
Scegliere modelli per l’IA vocale aziendale
Molti team pensano che costruire un agente vocale IA significhi scegliere una voce TTS che “suoni professionale”, collegarla al chatbot esistente, aggiungere un LLM e un po’ di riconoscimento vocale automatico, ASR. Dopo qualche mese pubblicano un prototipo che nei benchmark risponde in 600-800ms in una stanza silenziosa su macOS.
Poi, sulla vera infrastruttura telefonica, il sistema impiega da 2 a 4 secondi e il P95, la latenza massima entro cui ricade il 95% delle chiamate, arriva a 5 secondi. Aggiungi la qualità inferiore della telefonia a 8khz e l’esperienza reale può essere molto diversa dalle condizioni di valutazione.
È facile scegliere i modelli in base ai benchmark di laboratorio. Ma le conversazioni reali sono disordinate e gli agenti aziendali sono un problema ingegneristico difficile. Non possiamo trattare i modelli vocali come prodotti intercambiabili. Vanno scelti, analizzati e misurati per il caso d’uso previsto.
Lo stesso modello che rende perfettamente un accento britannico da trasmissione per podcast in studio può fallire in un help desk aereo collegato alla rete PSTN. Uno accurato nel trascrivere nel browser può faticare a rilevare il parlato in chiamata. Uno adatto al push-to-talk può non capire se l’utente ha finito o sta solo pensando. Il punto è questo.
Dimostrazioni e benchmark rispetto alla realtà
I benchmark pubblici sono un punto di partenza utile e valido, ma non devono determinare da soli la scelta finale del fornitore. Bisogna verificare che rappresentino il caso d’uso. Molti dataset contengono audio ideale: registrazioni in studio, audiolibri e prompt preparati, senza esitazioni, frasi lasciate in sospeso, rumore o lunghi silenzi.
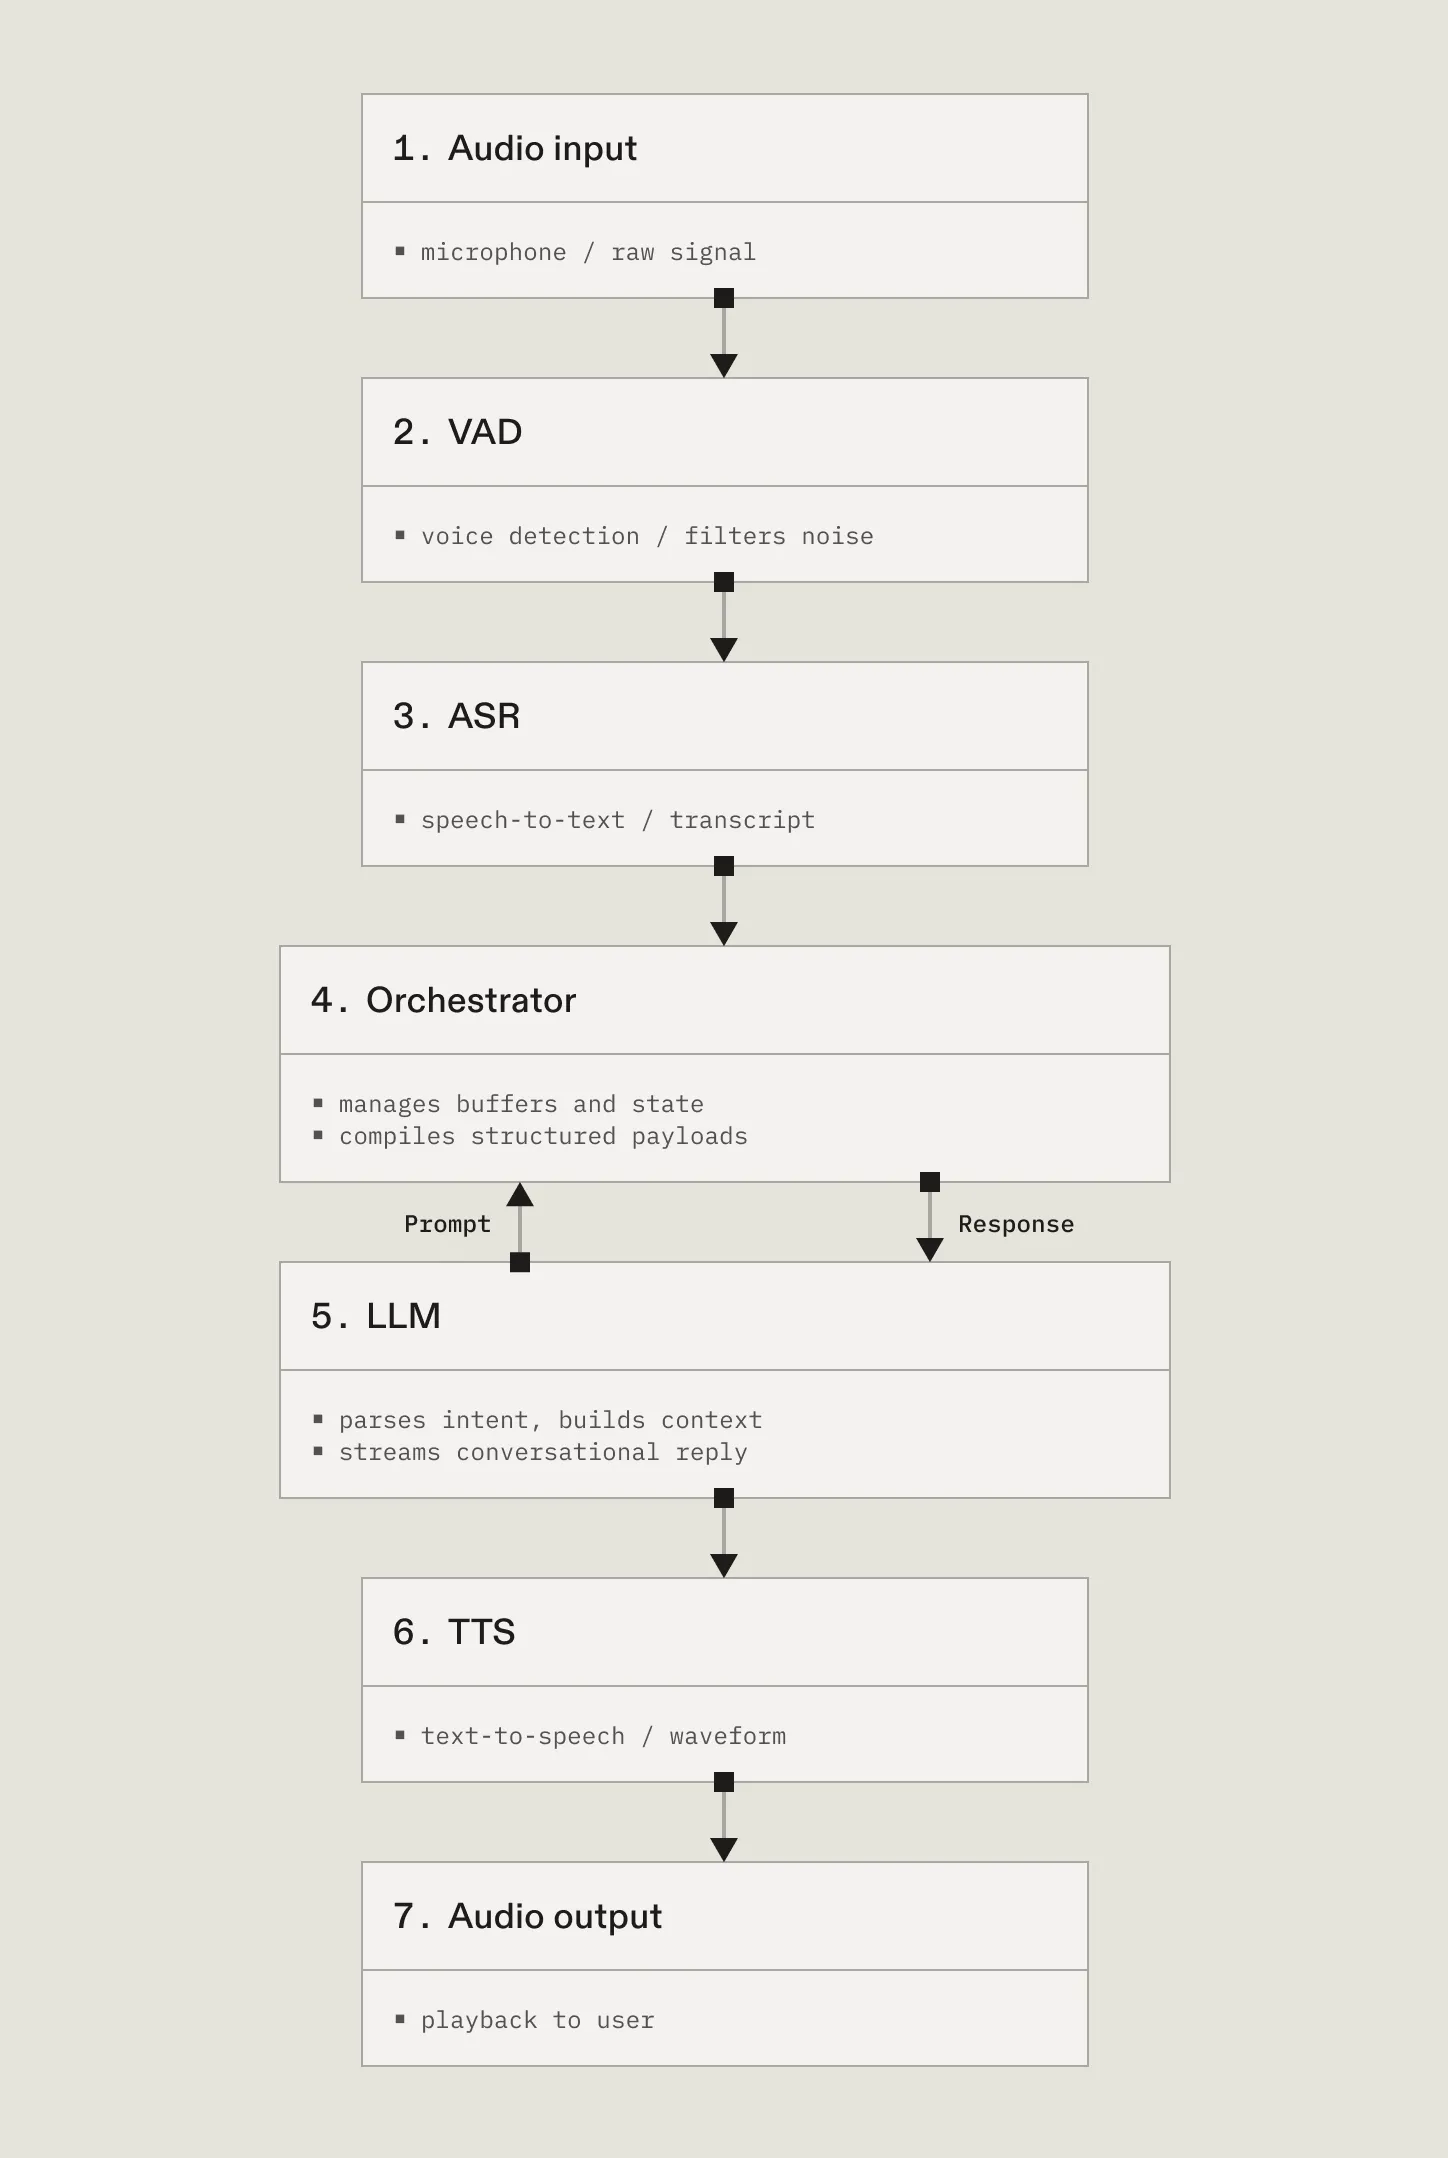
Quando un cliente dice “ehm, in realtà fammi [lunga pausa] controllare un’altra cosa…” e cerca sulla scrivania, una VAD basata su regole può emettere turn_ended perché ha rilevato una pausa ed è ottimizzata per ridurre la latenza anticipando. Questo avvia la trascrizione ASR; l’orchestrazione manda il testo all’LLM, la cui risposta viene subito convertita in parlato fluido e ben intonato. Tutto bene, salvo che l’utente riprende a parlare e l’agente gli parla sopra.
Acquisire legalmente su larga scala audio realistico per addestramento e benchmark è difficile. Per questo molti test misurano condizioni ideali, non scenari reali.
Se il tuo agente deve gestire conversazioni telefoniche con clienti in ambienti rumorosi, devi verificare che i modelli siano progettati per questi scenari.
Cosa significa scegliere modelli di IA vocale
1. Valutare il tempo fino alla trascrizione completa, TTCT, non al primo token
Molti team confrontano l’ASR sul tempo fino al primo token, TTFT, sul real-time factor, RTF, o sulla latenza media per parola. Per agenti in tempo reale, spesso sono metriche di facciata.
Crediamo che conti il tempo fino al segmento finale, TTFS, chiamato anche tempo fino alla trascrizione completa, TTCT.
È l’intervallo tra quando l’utente finisce il turno e quando il modello produce una trascrizione definitiva su cui l’agente LLM può fare affidamento. Determina se l’agente sembra presente o in ritardo, oltre alla qualità successiva della conversazione e del turno seguente.
Sotto 200ms, misurati da un capo all’altro e non per singolo segmento ASR, LLM o TTS, la conversazione sembra naturale. Tra 500ms e 1s, gli utenti notano il ritardo ma lo tollerano. Sopra 1s, iniziano a ripetersi o sovrapporsi in momenti inattesi. Le sovrapposizioni si accumulano: l’utente alza la voce, l’ASR viene distratto dalle parole precedenti, l’LLM riceve input sbagliati e tutto il ciclo peggiora.
2. Valutare rilevamento dei turni e gestione delle interruzioni
Il rilevamento dei turni è chiamato anche endpointing, perché rileva quando l’utente finisce. È difficile farlo bene: i modelli non hanno gli indizi visivi e gli altri segnali delle persone. Un rilevamento debole produce pause lunghe e sgradevoli e alta latenza.
Senza indizi visivi, orchestrazione e sistema di esecuzione devono gestire anche l’utente che riprende improvvisamente a parlare o interrompe. Un agente ben progettato cancella la chiamata LLM e la generazione TTS in corso quando l’utente inizia un nuovo turno o riprende quello ritenuto finito.
Valutando latenza e flusso nell’ASR, molti team non si rendono conto di valutare in realtà rilevamento dei turni e precisione rispetto al richiamo. Lo scoprono solo cercando la differenza tra dimostrazione e produzione. Come ogni debug, costa meno se lo anticipi e trovi presto il problema.
La precisione misura quanto correttamente il modello rilevi turn_start e turn_end. Un falso turn_start interrompe trascrizione e pipeline; un falso turn_end può far interrompere l’utente. Il richiamo misura se il modello perde un turn_start, ignorando interamente il turno, o un turn_end, senza mai rispondere.
L’ASR con rilevamento integrato è ormai comune. Sono precisione e richiamo a distinguere i modelli migliori. Storicamente si sacrificava l’una per l’altro, ma Ink-2 ASR ha stabilito un nuovo riferimento con alta precisione e alto richiamo sia nell’inizio sia nella fine del turno.
Ink-2 non usa solo la durata del silenzio: usa il contesto parlato. Capisce così se stai leggendo un numero di telefono, lasciando una frase in sospeso, pensando o hai davvero finito.
3. Accuratezza dove conta
Il tasso di errore sulle parole, WER, per STT/ASR è fuorviante se guardi classi di errori irrilevanti o confronti ASR non streaming, intrinsecamente più facile da rendere accurato, con ASR streaming. Molti benchmark non distinguono questi usi.
Conviene misurare WER per categorie di input, perché una media nasconde debolezze su numeri di telefono, nomi, UUID e altro. Lo stesso modello con WER del 2% sui numeri può arrivare al 23% su parlato con accento. Medicina e diritto hanno vocabolari specifici che i benchmark generici per consumatori possono non misurare affatto.
Se l’agente gestisce assistenza in ingresso da regioni diverse, la WER sugli accenti conta più di quella su trascrizioni pulite in inglese di conferenze sui risultati aziendali.
Il tuo caso può richiedere WER bassa solo in alcune categorie. Saperlo aiuta a valutare i compromessi con altre metriche. Se il benchmark non testa i dati che incontrerai, per te è privo di significato.
Nel TTS, WER misura l’intelligibilità rispetto al testo in ingresso. Contano coerenza, pronuncia, ritmo, prosodia e gestione di numeri, acronimi, importi e quantità, come “3 marzo” rispetto a “03/03” o “milleduecento dollari” rispetto a “$1,200”. Conta anche la pronuncia del vocabolario di settore.
Il modo migliore per misurare l’accuratezza è:
- Identificare le categorie di prestazioni rilevanti.
- Misurarle separatamente in scenari diversi.
- Esaminare i risultati in tutti gli scenari e categorie.
- Scegliere il modello che regge nei tuoi casi d’uso.
Scegliere le metriche che cambiano i risultati ed esaminare attentamente i benchmark è essenziale per trovare i modelli giusti.
4. Clonare le voci
Molti clienti preferiscono voci clonate quando serve continuità tra interazioni umane attuali e quelle degli agenti che stanno progettando.
Cartesia offre due modi: clonazione vocale istantanea, IVC, da 5 secondi di audio, e clonazione vocale professionale, PVC, da oltre 30 minuti di registrazioni.
I clienti aziendali devono capire quali qualità rendano la voce adatta allo scopo e quali attributi preservare e ottimizzare.
Anche localizzare una voce perché suoni nativa in altre lingue ha implicazioni di progettazione e parlato. Aspettative chiare su localizzazione, modifica dell’accento, pronunce personalizzate e altri attributi aiutano a creare agenti efficaci, perché influenzano molto la conversazione.
5. I controlli di progettazione della voce
Ogni piattaforma espone qualche versione di tre controlli TTS: velocità, volume ed emozione.
Sonic-3.5 va oltre. Puoi configurare gli attributi, ma il modello esprime emozione in accordo con il testo e ignora configurazioni in conflitto con il contesto semantico.
Se vuoi un tono empatico, l’LLM deve generare testo empatico. La progettazione della voce diventa così consapevole del contesto e collegata alla generazione LLM.
Collegare la voce agli input testuali dà più controllo e flessibilità nella scelta dell’LLM e nell’adattare la personalità del sistema al caso d’uso.
Cartesia progetta anche un’emotività di base per ogni voce. Una voce da “risolutore allegro” è diversa da un “confidente fidato”. Abbina la voce all’emozione necessaria e poi il prompt LLM alla voce scelta.
Un metodo per scegliere
Agenti davvero efficaci sono un risultato tecnico difficile. Ecco ciò che osserviamo nei clienti più riusciti.
Passo 1. Definisci gli obiettivi e collegali alle caratteristiche vocali
Un esempio di corrispondenze per il tuo caso d’uso:
| Caso d’uso | Velocità della voce | Emozione / temperatura | Reattività | Riferimento |
|---|---|---|---|---|
| Vendite in uscita | 1.1× – 1.3×, urgente e dinamica | Alta, calda ed entusiasta | Medio-rapida, 300-500ms | |
| Assistenza clienti | 0.8× – 1.0×, misurata e calma | Da bassa a media, stabile e rassicurante | Media, 500-650ms, spazio per pensare | |
| Recupero crediti / conformità | 0.9× – 1.0×, chiara e ferma | Bassa, controllata e professionale | Lenta, 650-800ms, lascia finire le dichiarazioni | |
| App di meditazione | 0.7× – 1.0×, calma | Bassa, rilassante e rassicurante | Lenta-media, 650-400ms, senza fretta e rilassata |
Se costruisci un sistema di appuntamenti per una clinica, un telefono sbagliato o una data capita male è un incidente di conformità e una possibile vendita persa. Per una IVR di recupero crediti su carte, l’accuratezza conta più dell’entusiasmo.
Parti dallo scenario peggiore, non da quello ideale, e risali alle cause dei risultati indesiderati.
Passo 2. Verifica che i benchmark pubblici testino ciò che ti serve
I benchmark non hanno valore se i dati di valutazione non corrispondono alla realtà commerciale. Possono persino essere controproducenti quando ciò che sembra attraente causa problemi di affidabilità, come una latenza bassa ottenuta anticipando troppo la fine del turno, con interruzioni o input errati alle chiamate di strumenti.
Molti benchmark usano dati etichettati male, vecchi audiolibri, brevi clip a metà frase, registrazioni in studio o letture ad alta voce perché sono facili da ottenere. I dataset aperti spesso rappresentano male la produzione, e i modelli vi si adattano eccessivamente fino a indovinare etichette sbagliate dagli artefatti del dataset invece di comprendere il parlato.
Questi dati possono assomigliare poco all’ambiente del tuo agente.
Una buona strategia è mettere alla prova i fornitori: fornisci 50 chiamate reali dei tuoi clienti, con rumore, accenti, sovrapposizioni, nomi di prodotti e silenzi mentre le persone passano dallo scrivere al parlare. Analizza prestazioni complete e sensazione della conversazione per diverse settimane.
Puoi ampliare l’approccio con Voice Sims di Sierra, simulando persone che parlano lingue diverse, hanno esigenze diverse e chiamano da casa con la TV accesa, dalla strada o dal treno, in stati emotivi e situazioni diversi.
Passo 3. Identifica le metriche da cui dipende il caso d’uso
Non tutte le metriche contano, né contano allo stesso modo. Un agente sanitario per appuntamenti deve trascrivere bene terminologia medica e dati strutturati, come farmaci, date e dosaggi. Un agente di vendita ad alto volume dà priorità a latenza completa e precisione delle interruzioni. Uno di recupero crediti soggetto a conformità deve rilevare i turni senza tagliare dichiarazioni obbligatorie. La metrica più importante per le imprese resta se il lavoro è stato svolto in modo efficiente, scalabile e con pochi passaggi a operatori umani.
Collega il tuo caso alle due o tre metriche che influenzano gli obiettivi commerciali e valuta le opzioni su quelle.
Passo 4. Gestisci il budget dei tempi
Assegna un budget di latenza a ogni componente. Per esempio:
- Rilevamento turni ASR: 50ms.
- TTCT ASR, o TTFS: 200ms.
- Primo token LLM: 300ms.
- Buffer di generazione TTS per testo proveniente dall’LLM.
- Primo audio TTS: 100ms.
- Pipeline totale: 500ms da un capo all’altro.
Assegna poi un responsabile a ogni voce. Entro due settimane il team ti dirà se 500ms sono irrealistici sulla telefonia. È un attrito utile, perché rivela il vero vincolo prima della produzione.
Considerazioni finali
Costruire agenti vocali aziendali è più difficile di quanto sembri online.
Se acquisti prodotti o guidi un team tecnico, chiediti quale architettura gestisca i tuoi casi, il budget di latenza e i requisiti di conformità in modo coerente con il marchio, anche quando il cliente chiama da un telefono fisso in hotel, parla con accento regionale e interrompe a metà frase.
È facile scegliere dal suono o da un benchmark ripulito e poi scoprire un P95 che compromette mesi di lavoro costoso.
Se vuoi combinare ricerca IA avanzata e pragmatismo commerciale nella costruzione del tuo agente aziendale, scrivi a business@cartesia.ai. Possiamo aiutarti.