
企業の音声AIに使うモデルを選ぶ
多くのチームは、AI音声エージェントの開発は簡単だと考えています。「プロらしく聞こえる」TTSの声を選び、既存のチャットボットとLLMにつなぎ、音声認識のASRを加えればよいという考えです。数か月後、静かな部屋のmacOS上では往復600〜800ミリ秒という試作品が完成します。
ところが実際の電話回線では2〜4秒かかり、P95、つまり通話の95%がその値以内に収まるレイテンシは5秒に達します。8khzの電話音声による品質の低下も加わり、現実の体験は評価環境と大きく異なるものになります。
実験室の条件で測ったベンチマークだけでモデルを選びたくなります。しかし現実の会話は不規則で、企業向けの音声エージェントは難しい技術課題です。音声モデルをどれでも交換できる部品として扱っては解決できません。想定する用途での性能をもとに選び、分析し、測定する必要があります。
スタジオ収録のポッドキャストで英国の放送アクセントを見事に再現するモデルでも、PSTN回線につながる航空会社の窓口では力を発揮できないかもしれません。ブラウザーで正確に文字起こしするモデルが、電話では発話の検出に苦戦することもあります。ボタンを押して話す用途が得意でも、話し終えたのか、考えながら言葉を止めただけなのかを判断できるとは限りません。
デモやベンチマークと現実
公開ベンチマークは有用な出発点ですが、最終的な提供企業の選定の根拠をそれだけにしてはいけません。用途を反映しているかも確かめる必要があります。多くのデータセットは、スタジオ録音、オーディオブック、台本のある発話などの「理想的な音声」です。「ええと」、言いよどみ、背景の雑音、長い沈黙などがありません。
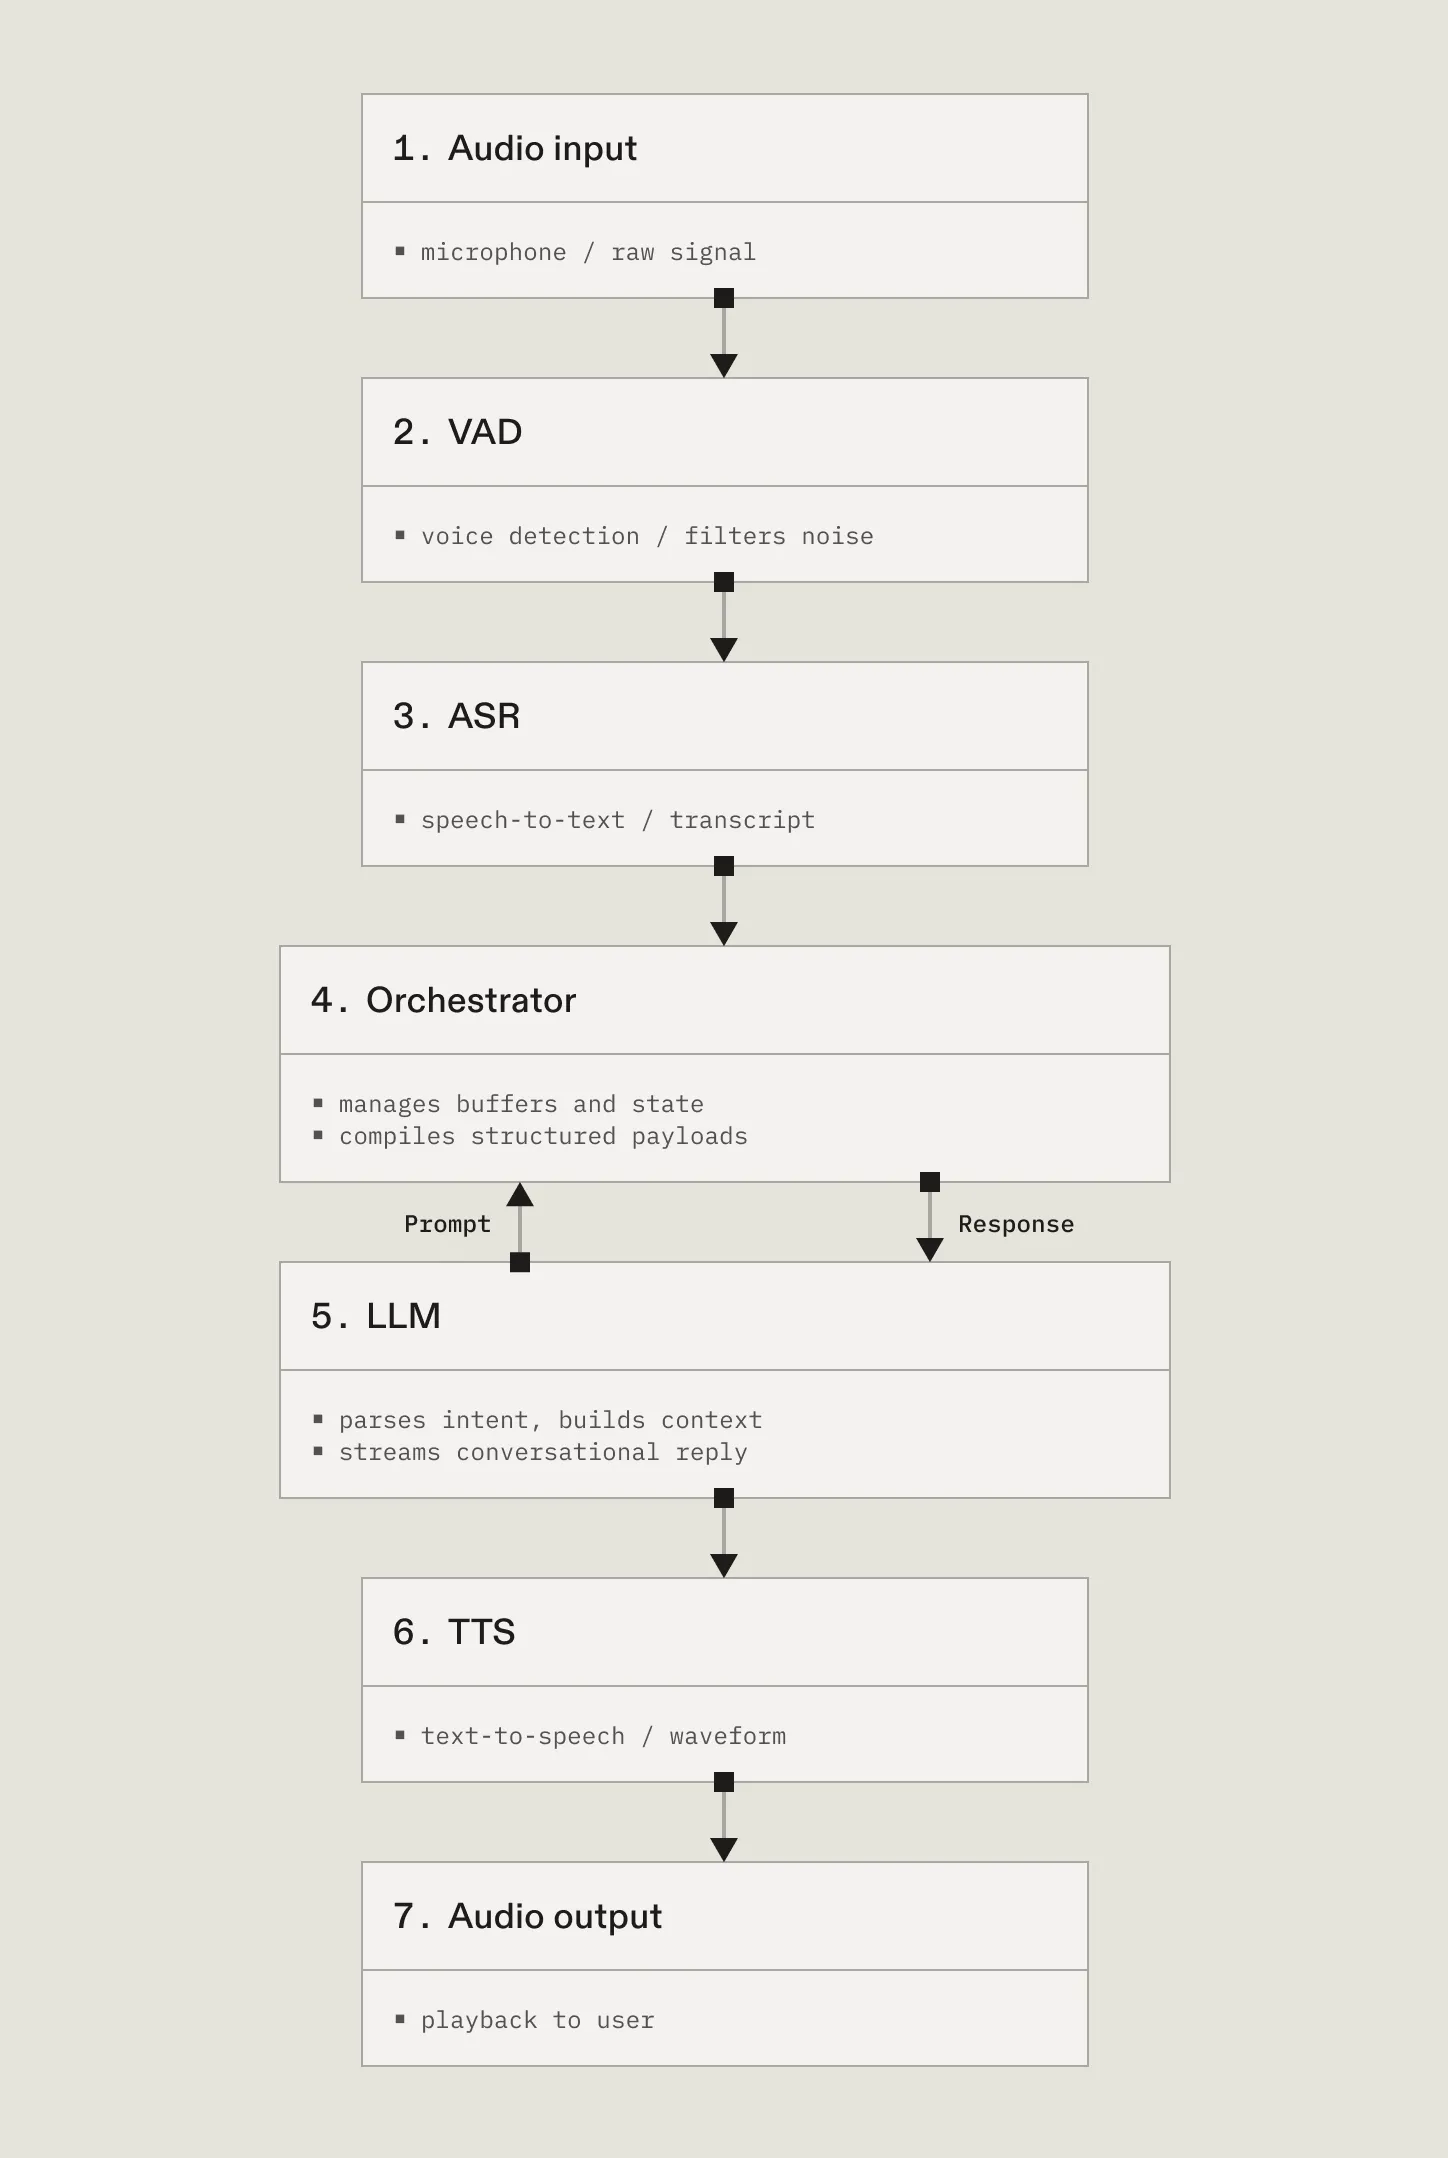
顧客が「ええと、ちょっと[長い間]別のものを確認させてください」と言い、机を探っているとします。ルールベースのVAD、音声区間検出は、間を検出するとturn_endedイベントを出すかもしれません。先を急いでレイテンシを減らすように最適化されているためです。ASRが文字起こしを行い、連携層がそれをLLMに渡して応答を生成します。テキストはすぐに調子のよい滑らかな音声になります。しかし、そこでユーザーが話を再開し、エージェントがかぶせて話してしまいます。
現実的な音声の学習、評価データを合法的に大量に入手することは非常に難しく、そのため多くのベンチマークは現実の場面ではなく、理想的な実験条件を測っています。
雑音のある環境で、顧客と電話で会話するAIエージェントが目的なら、その現実の状況に対応するようモデルが設計されているかを調べる必要があります。
「音声AIモデルを選ぶ」とは何か
1. 最初のトークンまででなく、文字起こしの確定までの時間を測る
多くのチームは、TTFT、最初のトークンまでの時間や、RTF、リアルタイム係数、単語あたりの平均レイテンシでASRを測ります。しかしリアルタイムのAI音声エージェントでは、実際の価値につながらない数値になりがちです。
音声エージェントで重要なのは、最後のセグメントが確定するまでの時間TTFS、別名TTCT、文字起こし完了までの時間だと考えています。
ユーザーが発話を終えた瞬間から、LLMエージェントが信頼できる確定済みの文字起こしが出る瞬間までの時間です。TTFSは、エージェントがすぐそばで応じていると感じるか、遅れていると感じるかを左右し、後続の会話や次の発話の品質にも影響します。
ASR、LLM、TTSそれぞれの区間ではなく、全体で200ミリ秒未満なら、会話は自然に感じられます。500ミリ秒〜1秒では遅れに気づいても許容できます。1秒を超えると、ユーザーは繰り返したり、予期しないタイミングで同時に話したりし始めます。その衝突は連鎖します。声が大きくなり、ASRは前の発話に引きずられ、LLMへの入力が乱れ、全体が悪化します。
2. ターン検出と割り込み対応を評価する
ターン検出は、ユーザーが発話を終えたことを検出するため、エンドポインティングとも呼ばれます。音声認識モデルには、人間の会話にある視覚などの手掛かりがなく、正確な判断は非常に困難です。そのため会話型AIでは品質の高いターン検出が重要です。不十分だと長く不自然な間ができ、レイテンシが増えます。
視覚的な手掛かりがないため、連携層と実行基盤は、ユーザーが突然話し始めたり、エージェントに割り込んだりする場面にも対応する必要があります。信頼できるエージェントは、ユーザーが新しく話し始めるか、終わったと思われた発話を再開したら、LLMへの呼び出しと進行中のTTS生成の両方を止めます。
ASRのレイテンシや会話の流れを評価するとき、多くのチームは、実際にはターン検出の「適合率と再現率」を評価していると気づいていません。デモと本番の差を調べて初めて気づきます。他の不具合と同様に、早い段階で検証して見つけるほうが速く、費用も少なく済みます。
「適合率」は、ターン検出を備えたASRがユーザーのturn_startとturn_endをどれだけ正しく検出するかを示します。誤ったturn_startは文字起こしや処理を中断し、誤ったturn_endはユーザーを遮る原因になります。「再現率」は、turn_startを見逃して発話全体を取り逃したり、turn_endを見逃して応答しなくなったりしないかを示します。
ターン検出を組み込んだASRは一般的ですが、最先端かどうかを決めるのは適合率と再現率です。従来は適合率を上げると再現率が下がるという交換関係がありました。CartesiaのInk-2 ASRは、開始と終了の両方で高い適合率と再現率を実現し、最高水準を確立しました。
Ink-2は無音の長さだけをルールにせず、話された文脈からターンを検出します。そのため、電話番号を読み上げているのか、言いよどんでいるのか、考えているのか、本当に終わったのかを理解できます。
3. 必要なところでの正確さ
STTやASRの単語誤り率、WERは、用途と関係のない種類の誤りを見ていると誤解を招きます。正確にしやすい非ストリーミングASRと、ストリーミングASRを比べる場合も同じです。多くのベンチマークは両者を区別していません。
入力データの分類ごとにWERを測るのが適切です。平均一つでは、電話番号、名前、UUIDなどの弱点が隠れます。同じモデルでも電話番号では2%のWERが、アクセントのある発話では23%になることがあります。医療や法律には固有の語彙や表現があり、一般消費者向けの既存ベンチマークでは、まったく測られていないかもしれません。
さまざまな地域からの着信をサポートするなら、明瞭な英語だけの決算説明会の文字起こしより、アクセントのある発話のWERが重要です。
用途によっては、一部の分類だけで低いWERが必要です。他の性能指標とのトレードオフを考える際に、把握しておく価値があります。実際に遭遇するデータで評価していないベンチマークは、自分の用途にとっては意味がありません。
TTSのWERは、入力テキストに対して合成音声がどれだけ聞き取れるかを測ります。重要なのは、話の一貫性、発音、速さ、韻律、数字、略語、金額、数量の扱いです。たとえば「March 3rd」と「03/03」、「twelve hundred dollars」と「$1,200」をどう読むかです。用途によっては専門用語の発音も重要です。
モデルの正確さは、次のように測るのが理想です。
- 重視する性能の分類を決める。
- さまざまな状況で、それぞれを個別に測る。
- すべての状況と分類を横断して性能を確認する。
- 自分の用途や必要条件に対して安定して動くモデルを選ぶ。
音声エージェントに合うモデルを選ぶには、成果に影響する指標を明確にし、ベンチマークを注意深く読む必要があります。
4. 声のクローン
現在の人による顧客対応と、これから設計するエージェントの対応に一貫性が必要な用途では、多くのお客様がクローンした声を選びます。
Cartesiaには、5秒の音声から作成するInstant Voice Cloning、IVCと、30分以上の音声から作成するProfessional Voice Cloning、PVCの二つの方法があります。
企業で声をクローンするときは、何がその声を用途に適したものにしているのか、どの特徴を保ち、最適化すべきかを深く理解する必要があります。
他の言語で母語話者のように聞こえるよう声をローカライズする際も、設計や発話への影響があります。ローカライズ、アクセント調整、独自の発音などに何を期待するかを明確にすると、効果的なエージェントを設計できます。これらは会話の体験を大きく左右します。
5. 声の設計で制御するもの
どの音声AI基盤も、TTSモデルに速度、音量、感情という三つの制御を何らかの形で提供しています。
CartesiaのSonic-3.5はさらに進んでいます。これらの特徴を設定できますが、入力テキストの意味に沿って感情を表現し、文脈に反する設定は無視します。
共感のある声にしたいなら、LLMも共感を示すテキストを生成する必要があります。声の設計は文脈を考慮し、LLMの生成と結びつきます。
エージェントの設計をテキスト入力と結びつけると、LLMの選択や、用途に合うシステムの個性づくりをより柔軟に制御できます。
Cartesiaは、それぞれの声に基本となる感情表現も持たせ、特定の用途に合うよう設計しています。「明るく問題を解決する人」と「信頼できる相談相手」では声が異なります。必要な感情に声を合わせ、選んだ声にLLMのプロンプトを合わせましょう。
選ぶための手順
効果的な会話型音声エージェントを実現するには、難しい技術課題を解く必要があります。成功しているお客様には、次の共通点があります。
手順1:目標を定義し、声の特徴に対応させる。
用途と特徴の対応例です。参考音声は英語です。
| 用途 | 話す速さ | 感情・温度感 | 応答の速さ | 参考音声 |
|---|---|---|---|---|
| 発信営業 | 1.1× – 1.3×(急ぎ、前に進める) | 高い(温かく、熱意がある) | 中〜速い(300-500ms) | |
| 顧客サポート | 0.8× – 1.0×(落ち着き、慎重) | 低〜中(安定し、安心感がある) | 中(500-650ms、考える間を置く) | |
| 債権回収・法令順守 | 0.9× – 1.0×(明瞭で、毅然としている) | 低い(抑制され、専門的) | 遅い650-800ms(発話を終えるまで待つ) | |
| 瞑想アプリ | 0.7× – 1.0×(穏やか) | 低い(心を落ち着け、安心させる) | 遅〜中650-400ms、急がず、くつろいだ調子 |
診療所の予約システムなら、電話番号や日付の聞き間違いはコンプライアンス上の問題になり、機会損失にもつながります。クレジットカードの債権回収のIVRなら、会話の熱意より正確さが重要です。
最悪の通話場面から始め、望ましくない結果の原因をたどって設計しましょう。
手順2:公開ベンチマークが必要なことを測っているか調べる
評価データが実際の事業の状況に合わなければ、音声AIのベンチマークは意味を持ちません。魅力的に聞こえる点が信頼性を損なうなら、逆効果です。たとえば発話終了を急いで判定してレイテンシを下げると、割り込みが多すぎたり、ツール呼び出しに誤った入力が渡ったりします。
公開ベンチマークの多くは、入手しやすいという理由で、誤ったラベル、古いオーディオブック、文の途中の短いクリップ、スタジオ録音、朗読のデータに頼っています。公開データは本番の条件を十分に再現していないことが多く、モデルが過度に適合すると、音声を理解せずデータの癖から誤ったラベルを推測するようになります。
これらのデータは、実際の会話エージェントの動作環境にほとんど似ていないかもしれません。
提供企業のモデルに厳しい条件を与えて試す方法が有効です。実際の顧客の電話を50件用意します。背景音、アクセント、重なった発話、製品名、タイピングから発話に切り替える際の不自然な沈黙も含め、数週間かけて全体の性能と使い心地を分析します。
SierraのVoice Simsを使えば、この方法を拡張できます。言語、要望、感情、状況が異なる発信者を、テレビのついた家、路上、電車など、さまざまな場所からの通話として再現できます。
手順3:用途の成否を左右する指標を選ぶ
すべての指標が重要なわけではなく、重要度も同じではありません。医療の予約エージェントには、薬品名、日付、用量など、専門語彙や構造化データで低いWERが必要です。大量に発信する営業エージェントは、全体のレイテンシと割り込みの正確さを最重視します。法令順守が必要な回収業務では、法定の説明を遮らない信頼できるターン検出が必要です。そして企業のAI音声エージェントで最も重要なのは、人への引き継ぎを最小限にし、効率よく、規模を拡大できる形で仕事を完了したかどうかです。
事業の目標に影響する二つか三つの指標を用途に対応させ、それに基づいて候補を評価しましょう。
手順4:時間の予算を管理する
各構成要素にレイテンシの予算を設定します。たとえば次のようになります。
- ASRのターン検出:50ms
- ASRのTTCT(TTFS):200ms
- LLMの最初のトークン:300ms
- LLMからのテキスト入力に対するTTS生成のバッファー
- TTSの最初の音声:100ms
- パイプライン全体:端から端まで500ms
各予算に担当者を決めます。電話の条件では500msが非現実的かどうか、チームは2週間以内に判断するでしょう。その議論は有益です。本番に入る前に本当の制約が明らかになります。
最後に
企業向け音声エージェントの開発は、インターネット上の説明ほど簡単ではありません。
音声サービスを評価する購入担当者や技術責任者が問うべきことは、用途、レイテンシの予算、法令順守の要件に、ブランドに合う形で対応できるアーキテクチャはどれか、ということです。顧客がホテルの部屋から固定電話を使い、地域のアクセントで話し、文の途中で割り込んでも対応できるでしょうか。
声の聞こえ方や整えられたベンチマークだけで選ぶと、後からP95の値が判明し、数か月の作業と高い開発費が無駄になることがあります。
企業向け音声エージェントの開発で、先端のAI研究と事業に即した実践を両立したい方は、business@cartesia.aiまでご連絡ください。お手伝いします。