
Escolha de modelos para IA de voz empresarial
Muitas equipes acham que criar um agente de voz é só escolher uma voz TTS que soe profissional, conectá-la ao chatbot existente e a um LLM e acrescentar reconhecimento automático de fala, ou ASR. Depois de alguns meses, entregam um protótipo com tempo de ida e volta de 600 a 800ms em uma sala silenciosa no macOS.
Na prática, porém, o sistema chega a 2 a 4 segundos na infraestrutura real de telefonia, com P95 chegando a 5 segundos. P95 é a latência máxima observada por 95% das chamadas. Some a isso a menor qualidade da telefonia de 8khz, e a experiência real pode ser muito diferente da avaliação.
É tentador escolher modelos por benchmarks de laboratório. Mas conversas reais são desorganizadas, e isso torna agentes empresariais um problema difícil de engenharia. Não podemos resolvê-lo tratando os modelos como produtos intercambiáveis. Precisamos escolher, analisar e medir seu desempenho para o caso de uso pretendido.
Um modelo que acerta o sotaque britânico de locução em podcasts de estúdio pode falhar no atendimento de uma companhia aérea via telefonia PSTN. Outro que transcreve muito bem no navegador pode ter dificuldade para detectar falas em uma ligação. Um modelo excelente para apertar um botão e falar pode não distinguir o fim de um turno de uma pausa para pensar.
Demonstrações e benchmarks diante da realidade
Benchmarks públicos são um ponto de partida útil e válido, mas não devem ser a única base da escolha final. Precisamos verificar se refletem o uso pretendido. Muitos conjuntos de avaliação têm áudio ideal, como gravações de estúdio, trechos de audiolivros e roteiros lidos, sem hesitações, frases inacabadas, ruído de fundo ou silêncios longos.
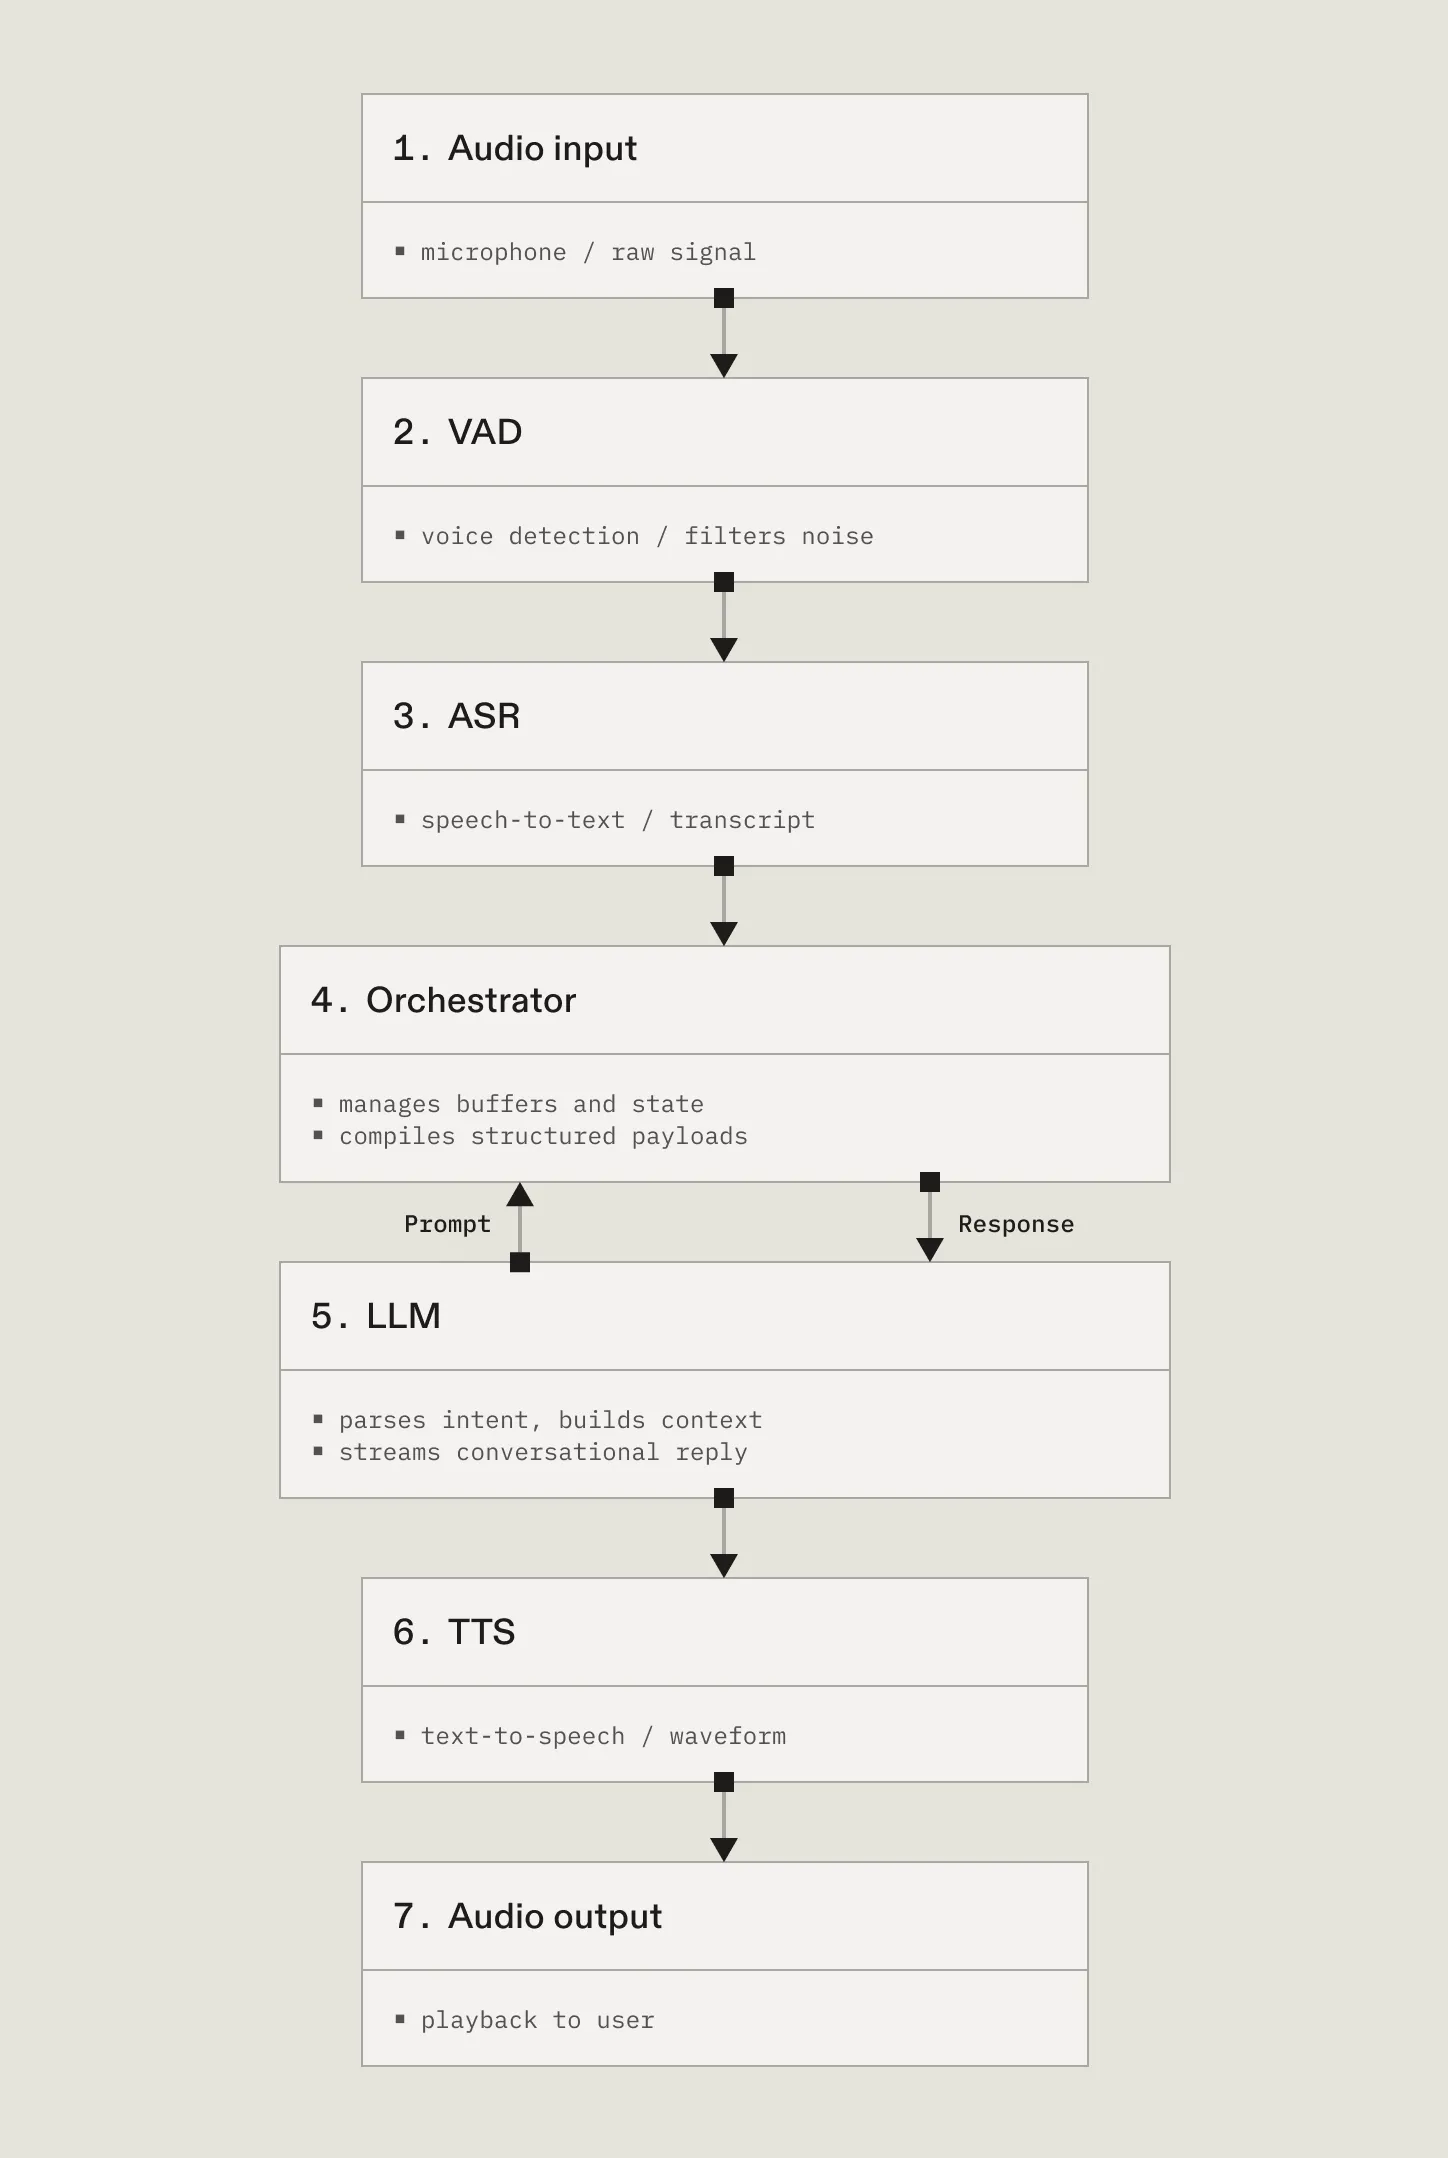
Mas imagine um cliente dizendo “hum, na verdade, deixe eu verificar outra coisa” enquanto faz uma pausa longa e procura algo na mesa. Um VAD baseado em regras pode emitir turn_ended ao detectar a pausa, tentando reduzir a latência. Isso aciona a transcrição pelo ASR, e a orquestração envia o texto ao LLM. A resposta vira fala fluida, com ótimo tom. Tudo parece bom, até o usuário retomar a fala e o agente falar por cima dele.
É muito difícil obter legalmente, em escala, dados realistas de áudio para treinamento e avaliação. Por isso, muitos benchmarks medem condições ideais de laboratório, em vez de cenários reais.
Se seu agente vai atender clientes por telefone em ambientes ruidosos, investigue se os modelos foram projetados para lidar com essas situações tão comuns.
O que significa escolher modelos de IA de voz
1. Avalie o tempo até a transcrição completa, ou TTCT
A maioria das equipes avalia ASR pelo tempo até o primeiro token, ou TTFT, pelo fator de tempo real, ou RTF, ou pela latência média por palavra. Para agentes de voz em tempo real, essas métricas muitas vezes são métricas de vaidade.
Acreditamos que a métrica relevante é o tempo até o segmento final, ou TTFS, também chamado de tempo até a transcrição completa, TTCT.
É o intervalo entre o usuário terminar o turno e o modelo produzir uma transcrição finalizada em que o agente LLM pode confiar. O TTFS determina se o agente parece presente ou atrasado e também influencia a qualidade da conversa e do próximo turno.
Abaixo de 200ms, medidos de ponta a ponta, e não por etapa ASR, LLM ou TTS, a conversa parece natural. Entre 500ms e 1s, o usuário percebe o atraso, mas o tolera. Acima de 1s, começa a repetir o que disse ou a falar ao mesmo tempo que o agente. Esses conflitos se acumulam. O usuário fala mais alto, o ASR se confunde com palavras anteriores, o LLM recebe entradas ruins e todo o ciclo se degrada.
2. Avalie a detecção de turnos e o tratamento de interrupções
A detecção de turnos, também chamada de endpointing, identifica quando o usuário terminou de falar. É difícil acertar porque modelos de fala para texto não têm pistas visuais ou outros sinais usados por humanos. Uma detecção ruim causa pausas longas e desconfortáveis e alta latência na conversa.
Sem pistas visuais, a estrutura de orquestração também precisa lidar com o usuário retomando a fala de repente ou interrompendo o agente. Um bom agente cancela a chamada ao LLM e a geração TTS em andamento quando o usuário começa um novo turno ou retoma um que parecia encerrado.
Ao avaliar latência e fluxo conversacional de ASR, muitas equipes não percebem que estão avaliando detecção de turnos e precisão versus revocação. Só descobrem isso ao investigar a diferença entre demonstração e produção. Como em qualquer depuração, é mais rápido e barato antecipar os testes e encontrar o problema cedo.
A precisão mede o acerto do ASR ao identificar turn_start e turn_end. Um turn_start falso interrompe a transcrição e o pipeline. Um turn_end falso pode fazer o agente interromper o usuário. A revocação mede se o ASR deixou de detectar turn_start, perdendo todo o turno, ou turn_end, fazendo o agente nunca responder.
ASR com detecção integrada de turnos já é comum. Mas precisão e revocação definem o estado da arte. Historicamente, melhorar uma comprometia a outra. O Ink-2 ASR da Cartesia estabeleceu um novo patamar por combinar alta precisão e alta revocação tanto no início quanto no fim dos turnos.
Isso acontece porque o Ink-2 usa o contexto da fala, além da duração do silêncio. Assim, distingue a leitura de um telefone, uma frase inacabada, uma pausa para pensar e um turno realmente concluído.
3. Exatidão onde ela importa
A taxa de erro de palavras, ou WER, de STT/ASR pode enganar quando mede categorias de erros irrelevantes para você. Também engana comparar ASR sem streaming, em que acertar é inerentemente mais fácil, com ASR em streaming. Muitos benchmarks não distinguem esses usos.
Meça WER por categoria de entrada, porque uma média única esconde fragilidades em telefones, nomes, UUIDs e outros dados. O mesmo modelo com WER de 2% em telefones pode chegar a 23% em fala com sotaques. Medicina e direito também têm vocabulário próprio que benchmarks genéricos de consumo podem nem avaliar.
Se o agente atende clientes de várias regiões, o WER em fala com sotaques importa mais que o WER em transcrições limpas de conferências de resultados apenas em inglês.
Seu caso de uso talvez exija WER baixo só em algumas categorias. Saber disso ajuda a avaliar compromissos com outras métricas. Se os benchmarks não testam os dados que sua aplicação encontrará, eles não têm significado para você.
Em TTS, WER mede a inteligibilidade da fala em relação ao texto de entrada. Importam coerência, pronúncia, ritmo, prosódia e tratamento de números, siglas, valores e quantidades, como “March 3rd” e “03/03”, ou “twelve hundred dollars” e “$1,200”. A pronúncia de vocabulário específico também importa em certos usos.
Uma boa forma de medir a exatidão dos modelos é:
- Identificar as categorias de desempenho relevantes.
- Medir cada uma separadamente em cenários variados.
- Examinar os resultados em todos os cenários e categorias.
- Escolher o modelo que lida bem com suas necessidades.
Definir as métricas que afetam os resultados e analisar os benchmarks com rigor é essencial para escolher os modelos certos.
4. Clonagem de voz
Muitos clientes preferem vozes clonadas para preservar continuidade entre as interações humanas atuais e as interações com agentes que estão projetando.
Na Cartesia, há duas formas de clonar uma voz. A clonagem instantânea, ou IVC, usa a partir de 5 segundos de áudio. A clonagem profissional, ou PVC, usa mais de 30 minutos de áudio de voz.
Ao clonar, clientes empresariais precisam entender quais qualidades tornam a voz adequada à finalidade e quais atributos devem ser preservados e otimizados.
Também há implicações de projeto e fala ao localizar essas vozes para que soem nativas em outros idiomas. Expectativas claras sobre localização, ajuste de sotaque, pronúncias personalizadas e outros atributos ajudam a criar agentes eficazes, porque tudo isso influencia muito a conversa.
5. Os controles de criação da voz
Toda plataforma de IA de voz oferece alguma versão de três controles em TTS, velocidade, volume e emoção.
O Sonic-3.5 da Cartesia vai além. Você pode configurar esses atributos, mas o modelo expressa emoção alinhada ao texto de entrada e desconsidera configurações que conflitem com seu contexto semântico.
Se você quer um tom empático, o LLM precisa gerar texto empático. Assim, a voz considera o contexto e se conecta à geração do LLM.
Vincular o projeto do agente ao texto de entrada dá mais controle e flexibilidade ao escolher o LLM e adaptar a personalidade do sistema ao uso pretendido.
A Cartesia também dá a cada voz uma expressividade emocional de base, adequada a cenários específicos. Uma voz de alguém que resolve problemas com alegria soa diferente de uma voz de confidente de confiança. Combine a voz com a emoção necessária e depois ajuste o prompt do LLM à voz escolhida.
Um método para escolher
Agentes realmente eficazes são uma conquista técnica difícil. Eis o que observamos em nossos clientes mais bem-sucedidos:
Etapa 1. Defina os objetivos e associe-os às características da voz.
Veja exemplos de relações que você pode definir para seu caso de uso:
| Caso de uso | Velocidade da voz | Emoção / temperatura | Tempo de resposta | Referência |
|---|---|---|---|---|
| Vendas ativas | 1.1× a 1.3×, urgente e dinâmica | Alta, calorosa e entusiasmada | Média a rápida, 300-500ms | |
| Atendimento ao cliente | 0.8× a 1.0×, ponderada e calma | Baixa a média, estável e tranquilizadora | Média, 500-650ms, com espaço para pensar | |
| Cobrança / conformidade | 0.9× a 1.0×, clara e firme | Baixa, controlada e profissional | Lenta, 650-800ms, deixando as frases terminarem | |
| Aplicativo de meditação | 0.7× a 1.0×, calma | Baixa, suave e tranquilizadora | Lenta a média, 650-400ms, sem pressa e relaxada |
Ao criar um agendador para uma clínica, um telefone errado ou uma data mal entendida pode ser um incidente de conformidade e uma venda perdida. Em uma URA de cobrança de cartão de crédito, a exatidão importa mais que o entusiasmo.
Comece pela pior chamada possível, em vez da ideal, e investigue o que produz os resultados indesejados.
Etapa 2. Verifique se os benchmarks públicos testam o que você precisa.
Benchmarks não ajudam se os dados não correspondem à realidade comercial. Podem até atrapalhar quando algo atraente causa problemas de confiabilidade, como baixa latência obtida ao encerrar turnos cedo demais, criando interrupções ou entradas ruins para ferramentas.
Muitos benchmarks usam dados rotulados incorretamente, audiolivros antigos, trechos curtos no meio de frases, gravações de estúdio ou textos lidos, porque são fáceis de obter. Dados abertos muitas vezes representam mal a produção. Os modelos podem se ajustar tanto a eles que aprendem a adivinhar o rótulo errado por artefatos do conjunto, em vez de compreender a fala.
Esses dados podem ter pouca semelhança com o ambiente em que seu agente vai operar.
Uma boa estratégia é testar os fornecedores de forma adversarial. Entregue 50 chamadas reais da sua base, com ruído, sotaques, falas sobrepostas, nomes de produtos e o silêncio estranho quando alguém troca a digitação pela fala. Analise o desempenho completo e a experiência por várias semanas.
Você pode ampliar essa abordagem com o Voice Sims da Sierra, simulando pessoas com idiomas, necessidades, locais, estados emocionais e situações diferentes. Elas podem ligar de casa com a TV ligada, da rua ou de um trem.
Etapa 3. Identifique as métricas de que seu caso de uso depende.
Nem toda métrica importa, e as relevantes raramente têm o mesmo peso. Um agente de agendamento médico precisa de bom WER em vocabulário especializado e dados estruturados, como medicamentos, datas e dosagens. Um agente de vendas de alto volume prioriza latência total e exatidão das interrupções. Um agente de cobrança sensível à conformidade precisa de detecção de turnos que não corte uma informação legalmente obrigatória. No fim, a principal métrica empresarial é saber se o trabalho foi concluído com eficiência, em escala e com o mínimo de transferência para humanos.
Associe o caso de uso às duas ou três métricas que influenciam seus objetivos comerciais e avalie as opções com base nelas.
Etapa 4. Assuma o controle do orçamento de tempo.
Defina um orçamento de latência por componente. Por exemplo:
- Detecção de turnos do ASR: 50ms
- TTCT ou TTFS do ASR: 200ms
- Primeiro token do LLM: 300ms
- Buffers de geração TTS para texto vindo do LLM
- Primeiro áudio TTS: 100ms
- Pipeline completo: 500ms de ponta a ponta
Atribua responsáveis a cada item. Em duas semanas, a equipe dirá se 500ms é irrealista na telefonia. Esse atrito é útil, porque revela a restrição real antes da produção.
Considerações finais
Criar agentes empresariais é mais difícil do que a internet faz parecer.
Se você compra produtos ou lidera engenharia e está avaliando fornecedores, pergunte qual arquitetura atende aos seus casos de uso, orçamento de latência e requisitos de conformidade de forma alinhada à marca, mesmo quando o cliente liga de um telefone fixo em um hotel, fala com sotaque regional e interrompe no meio da frase.
É tentador escolher modelos pelo som ou pelo desempenho em benchmarks limpos e só depois descobrir um P95 que compromete meses de trabalho e desenvolvimento caro.
Se você quer combinar pesquisa avançada de IA com foco nos resultados comerciais ao construir seu agente empresarial, fale conosco em business@cartesia.ai. Podemos ajudar.