
Choisir des modèles pour l’IA vocale en entreprise
Beaucoup d’équipes pensent qu’il suffit, pour créer un agent vocal IA, de choisir une voix de synthèse (TTS) qui « fait professionnel », de la relier à leur chatbot existant et à un LLM, puis d’ajouter de la reconnaissance vocale automatique (ASR). Quelques mois plus tard, elles livrent un prototype qui affiche un aller-retour de 600 à 800 ms dans une pièce calme, sur macOS.
Mais sur une véritable infrastructure téléphonique, le système atteint 2 à 4 secondes, avec un P95 qui grimpe à 5 secondes. Le P95 est le 95e percentile de latence, autrement dit la limite que 95 % des appels ne dépassent pas. Ajoutez la qualité réduite de la téléphonie à 8 kHz, et l’expérience réelle peut être très différente des conditions d’évaluation.
Il est tentant de choisir les modèles à partir de benchmarks réalisés en laboratoire. Mais les conversations réelles sont désordonnées, ce qui fait des agents vocaux d’entreprise un problème d’ingénierie difficile. Traiter les modèles vocaux comme des produits interchangeables ne résout pas ces problèmes. Il faut les choisir, les analyser et les mesurer selon leurs performances pour l’usage prévu.
Un modèle excellent pour un podcast en studio avec un accent britannique de présentateur peut échouer au service client d’une compagnie aérienne relié au réseau téléphonique commuté. Un modèle conçu pour transcrire très précisément dans un navigateur peut avoir du mal à détecter les prises de parole au téléphone. Un autre, excellent en mode appuyer-pour-parler, peut ne pas savoir si l’utilisateur a terminé ou s’il hésite simplement en réfléchissant. Vous voyez le problème !
Démonstrations, benchmarks et réalité
Les benchmarks publics sont un point de départ utile et valable, mais ils ne doivent pas être le seul fondement du choix final d’un fournisseur. Il faut aussi vérifier qu’ils reflètent l’usage prévu. Beaucoup de jeux de données d’évaluation vocale contiennent un audio « idéal » : enregistrements en studio, extraits de livres audio et textes préparés, sans hésitations, phrases laissées en suspens, bruit de fond ni longs silences.
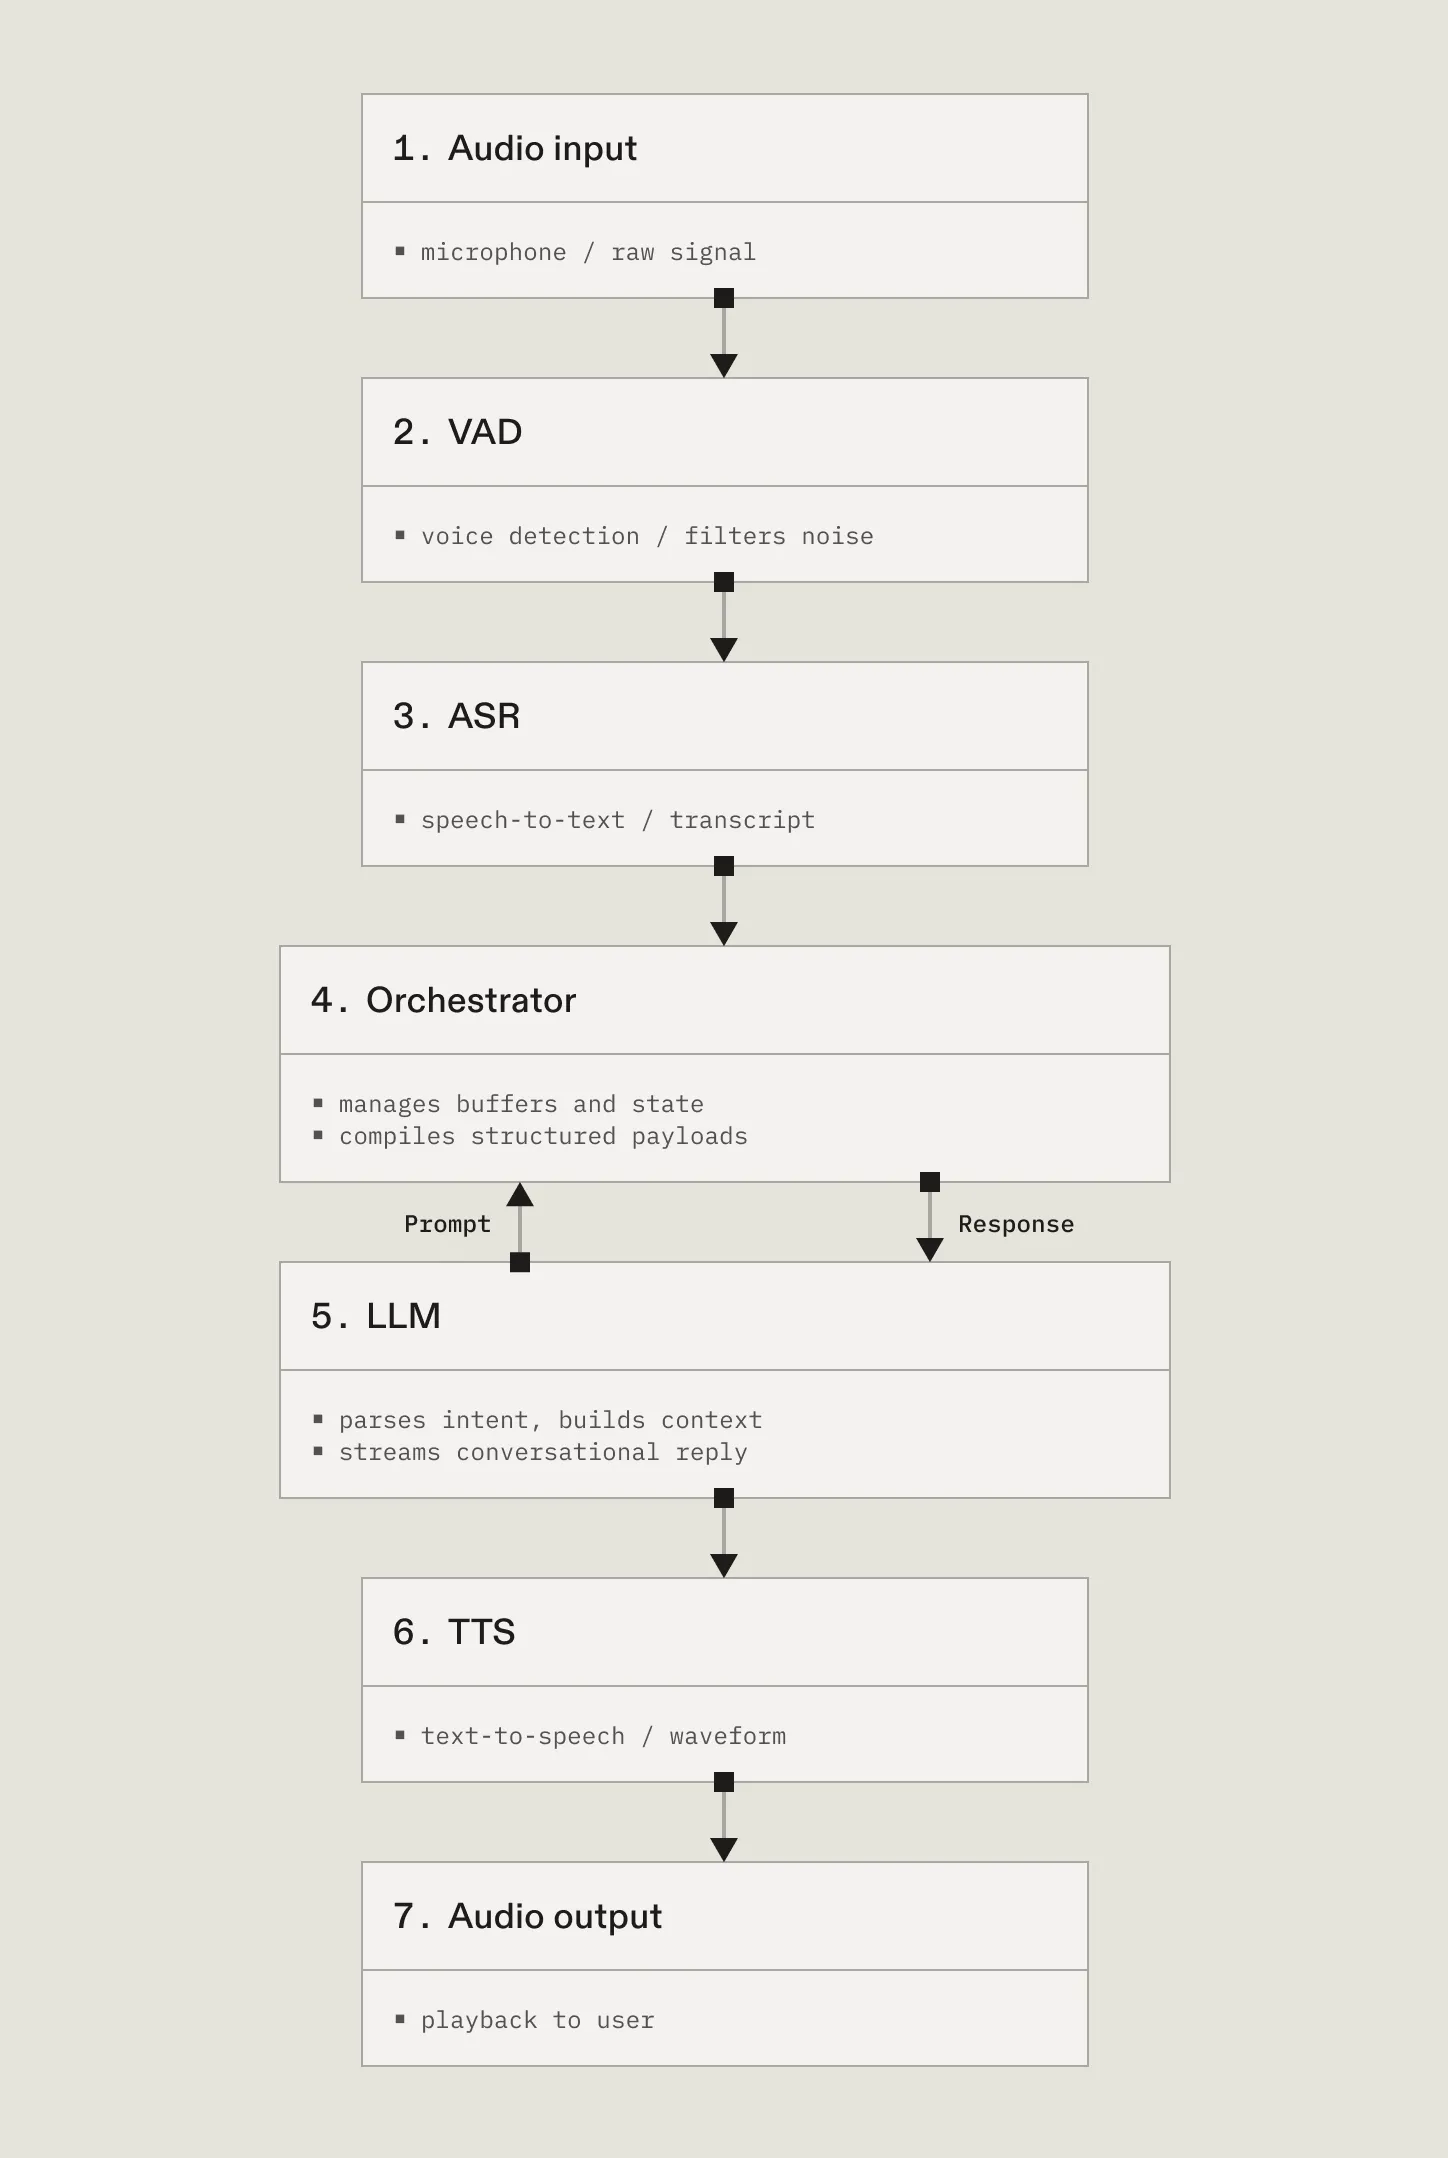
Lorsqu’un client dit « euh, en fait, laissez-moi [longue pause] vérifier autre chose… » en cherchant sur son bureau, un détecteur d’activité vocale (VAD) fondé sur des règles peut émettre un événement turn_ended. Il a détecté une pause et cherche à réduire la latence en avançant au plus vite. Le modèle ASR transcrit alors l’audio, puis la couche d’orchestration transmet le texte au LLM pour générer une réponse. Celle-ci est immédiatement convertie en une voix fluide, au ton agréable. Tout semble bien fonctionner, sauf que l’utilisateur reprend la parole et que l’agent lui parle par-dessus.
Il est très difficile d’obtenir légalement, à grande échelle, des données audio réalistes pour l’entraînement et l’évaluation. C’est pourquoi beaucoup de benchmarks mesurent des conditions idéales de laboratoire plutôt que des situations réelles.
Si votre usage est un agent conversationnel qui échange avec des clients au téléphone dans des environnements bruyants, vérifiez donc que les modèles choisis sont conçus pour ces situations bien réelles.
Ce que signifie réellement « choisir des modèles d’IA vocale »
1. Évaluer le délai de transcription complète (TTCT), pas le délai du premier token
La plupart des équipes évaluent les modèles ASR sur le TTFT, délai du premier token, le RTF, facteur temps réel, ou la latence moyenne par mot. Mais ces chiffres sont souvent flatteurs sans être utiles aux agents vocaux IA en temps réel.
Pour les agents vocaux, nous pensons que la mesure pertinente est le TTFS, délai du segment final, aussi appelé TTCT, délai de transcription complète.
Il s’agit du temps écoulé entre la milliseconde où l’utilisateur termine son tour de parole et celle où le modèle produit une transcription définitive sur laquelle un agent LLM peut s’appuyer. Le TTFS détermine si l’agent semble présent ou en retard, mais aussi la qualité de la conversation et du tour suivant.
En dessous de 200 ms, mesurées de bout en bout et non pour chaque segment ASR, LLM ou TTS, la conversation paraît naturelle. Entre 500 ms et 1 s, l’utilisateur remarque le délai mais le tolère. Au-delà d’une seconde, il commence à se répéter ou à parler en même temps que l’agent à des moments inattendus. Ces collisions s’accumulent : l’utilisateur parle plus fort, l’ASR est perturbé par ses mots précédents, le LLM reçoit une entrée incohérente et toute la boucle se dégrade.
2. Évaluer la détection des tours de parole et la gestion des interruptions
La détection des tours de parole est aussi appelée détection de fin de parole, car elle vise à déterminer quand l’utilisateur a terminé. Elle est très difficile à réaliser précisément : les modèles de transcription n’ont pas les indices visuels ou autres dont disposent les humains. Sa qualité est donc essentielle pour l’IA conversationnelle. Une mauvaise détection entraîne de longues pauses gênantes et une forte latence.
Sans indices visuels, la couche d’orchestration et l’environnement d’exécution doivent aussi gérer les reprises soudaines de parole et les interruptions de l’agent. Un agent fiable annule son appel au LLM et la génération TTS en cours lorsque l’utilisateur commence un nouveau tour, ou reprend un tour que le système croyait terminé.
Lorsqu’elles évaluent la latence et la fluidité conversationnelle des modèles ASR, la plupart des équipes ne réalisent pas qu’elles évaluent en fait la détection des tours de parole et le compromis précision-rappel. Elles ne le comprennent qu’en analysant l’écart entre démonstration et production. Comme pour tout débogage, il est plus rapide et moins coûteux de tester plus tôt et de détecter le problème en amont.
La « précision » mesure la justesse avec laquelle un modèle ASR détecte les événements turn_start et turn_end. Un faux turn_start interrompt la transcription et la chaîne de traitement. Un faux turn_end peut amener l’agent à couper la parole à l’utilisateur. Le « rappel » mesure les événements manqués : un turn_start non détecté signifie que l’agent rate entièrement la prise de parole, tandis qu’un turn_end manqué signifie qu’il ne répond jamais.
Les modèles ASR avec détection intégrée des tours de parole sont désormais courants. Mais la précision et le rappel distinguent les meilleurs. Historiquement, améliorer l’un se faisait au détriment de l’autre. Le modèle ASR Ink-2 de Cartesia a maintenant établi une nouvelle référence grâce à une précision et un rappel élevés, tant pour le début que pour la fin des tours de parole.
Ink-2 y parvient car il ne se fonde pas uniquement sur la durée du silence. Il utilise le contexte de la parole pour détecter les tours. Il comprend ainsi si vous récitez un numéro de téléphone, laissez une phrase en suspens, réfléchissez ou avez réellement terminé.
3. Mesurer l’exactitude là où elle compte
Le taux d’erreur sur les mots (WER) en STT/ASR est trompeur si vous observez des catégories d’erreurs sans rapport avec votre usage. Il l’est aussi si vous comparez un modèle hors diffusion en continu, pour lequel une bonne exactitude est intrinsèquement plus facile, à un modèle en continu. Malheureusement, beaucoup de benchmarks ne distinguent pas ces usages.
Mieux vaut mesurer le WER par catégorie de données, car une moyenne unique masque les faiblesses sur les numéros de téléphone, noms, UUID et autres éléments. Un modèle à 2 % de WER sur les numéros de téléphone peut atteindre 23 % sur une parole accentuée. Certains domaines, comme la médecine et le droit, emploient aussi un vocabulaire spécifique que les benchmarks grand public ne mesurent parfois pas du tout.
Si votre agent assure le support entrant dans plusieurs régions, le WER sur les accents compte davantage que celui mesuré sur des transcriptions propres de conférences de résultats financiers uniquement en anglais.
Votre usage peut exiger un faible WER sur certaines catégories seulement. Le savoir aide à arbitrer avec les autres mesures de performance. Si les benchmarks retenus n’ont pas testé les données que votre application rencontrera, ils ne sont pas pertinents pour vous.
En TTS, le WER mesure l’intelligibilité de la parole synthétisée par rapport au texte fourni. Ce qui compte est sa cohérence, la qualité de la prononciation, le rythme, la prosodie, et le traitement des nombres, acronymes, montants et quantités, par exemple « 3 mars » contre « 03/03 », ou « mille deux cents dollars » contre « $1,200 ». La prononciation du vocabulaire spécialisé compte aussi selon l’usage.
Pour évaluer l’exactitude des modèles choisis, l’idéal est de :
- Définir les catégories de performance qui vous intéressent.
- Les mesurer séparément dans différentes situations.
- Examiner les résultats dans chaque situation et catégorie.
- Choisir le modèle qui répond de manière fiable à vos usages et besoins.
Il faut donc choisir les mesures qui influencent réellement les résultats et examiner les benchmarks avec discernement pour sélectionner les bons modèles vocaux.
4. Cloner des voix
Beaucoup de clients préfèrent les voix clonées lorsque leur usage exige une continuité entre les échanges actuels avec des humains et les interactions avec les agents qu’ils conçoivent.
Cartesia propose deux méthodes : le clonage vocal instantané, ou IVC, à partir de 5 secondes d’audio, et le clonage vocal professionnel, ou PVC, à partir de plus de 30 minutes de voix.
Les entreprises qui clonent une voix doivent comprendre précisément les qualités qui la rendent adaptée à l’usage prévu, ainsi que les attributs à préserver et à optimiser.
La localisation de ces voix pour qu’elles paraissent natives dans d’autres langues a aussi des conséquences sur la conception et la parole. Définir des attentes claires sur la localisation, l’ajustement de l’accent, les prononciations personnalisées et les autres attributs aide à concevoir des agents efficaces, car ces choix influencent fortement l’expérience conversationnelle.
5. Les paramètres de conception de la voix
Chaque plateforme d’IA vocale propose, sous une forme ou une autre, trois réglages de son modèle de synthèse vocale : vitesse, volume et émotion.
Sonic-3.5 de Cartesia va plus loin. Vous pouvez configurer ces attributs, mais Sonic exprime les émotions en accord avec le texte fourni et écarte les réglages qui contredisent son contexte sémantique.
Pour obtenir un ton empathique, votre LLM doit donc produire un texte empathique. La conception de la voix tient ainsi compte du contexte et reste liée à la génération du LLM.
Relier la conception de l’agent à ses entrées textuelles vous donne plus de possibilités et de souplesse pour choisir votre LLM et adapter la personnalité du système à son usage.
Cartesia donne aussi à chaque voix une expressivité de base, pensée pour des situations précises. Une voix de « personne joyeuse qui trouve des solutions » ne ressemble pas à celle d’un « confident de confiance ». Choisissez une voix qui correspond à l’émotion recherchée, puis adaptez le prompt du LLM à cette voix.
Une méthode pour choisir
Créer un agent vocal conversationnel réellement efficace est un défi technique. Voici ce que nous observons chez nos clients qui réussissent le mieux.
Étape 1 : définir les objectifs, puis les traduire en caractéristiques vocales.
Voici des correspondances possibles selon l’usage :
| Usage | Vitesse de la voix | Émotion / température | Réactivité | Référence |
|---|---|---|---|---|
| Prospection commerciale | 1.1× – 1.3× (pressant, dynamique) | Élevée (chaleureuse, enthousiaste) | Moyenne à rapide (300-500ms) | |
| Support client | 0.8× – 1.0× (mesurée, calme) | Faible à moyenne (stable, rassurante) | Moyenne (500-650ms, temps de réflexion) | |
| Recouvrement / conformité | 0.9× – 1.0× (claire, ferme) | Faible (maîtrisée, professionnelle) | Lente 650-800ms (laisser finir les phrases) | |
| Application de méditation | 0.7× – 1.0× (calme) | Faible (apaisante, rassurante) | Lente à moyenne 650-400ms, sans hâte, détendue |
Pour un agent de prise de rendez-vous en clinique, un mauvais numéro de téléphone ou une date mal entendue peut constituer un incident de conformité et une vente perdue. Pour un serveur vocal de recouvrement de cartes de crédit, l’exactitude compte davantage que l’enthousiasme de la conversation.
Partez du pire scénario d’appel, puis remontez aux causes des résultats indésirables, plutôt que de partir du scénario idéal.
Étape 2 : vérifier que les benchmarks publics testent ce dont vous avez besoin.
Les benchmarks d’IA vocale n’ont pas de sens si leur jeu d’évaluation ne correspond pas à votre réalité commerciale. Ils peuvent même être contre-productifs lorsqu’un résultat séduisant provoque des problèmes de fiabilité : une faible latence obtenue par une détection agressive de fin de parole peut multiplier les interruptions ou envoyer de mauvaises données aux appels d’outils.
Beaucoup de benchmarks publics utilisent des jeux mal étiquetés, d’anciens livres audio, de courts extraits pris au milieu de phrases, des enregistrements en studio ou des lectures à voix haute, car ils sont faciles à obtenir. Ces données ouvertes reflètent souvent mal la production. Les modèles s’y surajustent au point d’apprendre à deviner une étiquette erronée à partir d’artefacts du jeu de données plutôt qu’à comprendre la parole.
Ces données peuvent avoir peu de rapport avec l’environnement de votre agent conversationnel.
Une bonne stratégie consiste à mettre les fournisseurs à l’épreuve. Donnez-leur 50 appels réels de vos clients, avec du bruit de fond, des accents, des voix qui se chevauchent, des noms de produits et les silences gênants qui surviennent quand une personne passe du clavier à la parole. Analysez les performances de bout en bout et le ressenti pendant plusieurs semaines.
Vous pouvez étendre cette approche avec Voice Sims de Sierra. L’outil simule des appelants parlant différentes langues, ayant des besoins variés, appelant de chez eux avec la télévision allumée, de la rue ou d’un train, et présentant différents états émotionnels et différentes situations.
Étape 3 : identifier les mesures dont dépend votre usage.
Comme nous l’avons vu, toutes les mesures ne sont pas pertinentes et celles qui le sont n’ont généralement pas le même poids. Un agent de rendez-vous médicaux doit obtenir un excellent WER sur le vocabulaire médical et les données structurées, comme les médicaments, dates et dosages. Un agent de prospection à fort volume privilégie la latence de bout en bout et la précision de la prise en compte des interruptions. Un agent de recouvrement soumis à des contraintes de conformité a besoin d’une détection fiable qui ne coupe jamais une mention légale obligatoire. Au bout du compte, la mesure essentielle pour une entreprise est de savoir si l’agent accomplit sa tâche efficacement, à grande échelle et avec un minimum de transferts vers des agents humains.
Associez votre usage aux deux ou trois mesures qui influencent vos objectifs commerciaux, puis évaluez les options selon ces critères.
Étape 4 : maîtriser votre budget de latence.
Fixez un budget pour chaque composant, par exemple :
- Détection des tours ASR : 50 ms
- TTCT (TTFS) de l’ASR : 200 ms
- Premier token du LLM : 300 ms
- Mise en mémoire tampon de la génération TTS pour le texte du LLM
- Premier audio TTS : 100 ms
- Chaîne complète : 500 ms de bout en bout
Attribuez ensuite un responsable à chaque ligne du budget. L’équipe vous dira sous deux semaines si 500 ms sont irréalistes en téléphonie. Cette friction est utile : elle révèle la véritable contrainte avant la mise en production.
Dernières réflexions
Créer des agents vocaux d’entreprise est plus difficile que ce qu’Internet laisse entendre.
Si vous achetez un produit ou dirigez une équipe d’ingénierie qui évalue des fournisseurs vocaux, demandez-vous quelle architecture répond à vos usages, à votre budget de latence et à vos exigences de conformité tout en respectant votre marque, même lorsque le client appelle d’une chambre d’hôtel sur une ligne fixe, avec un accent régional, et interrompt l’agent au milieu d’une phrase.
Il est tentant de choisir les modèles selon leur sonorité ou leurs résultats sur un benchmark nettoyé, puis de découvrir un P95 qui compromet des mois de travail et un développement coûteux.
Pour associer recherche IA avancée et pragmatisme commercial dans votre agent vocal d’entreprise, contactez-nous à business@cartesia.ai. Nous pouvons vous aider.