
Elegir modelos de voz con IA para empresas
Muchos equipos creen que crear un agente consiste en elegir una voz TTS que “suene profesional”, conectarla a su chatbot y a un LLM, y añadir reconocimiento automático del habla, ASR. Tras unos meses publican un prototipo que alcanza entre 600 y 800 ms de ida y vuelta en una habitación silenciosa con macOS.
Pero en una infraestructura telefónica real tarda entre 2 y 4 segundos, con P95 de hasta 5 segundos. P95 es el valor de latencia que no supera el 95 % de las llamadas. Si añadimos la menor calidad del audio telefónico a 8 kHz, la experiencia puede diferir mucho de la evaluación.
Es tentador elegir según pruebas de laboratorio. Sin embargo, las conversaciones reales son desordenadas y crear agentes empresariales es un problema difícil de ingeniería. No podemos tratar los modelos de voz como piezas intercambiables. Hay que elegirlos, analizarlos y medirlos para el uso previsto.
Un modelo que reproduce perfectamente un acento británico de radiodifusión para pódcasts de estudio puede fallar en el servicio telefónico de una aerolínea mediante PSTN. Otro que transcribe muy bien en el navegador puede tener dificultades para detectar intervenciones por teléfono. Uno que destaca al pulsar para hablar puede no distinguir si el usuario ha terminado o se ha quedado pensando.
Demostraciones y pruebas frente a la realidad
Las pruebas públicas son un punto de partida útil y válido, pero no deberían decidir por sí solas el proveedor. Hay que comprobar si representan el uso previsto. Muchos conjuntos contienen audio ideal: estudio, audiolibros e instrucciones guionizadas, sin muletillas, frases inconclusas, ruido ni silencios largos.
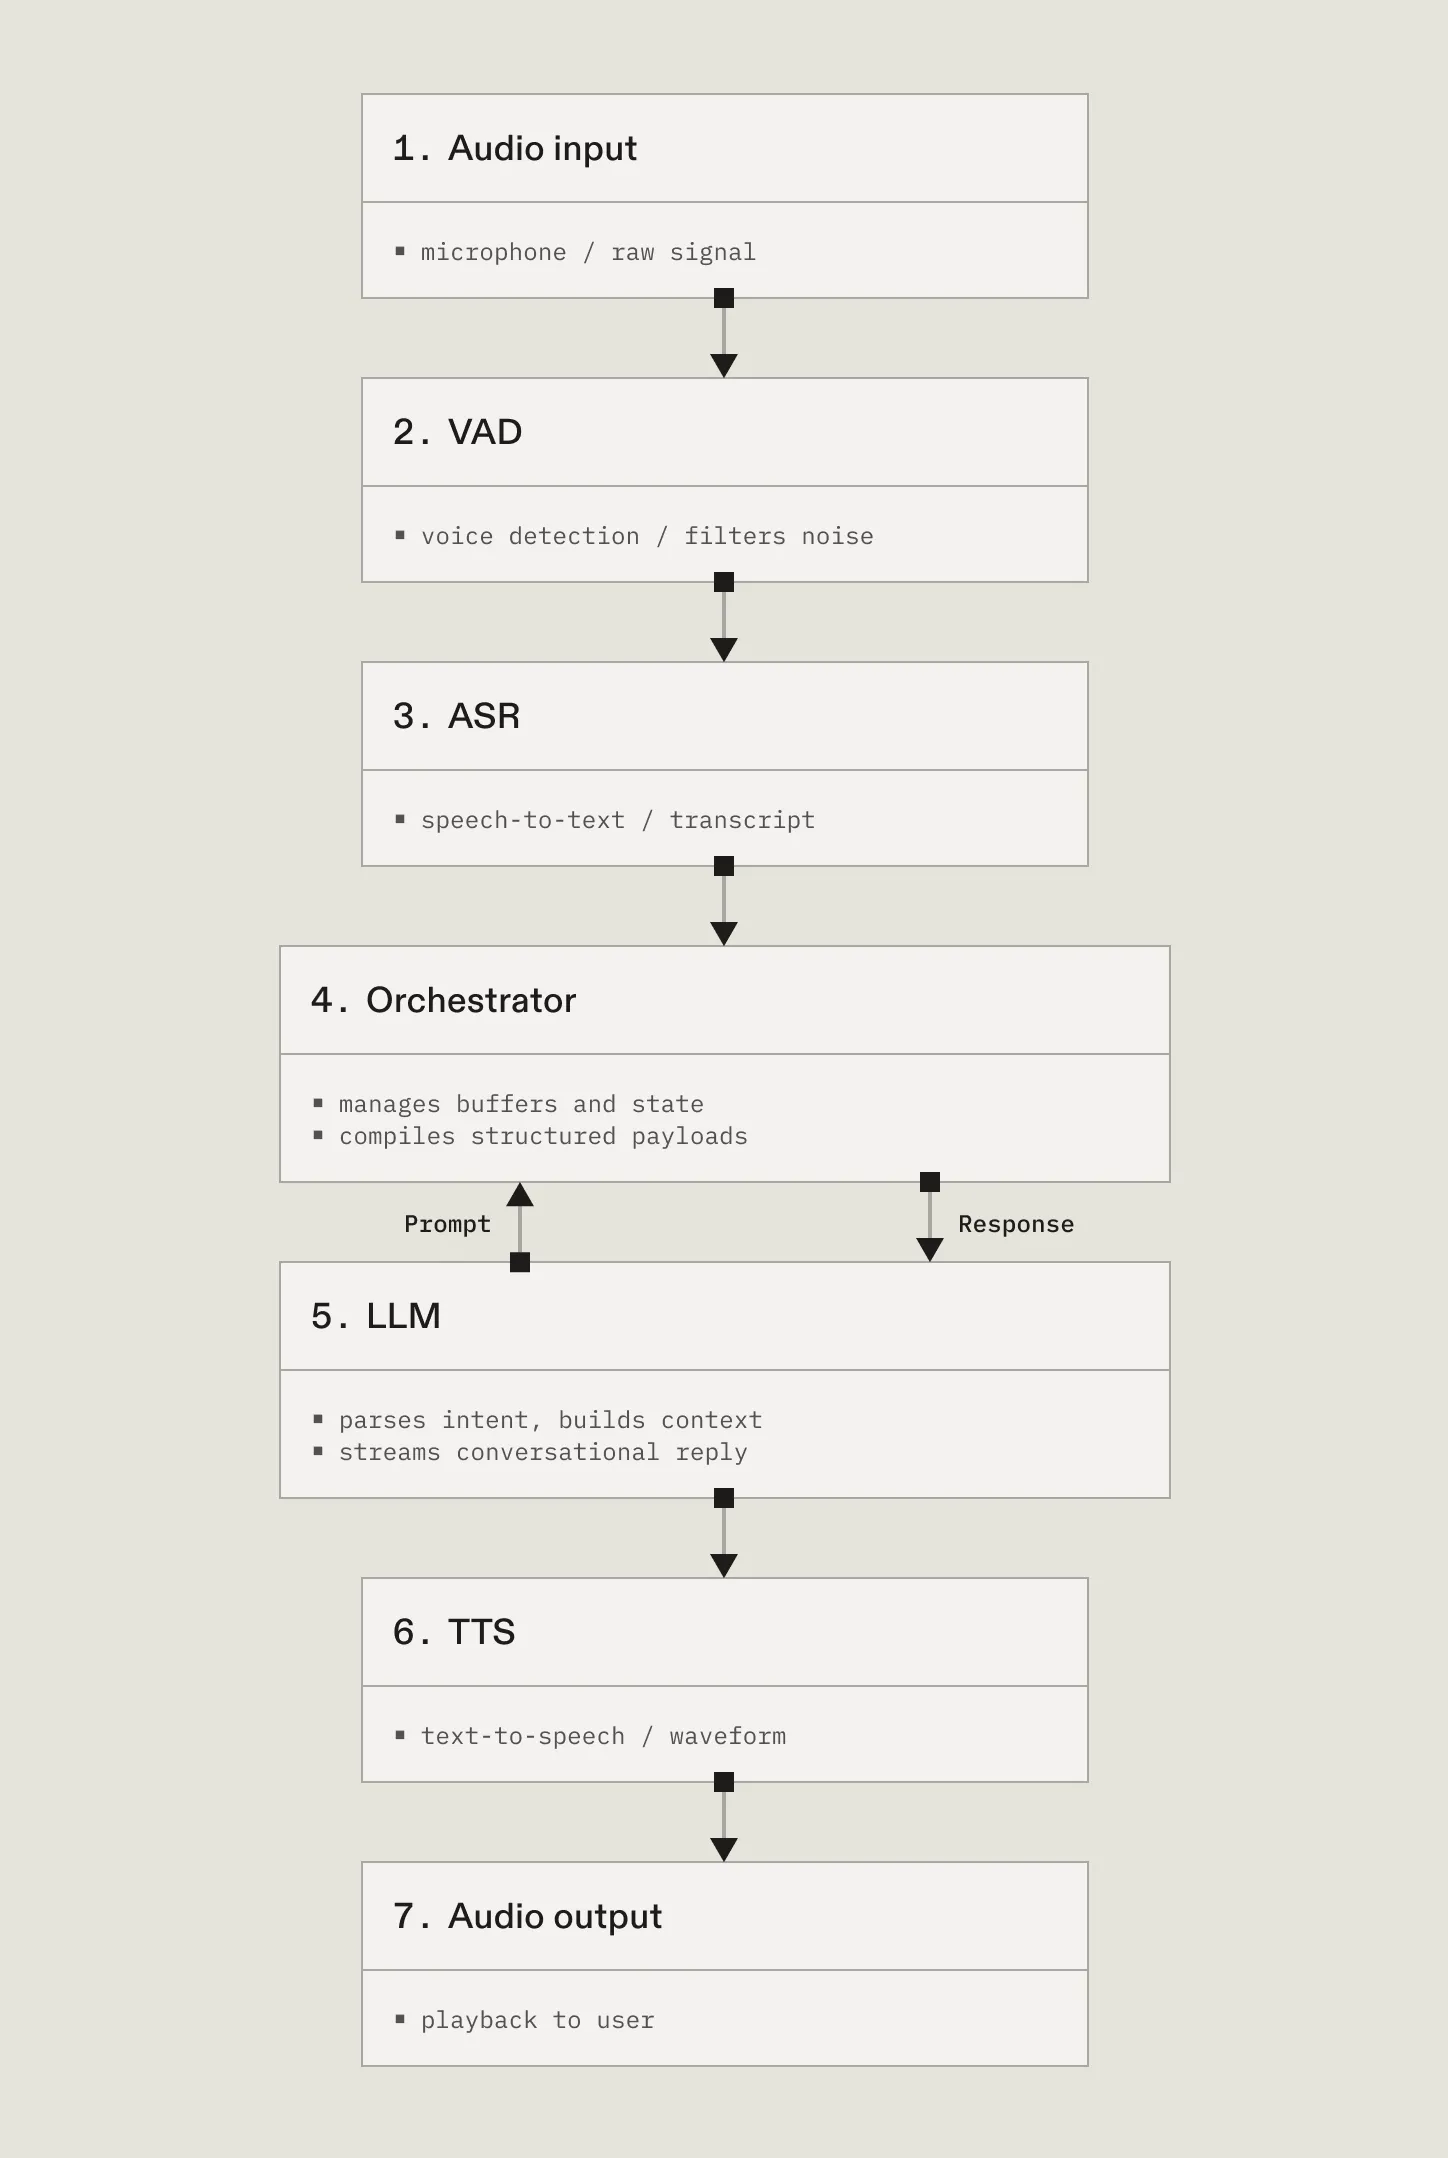
Cuando un cliente dice “eh, en realidad déjame [pausa larga] comprobar otra cosa…” mientras busca en su escritorio, un VAD basado en reglas puede emitir turn_ended por detectar una pausa y estar optimizado para reducir latencia. Eso activa la transcripción ASR, que llega al LLM para generar una respuesta. El texto se convierte inmediatamente en habla fluida y bien entonada. Suena bien, hasta que el usuario retoma la frase y el agente habla por encima.
Es muy difícil obtener legalmente audio realista a escala para entrenamiento y evaluación. Por eso muchas pruebas miden condiciones ideales en lugar de situaciones reales.
Si tu agente atenderá conversaciones telefónicas de clientes en entornos ruidosos, investiga si los modelos están diseñados para esas condiciones.
Qué significa elegir modelos de voz con IA
1. Evaluar el tiempo hasta completar la transcripción, no hasta el primer token
Muchos equipos miden ASR mediante TTFT, tiempo hasta el primer token, RTF, factor de tiempo real, o latencia media por palabra. Pero para agentes de voz en tiempo real pueden ser métricas poco útiles.
Creemos que importa TTFS, tiempo hasta el segmento final, también llamado TTCT o tiempo hasta completar la transcripción.
Es el intervalo entre el momento en que el usuario termina su turno y el momento en que el modelo entrega una transcripción definitiva en la que el agente LLM puede confiar. Determina si el agente parece presente o retrasado y afecta a la calidad de la siguiente intervención.
Por debajo de 200 ms, medidos de extremo a extremo y no por componente, la conversación se siente natural. Entre 500 ms y 1 s, el usuario nota el retraso, pero lo tolera. Por encima de 1 s, empieza a repetirse o a hablar al mismo tiempo que el agente. Los problemas se acumulan: el usuario alza la voz, el ASR se distrae con palabras anteriores, el LLM recibe una entrada errónea y todo el ciclo empeora.
2. Evaluar la detección de turnos y las interrupciones
La detección de turnos, también llamada endpointing, identifica cuándo ha terminado el usuario. Es difícil porque los modelos de voz a texto carecen de las señales visuales y otras pistas de una conversación humana. Una detección deficiente produce pausas incómodas y alta latencia.
La ausencia de señales visuales también obliga a la capa de orquestación a gestionar que el usuario retome el habla o interrumpa al agente. Un agente fiable cancela tanto la llamada al LLM como la generación TTS en curso cuando empieza un nuevo turno o se retoma uno que se dio por terminado.
Al evaluar latencia y fluidez, muchos equipos no advierten que están evaluando detección de turnos y precisión frente a exhaustividad. Lo descubren al depurar la distancia entre demostración y producción. Como en toda depuración, resulta más rápido y barato adelantar las pruebas y detectar el problema pronto.
La precisión refleja si el ASR detecta correctamente turn_start y turn_end. Un falso inicio interrumpe la transcripción y el proceso; un falso final puede hacer que el agente corte al usuario. La exhaustividad refleja si omite un inicio, perdiendo todo el turno, o un final, haciendo que el agente no responda.
Hoy es habitual que ASR incorpore detección de turnos. Lo que distingue a los mejores modelos es la precisión y la exhaustividad. Antes se sacrificaba una para mejorar la otra. Ahora Ink-2 de Cartesia ha establecido una nueva referencia al mantener altas ambas para el inicio y el final de turno.
Ink-2 utiliza el contexto hablado, además de la duración del silencio. Así distingue si lees un teléfono, dejas una frase a medias, piensas o has terminado.
3. Exactitud donde importa
La tasa de error de palabras, WER, engaña si analizas categorías de errores irrelevantes. También si comparas ASR sin streaming, donde lograr exactitud es más fácil, con ASR en streaming. Muchas pruebas no distinguen ambos usos.
Conviene medir WER por categoría de entrada. Una media oculta problemas con teléfonos, nombres o UUID. El mismo modelo puede tener un 2 % de WER en teléfonos y un 23 % en habla con acento. Medicina y derecho tienen vocabulario especializado que las pruebas de consumo quizá ni midan.
Si atiendes llamadas de clientes de distintas regiones, la WER con acentos importa más que la de transcripciones limpias de resultados empresariales solo en inglés.
Quizá solo necesites una WER baja en algunas categorías. Saberlo ayuda a evaluar compensaciones con otras métricas. Si las pruebas no incluyen los datos que encontrarás, carecen de significado para ti.
En TTS, WER mide la inteligibilidad del habla sintetizada frente al texto. Importan coherencia, pronunciación, ritmo, prosodia y tratamiento de números, acrónimos, importes y cantidades. Por ejemplo, “March 3rd” frente a “03/03” o “twelve hundred dollars” frente a “$1,200”. También importa pronunciar el vocabulario especializado del caso de uso.
Para medir la exactitud:
- Identifica las categorías de rendimiento que te importan.
- Mídelas por separado en distintos escenarios.
- Examina los resultados de todas las categorías y situaciones.
- Elige el modelo que responda bien a tus necesidades.
Elegir las métricas que influyen en los resultados y examinar las pruebas con criterio es necesario para acertar con los modelos.
4. Clonar voces
Muchos clientes prefieren voces clonadas para mantener continuidad entre sus interacciones humanas actuales y las que diseñan con agentes.
Cartesia ofrece clonación instantánea, IVC, a partir de 5 segundos de audio, y clonación profesional, PVC, con más de 30 minutos.
Los clientes empresariales deben comprender qué cualidades hacen adecuada una voz y cuáles hay que conservar y optimizar.
La localización a otros idiomas para que suene nativa también tiene implicaciones de diseño y habla. Definir expectativas sobre localización, ajuste de acento y pronunciaciones personalizadas ayuda a diseñar agentes eficaces, porque estos atributos influyen mucho en la conversación.
5. Controles de diseño de voz
Todas las plataformas ofrecen alguna forma de controlar velocidad, volumen y emoción en TTS.
Sonic-3.5 de Cartesia va más allá. Puedes configurarlos, pero Sonic expresa emociones acordes con el texto y descarta configuraciones incompatibles con su significado.
Si quieres empatía, el LLM debe generar texto empático. El diseño de voz tiene así en cuenta el contexto y está ligado a la generación del LLM.
Relacionar la voz con sus entradas de texto aporta flexibilidad al elegir el LLM y adaptar la personalidad del sistema al uso previsto.
Cartesia también diseña cada voz con una expresividad de base adecuada a ciertos usos. Una voz de “persona resolutiva y alegre” suena distinta de una de “confidente de confianza”. Elige la voz según la emoción necesaria y adapta después las instrucciones del LLM.
Un método para elegir
Crear agentes conversacionales eficaces es un logro técnico difícil. Esto hemos observado en nuestros clientes con mejores resultados.
Paso 1. Define objetivos y relaciónalos con características de voz.
Un ejemplo de relaciones posibles:
| Caso de uso | Velocidad de voz | Emoción / temperatura | Tiempo de respuesta | Referencia |
|---|---|---|---|---|
| Ventas salientes | 1.1× a 1.3×, urgente y ágil | Alta, cálida y entusiasta | Medio-rápido, 300-500 ms | |
| Atención al cliente | 0.8× a 1.0×, medida y calmada | Baja a media, estable y tranquilizadora | Medio, 500-650 ms, espacio para pensar | |
| Cobros / cumplimiento | 0.9× a 1.0×, clara y firme | Baja, controlada y profesional | Lento, 650-800 ms, deja terminar las frases | |
| Aplicación de meditación | 0.7× a 1.0×, calmada | Baja, relajante y tranquilizadora | Lento-medio, 650-400 ms, sin prisa y relajado |
Si creas un sistema de citas médicas, un teléfono incorrecto o una fecha mal entendida pueden provocar un incidente de cumplimiento y perder una venta. Para un IVR de cobro de tarjetas, la exactitud importa más que el entusiasmo.
Empieza por la peor llamada posible y analiza qué provoca los resultados indeseados.
Paso 2. Comprueba si las pruebas públicas evalúan lo que necesitas.
Una prueba carece de valor si sus datos no representan tu realidad comercial. Incluso puede ser contraproducente cuando algo atractivo causa problemas de fiabilidad, como baja latencia lograda cerrando turnos demasiado pronto, con interrupciones o entradas erróneas para herramientas.
Muchos conjuntos públicos tienen etiquetas incorrectas, audiolibros antiguos, clips cortos a mitad de frase, grabaciones de estudio o lecturas en voz alta porque son fáciles de obtener. A menudo no reflejan producción. Los modelos pueden sobreajustarse hasta aprender etiquetas erróneas a partir de artefactos, sin comprender el habla.
Quizá esos datos apenas se parezcan al entorno de tu agente.
Una buena estrategia es someter a los proveedores a pruebas adversariales. Dales 50 llamadas reales de tus clientes, con ruido, acentos, habla superpuesta, nombres de productos y silencios al pasar de escribir a hablar. Analiza durante varias semanas el rendimiento completo y la sensación de uso.
Puedes ampliar este enfoque con Voice Sims de Sierra, que simula personas con distintos idiomas, necesidades, ubicaciones, emociones y situaciones: en casa con la televisión, en la calle o en un tren.
Paso 3. Identifica las métricas de las que depende tu caso de uso.
No todas importan ni lo hacen por igual. Un agente de citas médicas necesita baja WER en terminología y datos estructurados, como medicamentos, fechas y dosis. Uno de ventas salientes de gran volumen prioriza latencia completa y exactitud de interrupciones. Uno de cobros sujeto a cumplimiento necesita turnos fiables que no corten una comunicación legal obligatoria. La medida final es si resolvió el trabajo con eficiencia, a escala y con mínima derivación a personas.
Relaciona tu uso con las dos o tres métricas que influyen en los objetivos comerciales y evalúa según ellas.
Paso 4. Responsabilízate del presupuesto de tiempo.
Fija un presupuesto de latencia por componente, por ejemplo:
- Detección de turnos ASR: 50 ms.
- TTCT de ASR, o TTFS: 200 ms.
- Primer token del LLM: 300 ms.
- Búferes de generación TTS para texto procedente del LLM.
- Primer audio TTS: 100 ms.
- Proceso completo: 500 ms de extremo a extremo.
Asigna responsables a cada partida. El equipo te dirá en dos semanas si 500 ms es irreal con telefonía. Esa dificultad ayuda a identificar la limitación antes de producción.
Reflexiones finales
Crear agentes de voz empresariales es más difícil de lo que parece en internet.
Si compras producto o diriges ingeniería, pregunta qué arquitectura resuelve tus usos, presupuesto de latencia y requisitos de cumplimiento con la voz de tu marca, incluso cuando el cliente llama desde el fijo de un hotel, tiene acento regional e interrumpe a mitad de frase.
Es tentador elegir por cómo suena una voz o por una prueba ideal y descubrir después que P95 invalida meses de desarrollo costoso.
Si buscas combinar investigación avanzada en IA y criterio comercial práctico para crear tu agente empresarial, escribe a business@cartesia.ai. Podemos ayudarte.