


지난해 말 공개한 ICLR 논문과 블로그 글에서 Mamba, RWKV, Hyena, RetNet 같은 효율적인 아키텍처가 회상 능력에서는 Transformer보다 뒤처진다는 결과를 공유했습니다. 회상은 문맥에서 본 정보에 근거해 생성하는 능력으로, 인컨텍스트 학습과 복사에 중요합니다. 이 분석으로 Based라는 새 아키텍처를 설계했고 이 글에서 먼저 소개했습니다. 이번에는 최근 성과를 공유합니다.
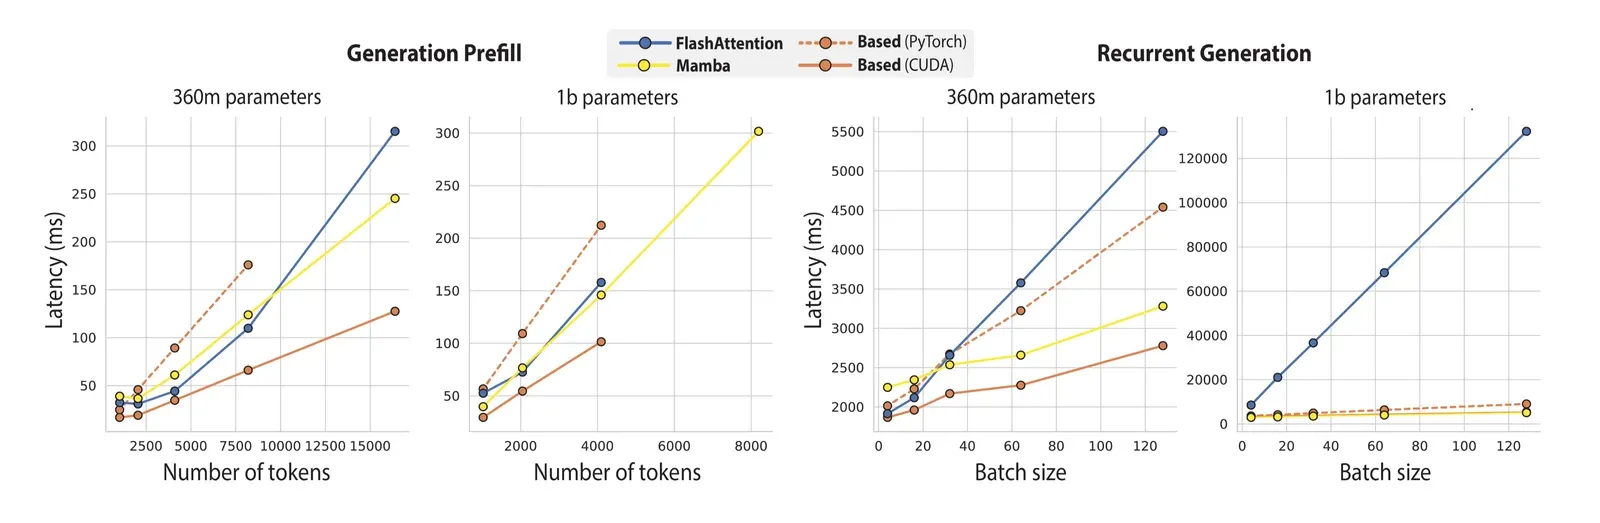
최근 연구에서는 회상 문제를 더 깊이 살폈습니다. 먼저 회상 능력과 생성 중 메모리 소비 사이의 근본적인 상충 관계를 보여줍니다. 이를 바탕으로 설계한 Based는 단순한 순환 아키텍처이면서, 정보 추출과 독해 등 회상이 중요한 실제 작업 및 인컨텍스트 학습에서 기존의 이차 미만 복잡도 모델을 앞섭니다. 생성 속도도 빠릅니다. 프롬프트 처리에서 FlashAttention-2보다 56%, Mamba보다 44% 빠르고, 텍스트 생성 처리량은 FlashAttention-2보다 24배 높습니다.
특히 Based의 단순함이 마음에 듭니다. 아주 작은 창의 슬라이딩 윈도 어텐션과 exp(QK^T)를 테일러 급수로 근사한 선형 어텐션, 익숙한 두 구성 요소만 사용합니다. 이것으로 언어 모델링에서 강력한 이차 미만 복잡도 아키텍처를 앞서고 최적화된 Transformer보다 크게 빨라질 수 있습니다.
이 글에서는 Based 설계로 이어진 회상 분석과 Based를 빠르게 실행하는 방법을 소개합니다.
출발점: 회상과 메모리의 상충 관계
연구를 이끈 질문은 다음과 같습니다.
회상과 인컨텍스트 학습 능력을 희생하지 않고 언어 모델의 실제 속도와 메모리 사용량을 크게 개선할 수 있을까요?
답하려면 먼저 무엇이 아키텍처를 느리게 하는지 생각해야 했습니다. Mamba 같은 효율적 아키텍처가 추론에서 Transformer보다 훨씬 빠른 이유, 예를 들어 처리량이 5배 높은 이유는 메모리 사용량이 작은 데 크게 있습니다. 메모리를 적게 쓰면 배치를 늘리고 I/O를 줄일 수 있습니다. 하지만 너무 줄이면 앞에서 본 정보를 회상하는 능력이 떨어질 수 있다는 직관도 자연스럽습니다. 공짜 이득은 없는 상황처럼 보여서 여러 인기 아키텍처의 메모리에 영향을 주는 하이퍼파라미터를 바꿔 어려운 합성 연관 회상 작업에서 평가했습니다.
모든 아키텍처에 근본적인 상충 관계가 있었습니다. 추론 중 메모리를 적게 쓸수록 연관 회상 성능이 나빴습니다. 토큰을 하나씩 순환적으로 생성할 때 이전 토큰을 표현하는 바이트 수, 즉 순환 상태 크기에 집중했습니다.
어텐션에서 상태는 보통 KV 캐시라 부르며 시퀀스 길이에 따라 커집니다. 그림 1 오른쪽 위에서 어텐션은 완벽하게 회상하지만 순환 상태가 매우 큽니다. 슬라이딩 윈도 어텐션으로 KV 캐시 크기를 제한할 수 있으나, 상태를 줄이면 회상 성능도 빠르게 떨어집니다. 그림 1의 연한 파란색처럼 상태가 1MB일 때 100%에서 65 KB일 때 50%로 내려갑니다.
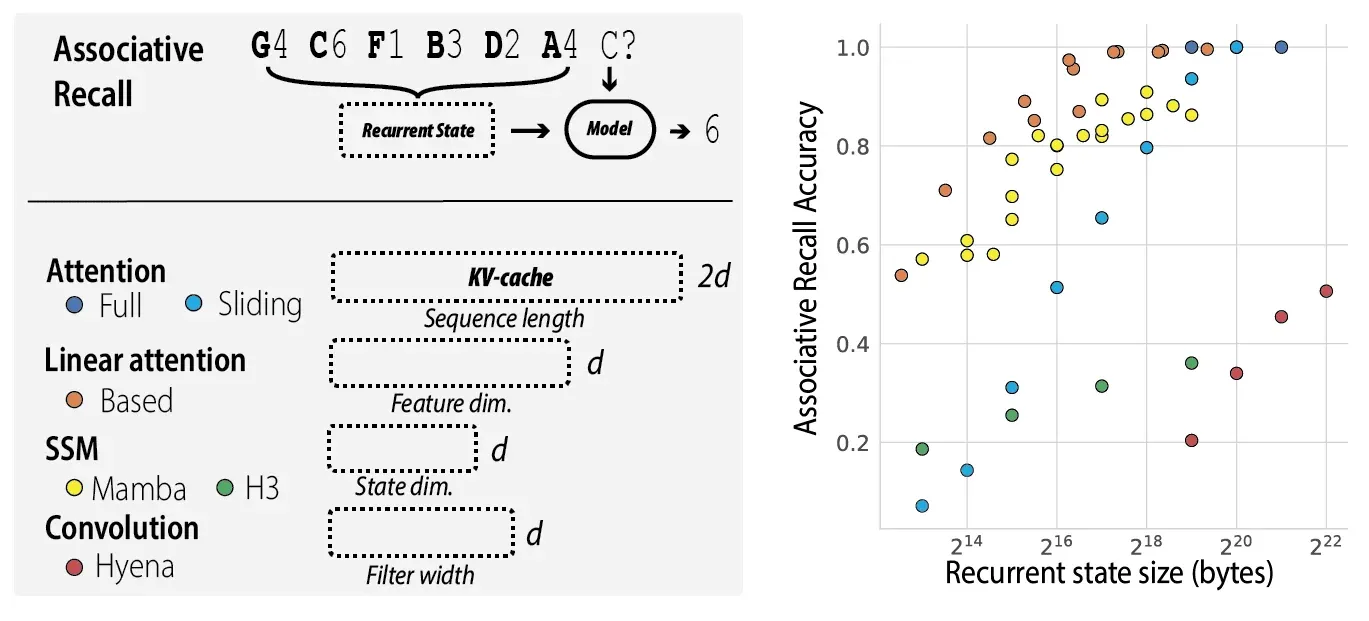
Mamba는 슬라이딩 윈도 어텐션보다 회상과 메모리의 파레토 프런티어를 넓힙니다. 제한된 순환 상태를 더 잘 활용한다는 뜻입니다.
그렇다면 더 단순하면서도 파레토 프런티어를 넓힐 다른 모델은 없을까요?
Based: 파레토 프런티어의 단순한 모델
먼저 softmax 어텐션의 가장 단순한 대안들이 왜 좋은 균형을 찾지 못하는지 연구했습니다. 현재와 미래 하드웨어에서 잘 확장되는 기본 연산을 찾는 것도 설계 원칙이었습니다. 예를 들어 최신 GPU의 Tensor Core를 활용하면 좋습니다. 이 전용 하드웨어는 16x16 행렬의 곱셈 GEMM을 기본 CUDA 코어보다 16배 빠르게 수행할 수 있습니다.
ICLR 논문에서는 H3나 Hyena처럼 합성곱 관점으로 볼 수 있는 모델이 왜 회상에 어려움을 겪는지 자세히 분석했습니다. 다음으로 두 가지 단순한 효율적 어텐션, 슬라이딩 윈도 어텐션과 softmax가 없는 선형 어텐션을 검토했습니다.
최대 1.4bn 파라미터의 실제 언어 모델링과 합성 연관 회상 실험에서 어느 하나만으로는 파레토 프런티어를 충분히 탐색하지 못했습니다.
- 순수 선형 어텐션은 밀집 어텐션만큼 정밀한 국소 토큰 이동과 비교를 수행하기 어려웠습니다. 이 능력은 회상에 중요합니다. Fu et al., 2023과 Arora et al., 2023a를 참고하세요. 그래도 이전 이차 미만 복잡도 아키텍처보다 개선되었습니다. 외운 지식 대신 이전 문맥을 써야 하는 Pile 테스트의 회상 중심 구간에서 355M 순수 선형 어텐션은 RWKV-v5보다 0.1 ppl, H3보다 2.6 ppl 좋았습니다. 논문의 표 1을 참고하세요. 이 구간에서 Mamba의 2.21 ppl과 순수 선형 어텐션의 2.29 ppl은 비슷합니다. 하지만 Transformer의 1.87 ppl과는 상당한 차이가 있습니다.
- 슬라이딩 윈도 어텐션은 창 안의 토큰만 회상할 수 있습니다. 그림 2 가운데를 보세요. 창을 키우면 순환 상태가 선형으로 커지고, 병렬 학습과 추론 속도에는 비선형 영향을 줍니다. 그림 2 왼쪽을 참고하세요.
두 연산은 서로 보완합니다. 선형 어텐션은 먼 토큰 간 상호작용을, 슬라이딩 윈도는 가까운 토큰 간 상호작용을 모델링합니다. 이를 하나로 합친 것이 그림 2 오른쪽의 Based입니다.
- 슬라이딩 윈도 어텐션은 연관 회상에 필요한 정밀한 국소 이동을 수행합니다. Mistral-7B나 최근 제안된 Griffin보다 훨씬 작은 창을 씁니다. 실험에서는 64였습니다. 큰 창이 품질에 유리해도 실제 실행 시간과 균형을 맞추려 합니다. 위 그림 왼쪽을 보면 16x16과 64x64 행렬 곱셈의 지연 시간이 대체로 같고 64를 넘으면 창 크기에 따라 비선형으로 늘어납니다. 64x64가 GPU Tensor Core 점유율을 충분히 높여 포화시키므로 두 크기의 시간이 비슷합니다.
- 선형 어텐션은 고정 크기 순환 상태로 전역 토큰 상호작용을 지원합니다. softmax 어텐션과 달리 상태 크기는 시퀀스 길이가 아니라 특징 맵 같은 하이퍼파라미터에 따라 정해집니다. 따라서 상충 관계를 연속적으로 조정할 수 있습니다. 이전 선형 어텐션 연구에서 처음 사용한 지수 함수의 테일러 근사를 특징 맵으로 사용합니다.
Based의 순환 상태 크기는 어텐션처럼 시퀀스 길이에 따라 늘지 않습니다. 선형 어텐션의 특징 차원과 창 크기로 정해집니다. 이 하이퍼파라미터로 회상과 처리량을 조정하며 그림 1의 파레토 프런티어를 탐색할 수 있습니다.
단순하지만 최소 1.3 billion 파라미터까지의 실제 언어 모델링에서 Based는 전체 Pile 퍼플렉서티와 LM eval harness의 표준 zero-shot 벤치마크에서 Mamba와 경쟁합니다. 그림의 Question Answering - Common에 표시되어 있습니다.
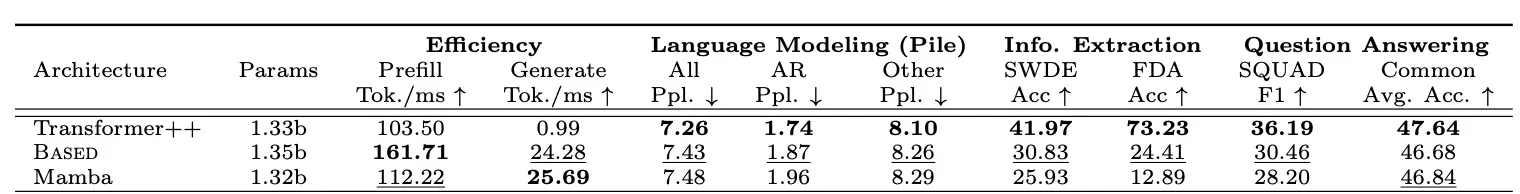
흔히 쓰는 zero-shot 벤치마크는 텍스트가 매우 짧아 회상 능력을 충분히 시험하지 못합니다. 이를 보완하려고 긴 문서의 정보를 회상해야 하는 작은 규모의 실제 회상 중심 벤치마크 모음을 구성했습니다. FDA 문서와 원시 HTML에서 정보 추출, 독해 등이 포함됩니다. Based는 이 작업에서 가장 강력한 이차 미만 복잡도 아키텍처로, 평균 정확도가 Mamba보다 6.22점 높습니다. 하지만 둘 다 가장 강력한 Transformer 기준선에는 뒤처지며 차이가 큰 경우도 있습니다. 앞서 관찰한 공짜 이득은 없다는 사실과 일치합니다.
이 균형점에 도달할 아키텍처가 Based뿐이라고 생각하지는 않습니다. 논문에서는 슬라이딩 윈도 어텐션을 필터 크기 3의 짧은 합성곱으로 바꿔도 퍼플렉서티 0.1점 이내의 비슷한 성능을 보였습니다. 다른 많은 아키텍처도 이 파레토 프런티어에 도달하거나 더 넓힐 수 있기를 기대합니다.
고정 크기 순환 상태를 사용하는 방법도 중요합니다
같은 은닉 상태 크기를 가진 순환 아키텍처는 많지만, 특징 맵과 상태 업데이트 방식 같은 특징화도 중요합니다. Based의 맵은 고등학교 미적분만 알면 이해할 만큼 단순합니다. 지수 함수를 테일러 급수로 근사합니다. ϕ(q)ϕ(k)^T ≈ exp(qk^T)가 되도록 ϕ를 계산합니다. 이전 연구처럼 exp(x)=1+x+x^2/2인 2차 테일러 급수만 사용합니다. x의 차원이 d′이면 x^2의 차원은 d′^2입니다. 키와 값의 외적 결과는 d′에 따라 빠르게 커져 Based의 상태 크기를 늘립니다.
품질에서 특징화 선택과 상태 크기 확대는 각각 얼마나 중요할까요? 모델이 상태를 효과적으로 사용하는 능력이 핵심입니다. 정확도와 상태 크기 곡선에서 테일러 맵의 여러 대안은 파레토 프런티어 아래에 있습니다. 아래에서는 학습된 투영으로 상태를 키운 뒤 Performer, CosFormer, PosELU 특징 맵을 적용한 모델과 비교합니다. 연관 회상용 MQAR 합성 테스트에서 학습하고 모든 점에 대해 학습률 하이퍼파라미터를 탐색했으며, 테일러 맵이 가장 효과적이었습니다. 실제 Pile 언어 모델링에서도 같은 경향이 나타납니다. 자세한 내용은 논문을 참고하세요.
I/O와 데이터 흐름을 고려한 구현
다음 질문은 실제 실행 시간에서 Based를 어떻게 경쟁력 있게 만들지입니다. 선형 어텐션은 이론상 시퀀스 길이에 대해 표준 어텐션보다 효율적이지만, 기존 구현은 FlashAttention처럼 최적화된 구현보다 느린 경우가 많습니다.
Based는 2차 테일러 근사로 키 차원을 확장하므로 상태가 크고 메모리 사용량도 큽니다. 시퀀스 길이 N, 키 차원 d′, 값 차원 d에 대해 O(Nd′^2d)입니다. 큰 키-값 상태 때문에 단순한 테일러 선형 어텐션 구현은 상당히 느립니다.
GPU에는 소량의 빠른 메모리인 스레드별 레지스터와 SRAM을 쓰는 워프 32스레드 수준 공유 메모리, 그리고 대량의 느린 HBM이 있습니다. 효율성을 높이려면 HBM과 SRAM 사이, SRAM과 레지스터 사이의 읽기·쓰기를 줄여야 합니다. 새 I/O 인식 알고리즘은 테일러 선형 어텐션의 순전파와 추론에서 HBM→SRAM 이동을 O(Nd′^2)바이트, SRAM→레지스터 이동을 O(Nd′^2d)바이트 줄입니다. 실험에 사용한 특징 차원 d′ = 16에서는 KV 상태를 스레드 레지스터 안에 유지할 수 있습니다.
아래는 시퀀스 길이 1024에서 배치 크기에 따라 단순 테일러 어텐션 순전파, Fast Transformers의 선형 어텐션 커널을 활용한 구현, 맞춤 커널을 비교한 결과입니다.
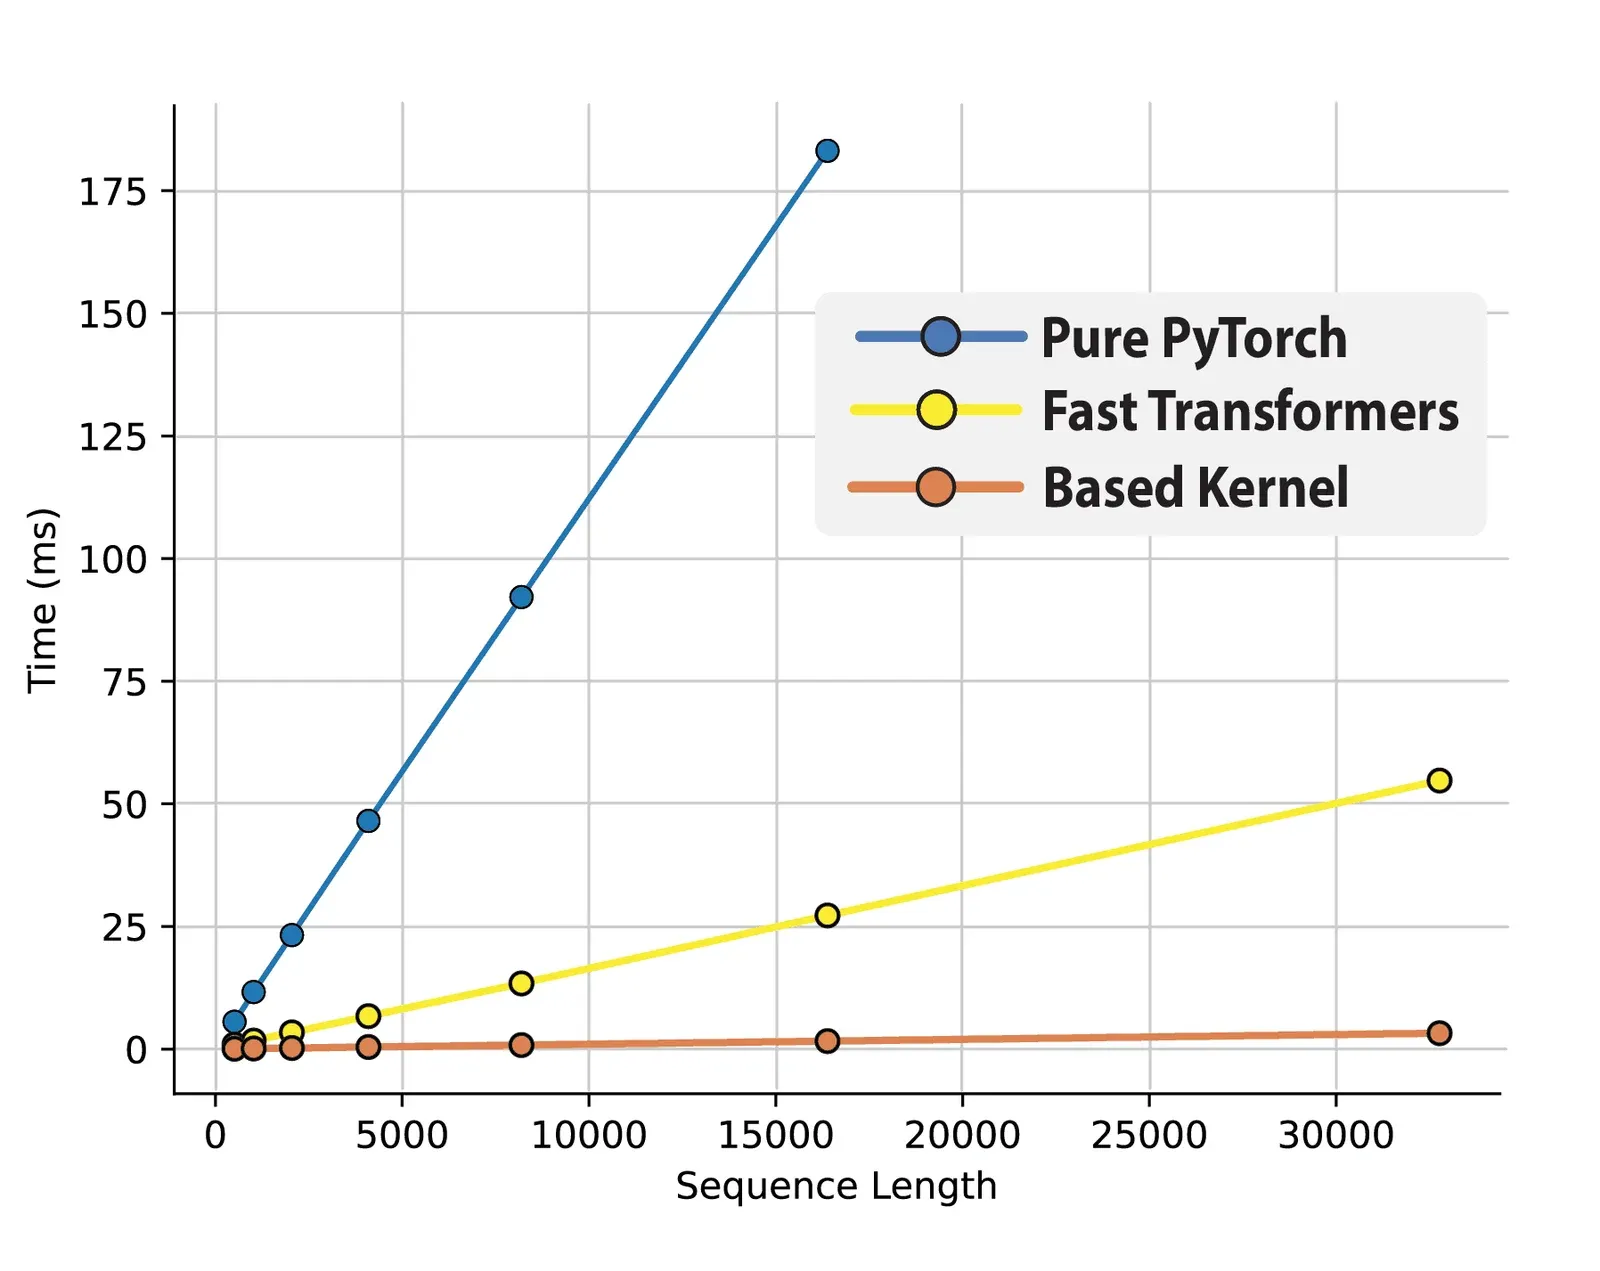
그다음 I/O 인식 알고리즘으로 FlashAttention-2, Mamba, Based의 360M 및 1.3Bn 파라미터 모델의 전체 생성 속도를 비교했습니다. 프리필 배치 크기는 2로 고정하고 다음 토큰 예측으로 1024토큰을 생성합니다. Based의 처리량은 FlashAttention-2보다 최대 24배 높았습니다.
곧 더 공유하겠습니다
이 알고리즘은 연구실에서 개발 중인 새 CUDA DSL ThunderKittens로 구현했습니다. CUDA 개발을 더 쉽게 만들 수 있기를 바랍니다. 사용자가 수행할 연산 범위에 자체 판단을 적용하는 Triton과 달리 이 DSL은 C++에 내장됩니다. 공개하고 피드백을 받고 싶습니다. 앞으로 몇 주 동안 “하드웨어는 어떤 모델을 원하는가?”라는 질문을 바탕으로 모델 결과물도 더 준비하고 있습니다.
체크포인트와 평가는 Hugging Face와 코드 저장소 https://github.com/HazyResearch/based에서 사용해 볼 수 있습니다.