


En un artículo de ICLR y una entrada del blog publicados a finales del año pasado, mostramos que muchas arquitecturas eficientes, como Mamba, RWKV, Hyena y RetNet, rinden peor que los Transformers al recuperar información del contexto. Esta capacidad permite fundamentar las generaciones en información ya vista y es esencial para aprender del contexto y copiar. Usamos ese análisis para diseñar Based, que presentamos inicialmente en esta entrada. Hoy compartimos los últimos avances.
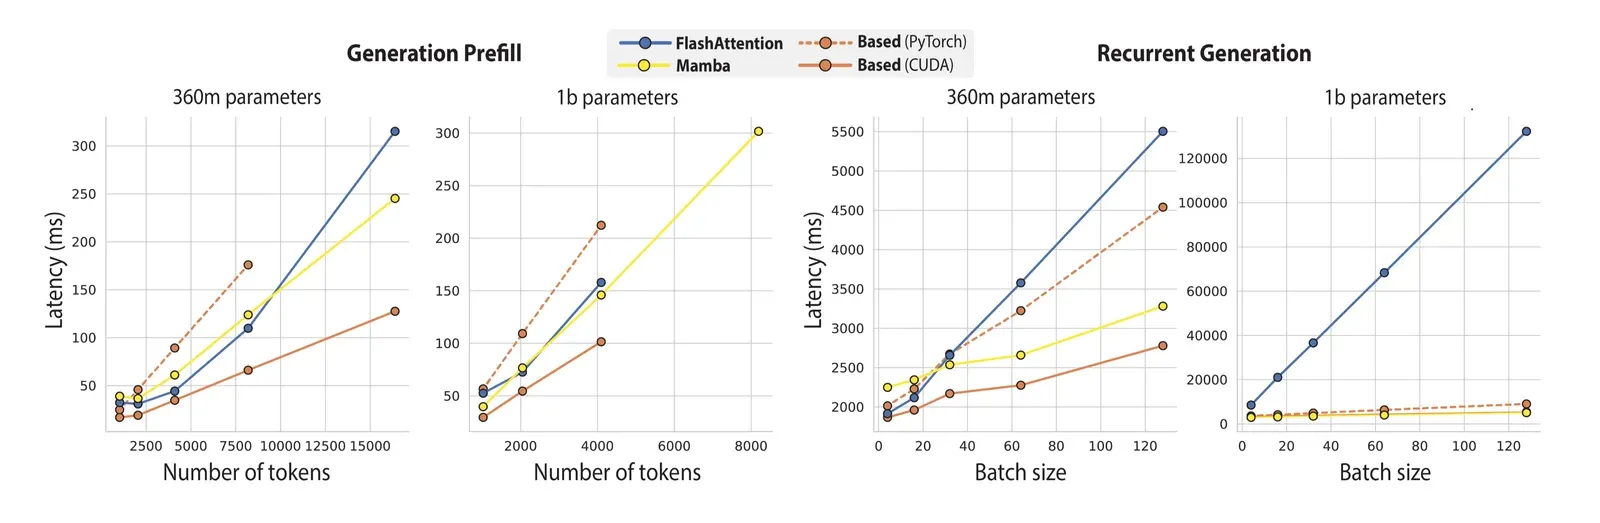
Nuestro trabajo reciente profundiza en este problema. Primero mostramos un equilibrio fundamental entre la capacidad de recuperar información y el consumo de memoria durante la generación. Este análisis guía el diseño de Based, una arquitectura recurrente sencilla que supera a modelos subcuadráticos anteriores en tareas reales que requieren recuperar información, como extracción de datos y comprensión lectora, y en aprendizaje en contexto. Además, genera rápido: procesa instrucciones un 56 % más rápido que FlashAttention-2 y un 44 % más rápido que Mamba. Based alcanza una capacidad de generación de texto 24 veces superior a FlashAttention-2.
Nos interesa especialmente la sencillez de Based. Con solo dos componentes conocidos, atención de ventana deslizante con ventanas muy pequeñas y atención lineal con una aproximación por series de Taylor de exp(QK^T), superamos a las arquitecturas subcuadráticas más potentes en modelado del lenguaje y aceleramos enormemente la ejecución frente a Transformers optimizados.
Esta entrada explica el análisis de recuperación de información que llevó al diseño de Based y cómo conseguimos que funcione tan rápido.
El análisis inicial: equilibrio entre recuperación de información y memoria
Nuestra pregunta principal es:
¿Podemos mejorar drásticamente la velocidad real y el consumo de memoria de los modelos de lenguaje sin perjudicar la recuperación de información ni el aprendizaje en contexto?
Para responder, empezamos por qué ralentiza las arquitecturas. Las eficientes, como Mamba, son mucho más rápidas en inferencia que los Transformers, por ejemplo con cinco veces más capacidad de procesamiento, en gran parte porque usan menos memoria. Menos memoria permite lotes mayores y menos operaciones de entrada y salida. Pero reducirla demasiado también puede perjudicar la capacidad de recordar información anterior de la secuencia. Parecía un caso clásico en el que nada sale gratis. Tomamos varias arquitecturas populares, variamos los hiperparámetros que afectan a la memoria y evaluamos una tarea sintética exigente de recuperación asociativa.
El equilibrio entre recuperación y memoria. Todas las arquitecturas seguían una relación fundamental: cuanto menos memoria consumía el modelo durante la inferencia, peor rendía en recuperación asociativa. Nos centramos en el tamaño del estado recurrente, los bytes que representan los tokens anteriores al generar uno a uno de forma recurrente.
En atención, el estado suele llamarse caché KV y crece con la longitud de la secuencia. En la parte superior derecha de la figura 1, la atención recupera información perfectamente, pero a costa de un estado enorme. La atención de ventana deslizante limita la caché KV, aunque su rendimiento cae rápidamente al reducir el estado. Por ejemplo, pasa del 100 % con 1 MB al 50 % con 65 KB, como muestra la curva azul claro de la figura 1.
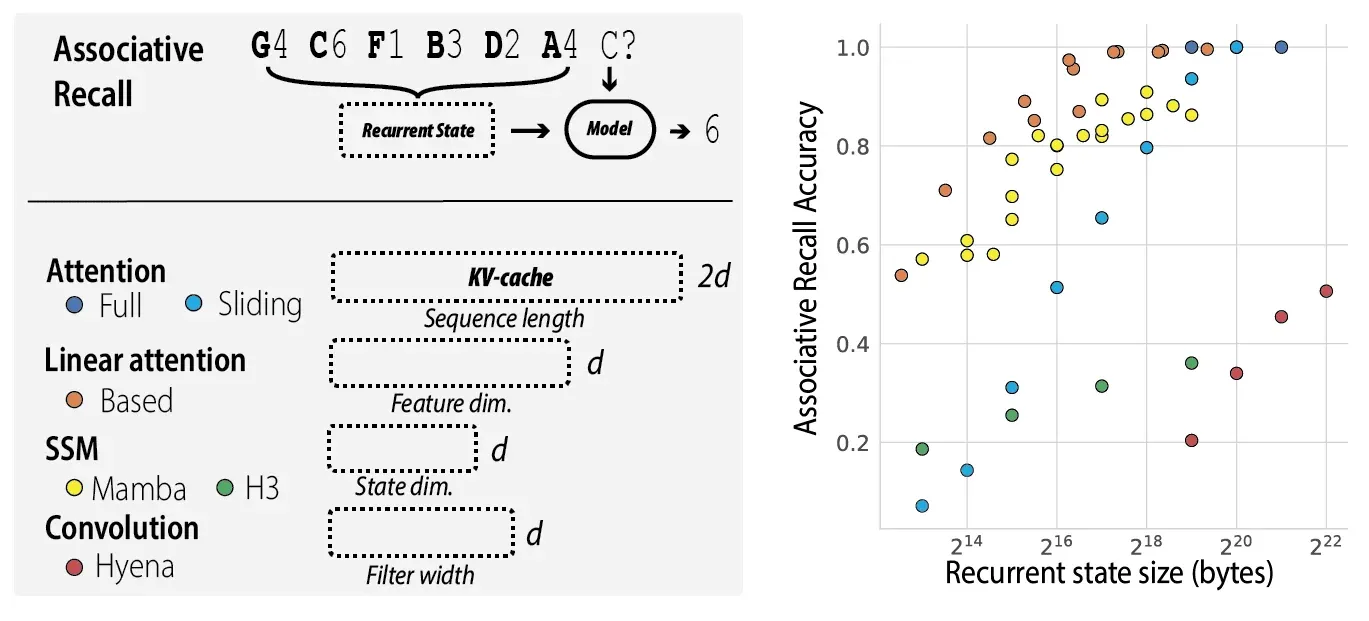
Observamos que Mamba amplía la frontera de Pareto de esta relación respecto a la atención de ventana deslizante. Esto significa que aprovecha mejor un estado recurrente limitado.
La siguiente pregunta es si existen otros modelos, quizá más sencillos, que también amplíen esa frontera.
Based: un modelo sencillo en la frontera de Pareto
Empezamos por estudiar por qué las alternativas más sencillas a la atención softmax no logran un equilibrio favorable. También buscamos componentes que escalaran bien en hardware actual y futuro. Por ejemplo, sería útil aprovechar los Tensor Cores de las GPU, hardware especializado capaz de multiplicar matrices de 16×16 hasta 16 veces más rápido que los núcleos CUDA habituales.
En nuestro artículo de ICLR analizamos por qué los modelos con una interpretación convolucional, como H3 o Hyena, tienen dificultades para recuperar información. Después consideramos dos técnicas sencillas de atención eficiente: la atención de ventana deslizante y la atención lineal, es decir, atención sin softmax.
Nuestros experimentos de modelado real del lenguaje, hasta 1.400 millones de parámetros, y de recuperación asociativa sintética sugirieron que ninguno de estos componentes bastaba por sí solo.
- Los modelos de atención lineal pura tenían dificultades para desplazar y comparar tokens locales con precisión, habilidades importantes para recuperar información, según Fu et al., 2023, y Arora et al., 2023a, y que la atención densa realiza mejor. Aun así, nuestro modelo lineal puro mejora arquitecturas subcuadráticas anteriores. En la parte del conjunto de prueba Pile que exige usar contexto previo en vez de conocimiento memorizado, el modelo lineal de 355 millones de parámetros supera a RWKV-v5 en 0,1 puntos de perplejidad y a H3 en 2,6, como indica la tabla 1 del artículo. Es incluso comparable a Mamba: 2,21 para Mamba frente a 2,29 para atención lineal pura. Pero sigue lejos del 1,87 de los Transformers.
- Con atención de ventana deslizante, el modelo solo recupera tokens dentro de la ventana, como muestra el centro de la figura 2. Aumentarla hace crecer linealmente el estado recurrente y afecta de forma no lineal a la velocidad del entrenamiento paralelo y la inferencia, como muestra la izquierda de esa figura.
Sin embargo, ambos componentes se complementan: la atención lineal modela interacciones lejanas y la ventana deslizante, interacciones locales. Los combinamos en Based, representado a la derecha de la figura 2.
- La ventana deslizante permite los desplazamientos locales precisos necesarios para la recuperación asociativa. Usamos ventanas pequeñas, de 64 en nuestros experimentos, frente a las mayores de Mistral-7B y el reciente Griffin. Una ventana mayor puede mejorar la calidad, pero queremos equilibrarla con el tiempo real de ejecución. En la gráfica izquierda, multiplicar matrices de 16×16 o 64×64 tiene una latencia aproximadamente igual; por encima de 64, crece de forma no lineal. La similitud se debe a que 64×64 mantiene suficiente ocupación de los Tensor Cores para saturarlos.
- La atención lineal permite interacciones globales con un estado recurrente de tamaño fijo. A diferencia de softmax, su tamaño depende de hiperparámetros, como la función de características, y no de la longitud de la secuencia. Podemos recorrer así el espacio de compromisos gradualmente. Usamos una aproximación de Taylor de la exponencial como función de características, utilizada primero en nuestro trabajo anterior sobre atención lineal.
El estado recurrente de Based no crece con la longitud de la secuencia, como ocurre en atención. Lo determinan la dimensión de características lineales y el tamaño de ventana. Ajustando estos hiperparámetros podemos intercambiar capacidad de recuperación por capacidad de procesamiento y recorrer la frontera de Pareto de la figura 1.
Pese a su sencillez, en experimentos reales de lenguaje hasta al menos 1.300 millones de parámetros, Based compite con Mamba en perplejidad global de Pile y pruebas zero-shot estándar de LM eval harness, mostradas bajo Question Answering - Common.
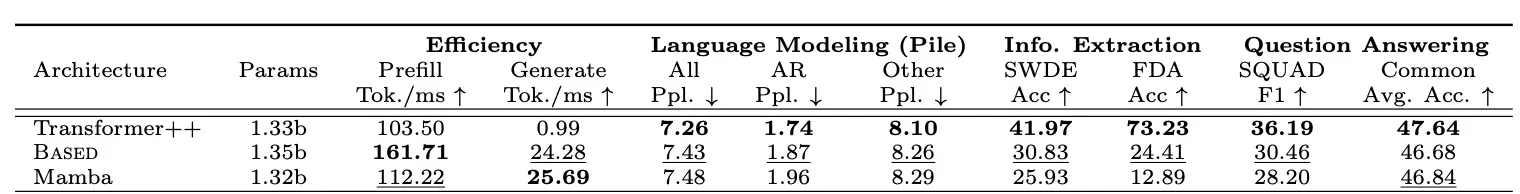
Estas pruebas zero-shot utilizan textos muy cortos y no exigen mucho a la recuperación de información. Para resolverlo, seleccionamos un pequeño conjunto de pruebas reales exigentes en recuperación de documentos largos, como extracción de información de documentos de la FDA y HTML sin procesar, además de comprensión lectora. Based es la arquitectura subcuadrática más potente en estas tareas y supera a Mamba en una media de 6,22 puntos de exactitud. Ambos siguen por debajo del mejor Transformer de referencia, a veces por bastante. Esto concuerda con la observación de que nada sale gratis.
No creemos que Based sea la única arquitectura capaz de operar en ese punto. En el artículo mostramos que sustituir la atención de ventana deslizante por convoluciones cortas de tamaño de filtro 3 da resultados similares, con una diferencia de 0,1 puntos de perplejidad. Sospechamos que muchas otras arquitecturas pueden igualar esta frontera y esperamos que algunas la amplíen.
También importa cómo usamos el estado recurrente fijo
Varias arquitecturas pueden tener estados ocultos del mismo tamaño, pero nuestro trabajo destaca que también importa la representación de características, incluida la función de atención lineal y el mecanismo de actualización. La función de Based es sencilla: aproxima la exponencial mediante una serie de Taylor. Calculamos ϕ de modo que ϕ(q)ϕ(k)^T ≈ exp(qk^T). Como en nuestro trabajo anterior, usamos solo segundo orden: exp(x)=1+x+x^2/2. Si x tiene dimensión d′, el término x^2 tiene dimensión d′^2. El producto exterior clave-valor del paso 1 crece rápidamente con d′, ampliando el estado de Based.
¿Cuánto influye la función de características frente al aumento del estado en la calidad de Based? La capacidad de usar el estado eficazmente es esencial. En las curvas de exactitud frente a tamaño de estado, varias alternativas a Taylor quedan por debajo de la frontera de Pareto. Comparamos con modelos que amplían el estado mediante proyecciones aprendidas y después aplican funciones conocidas, como Performer, CosFormer y PosELU. Los entrenamos en la prueba sintética MQAR de recuperación asociativa y exploramos hiperparámetros, incluida la tasa de aprendizaje, para todos los puntos de la gráfica. Taylor resultó más eficaz. La tendencia también aparece en experimentos reales con Pile; el artículo ofrece más detalles.
Implementación consciente de la entrada/salida y del flujo de datos
La siguiente cuestión es hacer competitivo el tiempo real de ejecución. La atención lineal es teóricamente más eficiente que la estándar respecto a la longitud de la secuencia. Sin embargo, sus implementaciones suelen ser más lentas que atención bien optimizada como FlashAttention.
Based usa Taylor de segundo grado, que amplía la dimensión de las claves y genera estados grandes y un consumo de memoria O(Nd′^2d), donde N es la longitud de la secuencia, d′ la dimensión de las claves y d la de los valores. El gran estado clave-valor hace lentas las implementaciones ingenuas.
Las GPU tienen poca memoria de acceso rápido, como registros por hilo y memoria compartida SRAM a nivel de warp de 32 hilos, y mucha memoria HBM de acceso más lento. Reducir las lecturas y escrituras entre HBM y SRAM, y entre SRAM y registros, mejora la eficiencia. Presentamos algoritmos de pasada hacia delante e inferencia de atención lineal Taylor que reducen el movimiento HBM-SRAM en O(Nd′^2) bytes y SRAM-registros en O(Nd′^2d) bytes. El algoritmo permite mantener el estado KV en registros del hilo con dimensión d′ = 16, la utilizada en los experimentos.
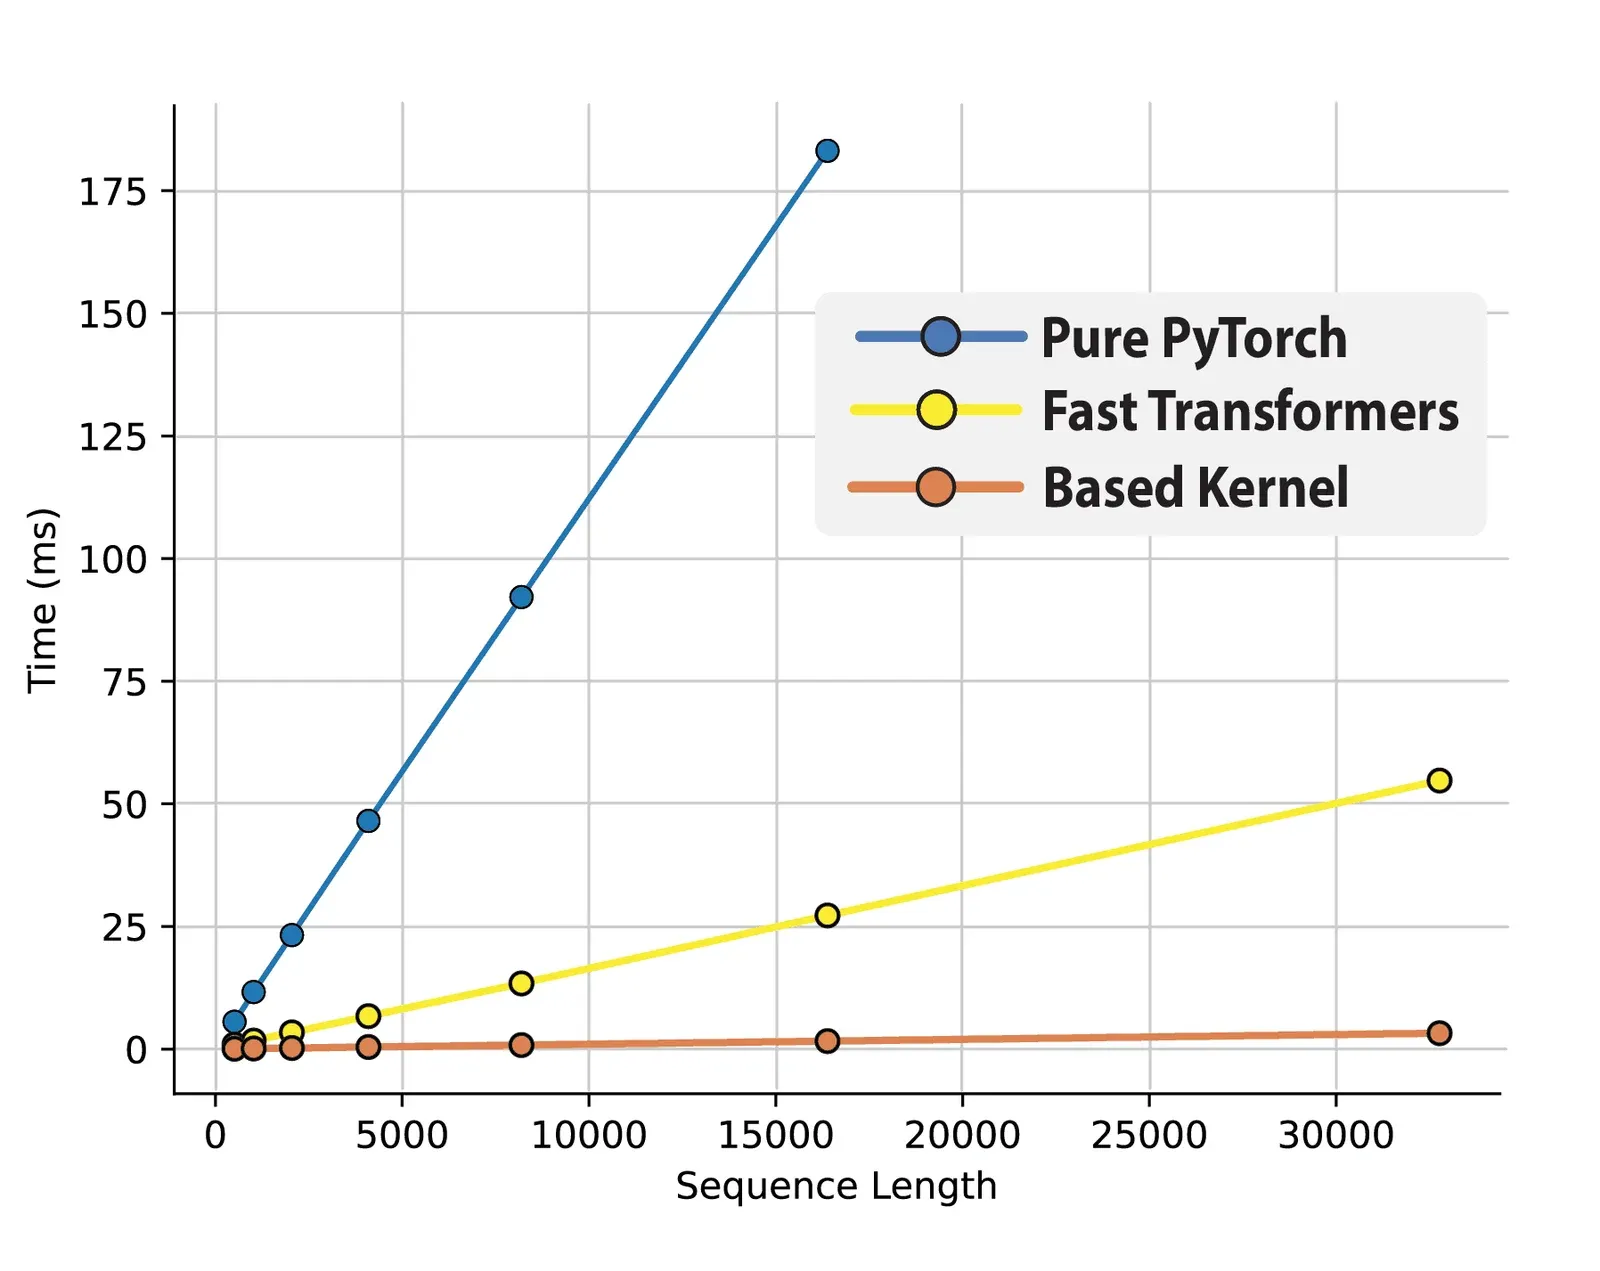
A continuación comparamos la pasada hacia delante ingenua, una implementación con los kernels de atención lineal de Fast Transformers y nuestros kernels, para distintos tamaños de lote con secuencias de longitud 1024.
Después comparamos la velocidad de generación completa de FlashAttention-2, Mamba y Based con modelos de 360 millones y 1.300 millones de parámetros usando estos algoritmos. Mantenemos el lote en 2 para prefill y generamos 1024 tokens. Based alcanza una capacidad de procesamiento hasta 24 veces mayor que FlashAttention-2.
Próximas novedades
Estos algoritmos están implementados en ThunderKittens, un nuevo lenguaje específico de dominio para CUDA que desarrolla nuestro laboratorio. Pronto compartiremos más detalles; esperamos que facilite el desarrollo con CUDA. A diferencia de frameworks como Triton, que fijan qué operaciones admite el usuario, nuestro lenguaje está integrado en C++. Queremos publicarlo y conocer tus comentarios. En las próximas semanas prepararemos más modelos, guiados por una pregunta: ¿qué modelos quiere el hardware?
Puedes probar los checkpoints y evaluaciones en Hugging Face y en este repositorio: https://github.com/HazyResearch/based.