


Dans un article ICLR et un billet de blog publiés vers la fin de l’année dernière, nous montrions que de nombreuses architectures efficaces, comme Mamba, RWKV, Hyena et RetNet, restent moins performantes que les Transformers en rappel. Il s’agit de la capacité à fonder les générations sur des informations vues dans le contexte, essentielle pour l’apprentissage en contexte et la copie. Cette analyse nous a aidés à concevoir une nouvelle architecture, Based, présentée dans ce billet. Voici nos derniers progrès.
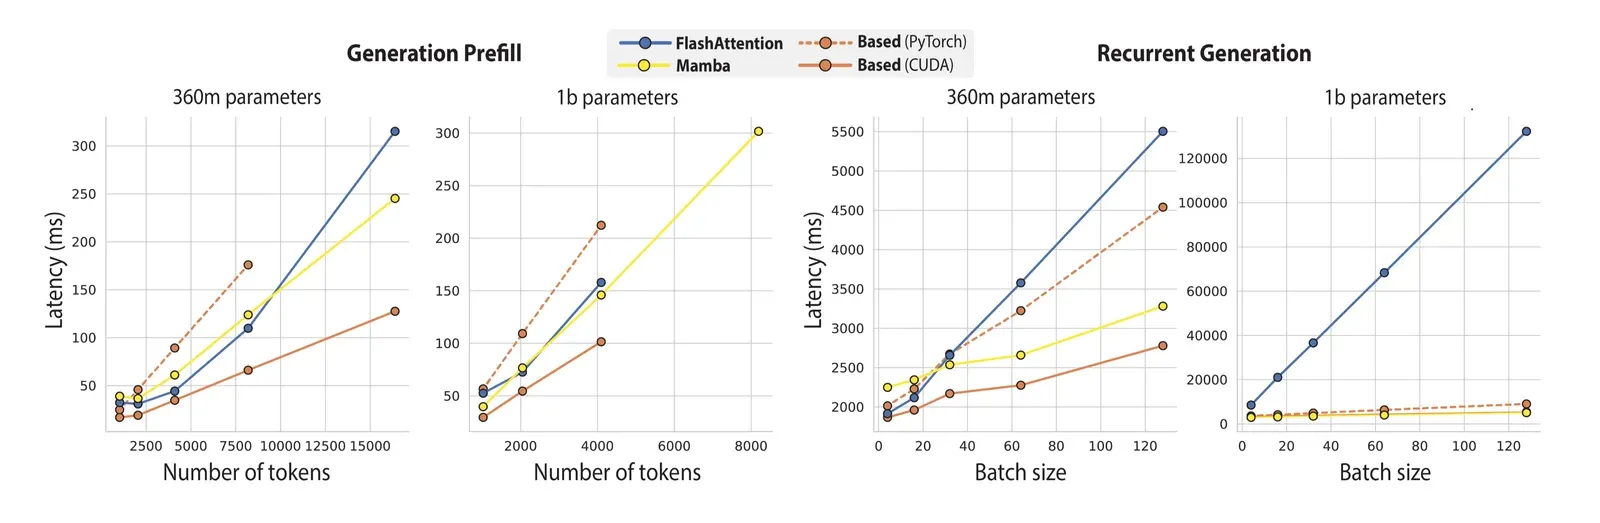
Nos travaux récents approfondissent ce défi du rappel. Nous commençons par illustrer un compromis fondamental entre les capacités de rappel d’un modèle et sa consommation de mémoire pendant la génération. Cette analyse guide la conception de Based, une architecture récurrente simple qui dépasse les précédents modèles sous-quadratiques sur des tâches réelles exigeant beaucoup de rappel, extraction d’information et compréhension écrite, ainsi qu’en apprentissage en contexte. Based génère aussi rapidement. Il traite les prompts 56 % plus vite que FlashAttention-2 et 44 % plus vite que Mamba. Son débit de génération de texte est 24 fois supérieur à celui de FlashAttention-2.
La simplicité de Based nous intéresse particulièrement. Avec seulement deux composants bien connus proches de l’attention, l’attention à fenêtre glissante avec de très petites fenêtres et l’attention linéaire avec une approximation de Taylor de exp(QK^T), nous dépassons les meilleures architectures sous-quadratiques en modélisation du langage et accélérons fortement la génération par rapport aux Transformers optimisés.
Ce billet présente notre analyse du rappel dans les architectures sous-quadratiques, qui conduit à Based, puis la façon dont nous accélérons son exécution.
L’analyse de départ : le compromis entre rappel et mémoire
La question principale est la suivante :
Peut-on améliorer radicalement la vitesse réelle et la consommation de mémoire des modèles de langage sans compromettre le rappel ni l’apprentissage en contexte ?
Pour commencer à répondre, nous avons examiné ce qui ralentit les architectures. Les architectures efficaces comme Mamba sont beaucoup plus rapides que les Transformers à l’inférence, par exemple avec un débit cinq fois supérieur, en grande partie grâce à leur empreinte mémoire réduite. Moins de mémoire permet de plus grands lots et moins d’entrées-sorties. Mais réduire trop fortement cette empreinte peut logiquement nuire à la capacité de rappeler des informations vues plus tôt dans la séquence. Cela ressemblait à un compromis inévitable. Nous avons donc pris plusieurs architectures courantes, fait varier les hyperparamètres affectant l’empreinte mémoire et évalué leurs performances sur une tâche synthétique difficile de rappel associatif.
Le compromis rappel-mémoire. Toutes les architectures suivent un compromis fondamental : moins le modèle consomme de mémoire à l’inférence, moins il réussit le rappel associatif. Nous nous sommes concentrés sur la taille de l’état récurrent, le nombre d’octets utilisés pour représenter les tokens déjà vus lorsque les nouveaux tokens sont générés un par un, de manière récurrente.
Avec l’attention, cet état est généralement appelé cache KV et grandit avec la longueur de la séquence. En haut à droite de la figure 1, l’attention réalise un rappel parfait, au prix d’un état récurrent énorme. L’attention à fenêtre glissante permet de plafonner la taille du cache KV. Sans surprise, nous constatons que le rappel chute rapidement quand nous réduisons l’état récurrent, par exemple de 100 % avec un état de 1 Mo à 50 % avec 65 Ko, en bleu clair dans la figure 1.
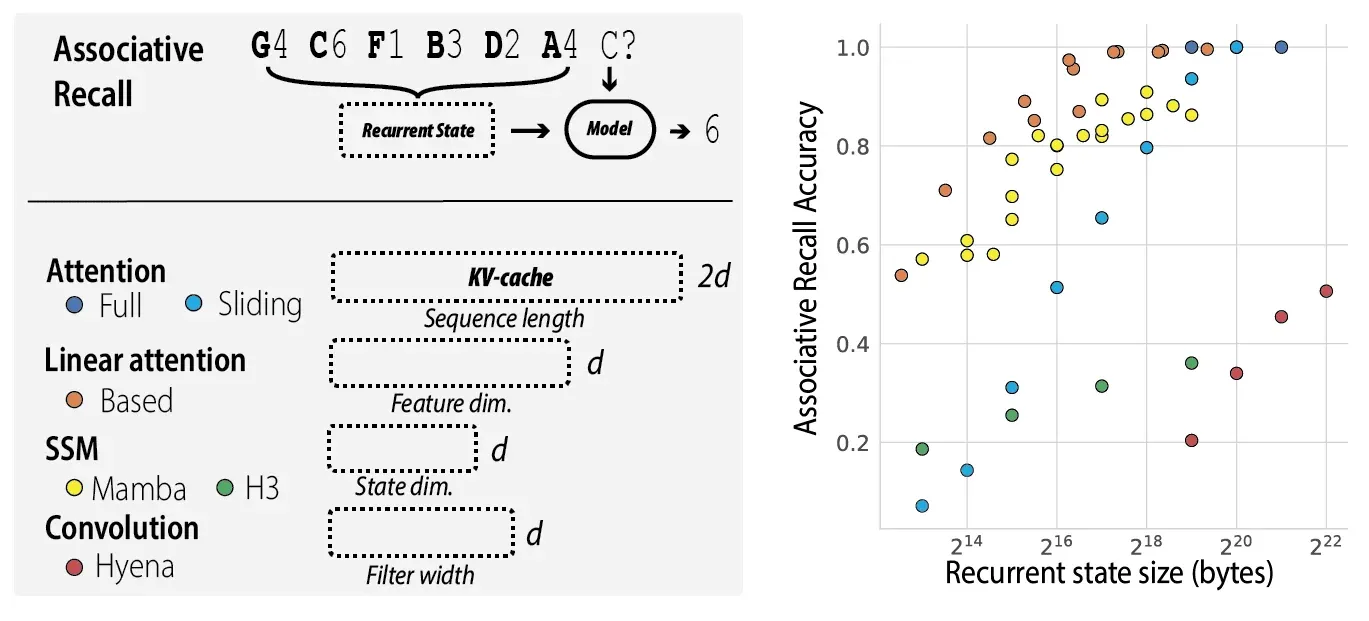
Mamba étend la frontière de Pareto du compromis rappel-mémoire au-delà de l’attention à fenêtre glissante. Il fait donc un meilleur usage d’un état récurrent limité que des approches comme l’attention à fenêtre glissante.
Une question en découle : d’autres modèles, peut-être plus simples, peuvent-ils eux aussi étendre cette frontière ?
Based : un modèle simple sur la frontière de Pareto
Nous avons commencé par étudier pourquoi les solutions les plus simples remplaçant l’attention softmax n’atteignent pas un compromis favorable. Nous avons aussi cherché des composants adaptés au matériel actuel et futur. Par exemple, ils pourraient utiliser les Tensor Cores des GPU, du matériel spécialisé capable d’effectuer des multiplications matricielles, ou GEMM, 16 fois plus vite que les cœurs CUDA standard pour des matrices 16 × 16.
Dans notre article ICLR, nous avons étudié pourquoi les modèles à représentation convolutionnelle, comme H3 ou Hyena, peinent en rappel. Nous avons ensuite examiné deux techniques simples d’attention efficace : l’attention à fenêtre glissante et l’attention linéaire, sans softmax.
Nos expériences sur la modélisation réelle du langage, jusqu’à 1,4 milliard de paramètres, et sur le rappel associatif synthétique suggéraient qu’aucun de ces composants ne suffirait seul pour parcourir la frontière de Pareto.
- Les modèles à attention purement linéaire peinent à effectuer les décalages locaux précis et les comparaisons de tokens importants pour le rappel, décrits par Fu et al., 2023 et Arora et al., 2023a, ainsi que l’attention dense. Notre modèle purement linéaire améliore néanmoins les architectures sous-quadratiques antérieures. Sur la partie du test Pile exigeant du rappel, où prédire le token suivant oblige à utiliser le contexte plutôt que les connaissances mémorisées, le modèle à 355 millions de paramètres dépasse RWKV-v5 de 0,1 point de perplexité et H3 de 2,6 points, comme le montre le tableau 1 de l’article. Il est même comparable à Mamba sur cette partie : 2,21 pour Mamba contre 2,29 pour l’attention purement linéaire. Un écart notable demeure toutefois avec les Transformers, qui atteignent 1,87.
- Avec l’attention à fenêtre glissante, les modèles ne peuvent rappeler que les tokens dans la fenêtre, au centre de la figure 2. Lorsque sa taille augmente, l’état récurrent croît linéairement et affecte la vitesse de manière non linéaire pendant l’entraînement parallèle et l’inférence, à gauche de la figure 2.
Ces deux composants sont complémentaires. L’attention linéaire modélise les interactions à longue distance entre tokens, et la fenêtre glissante leurs interactions locales. Nous les avons réunis dans une seule architecture, Based, à droite de la figure 2.
- L’attention à fenêtre glissante réalise les décalages locaux précis nécessaires au rappel associatif. Nous utilisons de très petites fenêtres, par exemple 64 dans nos expériences, contrairement aux fenêtres plus grandes de Mistral-7B et du récent Griffin. Une fenêtre plus grande favorise intuitivement la qualité, mais nous voulons équilibrer qualité et temps réel d’exécution. Le graphique de gauche montre une latence de multiplication matricielle à peu près égale pour les matrices 16 × 16 et 64 × 64. Au-delà de 64, elle augmente de façon non linéaire avec la fenêtre. Cette similarité vient du fait que les matrices 64 × 64 occupent suffisamment les Tensor Cores du GPU pour les saturer.
- L’attention linéaire permet des interactions globales entre tokens avec un état récurrent de taille fixe. Contrairement à l’attention softmax, sa taille dépend des hyperparamètres, par exemple de la transformation de caractéristiques choisie, et non de la longueur de la séquence. Cela permet de parcourir progressivement l’espace des compromis. Nous utilisons une approximation de Taylor de la fonction exponentielle comme transformation de caractéristiques, employée pour la première fois dans nos travaux précédents sur l’attention linéaire.
La taille de l’état récurrent de Based ne grandit pas avec la séquence comme dans l’attention. Elle dépend de la dimension des caractéristiques de l’attention linéaire et de la taille de fenêtre. En ajustant ces hyperparamètres, nous pouvons échanger du rappel contre du débit et parcourir la frontière de Pareto de la figure 1.
Malgré sa simplicité, dans les expériences réelles de modélisation du langage jusqu’à au moins 1,3 milliard de paramètres, Based est compétitif avec Mamba sur la perplexité globale de Pile et les tests standard sans exemple de LM eval harness, présentés sous Question Answering - Common.
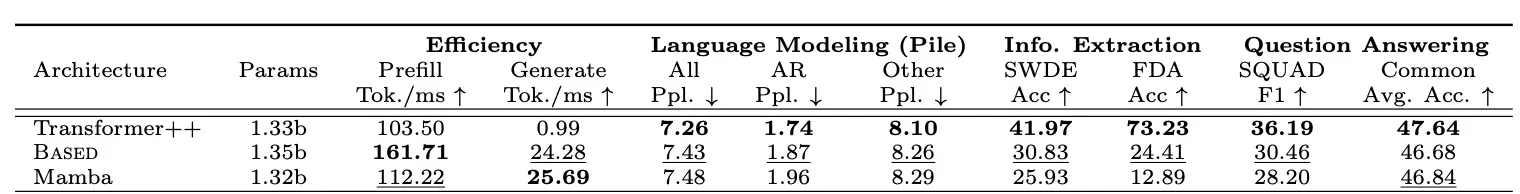
Ces tests courants sans exemple utilisent des textes extrêmement courts et ne mettent donc pas les capacités de rappel à l’épreuve. Pour y remédier, nous avons constitué un petit ensemble de tests réels exigeants en rappel, qui nécessitent de retrouver des informations dans de longs documents. Ils couvrent notamment l’extraction d’information de documents de la FDA et de HTML brut, ainsi que la compréhension écrite. Based est l’architecture sous-quadratique la plus performante sur ces tâches et dépasse Mamba de 6,22 points d’exactitude en moyenne. Toutefois, Based et Mamba restent derrière le meilleur Transformer de référence, parfois de beaucoup. Cela concorde avec notre constat de compromis inévitable.
Nous ne pensons pas que Based soit la seule architecture capable d’atteindre ce point de la courbe. Notre article montre, par exemple, qu’on peut remplacer l’attention à fenêtre glissante par de courtes convolutions de taille de filtre 3 et obtenir des performances similaires à 0,1 point de perplexité près. Nous soupçonnons que bien d’autres architectures peuvent atteindre cette frontière de Pareto et espérons que certaines pourront même la dépasser.
La façon d’utiliser l’état récurrent fixe compte aussi
De nombreuses architectures récurrentes peuvent avoir la même taille d’état caché. Nos travaux montrent que la représentation des caractéristiques, par exemple leur transformation en attention linéaire ou le mécanisme de mise à jour d’état, compte aussi. Notre choix dans Based est étonnamment simple : une approximation de l’exponentielle par une série de Taylor, qui ne demande que des notions de calcul de niveau lycée. Nous calculons ϕ pour que ϕ(q)ϕ(k)^T ≈ exp(qk^T). Nous utilisons seulement la série de Taylor d’ordre deux, comme dans nos travaux précédents, avec exp(x)=1+x+x^2/2. Si x a une dimension d′, le terme x^2 a une dimension d′^2. Le produit extérieur clé-valeur, première étape ci-dessus, croît rapidement avec d′ et augmente la taille de l’état de Based.
Quelle part de la qualité de Based vient de la représentation choisie, plutôt que de la taille d’état accrue ? La capacité du modèle à utiliser efficacement l’état est déterminante. Dans les courbes d’exactitude selon la taille d’état récurrent, plusieurs alternatives à la transformation de Taylor se situent sous la frontière de Pareto. Nous comparons ci-dessous des modèles qui étendent l’état par des projections apprises, puis appliquent des transformations connues de la littérature : Performer, CosFormer et PosELU. Nous les entraînons sur le test synthétique MQAR de rappel associatif et balayons les hyperparamètres, notamment le taux d’apprentissage, pour tous les points du graphique. La transformation de Taylor est la plus efficace. Cette tendance se retrouve dans les expériences réelles sur Pile ; l’article donne plus de détails.
Une implémentation attentive aux entrées-sorties et au flux de données
La question suivante est de rendre Based compétitif en temps réel d’exécution. L’attention linéaire est théoriquement plus efficace que l’attention standard selon la longueur des séquences. Pourtant, les implémentations existantes sont souvent plus lentes que des implémentations d’attention bien optimisées comme FlashAttention.
Based utilise l’approximation de Taylor d’ordre deux, qui augmente la dimension des clés et produit de grands états ainsi qu’une consommation mémoire de O(Nd′^2d), où N est la longueur de séquence, d′ la dimension des clés et d celle des valeurs. L’état clé-valeur résultant rend les implémentations naïves de cette attention linéaire assez lentes.
Rappelons le fonctionnement du matériel. Les GPU disposent de petites quantités de mémoire rapidement accessible, registres propres aux threads et mémoire partagée au niveau des warps de 32 threads en SRAM, et de grandes quantités de mémoire plus lente, la HBM. Réduire les lectures et écritures entre HBM et SRAM, puis entre SRAM et registres, permet de gagner en efficacité. Nous présentons de nouveaux algorithmes attentifs aux entrées-sorties pour la passe avant et l’inférence de l’attention linéaire de Taylor. Ils réduisent les mouvements de données HBM-SRAM de O(Nd′^2) octets et SRAM-registres de O(Nd′^2d) octets. Notre algorithme conserve l’état KV dans les registres du thread avec une dimension de caractéristiques d′ = 16, utilisée dans nos expériences.
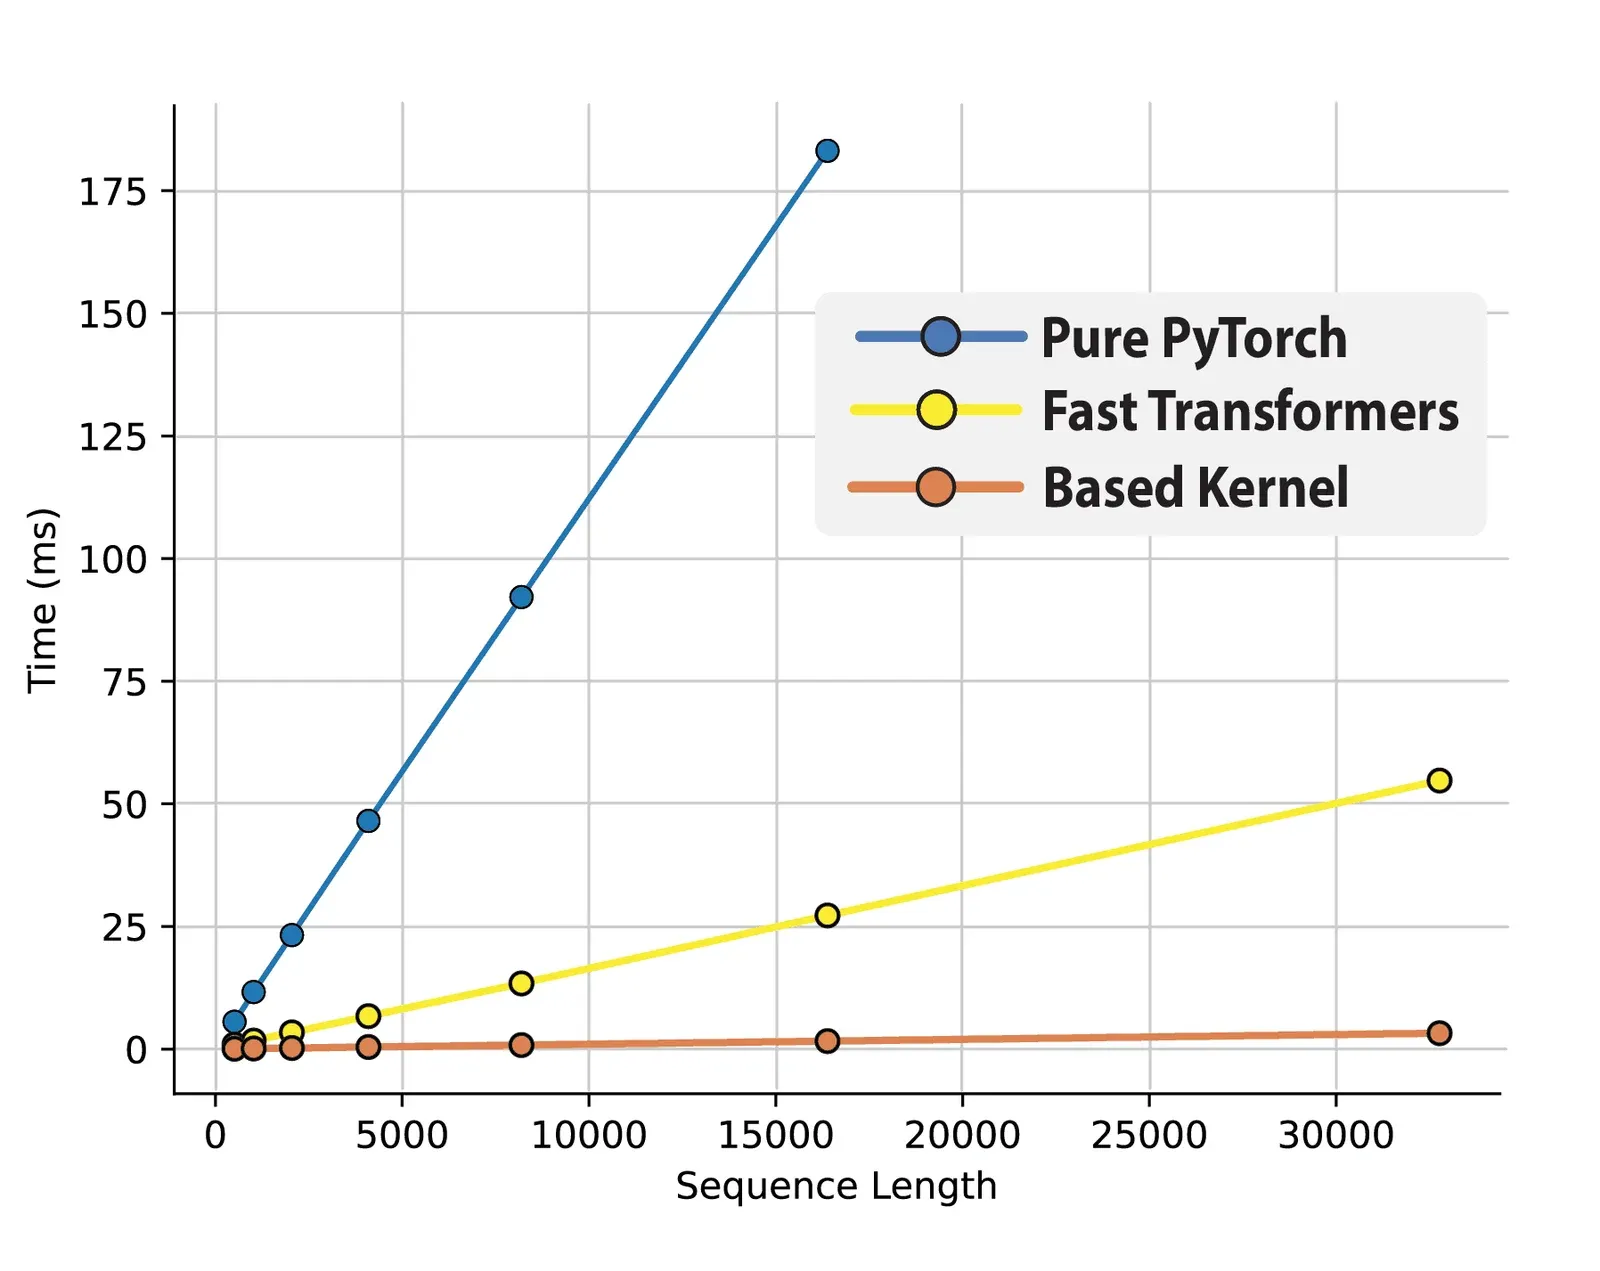
Nous comparons ci-dessous, selon la taille du lot et pour une séquence de longueur 1024, la passe avant naïve de l’attention de Taylor, une implémentation utilisant les noyaux courants de Fast Transformers et nos noyaux personnalisés.
Nous comparons ensuite les vitesses de génération de bout en bout de FlashAttention-2, Mamba et Based à 360 millions et 1,3 milliard de paramètres avec nos algorithmes. Nous fixons la taille du lot à deux pour le préremplissage et générons 1024 tokens par prédiction du token suivant. Based atteint un débit jusqu’à 24 fois supérieur à celui de FlashAttention-2.
Restez à l’écoute
Ces algorithmes sont implémentés dans ThunderKittens, un nouveau langage spécialisé CUDA développé par notre laboratoire. Nous en parlerons bientôt davantage et espérons qu’il rendra le développement CUDA plus accessible. Contrairement à des frameworks comme Triton, qui font des choix précis sur les opérations autorisées, notre langage est intégré à C++. Nous avons hâte de le partager et de recueillir vos retours. Nous préparons aussi de nouveaux modèles pour les semaines à venir, autour d’une question : quels modèles le matériel veut-il ?
Vous pouvez essayer nos points de contrôle et nos évaluations sur Hugging Face et dans ce dépôt : https://github.com/HazyResearch/based !