


Em um artigo da ICLR e em uma publicação no blog divulgados no fim do ano passado, mostramos que muitas arquiteturas eficientes, como Mamba, RWKV, Hyena e RetNet, ficam atrás dos Transformers na recuperação de informações. Essa capacidade de fundamentar a geração em informações vistas no contexto é essencial para aprender em contexto e copiar. Usamos essa análise para projetar uma nova arquitetura, chamada Based, apresentada inicialmente nesta publicação. Agora compartilhamos os avanços mais recentes dessa pesquisa.
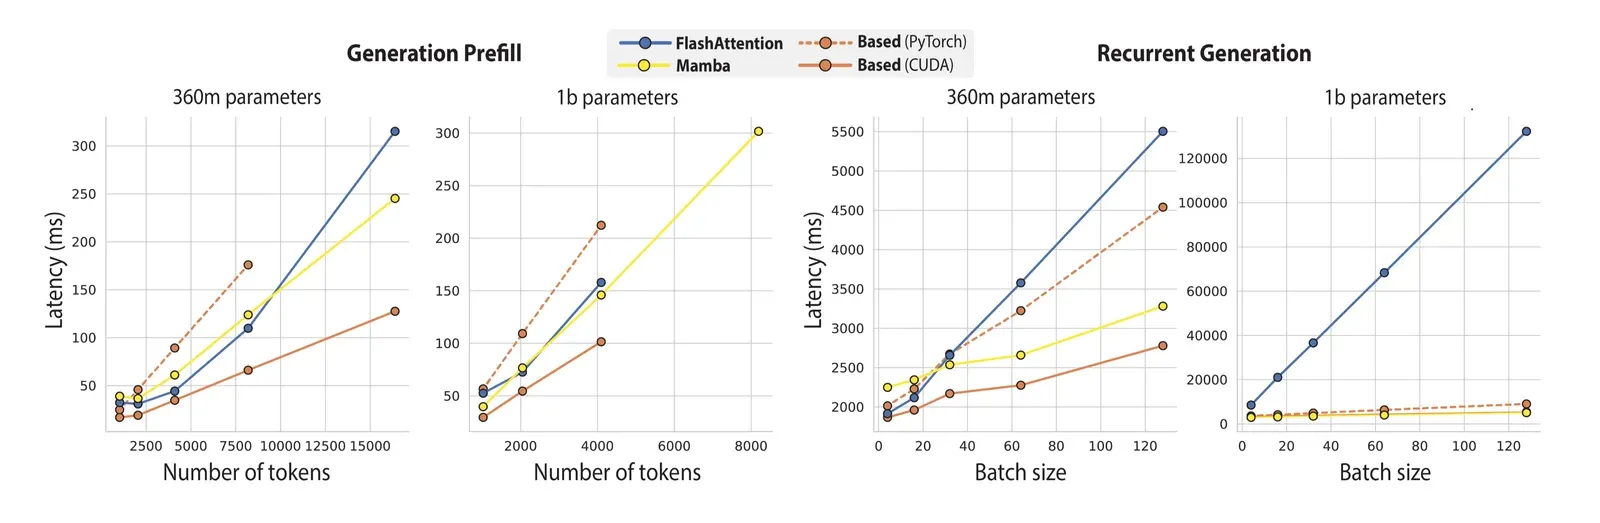
Nosso trabalho recente aprofunda o desafio da recuperação. Começamos mostrando um compromisso fundamental entre a capacidade de recuperação de um modelo e seu consumo de memória durante a geração. Essa análise orienta o projeto do Based, uma arquitetura recorrente simples que supera modelos subquadráticos anteriores em tarefas reais que exigem muita recuperação de informações, como extração de informações e compreensão de leitura, e em aprendizado em contexto. Ao mesmo tempo, o Based gera texto rapidamente. Ele processa prompts 56% e 44% mais rápido que FlashAttention-2 e Mamba, respectivamente. A vazão de geração de texto do Based é 24x maior que a do FlashAttention-2.
A simplicidade do Based nos anima especialmente. Com apenas dois componentes conhecidos semelhantes à atenção, atenção de janela deslizante com janelas minúsculas e atenção linear com aproximação por série de Taylor de exp(QK^T), conseguimos superar as melhores arquiteturas subquadráticas em modelagem de linguagem e obter grandes ganhos de velocidade sobre Transformers otimizados!
Esta publicação apresenta nossa análise da recuperação em arquiteturas subquadráticas, que levou ao projeto do Based, e explica como fazemos o Based rodar tão rápido.
A análise que motivou o projeto: o compromisso entre recuperação e memória
A principal pergunta da nossa investigação é:
Podemos melhorar drasticamente a velocidade e o consumo de memória dos modelos de linguagem na prática sem comprometer a recuperação de informações e o aprendizado em contexto?
Para começar a responder, primeiro precisamos entender o que torna as arquiteturas lentas. Arquiteturas eficientes, como Mamba, são muito mais rápidas que Transformers durante a inferência, por exemplo, com vazão 5x maior. Isso se deve em grande parte ao menor uso de memória, que permite lotes maiores e menos operações de entrada e saída. Mas também é intuitivo que reduzir demais a memória possa prejudicar a capacidade de recuperar informações vistas antes na sequência. Parecia um caso clássico de “não existe almoço grátis”. Por isso, escolhemos várias arquiteturas populares, variamos os hiperparâmetros que afetam o uso de memória e avaliamos o desempenho em uma tarefa sintética difícil de recuperação associativa.
O compromisso entre recuperação e memória. Todas as arquiteturas seguiram uma relação fundamental. Quanto menos memória o modelo consumia na inferência, pior era seu desempenho na recuperação associativa. Nosso foco foi o tamanho do estado recorrente, a quantidade de bytes usada para representar tokens vistos anteriormente ao gerar tokens um a um, de forma recorrente.
Na atenção, esse estado costuma ser chamado de cache KV e cresce com o comprimento da sequência. No canto superior direito da Figura 1, a atenção recupera as informações perfeitamente, mas usa um estado recorrente enorme. A atenção de janela deslizante limita o tamanho do cache KV. Porém, como esperado, a recuperação cai rapidamente quando reduzimos o estado recorrente, por exemplo, de 100% com 1MB para 50% com 65 KB, como mostra a curva azul-clara da Figura 1.
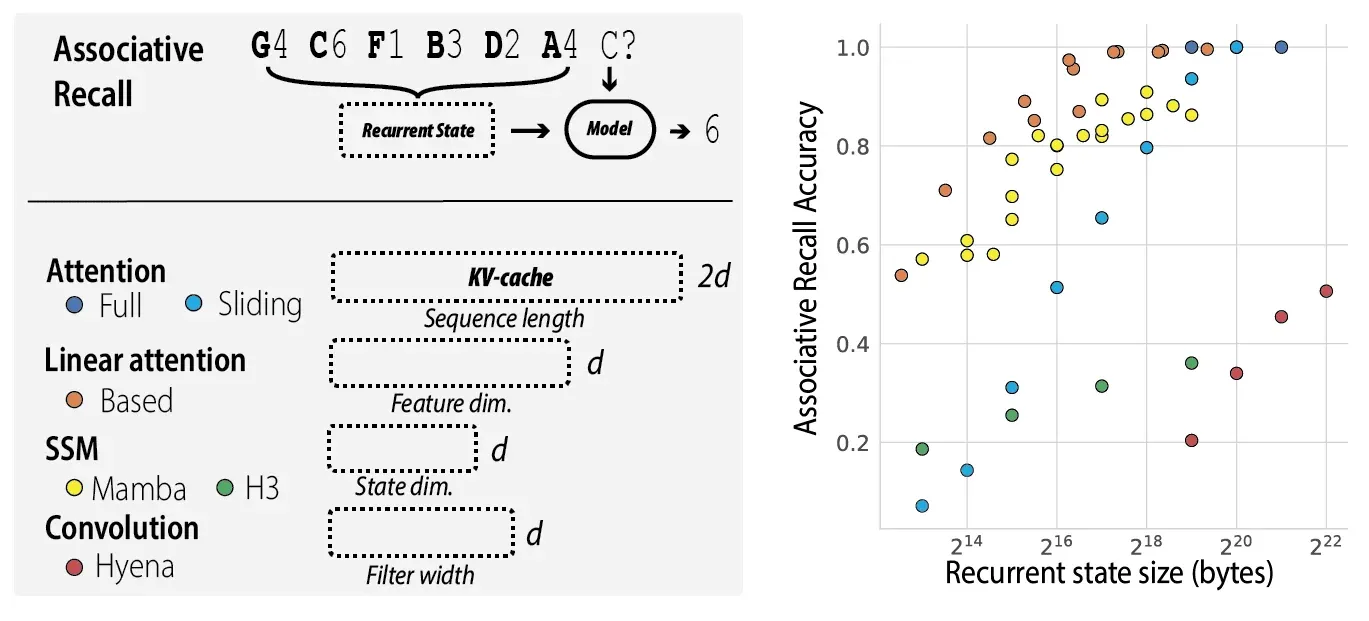
Descobrimos que o Mamba amplia a fronteira de Pareto da relação entre recuperação e memória em comparação com a atenção de janela deslizante. Isso significa que ele aproveita melhor um estado recorrente de tamanho limitado.
A pergunta seguinte foi se outros modelos, talvez mais simples, também poderiam ampliar essa fronteira.
Based: um modelo simples na fronteira de Pareto
Para responder, estudamos por que as alternativas mais simples à atenção softmax não alcançam um equilíbrio favorável. Também buscamos operações básicas que escalassem bem no hardware atual e futuro. Por exemplo, seria útil aproveitar os Tensor Cores das GPUs, hardware especializado das GPUs modernas que multiplica matrizes 16x16, ou GEMMs, 16x mais rápido que os CUDA cores padrão!
Em nosso artigo da ICLR, analisamos a fundo por que modelos com uma interpretação convolucional, como H3 ou Hyena, têm dificuldade com recuperação. Em seguida, consideramos duas das técnicas de atenção eficiente mais simples disponíveis, a atenção de janela deslizante e a atenção linear, isto é, atenção sem softmax.
Nossos experimentos de modelagem de linguagem real, com até 1.4 bilhão de parâmetros, e de recuperação associativa sintética sugeriram que nenhuma dessas operações isoladamente bastaria para percorrer a fronteira de Pareto.
- Modelos de atenção puramente linear tinham dificuldade para fazer deslocamentos locais precisos e comparações entre tokens tão bem quanto a atenção densa. Essas capacidades são importantes para a recuperação, como discutem Fu et al., 2023, e Arora et al., 2023a. Ainda assim, nosso modelo de atenção puramente linear melhora os resultados de arquiteturas subquadráticas anteriores. Na parte do conjunto de teste Pile que exige recuperação, em que prever o próximo token requer usar o contexto anterior em vez de conhecimento memorizado, o modelo de 355M parâmetros supera RWKV-v5 em 0.1 ponto de perplexidade e H3 em 2.6, conforme a Tabela 1 do artigo. Nessa parte, ele chega perto do Mamba, com 2.29 de perplexidade contra 2.21! Porém, ainda existe uma diferença considerável em relação aos Transformers, que alcançam 1.87.
- Na atenção de janela deslizante, os modelos só recuperam tokens dentro da janela, como mostra o centro da Figura 2. Quando a janela aumenta, o estado recorrente cresce linearmente, com um efeito não linear na velocidade durante treinamento paralelo e inferência, como mostra o gráfico à esquerda.
As duas operações, porém, se complementam. A atenção linear modela interações entre tokens distantes, enquanto a janela deslizante modela interações locais. Combinamos as duas em uma única arquitetura, o Based, mostrado à direita na Figura 2.
- A atenção de janela deslizante executa os deslocamentos locais precisos necessários à recuperação associativa. Usamos janelas minúsculas, por exemplo, de 64 tokens nos experimentos, em comparação com as janelas maiores de arquiteturas como Mistral-7B e o recém-proposto Griffin. Intuitivamente, mais atenção, com janelas maiores, ajuda a qualidade, mas queremos equilibrar qualidade e tempo real de execução. O gráfico à esquerda na figura acima mostra que a latência da multiplicação de matrizes 16x16 e 64x64 é aproximadamente igual. Acima de 64, a latência cresce de forma não linear com o tamanho da janela. Essa semelhança ocorre porque as matrizes 64x64 mantêm a ocupação dos Tensor Cores alta o suficiente para saturá-los.
- A atenção linear permite interações globais entre tokens e mantém um estado recorrente de tamanho fixo. Ao contrário da atenção softmax, seu tamanho depende de hiperparâmetros, como a escolha do mapa de características, e não do comprimento da sequência. Isso permite percorrer suavemente o espaço de compromissos. Usamos uma aproximação de Taylor da função exponencial como mapa de características, empregada pela primeira vez em nosso trabalho anterior sobre atenção linear!
O tamanho do estado recorrente do Based não cresce com o comprimento da sequência, como acontece na atenção. Ele depende da dimensão das características da atenção linear e do tamanho da janela. Ajustando esses hiperparâmetros, podemos trocar capacidade de recuperação por vazão e percorrer a fronteira de Pareto da Figura 1.
Apesar da simplicidade, em experimentos reais de modelagem de linguagem com pelo menos até 1.3 bilhão de parâmetros, o Based é competitivo com Mamba na perplexidade geral do Pile e nos benchmarks padrão sem exemplos do LM eval harness, mostrados na categoria “Question Answering - Common”.
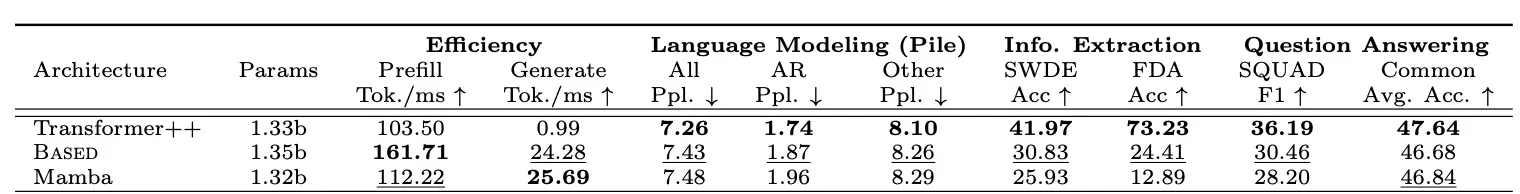
Esses benchmarks populares sem exemplos usam textos extremamente curtos e, portanto, não testam as capacidades de recuperação sob pressão. Para resolver essa limitação, selecionamos um pequeno conjunto de benchmarks reais que exigem muita recuperação. Eles requerem recuperar informações de documentos longos, como extrair informações de documentos da FDA e de HTML bruto, além de compreender textos. O Based é a arquitetura subquadrática mais forte nessas tarefas, superando o Mamba em 6.22 pontos de acurácia, em média. Porém, tanto Based quanto Mamba ainda ficam atrás da melhor referência Transformer, às vezes por margens grandes. Isso é consistente com a observação de que não existe almoço grátis.
Não acreditamos que o Based seja a única arquitetura capaz de operar nesse ponto da curva. No artigo, mostramos que é possível substituir a atenção de janela deslizante por convoluções curtas, com filtro de tamanho 3, e obter desempenho semelhante, com diferença de até 0.1 ponto de perplexidade. Suspeitamos que muitas outras arquiteturas possam alcançar essa fronteira de Pareto e esperamos que algumas consigam ultrapassá-la!
A forma de usar o estado recorrente de tamanho fixo também importa
Muitas arquiteturas recorrentes podem ter o mesmo tamanho de estado oculto, mas nosso trabalho mostra que a representação de características, como o mapa da atenção linear e o mecanismo de atualização de estado, também importa. A escolha do mapa no Based é surpreendentemente simples. Basta cálculo do ensino médio para entender a aproximação da exponencial por uma série de Taylor. Calculamos ϕ de modo que ϕ(q)ϕ(k)^T ≈ exp(qk^T). Usamos apenas a série de Taylor de segunda ordem, como em nosso trabalho anterior, em que exp(x)=1+x+x^2/2! Se x tem dimensão d′, o termo x^2 tem dimensão d′^2. O resultado do produto externo entre chave e valor, a etapa 1 acima, cresce rapidamente com d′, aumentando o estado do Based.
Quanto a qualidade do Based depende da representação de características escolhida, em comparação com o aumento do estado? A capacidade do modelo de usar o estado de forma eficaz é essencial. Nas curvas que relacionam acurácia e tamanho do estado recorrente, várias alternativas ao mapa de Taylor ficam abaixo da fronteira de Pareto. A seguir, comparamos modelos que expandem o estado com projeções aprendidas e depois aplicam mapas populares da literatura, como Performer, CosFormer e PosELU. Treinamos esses modelos no teste sintético MQAR de recuperação associativa e variamos os hiperparâmetros, especificamente a taxa de aprendizado, para todos os pontos do gráfico abaixo. O mapa de Taylor foi o mais eficaz. A mesma tendência aparece em experimentos reais no corpus Pile de modelagem de linguagem. O artigo traz mais detalhes.
Implementação que considera entrada, saída e fluxo de dados
A próxima questão é como tornar o Based competitivo no tempo real de execução. Teoricamente, a atenção linear é mais eficiente que a atenção padrão em função do comprimento da sequência. Porém, as implementações existentes de atenção linear costumam ser mais lentas que implementações de atenção bem otimizadas, como FlashAttention.
No Based, usamos a aproximação de Taylor de segundo grau, que expande a dimensão das chaves e resulta em estados grandes e alto consumo de memória, O(Nd′^2d), para comprimento de sequência N, dimensão de chave d′ e dimensão de valor d. Esse grande estado de chave e valor torna as implementações ingênuas de atenção linear de Taylor bastante lentas.
Vale retomar como o hardware funciona. GPUs têm pequenas quantidades de memória de acesso rápido, como registradores específicos de cada thread e memória compartilhada em SRAM no nível do warp de 32 threads, e grandes quantidades de memória de acesso lento, a HBM. Reduzir leituras e escritas entre HBM e SRAM, e entre SRAM e registradores, é essencial para a eficiência. Apresentamos novos algoritmos que consideram entrada e saída para a passagem direta e a inferência da atenção linear de Taylor. Eles reduzem a movimentação de dados da HBM para SRAM em O(Nd′^2) bytes e da SRAM para registradores em O(Nd′^2d) bytes. Nosso algoritmo permite manter o estado KV nos registradores da thread com dimensão de características d′ = 16, usada nos experimentos.
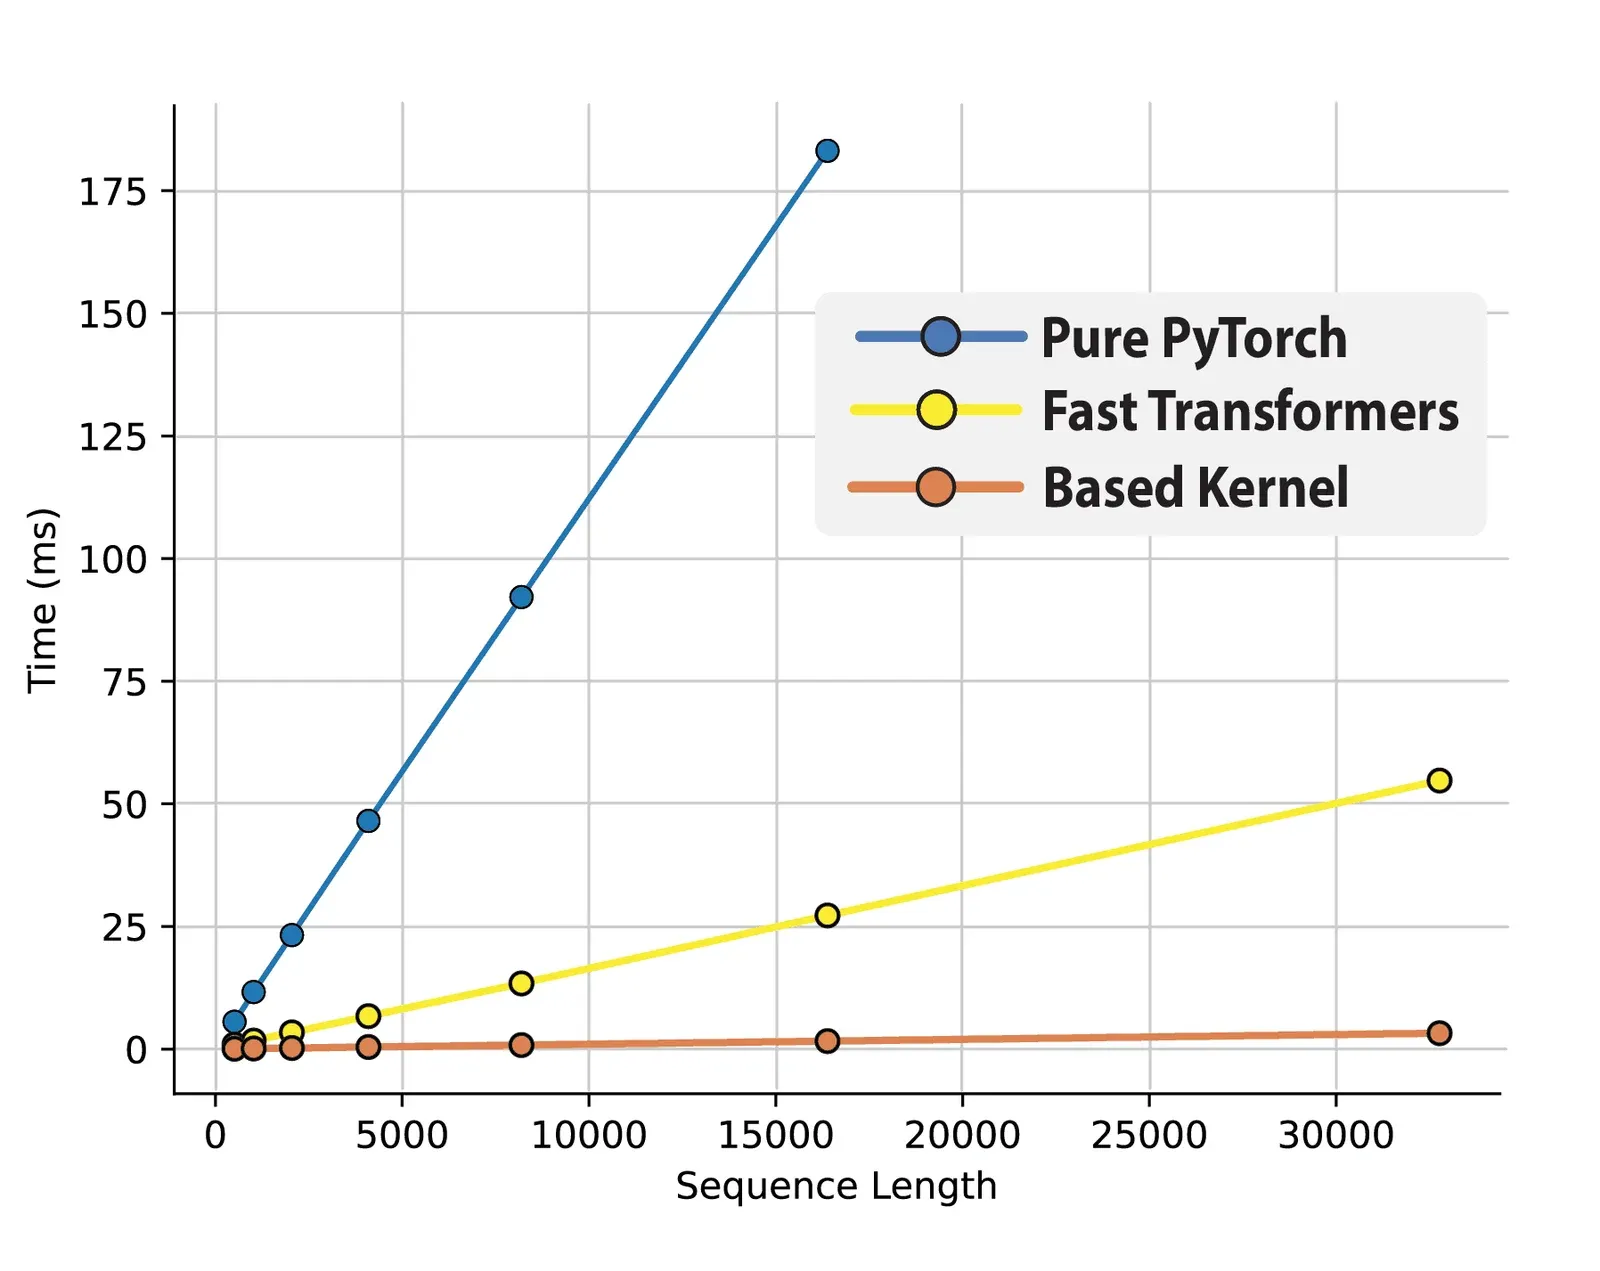
A seguir, comparamos a passagem direta ingênua da atenção de Taylor, uma implementação que usa os populares kernels de atenção linear do Fast Transformers e nossos kernels personalizados, variando o tamanho do lote com sequências de comprimento 1024.
Depois, comparamos a velocidade de geração de ponta a ponta de FlashAttention-2, Mamba e Based, com modelos de 360M e 1.3 bilhão de parâmetros, usando nossos algoritmos que consideram entrada e saída. Mantemos o lote em 2 no prefill e geramos 1024 tokens na previsão do próximo token. O Based alcança vazão até 24x maior que o FlashAttention-2!
Acompanhe as novidades
Esses algoritmos são implementados em uma nova linguagem específica de domínio para CUDA, chamada ThunderKittens, que nosso laboratório está desenvolvendo. Em breve compartilharemos mais detalhes. Esperamos tornar o desenvolvimento CUDA mais acessível! Ao contrário de frameworks como Triton, que tomam decisões específicas sobre quais operações o usuário pode executar, nossa linguagem é incorporada ao C++. Queremos compartilhá-la e ouvir suas opiniões. Nas próximas semanas, também prepararemos mais artefatos de modelos, guiados pela pergunta sobre quais modelos o hardware pede.
Você pode experimentar nossos checkpoints e avaliações no Hugging Face e neste repositório de código: https://github.com/HazyResearch/based!