


In un articolo ICLR e nel relativo post pubblicati verso la fine dello scorso anno, abbiamo mostrato che molte architetture efficienti, tra cui Mamba, RWKV, Hyena e RetNet, sono inferiori ai Transformer nel richiamo: la capacità di fondare la generazione su informazioni viste nel contesto, essenziale per apprendimento nel contesto e copia. Abbiamo usato questa analisi per progettare Based, una nuova architettura anticipata in questo post. Condividiamo qui gli ultimi progressi.
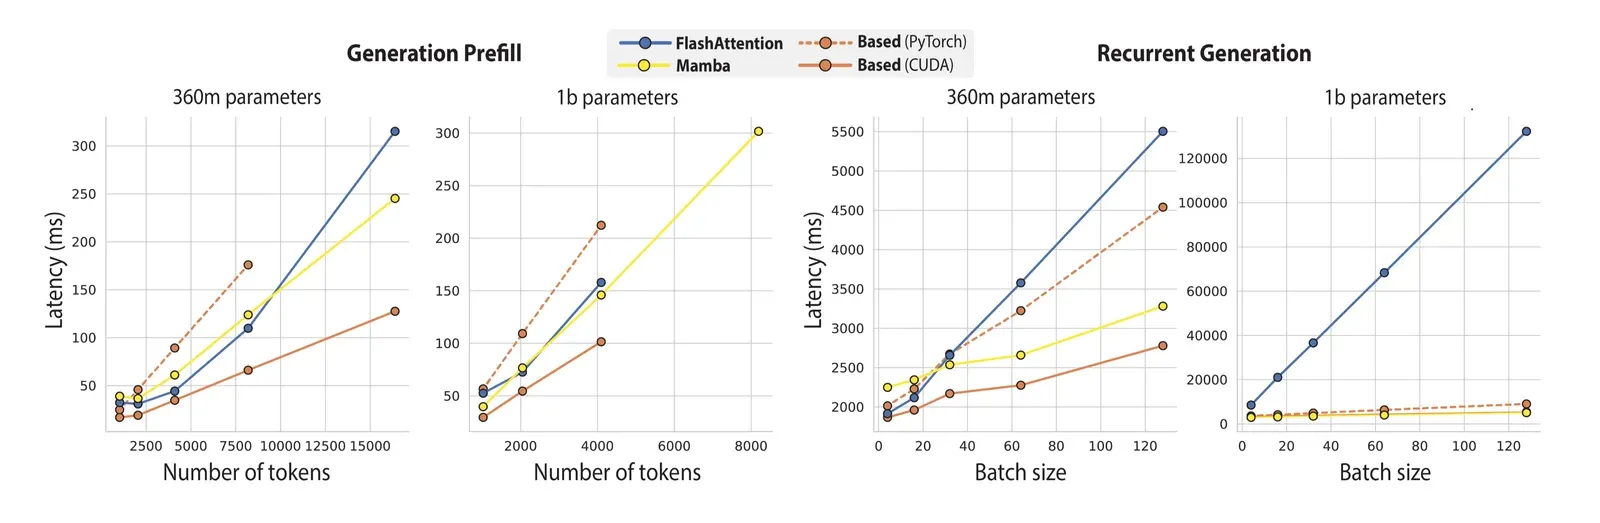
Il nostro lavoro recente approfondisce il problema del richiamo. Partiamo da un compromesso fondamentale tra capacità di richiamo e consumo di memoria durante la generazione. L’analisi guida il progetto di Based, una semplice architettura ricorrente che supera i precedenti modelli subquadratici nei compiti reali ad alto bisogno di richiamo, come estrazione di informazioni e comprensione del testo, e nell’apprendimento nel contesto. Based genera anche velocemente: elabora i prompt il 56% e il 44% più velocemente di FlashAttention-2 e Mamba, rispettivamente. Raggiunge un throughput di generazione testuale 24 volte superiore a FlashAttention-2.
Ci interessa soprattutto la semplicità di Based. Con due soli elementi noti, l’attenzione a finestra scorrevole con finestre molto piccole e l’attenzione lineare con approssimazione di Taylor di exp(QK^T), possiamo superare le migliori architetture subquadratiche nella modellazione linguistica e accelerare molto rispetto ai Transformer ottimizzati.
Questo post presenta l’analisi sul richiamo nelle architetture subquadratiche che ha portato a Based e il modo in cui lo rendiamo veloce.
L’analisi di partenza: il compromesso tra richiamo e memoria
La domanda che guida l’esplorazione è:
Possiamo migliorare drasticamente velocità reale e consumo di memoria dei modelli linguistici senza compromettere richiamo e apprendimento nel contesto?
Per rispondere abbiamo prima esaminato ciò che rallenta le architetture. Architetture efficienti come Mamba sono molto più veloci dei Transformer in inferenza, per esempio con throughput 5 volte superiore, soprattutto grazie a un’occupazione di memoria ridotta. Meno memoria permette batch più grandi e meno I/O. Ma è intuitivo che ridurla troppo possa danneggiare la capacità del modello di ricordare informazioni precedenti nella sequenza. Sembrava il classico caso in cui non si ottiene nulla gratis. Abbiamo quindi preso diverse architetture diffuse, variato gli iperparametri che influenzano la memoria e valutato un difficile compito sintetico di richiamo associativo.
Tutte le architetture rispettavano un compromesso fondamentale: meno memoria consumavano in inferenza, peggiori erano i risultati nel richiamo associativo. Ci siamo concentrati sulla dimensione dello stato ricorrente, il numero di byte usati per rappresentare i token già visti quando se ne genera uno alla volta, in modo ricorrente.
Nell’attenzione, lo stato è comunemente chiamato cache KV e cresce con la lunghezza della sequenza. In alto a destra nella Figura 1, l’attenzione esegue perfettamente il richiamo, al costo di uno stato ricorrente enorme. L’attenzione a finestra scorrevole limita la cache KV, ma il richiamo cala rapidamente quando riduciamo lo stato: per esempio dal 100% con 1MB al 50% con 65 KB, in azzurro nella Figura 1.
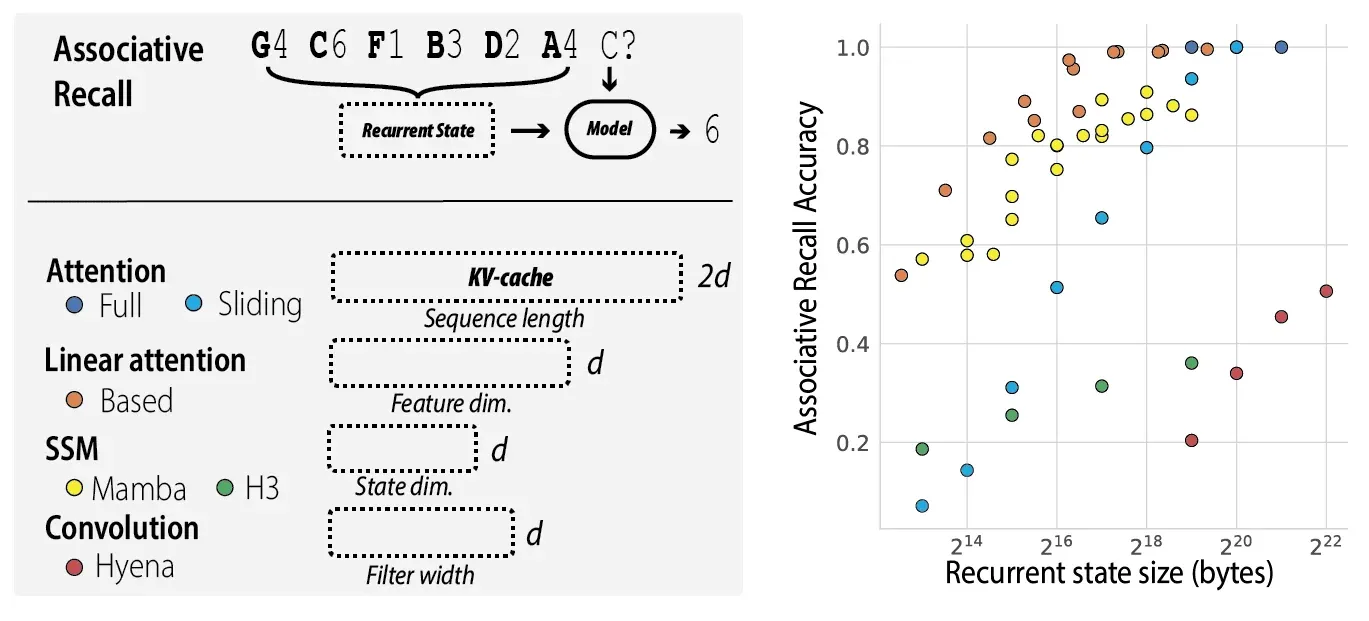
Abbiamo scoperto che Mamba estende la frontiera di Pareto del compromesso richiamo-memoria oltre l’attenzione a finestra scorrevole. Usa quindi meglio uno stato ricorrente limitato rispetto a quel tipo di attenzione.
La domanda naturale è se esistano altri modelli, magari più semplici, capaci di estendere la frontiera.
Based: un modello semplice sulla frontiera di Pareto
Abbiamo iniziato a studiare perché le alternative più semplici all’attenzione softmax non raggiungano un buon compromesso. Come ulteriore principio progettuale, cercavamo primitive adatte all’hardware attuale e futuro. Sarebbe utile, per esempio, sfruttare i Tensor Core delle GPU, hardware specializzato che sulle GPU moderne può eseguire moltiplicazioni di matrici, GEMM, 16 volte più velocemente dei core CUDA per matrici 16x16.
Nel nostro articolo ICLR abbiamo analizzato perché i modelli con una formulazione convoluzionale, come H3 o Hyena, faticano nel richiamo. Abbiamo poi considerato due tecniche di attenzione efficienti e semplici: attenzione a finestra scorrevole e attenzione lineare, cioè senza softmax.
Gli esperimenti su modellazione linguistica reale, fino a 1.4 miliardi di parametri, e richiamo associativo sintetico suggerivano che nessuna delle due primitive da sola bastasse a percorrere la frontiera di Pareto.
- I modelli di pura attenzione lineare faticavano a eseguire spostamenti locali precisi e confronti tra token, capacità importanti per il richiamo, come discusso da Fu et al., 2023, e Arora et al., 2023a, oltre che per l’attenzione densa. Il nostro modello di pura attenzione lineare migliora comunque rispetto alle precedenti architetture subquadratiche. Sulla parte del test Pile che richiede richiamo, cioè previsioni del token successivo basate sul contesto precedente anziché su conoscenze memorizzate, il modello da 355M supera RWKV-v5 di 0.1 punti di perplexity e H3 di 2.6, nella Tabella 1 dell’articolo. È persino comparabile a Mamba su questa porzione: 2.21 per Mamba contro 2.29 per la pura attenzione lineare. Rimane però un divario rispetto ai Transformer, che raggiungono 1.87.
- Nell’attenzione a finestra scorrevole i modelli possono richiamare solo token dentro la finestra, al centro della Figura 2. Aumentando la finestra, lo stato ricorrente cresce linearmente e la velocità di addestramento parallelo e inferenza cambia in modo non lineare, a sinistra nella Figura 2.
Le due primitive sono però complementari: attenzione lineare per interazioni a lungo raggio e finestra scorrevole per interazioni locali nella sequenza. Le abbiamo combinate in Based, a destra nella Figura 2.
- L’attenzione a finestra scorrevole esegue gli spostamenti locali precisi richiesti dal richiamo associativo. Usiamo finestre molto piccole, per esempio 64 negli esperimenti, a differenza di Mistral-7B e del recente Griffin. Finestre più grandi aiutano intuitivamente la qualità, ma vogliamo bilanciarla con il tempo reale di esecuzione. Nel grafico a sinistra, la latenza delle moltiplicazioni di matrici 16x16 e 64x64 è circa uguale; oltre 64 cresce in modo non lineare con la finestra. La somiglianza tra 16x16 e 64x64 deriva dal fatto che quest’ultima mantiene un’occupazione dei Tensor Core sufficiente a saturarli.
- L’attenzione lineare permette interazioni globali tra token mantenendo uno stato ricorrente di dimensione fissa. A differenza dell’attenzione softmax, la dimensione dello stato dipende da iperparametri, come la mappa di caratteristiche, e non dalla lunghezza della sequenza. Possiamo così esplorare gradualmente i compromessi. Usiamo come mappa un’approssimazione di Taylor della funzione esponenziale, introdotta nel nostro lavoro precedente sull’attenzione lineare.
La dimensione dello stato ricorrente di Based non cresce con la sequenza come nell’attenzione. Dipende dalla dimensione delle caratteristiche dell’attenzione lineare e dalla finestra. Regolando questi iperparametri possiamo scambiare richiamo con throughput e percorrere la frontiera di Pareto della Figura 1.
Nonostante la semplicità, negli esperimenti di modellazione linguistica reale fino ad almeno 1.3 miliardi di parametri, Based è competitivo con Mamba nella perplexity complessiva su Pile e nei benchmark zero-shot standard di LM eval harness, indicati come Question Answering - Common.
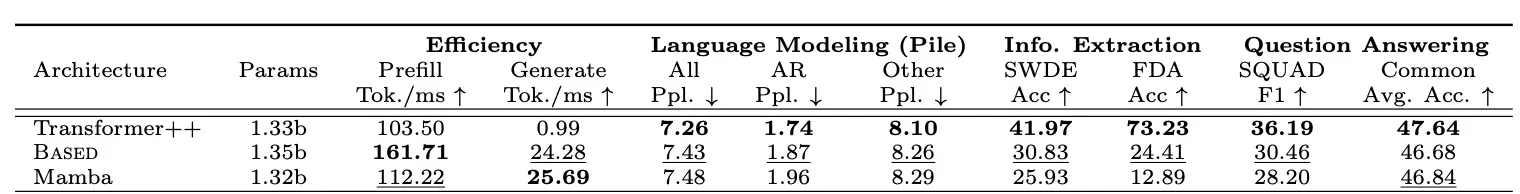
Questi benchmark zero-shot usano testi molto brevi e non mettono davvero alla prova il richiamo. Per colmare la lacuna abbiamo raccolto una piccola serie di benchmark reali ad alto bisogno di richiamo, che richiedono informazioni da documenti lunghi, come estrazione da documenti FDA e HTML grezzo, e comprensione del testo. Based è la migliore architettura subquadratica in questi compiti e supera Mamba in media di 6.22 punti di accuratezza. Entrambi restano però inferiori al miglior Transformer di riferimento, a volte con ampi margini. È coerente con il compromesso osservato prima.
Non pensiamo che Based sia l’unica architettura capace di occupare questo punto sulla curva. Nell’articolo mostriamo, per esempio, che sostituire l’attenzione a finestra scorrevole con convoluzioni corte, filtro di dimensione 3, dà prestazioni simili entro 0.1 punti di perplexity. Sospettiamo che molte altre architetture possano raggiungere questa frontiera e speriamo che altre ancora riescano a superarla.
Conta anche come usiamo lo stato ricorrente fisso
Molte architetture ricorrenti possono avere uno stato nascosto della stessa dimensione, ma il nostro lavoro mostra che contano anche la rappresentazione delle caratteristiche e il meccanismo di aggiornamento. La mappa scelta per Based è semplice: basta il calcolo delle scuole superiori. Approssima l’esponenziale con una serie di Taylor. Calcoliamo ϕ in modo che ϕ(q)ϕ(k)^T ≈ exp(qk^T). Usiamo solo la serie di secondo ordine del lavoro precedente, exp(x)=1+x+x^2/2. Se x ha dimensione d′, il termine x^2 ha dimensione d′^2. Il prodotto esterno chiave-valore cresce rapidamente con d′, ampliando lo stato di Based.
Quanto conta la scelta della rappresentazione rispetto alla dimensione ampliata dello stato per la qualità di Based? È essenziale che il modello usi lo stato bene. Nelle curve di accuratezza rispetto alla dimensione dello stato, diverse alternative alla mappa di Taylor restano sotto la frontiera di Pareto. Confrontiamo modelli che ampliano lo stato con proiezioni apprese e applicano mappe note, Performer, CosFormer e PosELU. Li addestriamo sul test sintetico MQAR per il richiamo associativo, esplorando gli iperparametri, tra cui il tasso di apprendimento, per tutti i punti del grafico. La mappa di Taylor risulta la più efficace. La tendenza si conferma negli esperimenti reali sul corpus Pile; i dettagli sono nell’articolo.
Implementazione attenta a I/O e flusso dei dati
La domanda successiva è come rendere Based competitivo nel tempo effettivo di esecuzione. L’attenzione lineare è teoricamente più efficiente di quella standard rispetto alla lunghezza della sequenza. Ma le implementazioni esistenti sono spesso più lente di implementazioni ottimizzate come FlashAttention.
Based usa l’approssimazione di Taylor di secondo grado, che amplia la dimensione delle chiavi e produce stati grandi e consumo di memoria O(Nd′^2d), con lunghezza della sequenza N, dimensione della chiave d′ e dimensione del valore d. Il grande stato chiave-valore rende lente le implementazioni ingenue.
Le GPU hanno piccole quantità di memoria ad accesso rapido, registri dei thread e memoria condivisa a livello di warp di 32 thread in SRAM, e grandi quantità di memoria più lenta, HBM. Per l’efficienza occorre ridurre letture e scritture tra HBM e SRAM e tra SRAM e registri. Presentiamo nuovi algoritmi attenti all’I/O per il passaggio forward e l’inferenza dell’attenzione lineare di Taylor. Riducono i trasferimenti HBM-SRAM di O(Nd′^2) byte e SRAM-registri di O(Nd′^2d) byte. L’algoritmo mantiene lo stato KV nei registri del thread con dimensione delle caratteristiche d′ = 16, usata negli esperimenti.
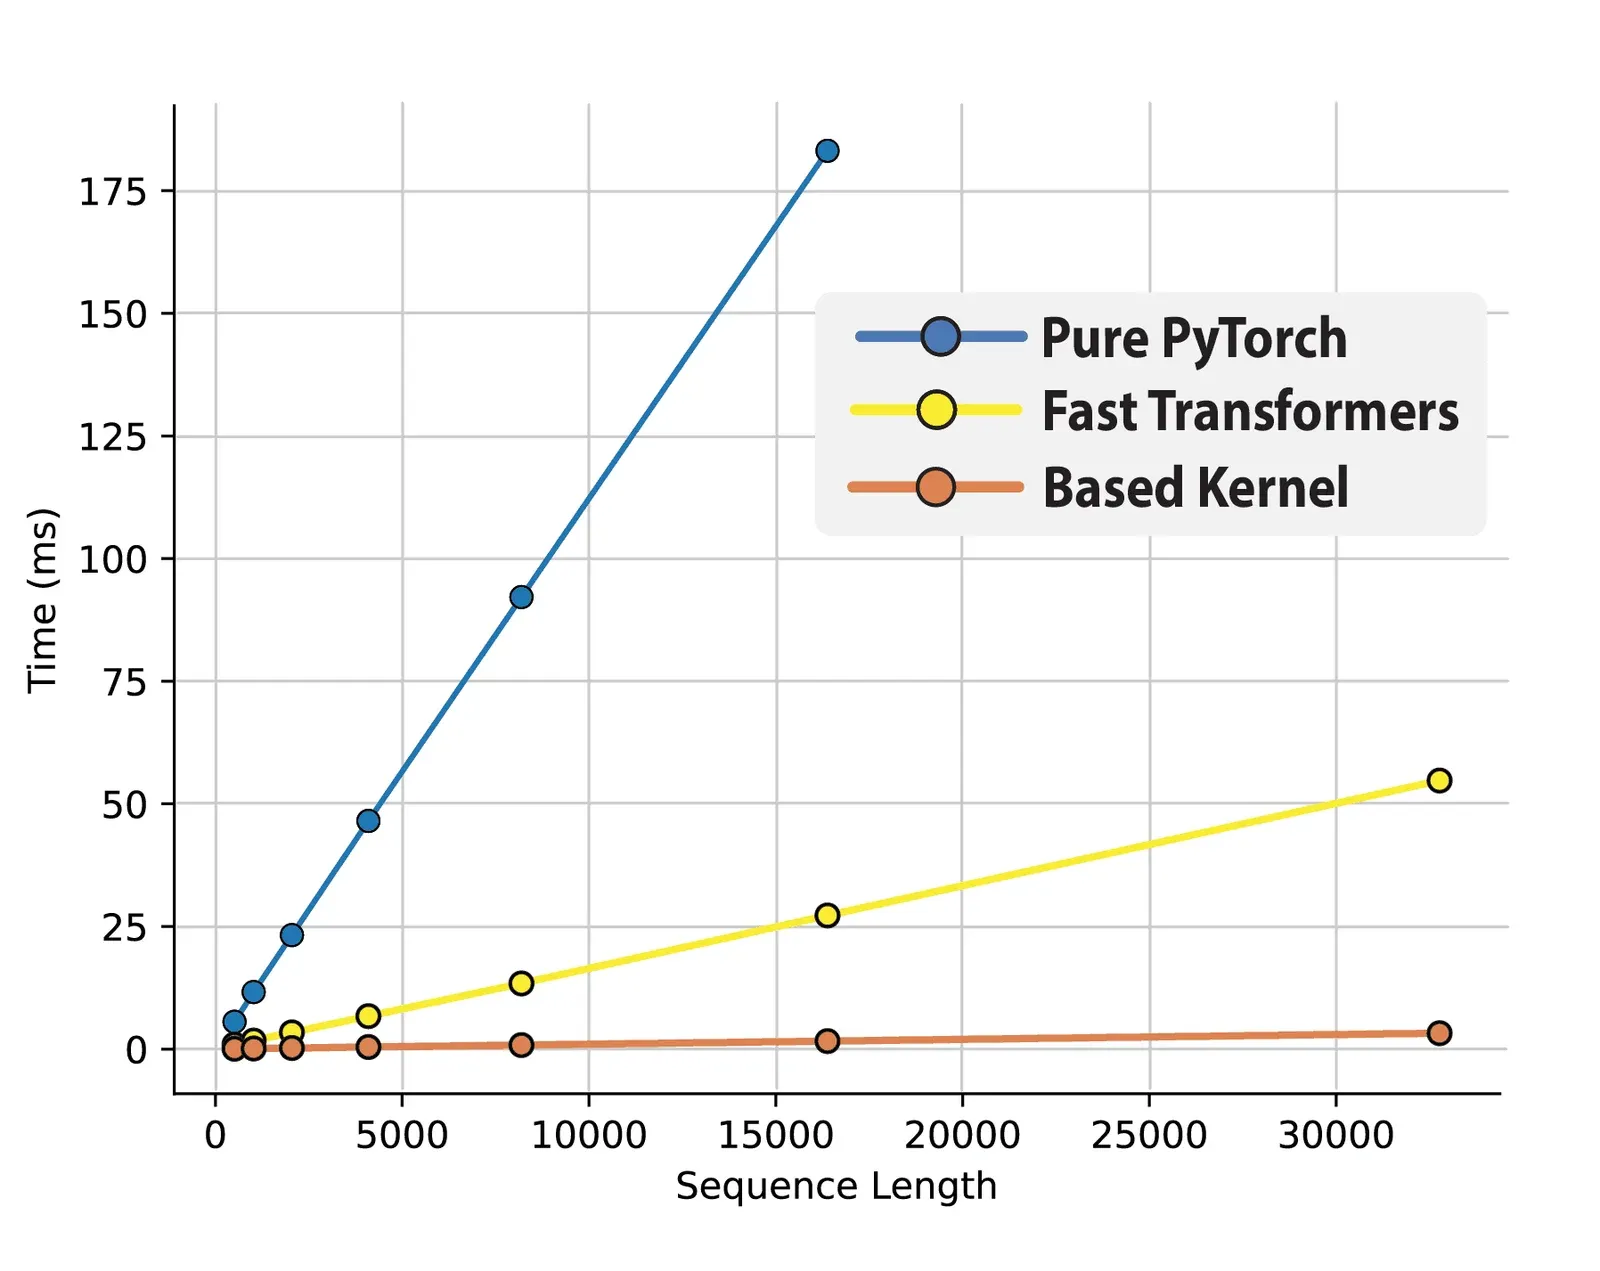
Qui confrontiamo il passaggio forward ingenuo, un’implementazione con i kernel di attenzione lineare di Fast Transformers e i nostri kernel personalizzati, variando la dimensione del batch con sequenza di lunghezza 1024.
Confrontiamo poi la velocità di generazione end-to-end di FlashAttention-2, Mamba e Based con modelli da 360M e 1.3 miliardi di parametri usando gli algoritmi attenti all’I/O. Manteniamo batch 2 per il prefill e generiamo 1024 token per la previsione del token successivo. Based raggiunge un throughput fino a 24 volte superiore a FlashAttention-2.
Presto altri aggiornamenti
Gli algoritmi sono implementati in un nuovo DSL CUDA chiamato ThunderKittens, sviluppato dal nostro laboratorio. Speriamo che renda lo sviluppo CUDA più accessibile e ne parleremo presto. A differenza di framework come Triton, che prendono decisioni specifiche sull’ambito delle operazioni supportate, il nostro DSL è incorporato in C++. Vogliamo condividerlo e raccogliere i vostri riscontri. Nelle prossime settimane prepareremo anche altri modelli, guidati da una domanda: quali modelli vuole l’hardware?
Puoi provare checkpoint e valutazioni su Hugging Face e nel repository https://github.com/HazyResearch/based.