


昨年末に公開したICLR論文とブログで、多くの効率的なアーキテクチャ、たとえばMamba、RWKV、Hyena、RetNetは、コンテキスト内で見た情報に基づいて生成する能力であるリコールにおいて、Transformerに劣ることを報告しました。この能力は、文脈内学習やコピーに欠かせません。この分析からBasedという新しいアーキテクチャを設計し、こちらのブログで予告しました。今回は、その後の進展を紹介します。
最近の研究では、リコールの課題をさらに掘り下げています。まず、モデルのリコール能力と生成時のメモリ使用量の間にある根本的なトレードオフを示します。この分析をもとに設計したBasedは、情報抽出や読解など、リコールを多用する実世界のタスクと文脈内学習で、従来の準二次モデルを上回る単純な再帰型アーキテクチャです。同時に生成も高速で、プロンプト処理はFlashAttention-2より56%、Mambaより44%高速です。テキスト生成のスループットはFlashAttention-2の24倍に達します。
Basedの魅力は、その単純さです。よく知られた二つの注意機構に近い要素、非常に小さいウィンドウのスライディングウィンドウ注意と、exp(QK^T)のテイラー級数近似を用いた線形注意だけで、有力な準二次アーキテクチャを言語モデリングで上回り、最適化されたTransformerより大幅に高速化できます。
この記事では、Basedの設計につながった準二次アーキテクチャのリコール分析と、Basedを高速化する方法を説明します。
出発点となる分析:リコールとメモリのトレードオフ
研究を進める中心の問いは、次のものです。
リコールと文脈内学習の能力を損なわずに、言語モデルの実際の速度とメモリ使用量を大幅に改善できるでしょうか。
まず、アーキテクチャを遅くする原因を考える必要がありました。Mambaなどの効率的なアーキテクチャが推論時にTransformerより大幅に高速で、たとえばスループットが5倍になる大きな理由は、メモリ使用量の小ささです。メモリが少なくて済めば、バッチを大きくし、I/Oを減らせます。しかし減らしすぎれば、系列の前の部分で見た情報を思い出す能力が損なわれそうです。これは「ただで得られるものはない」という状況に見えました。そこで複数の一般的なアーキテクチャで、メモリ使用量に影響するハイパーパラメーターを変え、難しい合成の連想記憶タスクで性能を評価しました。
リコールとメモリのトレードオフ。すべてのアーキテクチャに共通する関係が見つかりました。推論時のメモリ使用量が少ないほど、連想記憶の成績が悪化します。私たちは再帰状態のサイズ、つまりトークンを一つずつ再帰的に生成するとき、それまでのトークンを表すために使うバイト数に着目しました。
注意機構では、この状態は一般にKVキャッシュと呼ばれ、系列長とともに増えます。図1の右上では、注意機構が完全にリコールできる一方、巨大な再帰状態を必要とすることがわかります。スライディングウィンドウ注意ならKVキャッシュの大きさに上限を設けられますが、状態を小さくするとリコール性能は急落します。たとえば再帰状態が1MBでは100%でも、65KBでは50%になります。図1の水色の線です。
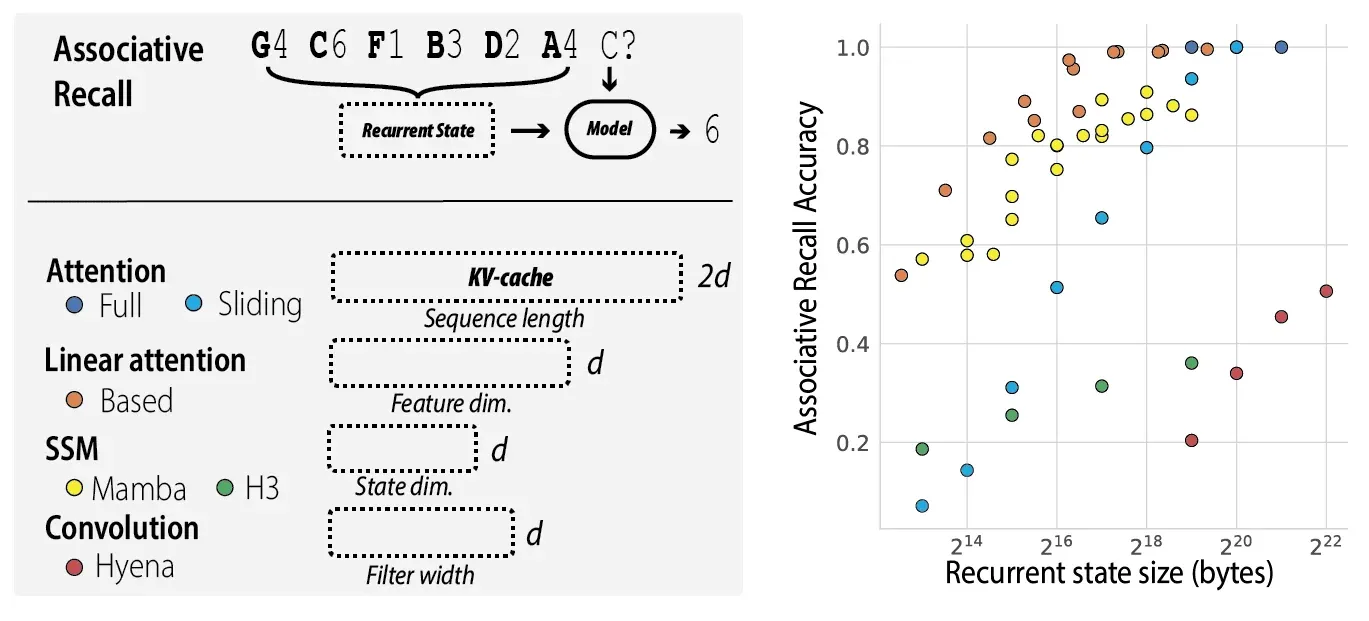
Mambaは、リコールとメモリのトレードオフのパレートフロンティアを、スライディングウィンドウ注意より外側に広げます。つまり、限られた再帰状態をより有効に使っているのです。
では、他の、さらに単純なモデルでもパレートフロンティアを広げられるでしょうか。
Based:パレートフロンティア上の単純なモデル
この問いに答えるため、softmax注意を置き換える単純な手法が、なぜ有利なトレードオフを実現できないのかを調べ始めました。もう一つの設計原則として、現在と将来のハードウェアで効率よく動く基本要素を探しました。たとえば、現代のGPUにある専用ハードウェアTensor Coreを使えると理想的です。16×16行列の積、GEMMを、通常のCUDA Coreの16倍の速度で実行できます。
ICLR論文では、H3やHyenaのような畳み込みとして捉えられるモデルが、なぜリコールを苦手とするのかを詳しく分析しました。次に、最も単純な効率的注意手法の二つ、スライディングウィンドウ注意と、softmaxを使わない線形注意を検討しました。
最大14億パラメーターの実際の言語モデリングと合成の連想記憶の実験から、どちらか一方だけではパレートフロンティアに沿って性能を改善するには不十分だとわかりました。
- 線形注意だけのモデルは、リコールに重要な局所的なトークンの正確なシフトや比較を、密な注意機構ほど上手に行えませんでした(Fu et al., 2023; Arora et al., 2023a)。それでも、従来の準二次アーキテクチャよりは改善しています。Pileテストセットのうち、記憶した知識ではなく前のコンテキストを使う必要がある次トークン予測に注目すると、355Mの線形注意モデルはRWKV-v5より0.1 ppl、H3より2.6 ppl優れています(論文の表1)。このリコール部分では、Mambaの2.21 pplに対して線形注意は2.29 pplと、同程度です。しかしTransformerの1.87 pplとは大きな差があります。
- スライディングウィンドウ注意では、ウィンドウ内のトークンしか思い出せません(図2中央)。ウィンドウを広げると再帰状態は線形に増え、並列学習と推論の速度には非線形の影響が生じます(図2左)。
ただし二つの要素は補い合います。線形注意は遠く離れたトークン同士の関係を、スライディングウィンドウ注意は系列内の局所的な関係を扱います。両者を一つのアーキテクチャにまとめたものがBasedです(図2右)。
- スライディングウィンドウ注意は、連想記憶に必要な正確な局所的シフトを行えます。Mistral-7Bや最近提案されたGriffinよりも非常に小さいウィンドウを使い、実験では64にしています。注意を増やし、ウィンドウを大きくすることは品質にはよさそうですが、実行時間とのバランスが必要です。図の左を見ると、16×16と64×64の行列積のレイテンシはほぼ同じで、64を超えるとウィンドウサイズに対して非線形に増加します。16×16と64×64が近いのは、後者でGPUのTensor Coreを十分に使い切れるためです。
- 線形注意は、固定サイズの再帰状態を維持しながら、大域的なトークン間の関係を扱えます。softmax注意と異なり、状態のサイズは系列長ではなく、特徴写像の選択などのハイパーパラメーターで決まります。そのため、トレードオフの空間を滑らかに移動できます。私たちは線形注意に関する先行研究で初めて用いた、指数関数のテイラー近似を特徴写像として使います。
Basedの再帰状態は、通常の注意機構と違って系列長とともに増えません。線形注意の特徴次元とウィンドウサイズで決まります。これらを調整することで、リコールとスループットを交換し、図1のパレートフロンティアに沿って動けます。
単純な構成にもかかわらず、少なくとも13億パラメーターまでの実際の言語モデリング実験では、Pile全体のパープレキシティと、LM eval harnessの標準的なゼロショットベンチマークでMambaと競争力があります。図ではQuestion Answering - Commonに示しています。
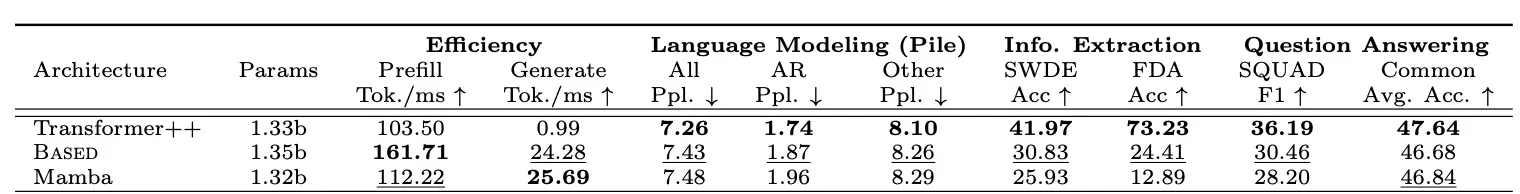
よく使われるこれらのゼロショットベンチマークは、非常に短いテキストに限られ、リコール能力を十分に試せません。そこで、長い文書の情報を思い出す必要がある実世界のリコール重視ベンチマークを小規模に選定しました。ベンチマークには、FDA文書や生のHTMLからの情報抽出、読解が含まれます。Basedはこれらのタスクで準二次アーキテクチャの中で最も高い性能を示し、正解率でMambaを平均6.22ポイント上回ります。ただし、BasedもMambaも最強のTransformerベースラインには届かず、大差がつくこともあります。これは先ほどの「ただで得られるものはない」という観察と一致します。
Basedだけがこのトレードオフ曲線上の位置を実現できるとは考えていません。論文では、スライディングウィンドウ注意をフィルターサイズ3の短い畳み込みに置き換えても、パープレキシティの差が0.1以内の同程度の性能を得られることを示しました。他にもこのパレートフロンティアに並ぶアーキテクチャは多くあり、さらに外側へ広げるものもあると期待しています。
固定サイズの再帰状態をどう使うかも重要
隠れ状態のサイズが同じ再帰型アーキテクチャは多くありますが、特徴の表現方法、たとえば線形注意の特徴写像や状態更新の仕組みも重要です。Basedで選んだ写像は驚くほど単純で、高校の微積分がわかれば理解できます。指数関数をテイラー級数で近似し、ϕ(q)ϕ(k)^T ≈ exp(qk^T)となるϕを計算します。先行研究と同じく二次までを使い、exp(x)=1+x+x^2/2とします。xの次元がd′なら、x^2の項の次元はd′^2になります。キーとバリューの外積の結果はd′に対して急速に増え、Basedの状態サイズが拡大します。
Basedの品質には、特徴表現の選択と状態サイズの拡大のどちらがどのくらい効いているのでしょうか。 重要なのは、モデルが状態を有効に使えることです。正解率と再帰状態サイズの曲線では、テイラー写像の代替案のいくつかがパレートフロンティアの内側にあります。学習した射影で状態を拡大した後、既存の一般的な特徴写像であるPerformer、CosFormer、PosELUを使うモデルと比較しました。MQAR合成テストで連想記憶を学習し、図の各点で学習率を探索した結果、テイラー写像が最も有効でした。この傾向はPile言語モデリングコーパスでの実世界の実験にも当てはまります。詳細は論文をご覧ください。
I/Oとデータの流れを考慮した実装
次の課題は、実際の実行時間でもBasedを競争力のあるものにすることです。系列長に対する理論上の効率では線形注意が通常の注意機構に勝りますが、既存の実装はFlashAttentionのようによく最適化された注意機構より遅いことがよくあります。
Basedでは二次のテイラー近似によってキーの次元が拡大し、状態サイズとメモリ使用量が大きくなります。系列長をN、キー次元をd′、バリュー次元をdとすると、メモリ使用量はO(Nd′^2d)です。この大きなキーとバリューの状態により、素朴なテイラー線形注意の実装は遅くなります。
ハードウェアの仕組みを振り返りましょう。GPUには、スレッド固有のレジスターやwarp、つまり32スレッド単位のSRAM共有メモリなど、少量で高速なメモリと、大量で低速なHBMがあります。効率を上げるには、HBMとSRAM、さらにSRAMとレジスターの間の読み書きを減らす必要があります。私たちはテイラー線形注意の順伝播と推論向けに新しいI/Oを考慮したアルゴリズムを提案し、HBMからSRAMへの移動をO(Nd′^2)バイト、SRAMからレジスターへの移動をO(Nd′^2d)バイト減らします。実験で使う特徴次元d′ = 16では、KV状態をスレッド内のレジスターに保持できます。
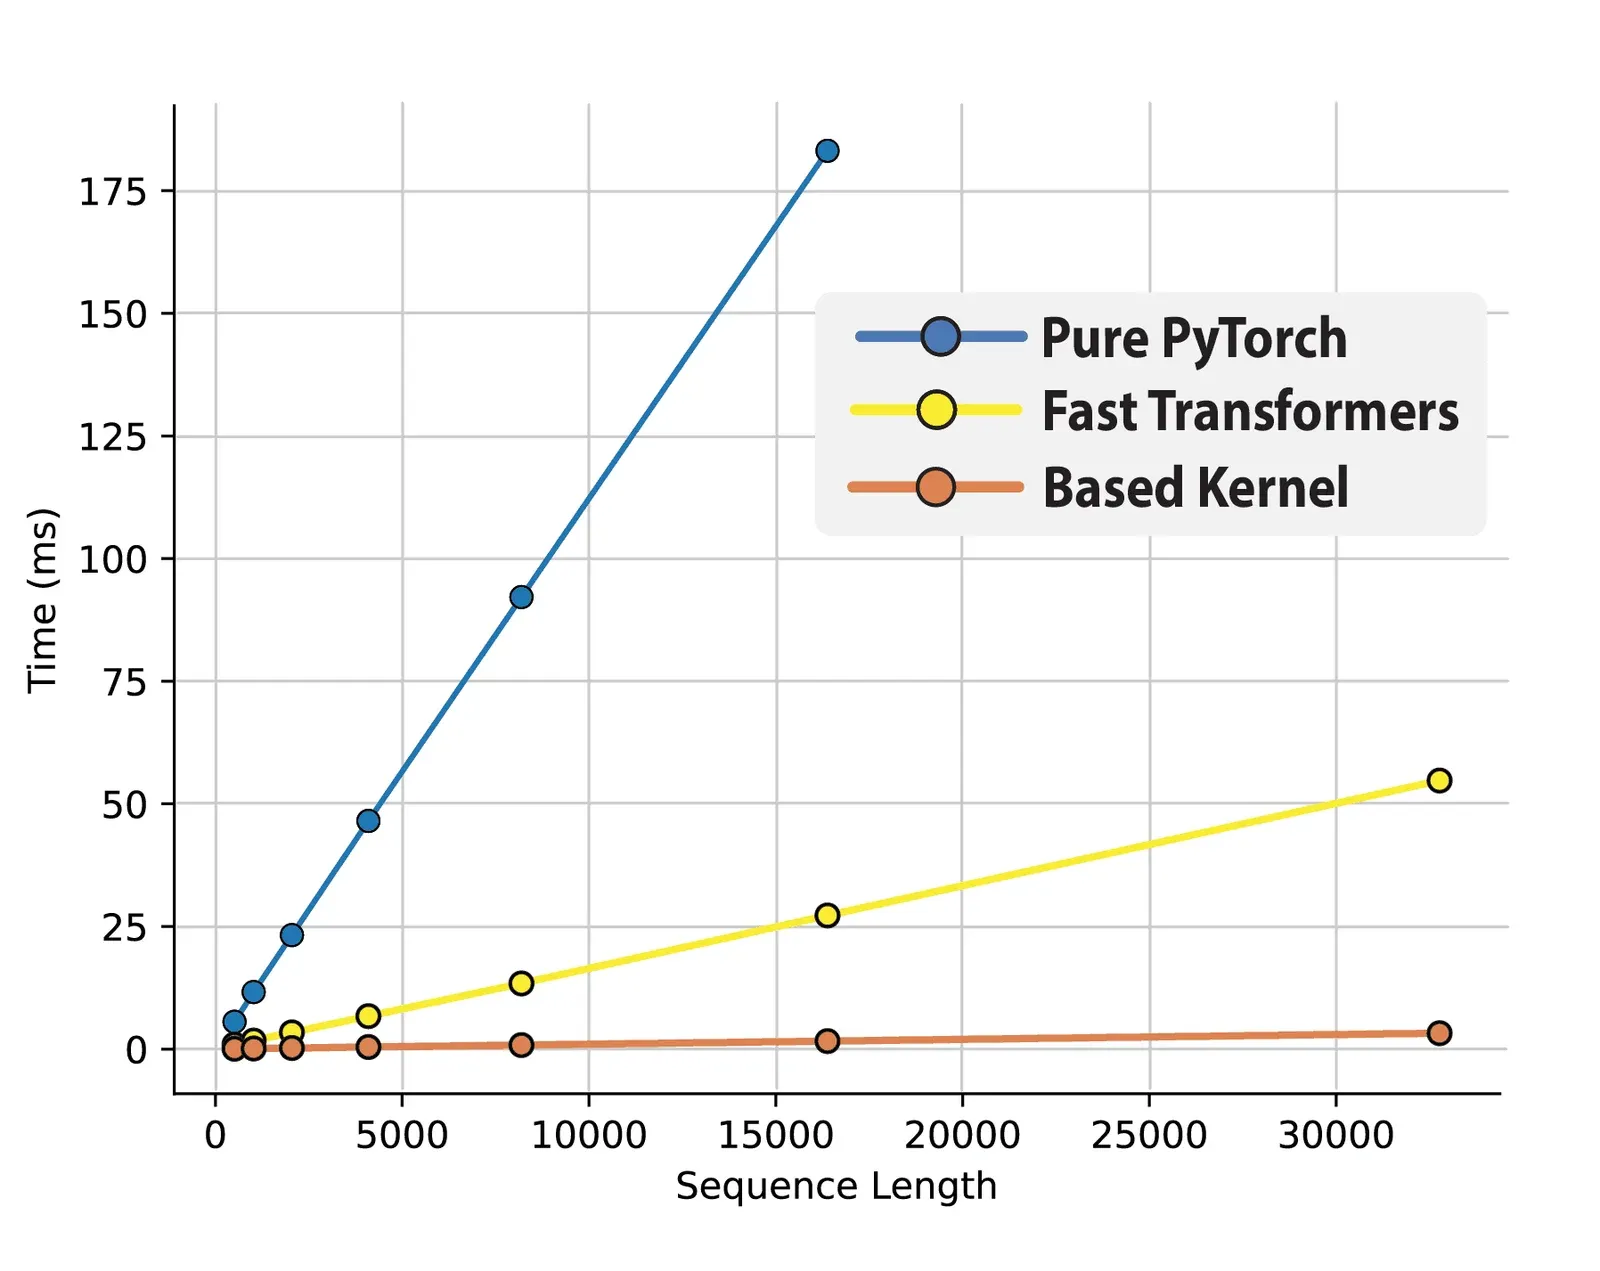
次の図は、系列長1024でバッチサイズを変えながら、素朴なテイラー注意の順伝播、Fast Transformersの一般的な線形注意カーネルを使った実装、独自カーネルを比較したものです。
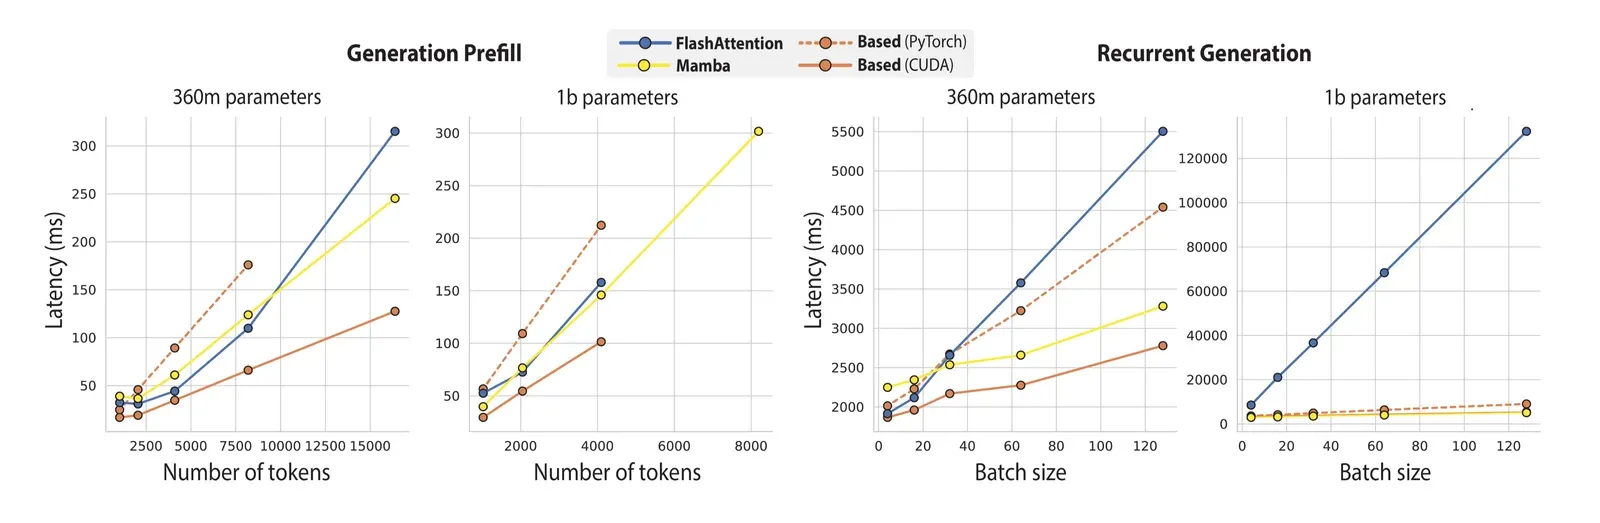
さらに、I/Oを考慮したアルゴリズムを使い、360Mと1.3BnパラメーターのモデルでFlashAttention-2、Mamba、Basedの生成全体の速度を比較しました。prefillのバッチサイズを2に固定し、次トークン予測で1024トークンを生成します。BasedはFlashAttention-2の最大24倍のスループットを達成しました。
今後の公開にもご注目ください
これらのアルゴリズムは、研究室で開発中の新しいCUDA DSL、ThunderKittensで実装しています。詳細は近日公開予定です。このDSLでCUDAの開発をしやすくしたいと考えています。利用できる操作の範囲に独自の方針を持つTritonのようなフレームワークと異なり、私たちのDSLはC++に埋め込まれています。公開後のご意見をお待ちしています。今後数週間は、「ハードウェアはどんなモデルを求めているのか」という問いをもとに、さらにモデル関連の成果物を用意しています。
チェックポイントと評価はHugging Faceとコードリポジトリで試せます。