

오늘날 가장 뛰어난 AI 아키텍처는 모든 입력을 똑같이 다룹니다. 관련 입력을 상위 개념으로 명시적으로 묶지 않고 각 입력에 같은 양의 연산을 사용합니다. 여러 분야에서 좋은 성과를 냈지만 계층이 없다는 점에는 근본적인 한계가 있습니다.
- 고해상도 원시 데이터에서 학습하기 어려워 좋은 성능을 얻으려면 의미 있는 토큰으로 전처리해야 합니다.
- 토큰화처럼 사람이 설계한 전처리 때문에 입력의 작은 변화에도 예상치 못하게 실패할 수 있습니다.
- 예측이 쉽고 정보가 적은 토큰에도 연산을 낭비합니다.
더 근본적으로 정보 자체가 계층적입니다. 언어에서는 문자, 단어, 문장, 문단으로 생각을 묶고, 이미지에서는 픽셀을 모서리, 모양, 사물로 묶습니다. 오디오의 원시 파형은 음소, 문장, 대화 차례로 묶습니다. 사람은 원시 정보를 받아 의미 있게 그룹화하며 낮은 수준의 단위부터 높은 수준의 생각까지 여러 추상화 단계에서 추론하고 연결합니다. 지능의 핵심입니다. 계층적 모델이 현재 아키텍처의 여러 근본적인 한계를 해결할 것이라 믿습니다.
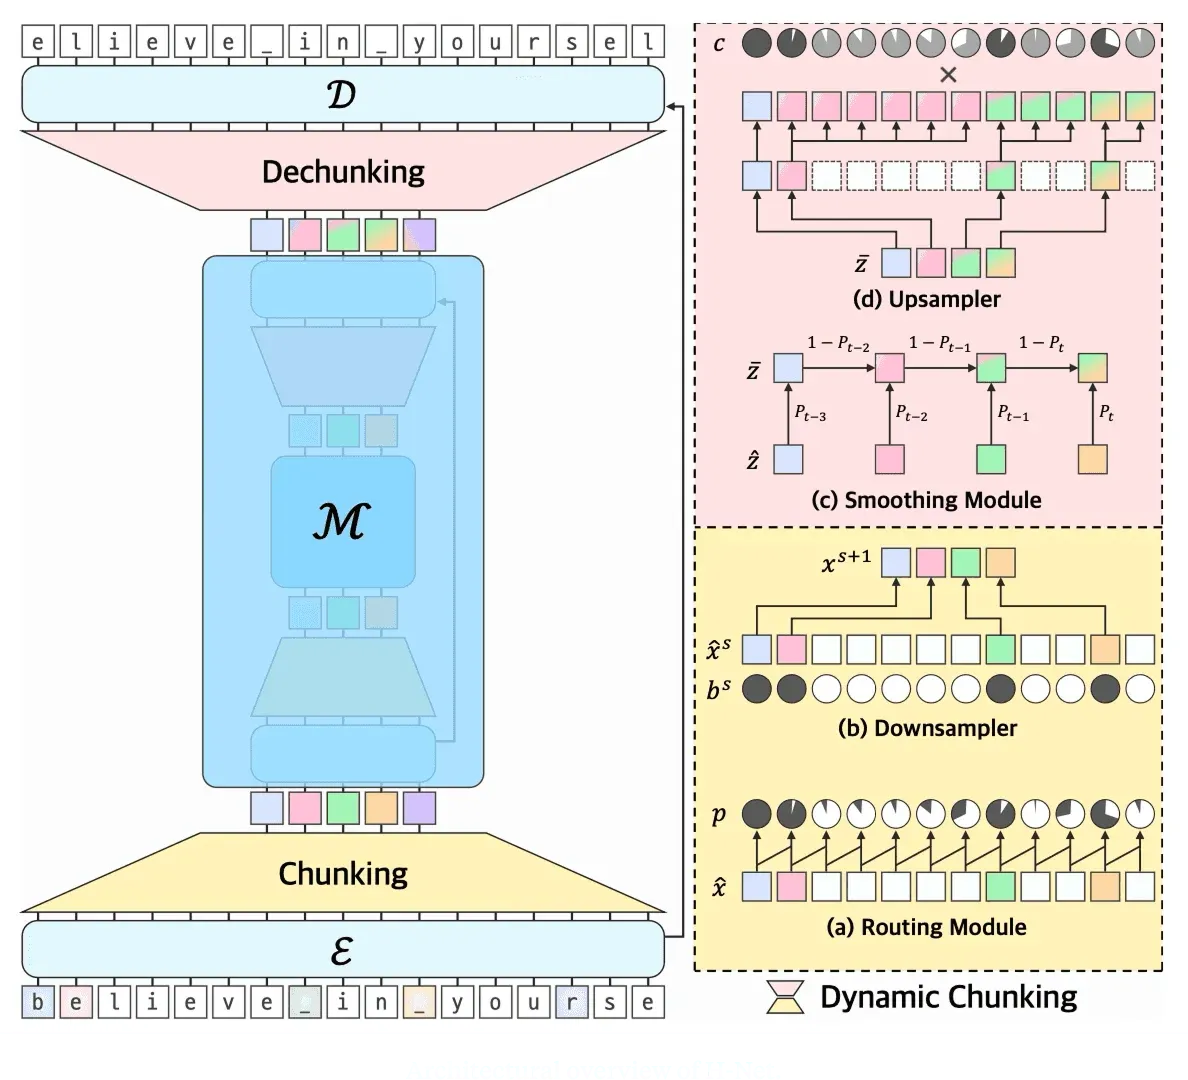
원시 데이터에서 계층을 직접 모델링하는 새 아키텍처 계층적 네트워크 H-Net에 관한 공동 연구를 발표합니다. 핵심은 원시 데이터를 의미 있는 개념으로 나누고 압축하는 법을 학습하는 동적 청킹입니다. 인코더 네트워크, 메인 네트워크, 디코더 네트워크로 구성됩니다. 인코더의 중심인 라우팅 모듈은 유사도 점수로 함께 묶어 메인 네트워크에 압축해 전달할 청크를 예측합니다. 메인 네트워크는 어떤 시퀀스 대 시퀀스 모델이든 가능하며 상위 청크의 다음 토큰 예측을 담당합니다. 마지막으로 디코더는 청크를 원시 데이터로 되돌리는 법을 학습하고, 스무딩 모듈로 학습을 안정화합니다.
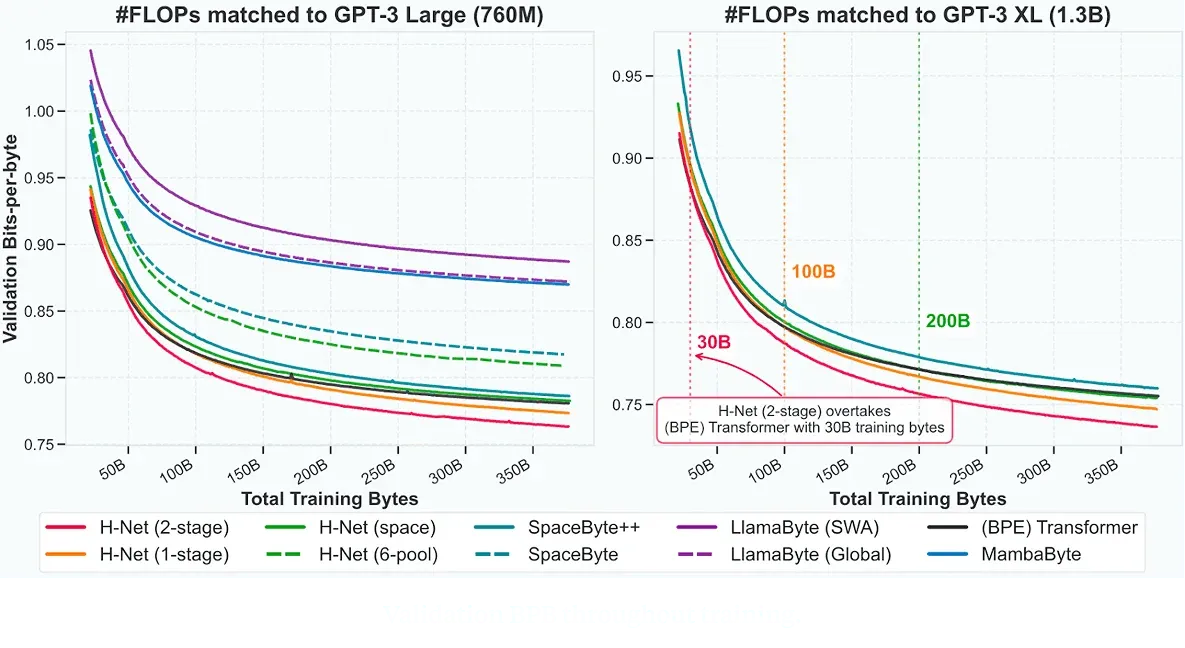
H-Net은 언어 모델링에서 세 가지 중요한 결과를 보여줍니다.
- 원시 바이트에서 직접 학습하면서 BPE 토큰화를 쓰는 최신 Transformer보다 데이터가 늘어날 때 더 잘 확장됩니다. 중국어, 코드, DNA처럼 자연스러운 토큰 경계가 없는 분야에서 차이가 더 큽니다.
- H-Net을 쌓아 더 깊은 계층에서 학습하면 성능이 더 좋아집니다.
- 대소문자 같은 입력의 작은 변화에 훨씬 강합니다. 인간의 추론과 더 잘 맞고 안정적인 모델을 만들 가능성을 보여줍니다.
이 연구는 멀티모달이고 효율적이며 긴 시간에 걸쳐 추론하고 개선하는 차세대 AI 모델을 만들려는 계획의 일부입니다. 첫 연구 성과인 상태 공간 모델은 긴 문맥의 정보를 압축하는 상태 유지 모델을 가능하게 했습니다. H-Net과 계층적 모델링은 다음 근본적인 AI 과제를 해결할 중요한 다음 단계라고 믿습니다.
- 멀티모달 이해와 생성. 여러 데이터 스트림을 합치는 것은 핵심 과제입니다. 모달리티마다 토큰화 비율이 달라 어렵습니다. 언어는 하위 단어로, 오디오는 원시 파형이나 다운샘플링한 코덱으로 토큰화해 함께 모델링하기 어렵습니다. H-Net 같은 계층적 모델은 더 높은 추상화 수준에서 스트림을 합쳐 모달리티 간 전이, 추론, 이해를 개선할 유망한 방법입니다.
- 긴 문맥 추론. H-Net은 정보를 상위 추상화의 의미 있는 단위로 묶어 긴 문맥 추론을 가능하게 합니다. 압축 덕분에 특히 계층이 깊어질수록 큰 입력을 이해하고 추론하기 쉬워집니다. 계층적 아키텍처는 원시 데이터로 환경을 이해하고 긴 시간에 걸쳐 적절한 추상화 수준에서 추론하는 모델을 가능하게 합니다.
- 효율적인 학습과 추론. 일부 토큰은 정보가 적고 예측하기 쉬워도 현재 아키텍처는 모든 토큰에 같은 연산을 사용합니다. 추측 디코딩 같은 추론 최적화는 이를 이용해 쉬운 토큰의 계산을 빠르게 합니다. H-Net은 가벼운 인코더와 디코더로 쉬운 토큰을 처리해 이 원리를 아키텍처 자체에 넣습니다.
자세한 내용은 arXiv의 전체 프리프린트를 읽어보세요. HuggingFace에 H-Net 2-stage XL, H-Net 1-stage XL, H-Net 1-stage L 체크포인트도 공개했습니다.
아키텍처 연구의 미래와 새 모델을 대규모로 제공하는 시스템·인프라 개발에 관심이 있다면 연락해 주세요.