

Le migliori architetture IA attuali trattano tutti gli input allo stesso modo. Elaborano ogni input con la stessa quantità di calcolo, senza raggruppare esplicitamente quelli correlati in concetti di livello superiore. Queste architetture hanno ottenuto risultati notevoli in molti ambiti, ma l’assenza di gerarchia comporta limiti fondamentali.
- I modelli faticano ad apprendere da dati grezzi ad alta risoluzione e richiedono una pre-elaborazione degli input in token significativi per ottenere buone prestazioni.
- I passaggi di pre-elaborazione progettati manualmente, come la tokenizzazione, possono causare errori inattesi anche con piccole perturbazioni dei dati in ingresso.
- I modelli sprecano calcolo su token facili da prevedere e poco informativi.
Soprattutto, l’informazione è fondamentalmente gerarchica. Nel linguaggio, le idee si articolano in caratteri, parole, frasi e paragrafi; nelle immagini, i pixel si raggruppano in bordi, forme e oggetti; nell’audio, le forme d’onda grezze si raggruppano in fonemi, frasi e turni di conversazione. Noi esseri umani riceviamo informazioni grezze e le organizziamo in modi significativi che ci permettono di ragionare e creare connessioni a diversi livelli di astrazione, dalle unità di base alle idee di alto livello. È una parte centrale dell’intelligenza. Crediamo che i modelli gerarchici affronteranno diversi limiti fondamentali delle architetture attuali.
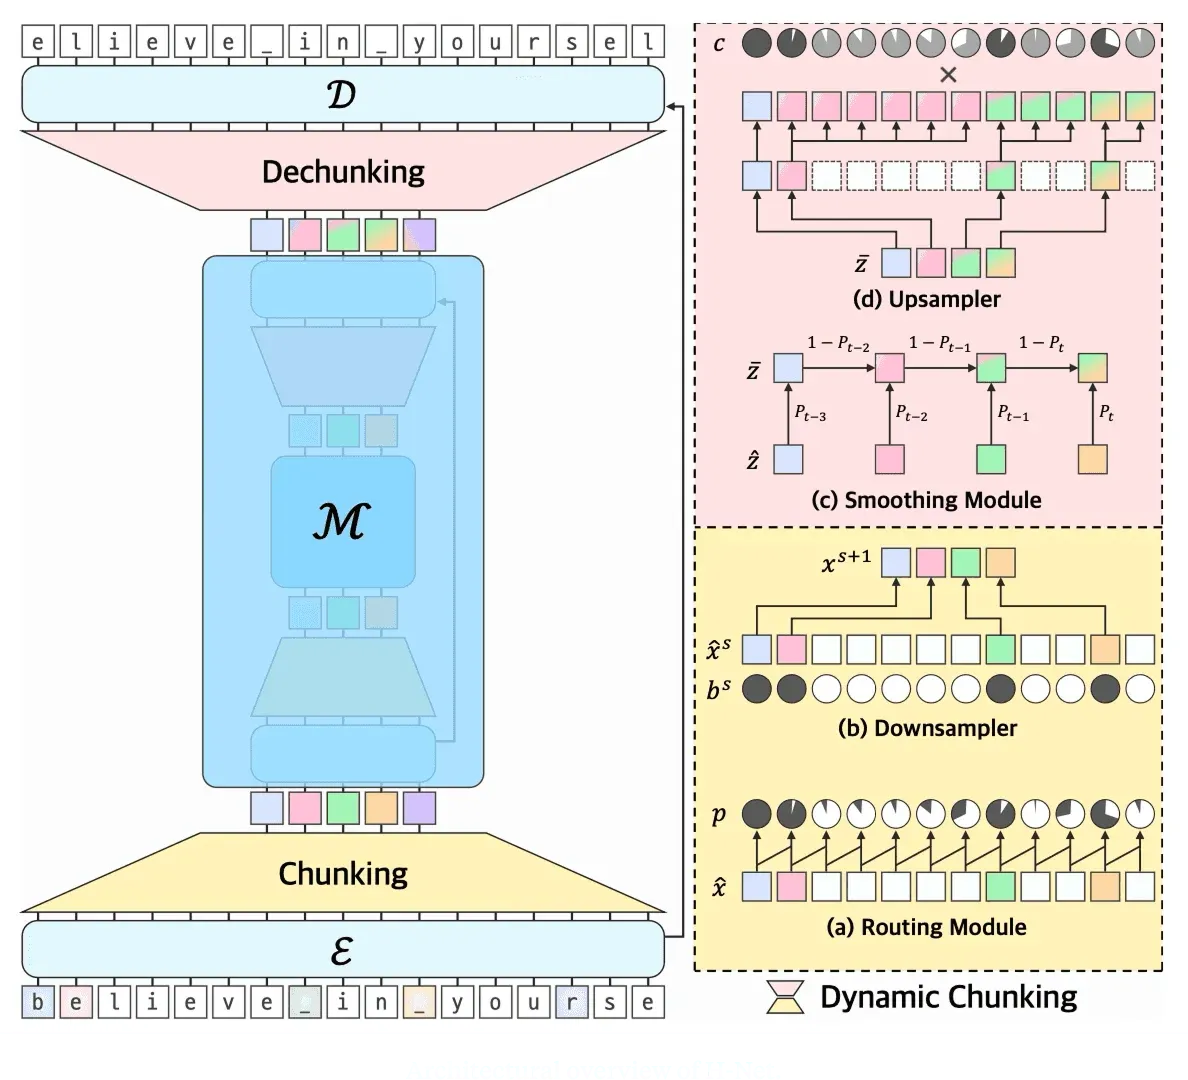
Annunciamo la nostra ultima collaborazione di ricerca sulle reti gerarchiche, H-Net, una nuova architettura che modella nativamente la gerarchia a partire dai dati grezzi. Il suo nucleo è un meccanismo di suddivisione dinamica in blocchi che impara a segmentare e comprimere i dati grezzi in concetti significativi da modellare. Ha tre componenti: una rete encoder, la rete principale e una rete decoder. Al centro dell’encoder c’è un modulo di instradamento che usa un punteggio di similarità per prevedere quali blocchi significativi raggruppare e comprimere per la rete principale. Quest’ultima può essere qualsiasi modello da sequenza a sequenza ed è responsabile della previsione del token successivo su questi blocchi di livello superiore. Infine, il decoder impara a trasformare i blocchi di nuovo in dati grezzi, con un modulo di smussamento che stabilizza l’apprendimento.
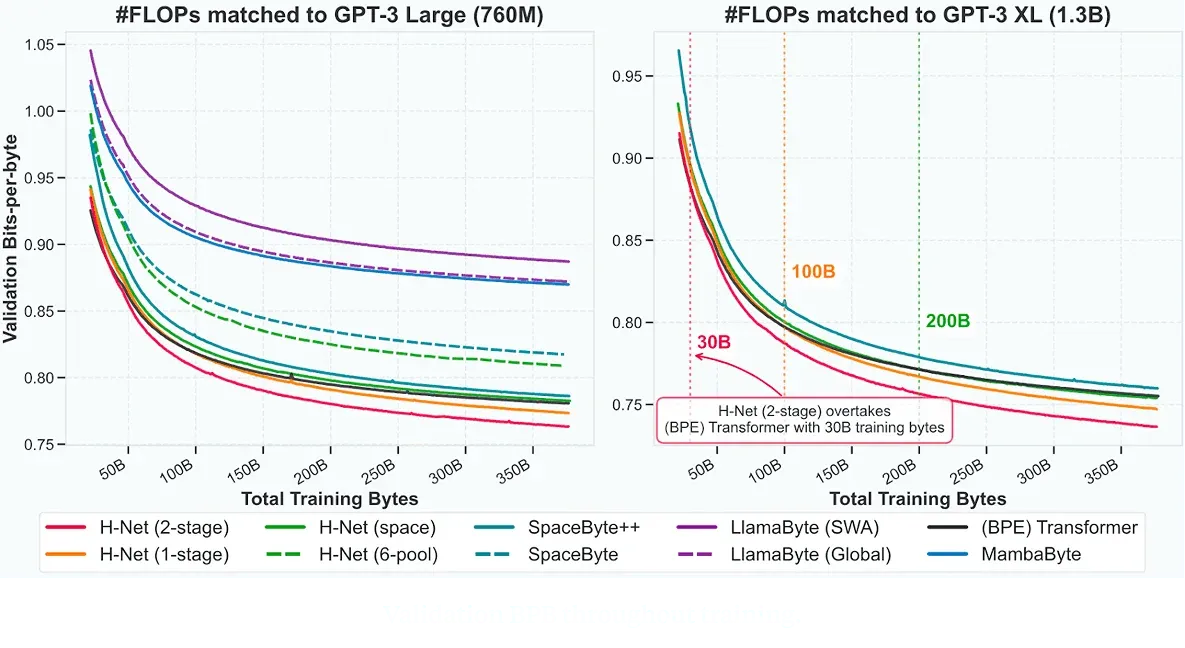
H-Net dimostra tre risultati importanti nella modellazione del linguaggio:
- Le H-Net scalano con i dati meglio dei Transformer più avanzati con tokenizzazione BPE, pur imparando direttamente dai byte grezzi. Il vantaggio è ancora più evidente nei domini senza confini naturali di tokenizzazione, come cinese, codice e DNA.
- Le H-Net possono essere impilate per apprendere da gerarchie più profonde, migliorando ulteriormente le prestazioni.
- Le H-Net resistono molto meglio a piccole perturbazioni degli input, come i cambiamenti tra maiuscole e minuscole. Indicano così una strada verso modelli più stabili e più vicini al ragionamento umano.
Il nostro investimento in questa ricerca fa parte di un lavoro più ampio per costruire la prossima generazione di modelli IA multimodali, molto efficienti e capaci di ragionare e migliorare su orizzonti lunghi. I modelli a spazio di stato sono stati il nostro primo progresso di ricerca: modelli con stato che comprimono informazioni su contesti lunghi. Crediamo che H-Net e la modellazione gerarchica siano il passo successivo per affrontare sfide fondamentali dell’IA:
- Comprensione e generazione multimodale. Una sfida centrale è fondere più flussi di dati. Oggi è difficile perché le modalità vengono tokenizzate a frequenze diverse. Il linguaggio, per esempio, viene suddiviso in sottoparole, mentre l’audio viene rappresentato come forme d’onda grezze o codec sottocampionati. Questo rende difficile modellarli insieme. Modelli gerarchici come H-Net offrono una strada promettente per fondere questi flussi a un livello di astrazione superiore, migliorando trasferimento, ragionamento e comprensione tra le modalità.
- Ragionamento su contesti lunghi. Le H-Net suddividono le informazioni in unità semanticamente significative a livelli di astrazione superiori. Questa compressione facilita la comprensione e il ragionamento su input grandi, soprattutto con gerarchie sempre più profonde. Le architetture gerarchiche permetteranno modelli che comprendono l’ambiente dai dati grezzi e ragionano ai livelli di astrazione appropriati su orizzonti lunghi.
- Addestramento e inferenza efficienti. Le architetture attuali usano la stessa quantità di calcolo per ogni token, anche se alcuni sono meno informativi e più facili da prevedere. Ottimizzazioni dell’inferenza come la decodifica speculativa sfruttano questa proprietà per accelerare il calcolo sui token più prevedibili. In H-Net questo comportamento è integrato nell’architettura, che gestisce tali token con moduli encoder e decoder leggeri.
Per approfondire, leggi il preprint completo su arXiv. Abbiamo anche pubblicato i checkpoint di H-Net 2-stage XL, H-Net 1-stage XL e H-Net 1-stage L su HuggingFace.
Se ti interessa il futuro della ricerca sulle architetture e vuoi costruire sistemi e infrastrutture per erogare questi modelli su larga scala, contattaci.