

As melhores arquiteturas de IA usadas hoje tratam todas as entradas da mesma forma. Elas dedicam a mesma quantidade de computação a cada entrada, sem agrupar explicitamente entradas relacionadas em conceitos de nível mais alto. Embora tenham alcançado resultados expressivos em vários domínios, essa ausência de hierarquia impõe limitações fundamentais.
- Os modelos têm dificuldade para aprender com dados brutos de alta resolução. Para obter bom desempenho, precisam que as entradas sejam pré-processadas em tokens significativos.
- Etapas de pré-processamento definidas manualmente, como a tokenização, podem fazer os modelos falharem de forma inesperada diante de pequenas alterações nos dados de entrada.
- Os modelos desperdiçam computação em tokens fáceis de prever e pouco informativos.
A própria informação é fundamentalmente hierárquica. Na linguagem, as ideias se organizam em caracteres, palavras, frases e parágrafos. Nas imagens, os pixels se agrupam em bordas, formas e objetos. No áudio, as formas de onda brutas se agrupam em fonemas, frases e turnos de conversa. Nós, humanos, recebemos informações brutas e as agrupamos de maneiras significativas, que nos permitem raciocinar e estabelecer conexões em diferentes níveis de abstração, das unidades mais básicas às ideias mais amplas. Isso está no centro da inteligência. Acreditamos que modelos hierárquicos resolverão várias limitações fundamentais das arquiteturas atuais.
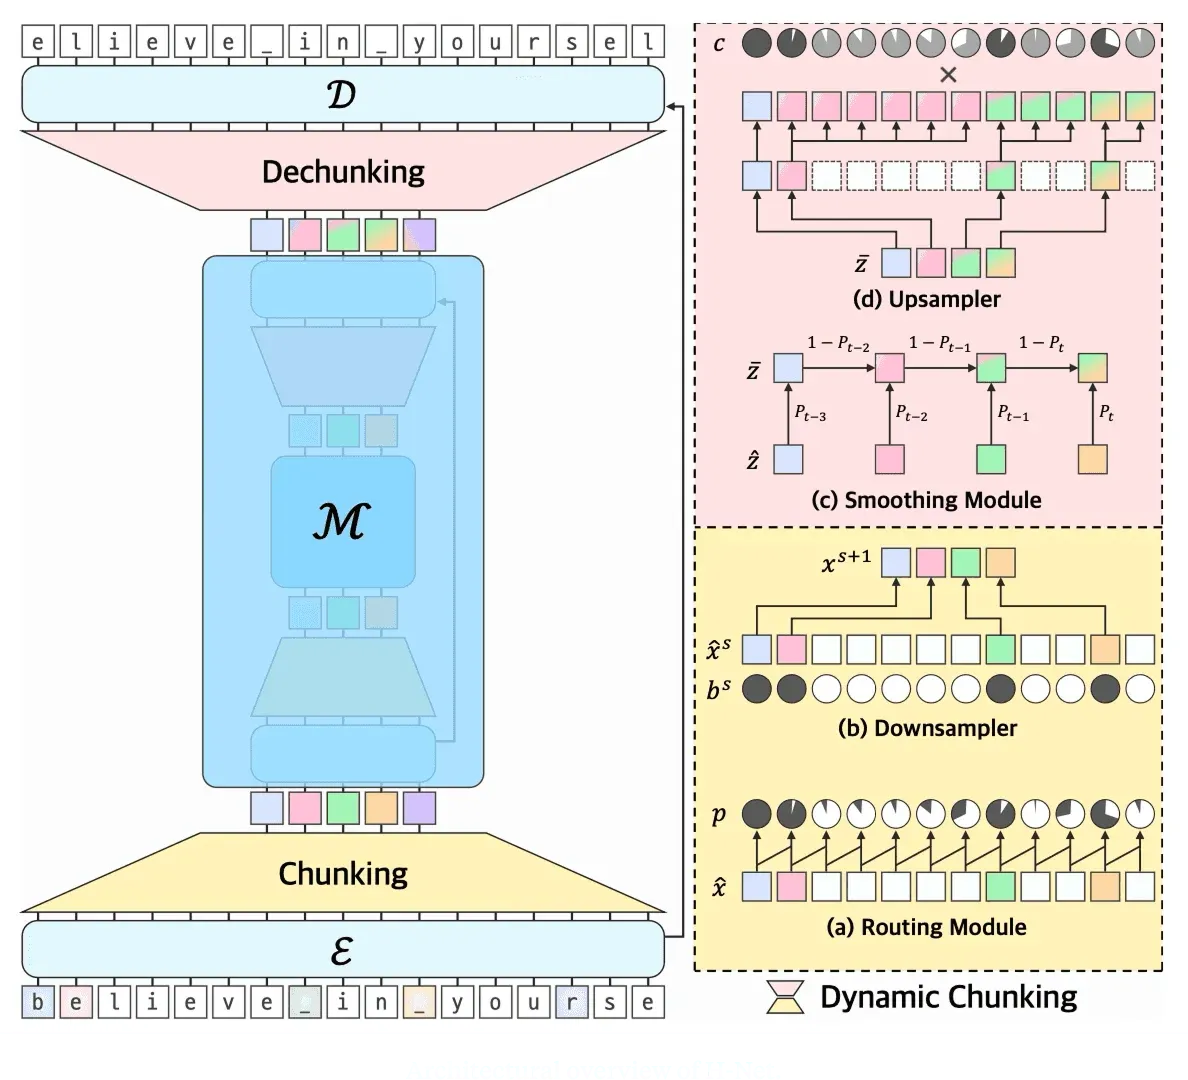
Apresentamos nossa mais recente colaboração de pesquisa sobre redes hierárquicas, ou H-Nets, uma nova arquitetura que modela hierarquias diretamente a partir de dados brutos. O centro da arquitetura H-Net é um mecanismo de agrupamento dinâmico que aprende a segmentar e comprimir dados brutos em conceitos significativos para a modelagem. Ela tem três componentes, uma rede codificadora, a rede principal e uma rede decodificadora. No centro da rede codificadora há um módulo de roteamento, que usa uma pontuação de similaridade para prever quais segmentos significativos devem ser agrupados e comprimidos para a rede principal. A rede principal pode ser qualquer modelo de sequência para sequência e prevê o próximo token nesses segmentos de nível mais alto. Por fim, a rede decodificadora aprende a converter os segmentos de volta em dados brutos, com um módulo de suavização para estabilizar o aprendizado.
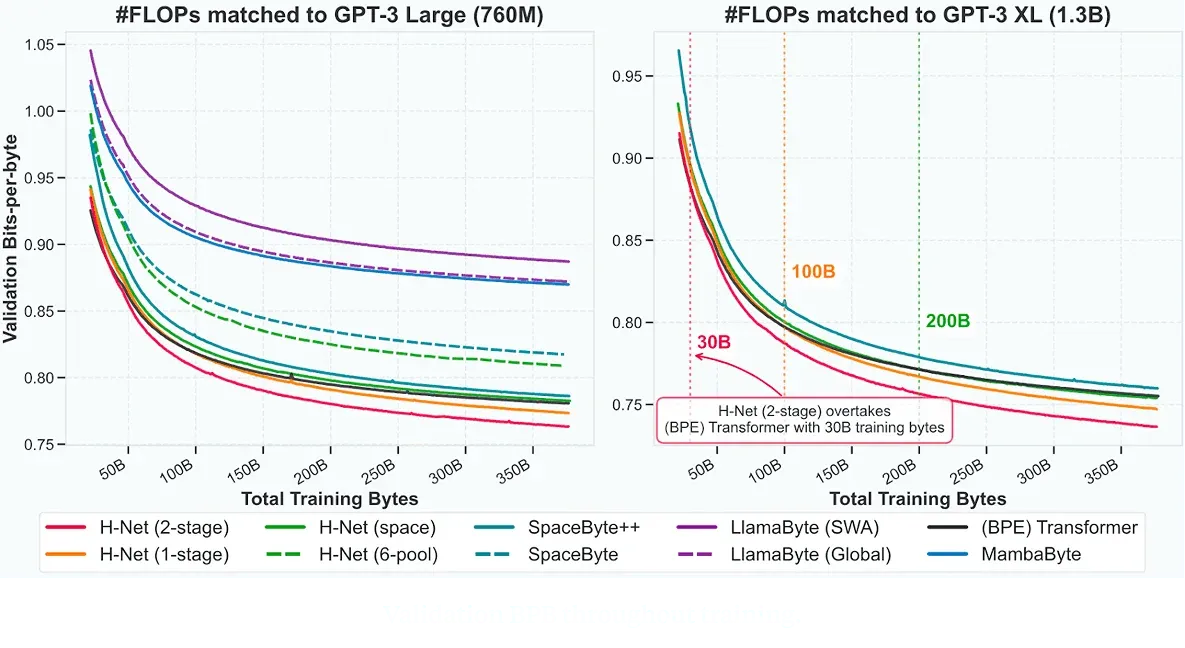
O H-Net demonstra três resultados importantes em modelagem de linguagem:
- H-Nets escalam melhor com o volume de dados que Transformers de ponta com tokenização BPE, enquanto aprendem diretamente de bytes brutos. Essa melhora é ainda mais acentuada em domínios sem limites naturais de tokenização, como chinês, código e DNA.
- H-Nets podem ser empilhadas para aprender hierarquias mais profundas, melhorando ainda mais o desempenho.
- H-Nets são significativamente mais resistentes a pequenas alterações nos dados de entrada, como mudanças entre maiúsculas e minúsculas. Isso aponta um caminho para criar modelos mais resistentes e alinhados ao raciocínio humano.
Nosso investimento nessa pesquisa faz parte de um esforço maior para construir a próxima geração de modelos de IA, capazes de trabalhar com múltiplas modalidades, operar com alta eficiência, raciocinar e melhorar ao longo de períodos extensos. Os modelos de espaço de estados foram nosso primeiro avanço de pesquisa, viabilizando modelos com estado que comprimem informações de contextos longos. Acreditamos que H-Nets e a modelagem hierárquica sejam o próximo passo essencial para enfrentar desafios fundamentais da IA:
- Compreensão e geração multimodal: um dos principais desafios da modelagem multimodal é combinar vários fluxos de dados. Isso é difícil hoje porque diferentes modalidades são tokenizadas em ritmos distintos. A linguagem, por exemplo, é tokenizada em partes de palavras, enquanto o áudio é tokenizado como formas de onda brutas ou codecs com taxa de amostragem reduzida. Isso dificulta a modelagem conjunta. Modelos hierárquicos como H-Net oferecem um caminho promissor para combinar esses fluxos em um nível mais alto de abstração, melhorando transferência, raciocínio e compreensão entre modalidades.
- Raciocínio em contextos longos: H-Nets viabilizam esse raciocínio agrupando informações em unidades semanticamente significativas, em níveis mais altos de abstração. Essa compressão facilita compreender entradas extensas e raciocinar sobre elas, especialmente com hierarquias cada vez mais profundas. Arquiteturas hierárquicas permitirão que modelos compreendam seu ambiente a partir de dados brutos e raciocinem nos níveis de abstração adequados ao longo de períodos extensos.
- Treinamento e inferência eficientes: as arquiteturas atuais dedicam a mesma quantidade de computação a cada token, embora alguns sejam menos informativos e mais fáceis de prever. Otimizações de inferência, como a decodificação especulativa, exploram essa propriedade para acelerar a computação de tokens mais previsíveis. Com H-Nets, isso faz parte da própria arquitetura, que processa esses tokens com módulos leves de codificação e decodificação.
Para saber mais, leia nosso preprint completo no arXiv. Também disponibilizamos checkpoints de H-Net 2-stage XL, H-Net 1-stage XL e H-Net 1-stage L no HuggingFace.
Se você se interessa pelo futuro da pesquisa de arquiteturas e pela construção de sistemas e infraestrutura para disponibilizar esses novos modelos em escala, entre em contato!