

現在使われている最も優れたAIアーキテクチャは、すべての入力を同じように扱います。関連する入力を上位の概念へ明示的にまとめず、各入力に同じ計算量を使います。さまざまな分野で成果を出してきましたが、階層を持たないことには根本的な制約があります。
- 高解像度の生データから学習することが難しく、高い性能を得るには意味のあるトークンへの前処理が必要です。
- トークン化など、人が設計した前処理により、入力データの小さな変化で予想外の失敗が起きることがあります。
- 予測しやすく情報量の少ないトークンにも、計算資源を使ってしまいます。
情報そのものは階層的です。言語では文字、単語、文、段落に、画像ではピクセル、エッジ、形、物体に、音声では波形、音素、文、会話のターンにまとめられます。人は生の情報を取り込み、意味のある形にまとめることで、細かな単位から高次の考えまで、さまざまな抽象度で推論し、つながりを見つけます。これは知能の中核です。階層モデルは、現在のアーキテクチャが持つ根本的な制約のいくつかに対処できると考えています。
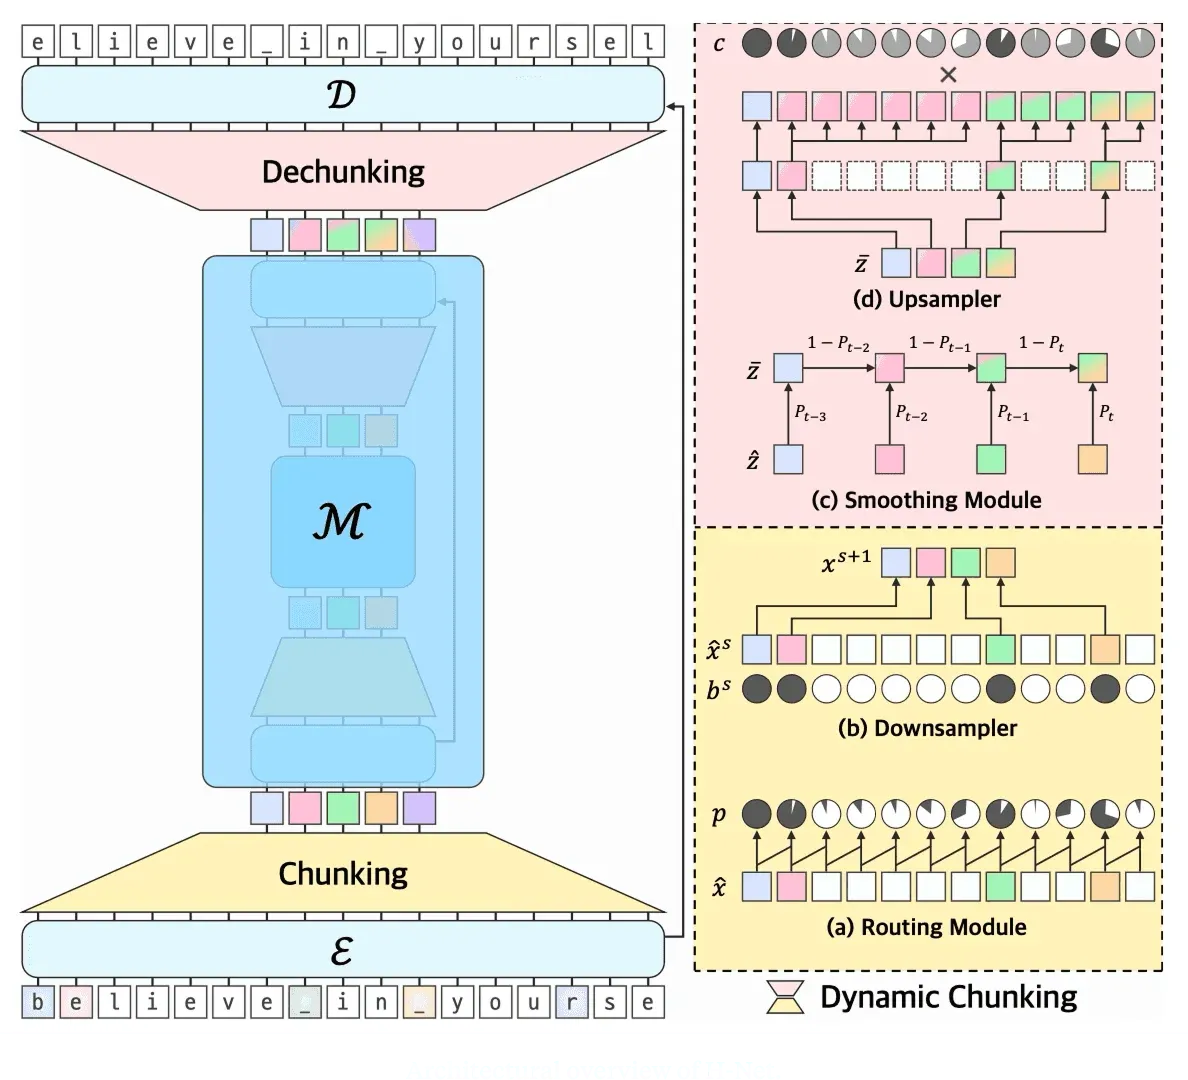
共同研究による最新の成果として、生データから階層を直接モデル化する階層ネットワーク、H-Netを発表します。中心にあるのは、生データを意味のある概念に分割・圧縮する方法を学ぶ、動的なチャンク化の仕組みです。エンコーダー、メインネットワーク、デコーダーの3つで構成します。エンコーダーの中心はルーティングモジュールで、類似度を使い、まとめて圧縮すべき意味のあるチャンクを予測します。メインネットワークには任意の系列変換モデルを使え、上位のチャンクに対して次のトークンを予測します。最後に、デコーダーがチャンクを生データに戻す方法を学び、平滑化モジュールが学習を安定させます。
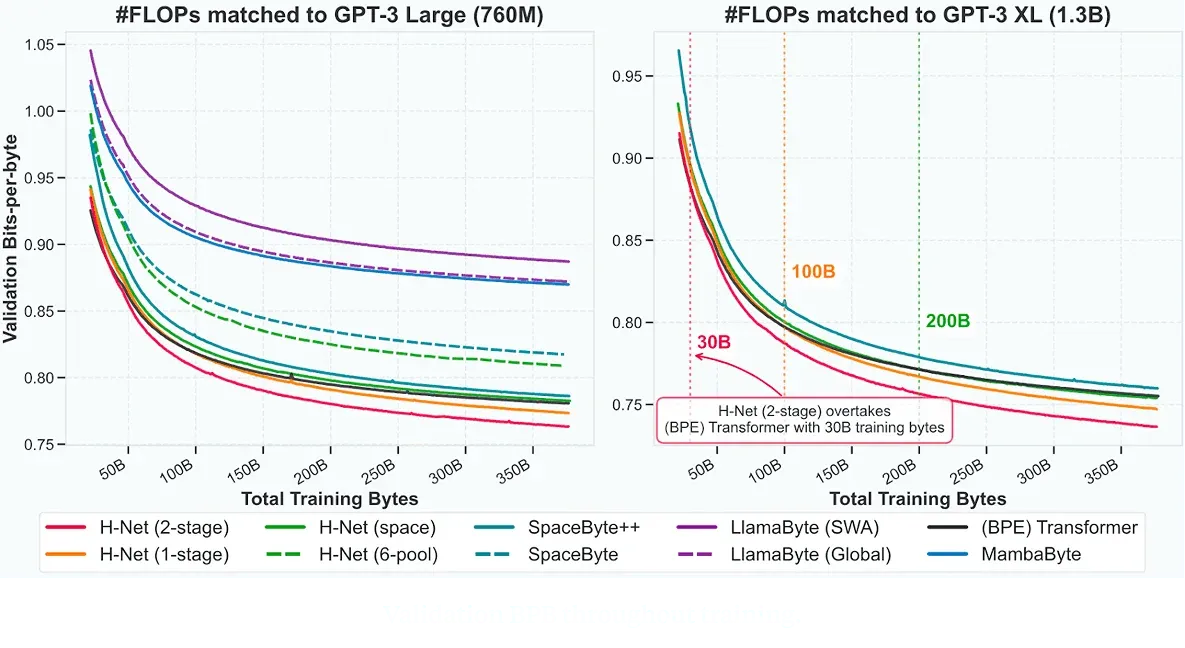
言語モデリングで、H-Netは次の3つの結果を示しました。
- 生のバイトから直接学習しながら、BPEトークン化を使う最先端のTransformerよりも、データ量の増加に対して性能がよく伸びます。中国語、コード、DNAのように自然なトークン境界がない分野では、この傾向がさらに強くなります。
- H-Netを積み重ねて深い階層から学習すると、性能がさらに向上します。
- 大文字・小文字の変更など、入力の小さな変化に対して大幅に安定しています。人の推論に近く、変化に強いモデルをつくる道筋を示しています。
この研究への投資は、マルチモーダルで効率が高く、長い時間にわたって推論し改善する次世代AIモデルをつくる取り組みの一部です。最初の研究上の前進は状態空間モデルでした。長いコンテキストの情報を圧縮できる、状態を持ったモデルを実現しました。H-Netと階層的モデリングは、AIの根本的な課題に取り組む次の段階だと考えています。
- マルチモーダルの理解と生成: 大きな課題は、複数のデータストリームの統合です。言語はサブワード、音声は波形やダウンサンプリングしたコーデックというように、モダリティによってトークン化の頻度が違うため、現在は共同でのモデリングが難しくなっています。H-Netのような階層モデルは、より高い抽象度でそれらを統合し、モダリティをまたぐ転移、推論、理解を改善する有望な方法です。
- 長いコンテキストでの推論: H-Netは、情報を高い抽象度の意味のある単位にまとめます。この圧縮により、特に階層を深くすると、大きな入力全体を理解・推論しやすくなります。階層アーキテクチャは、生データから環境を理解し、適切な抽象度で長期にわたって推論するモデルを可能にします。
- 効率的な学習と推論: 現在のアーキテクチャは、情報量が少なく予測しやすいトークンにも、ほかと同じ計算量を使います。推測デコーディングのような推論時の最適化は、この特性を使って簡単なトークンの計算を速くします。H-Netでは、予測しやすいトークンを軽量なエンコーダーとデコーダーで処理し、その考え方をアーキテクチャ自体に組み込んでいます。
詳しくはarXivのプレプリントをご覧ください。H-Net 2-stage XL、H-Net 1-stage XL、H-Net 1-stage LのチェックポイントもHuggingFaceで公開しました。
アーキテクチャ研究の未来や、これらのモデルを大規模に届けるシステム・インフラの開発に関心がある方は、ぜひご連絡ください。