

Les meilleures architectures d’IA actuelles traitent toutes les entrées de la même manière. Elles consacrent la même quantité de calcul à chacune, sans regrouper explicitement les éléments liés en concepts de niveau supérieur. Ces architectures ont obtenu des résultats impressionnants dans différents domaines, mais cette absence de hiérarchie présente des limites fondamentales.
- Les modèles peinent à apprendre à partir de données brutes haute résolution. Pour être performants, ils exigent un prétraitement des entrées en tokens pertinents.
- Les étapes de prétraitement définies manuellement, comme la tokenisation, peuvent provoquer des échecs inattendus après de petites perturbations des données d’entrée.
- Les modèles gaspillent du calcul sur des tokens faciles à prédire et peu informatifs.
Surtout, l’information est fondamentalement hiérarchique. Dans le langage, les idées se regroupent en caractères, mots, phrases et paragraphes. Dans les images, les pixels forment des contours, des formes et des objets. Dans l’audio, les formes d’onde brutes se regroupent en phonèmes, phrases et tours de parole. Les humains absorbent l’information brute et la regroupent de façon pertinente pour raisonner et établir des liens à différents niveaux d’abstraction, des petites unités aux grandes idées. C’est au cœur de l’intelligence. Nous pensons que les modèles hiérarchiques corrigeront plusieurs limites fondamentales des architectures actuelles.
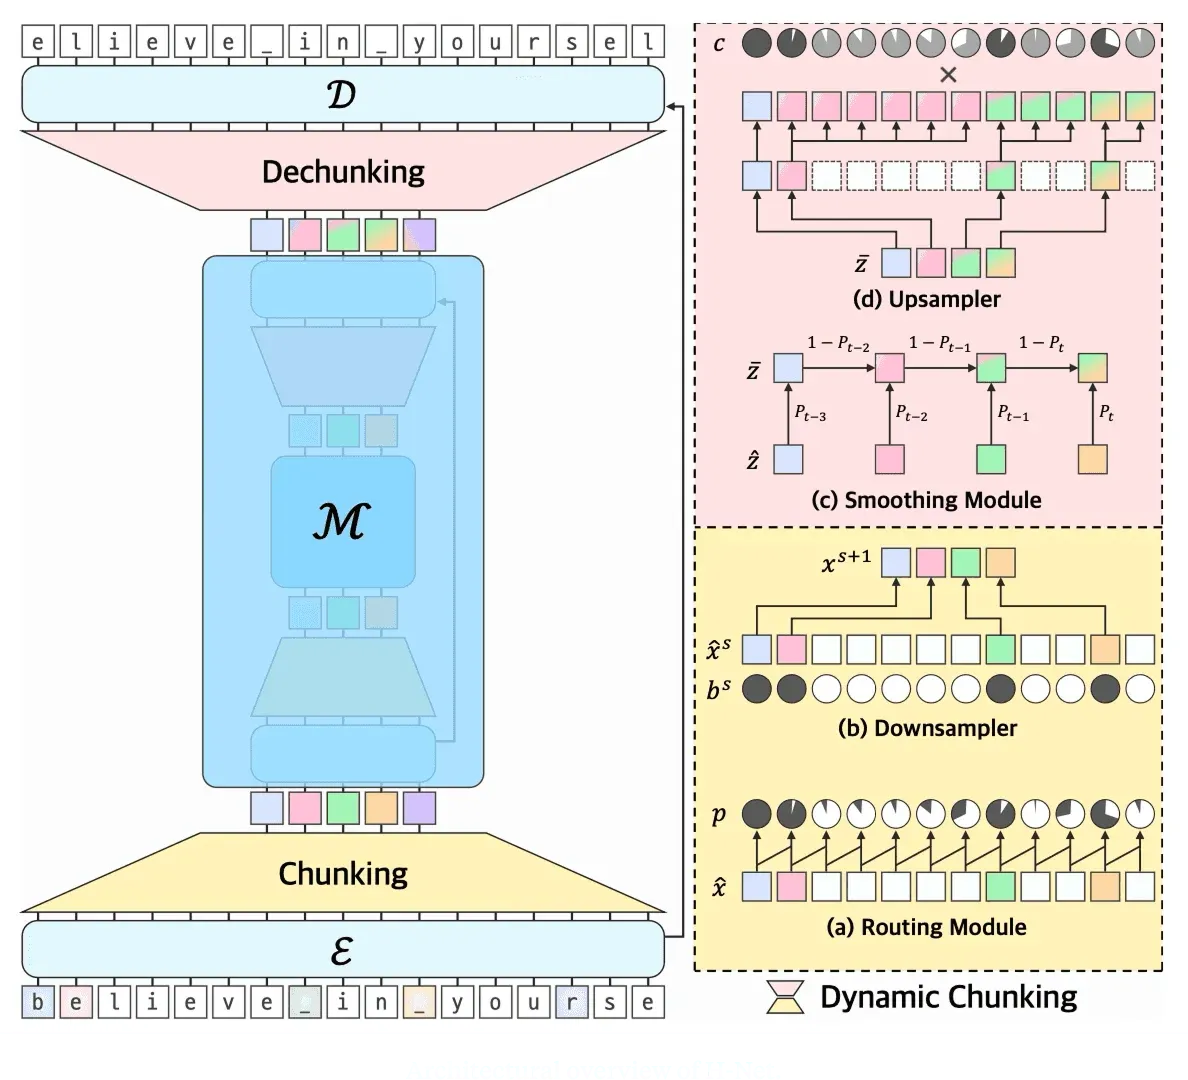
Nous présentons notre dernière collaboration de recherche sur les réseaux hiérarchiques, ou H-Net, une nouvelle architecture qui modélise nativement la hiérarchie à partir de données brutes. Au cœur de H-Net, un mécanisme de découpage dynamique apprend à segmenter et à compresser les données brutes en concepts pertinents pour la modélisation. Il comprend un réseau encodeur, un réseau principal et un réseau décodeur. L’encodeur repose sur un module de routage qui utilise un score de similarité pour prédire quels fragments pertinents doivent être regroupés et compressés pour le réseau principal. Celui-ci peut être n’importe quel modèle séquence à séquence et prédit le token suivant sur ces fragments de niveau supérieur. Enfin, le décodeur apprend à reconvertir les fragments en données brutes, avec un module de lissage pour stabiliser l’apprentissage.
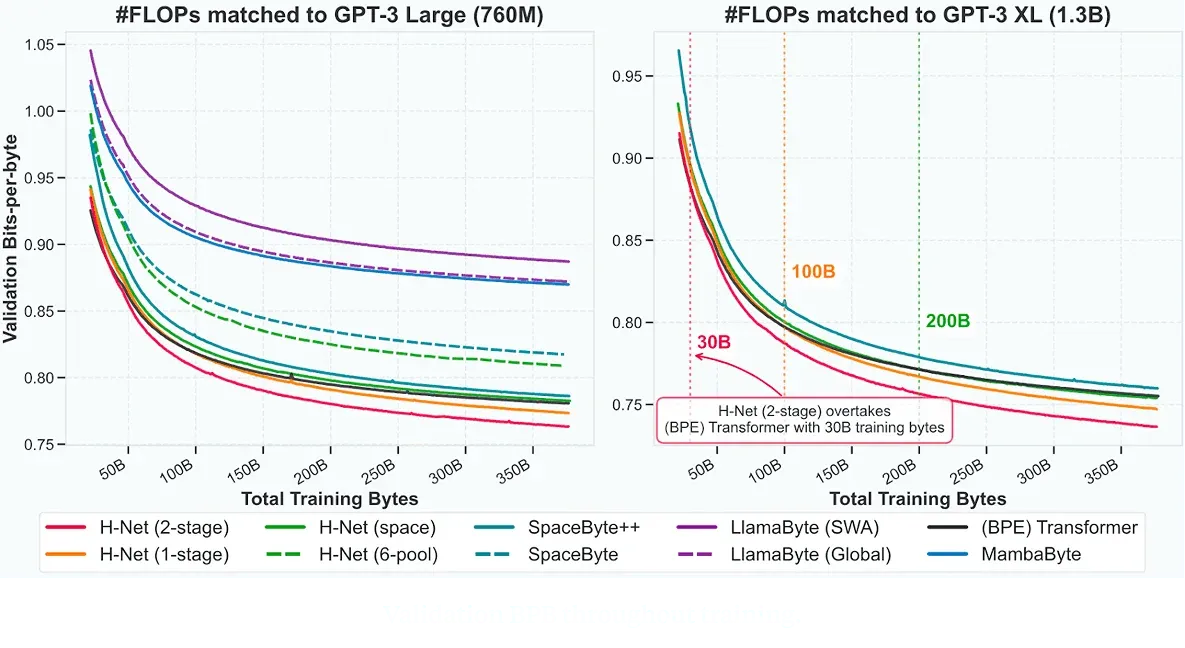
H-Net démontre trois résultats importants en modélisation du langage :
- Les H-Net progressent mieux avec davantage de données que les meilleurs Transformers à tokenisation BPE, tout en apprenant directement à partir des octets bruts. Cette progression est encore plus marquée dans les domaines sans frontières naturelles de tokenisation, comme le chinois, le code et l’ADN.
- Les H-Net peuvent être empilés pour apprendre des hiérarchies plus profondes, ce qui améliore encore les performances.
- Les H-Net résistent nettement mieux aux petites perturbations des entrées, comme les changements de casse. Cela ouvre une voie vers des modèles plus fiables et plus proches du raisonnement humain.
Notre investissement dans cette recherche s’inscrit dans un effort plus large pour construire la prochaine génération de modèles d’IA : multimodaux, très efficaces et capables de raisonner et de progresser sur de longues périodes. Les modèles à espace d’états ont constitué notre première avancée de recherche, avec des modèles à état capables de compresser l’information sur de longs contextes. Nous pensons que H-Net et la modélisation hiérarchique sont la prochaine étape pour répondre à des défis fondamentaux de l’IA :
- Compréhension et génération multimodales : fusionner plusieurs flux de données est un défi majeur. Les différentes modalités sont aujourd’hui tokenisées à des rythmes différents. Par exemple, le langage est découpé en sous-mots, tandis que l’audio est tokenisé sous forme d’ondes brutes ou de codecs sous-échantillonnés. Cela rend leur modélisation conjointe difficile. Les modèles hiérarchiques comme H-Net offrent une voie prometteuse pour fusionner ces flux à un niveau d’abstraction supérieur, avec de meilleurs transfert, raisonnement et compréhension entre modalités.
- Raisonnement sur contexte long : les H-Net le rendent possible en regroupant l’information en unités sémantiquement pertinentes à des niveaux d’abstraction supérieurs. Cette compression aide les modèles à comprendre et à analyser de grandes entrées, particulièrement avec des hiérarchies toujours plus profondes. Les architectures hiérarchiques permettront à des modèles de comprendre leur environnement à partir de données brutes et de raisonner au bon niveau d’abstraction sur de longues périodes.
- Entraînement et inférence efficaces : les architectures actuelles consacrent la même quantité de calcul à chaque token, même si certains sont moins informatifs et plus faciles à prédire. Des optimisations d’inférence comme le décodage spéculatif exploitent cette propriété pour accélérer le calcul sur ces tokens. Les H-Net l’intègrent directement à leur architecture en traitant les tokens faciles à prédire avec des modules encodeur et décodeur légers.
Pour en savoir plus, lisez notre prépublication complète sur arXiv. Nous avons aussi publié les points de contrôle H-Net 2-stage XL, H-Net 1-stage XL et H-Net 1-stage L sur HuggingFace.
Si la recherche sur les architectures et la construction de systèmes et d’infrastructures pour déployer ces nouveaux modèles à grande échelle vous intéressent, contactez-nous !