

Las mejores arquitecturas de IA actuales tratan todas las entradas por igual. Dedican la misma cantidad de cómputo a cada entrada, sin agrupar explícitamente las relacionadas en conceptos de mayor nivel. Aunque han logrado resultados destacados en distintos ámbitos, esta falta de jerarquía impone limitaciones fundamentales.
- A los modelos les cuesta aprender de datos sin procesar de alta resolución. Para rendir bien, necesitan que las entradas se conviertan previamente en tokens con significado.
- Los pasos de preprocesamiento diseñados manualmente, como la tokenización, pueden causar fallos inesperados ante pequeñas alteraciones de los datos.
- Los modelos desperdician cómputo en tokens fáciles de predecir y poco informativos.
La información es, por naturaleza, jerárquica. En el lenguaje, las ideas se agrupan en caracteres, palabras, frases y párrafos; en las imágenes, los píxeles forman bordes, formas y objetos; en el audio, las ondas se agrupan en fonemas, frases y turnos de conversación. Los seres humanos recibimos información sin procesar y la agrupamos de formas que nos permiten razonar y establecer conexiones a distintos niveles de abstracción, desde unidades básicas hasta ideas complejas. Esto es parte esencial de la inteligencia. Creemos que los modelos jerárquicos resolverán varias limitaciones fundamentales de las arquitecturas actuales.
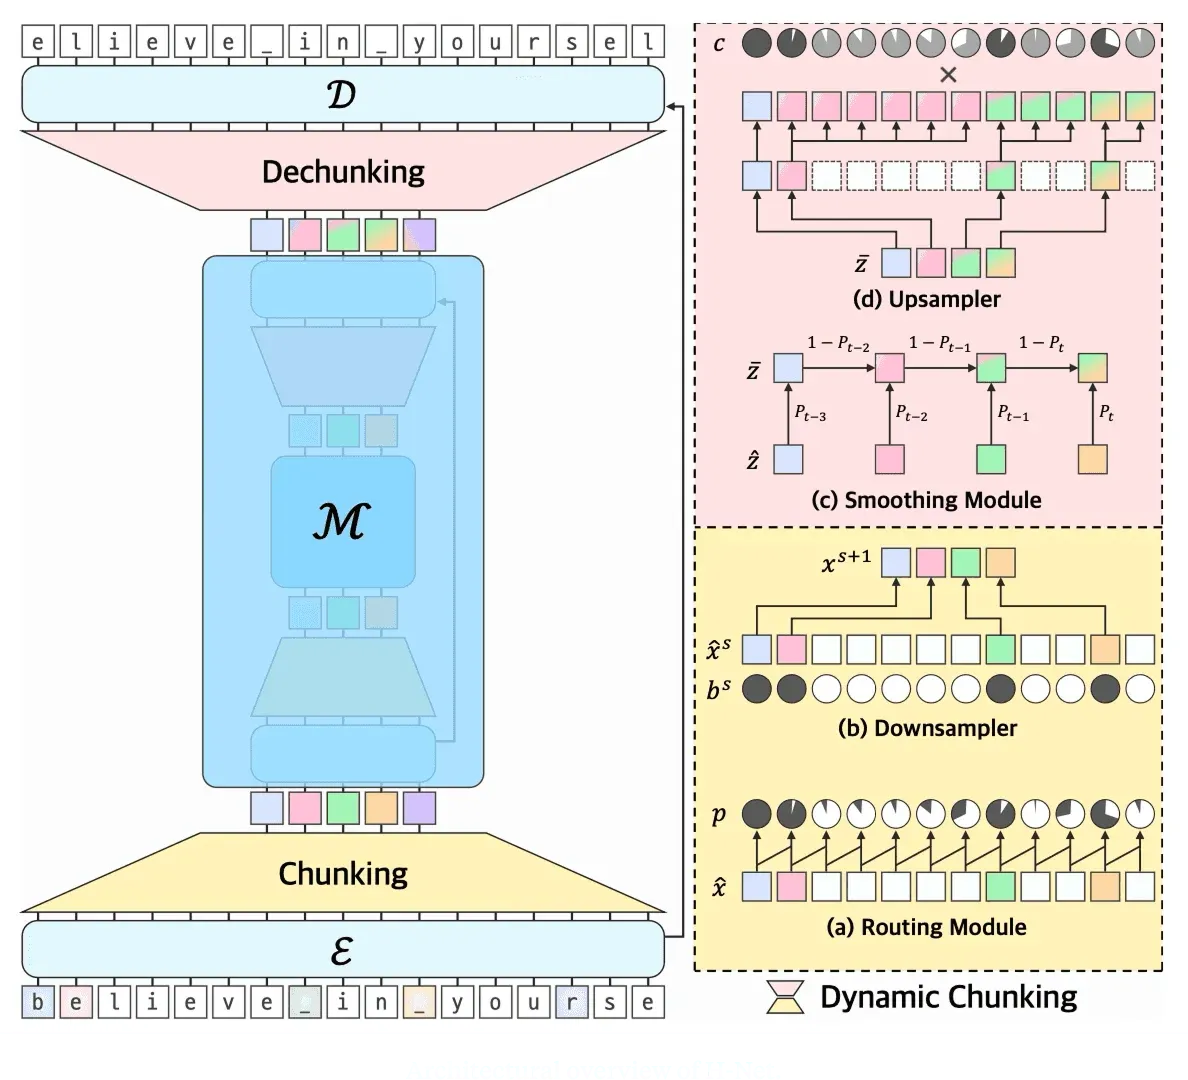
Presentamos nuestra última colaboración de investigación sobre redes jerárquicas, o H-Nets, una arquitectura que modela jerarquías de forma nativa a partir de datos sin procesar. Su núcleo es un mecanismo de agrupación dinámica que aprende a segmentar y comprimir los datos en conceptos significativos. Tiene tres componentes: una red codificadora, la red principal y una red decodificadora. El núcleo de la red codificadora es un módulo de enrutamiento que utiliza una puntuación de similitud para predecir qué fragmentos deben agruparse y comprimirse para la red principal. Esta puede ser cualquier modelo de secuencia a secuencia y predice el siguiente token sobre esos fragmentos de mayor nivel. Por último, la red decodificadora aprende a convertir los fragmentos de nuevo en datos sin procesar, con un módulo de suavizado que estabiliza el aprendizaje.
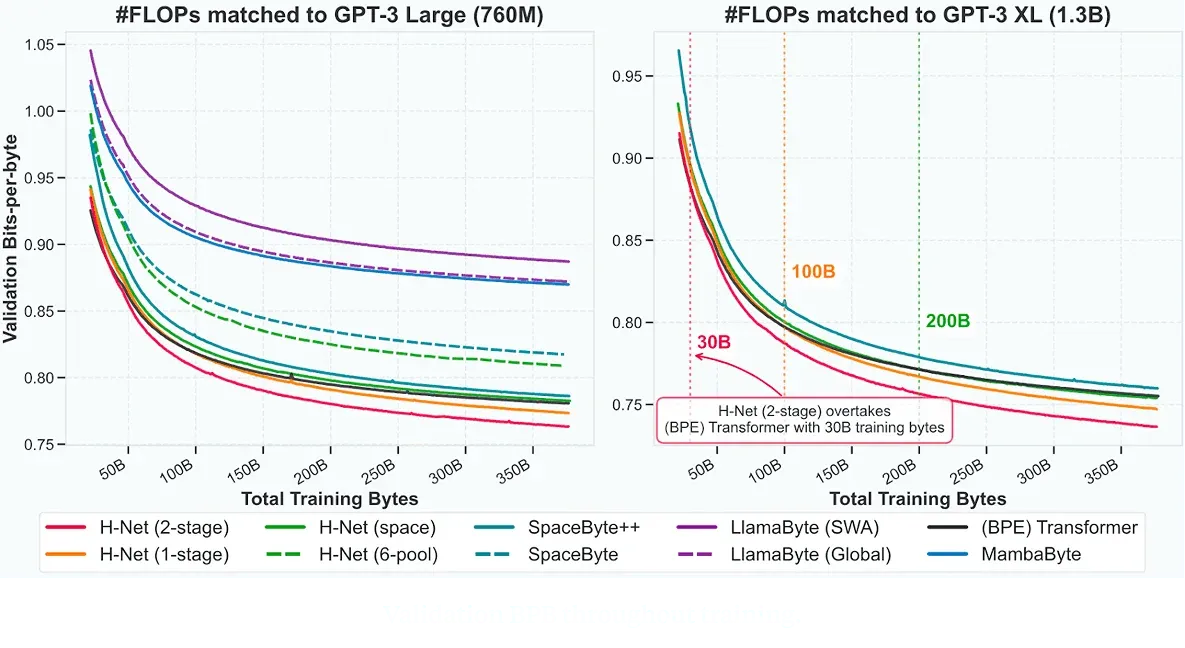
H-Net demuestra tres resultados importantes en modelado del lenguaje:
- Las H-Nets escalan mejor con los datos que los Transformers más avanzados con tokenización BPE, mientras aprenden directamente de bytes sin procesar. Esta ventaja es aún mayor en ámbitos sin límites naturales de tokenización, como chino, código y ADN.
- Las H-Nets pueden apilarse para aprender jerarquías más profundas, lo que mejora aún más el rendimiento.
- Las H-Nets resisten mucho mejor pequeñas alteraciones de las entradas, como cambios entre mayúsculas y minúsculas. Esto abre una vía hacia modelos más resistentes a esas variaciones y más próximos al razonamiento humano.
Nuestra inversión en esta investigación forma parte del trabajo para crear la próxima generación de modelos de IA multimodales y muy eficientes, capaces de razonar y mejorar durante periodos largos. Los modelos de espacio de estados fueron nuestro primer avance: permitieron modelos con estado que comprimen información en contextos extensos. Creemos que las H-Nets y el modelado jerárquico son el siguiente paso para resolver problemas fundamentales de la IA:
- Comprensión y generación multimodal: uno de los grandes retos es combinar varios flujos de datos. Hoy resulta difícil porque cada modalidad se tokeniza a un ritmo distinto. Por ejemplo, el lenguaje se divide en subpalabras y el audio se representa como ondas sin procesar o códecs con menor frecuencia de muestreo. Esto dificulta modelarlos conjuntamente. Los modelos jerárquicos como H-Net ofrecen una vía prometedora para combinar estos flujos en un nivel de abstracción superior y mejorar la transferencia, el razonamiento y la comprensión entre modalidades.
- Razonamiento sobre contextos largos: las H-Nets agrupan la información en unidades semánticas de mayor nivel. Esta compresión facilita comprender y razonar sobre entradas extensas, especialmente con jerarquías cada vez más profundas. Las arquitecturas jerárquicas permitirán modelos que comprendan el entorno a partir de datos sin procesar y razonen al nivel de abstracción adecuado durante periodos largos.
- Entrenamiento e inferencia eficientes: las arquitecturas actuales dedican la misma cantidad de cómputo a cada token, aunque algunos sean menos informativos y más fáciles de predecir. Optimizaciones de inferencia como la decodificación especulativa aprovechan esta propiedad para acelerar el procesamiento de esos tokens. En H-Nets, esto forma parte de la propia arquitectura: los módulos ligeros de codificación y decodificación gestionan los tokens más fáciles de predecir.
Puedes leer el preprint completo en arXiv. También hemos publicado checkpoints de H-Net 2-stage XL, H-Net 1-stage XL y H-Net 1-stage L en HuggingFace.
Si te interesa el futuro de la investigación en arquitecturas y la creación de sistemas e infraestructura para servir estos modelos a escala, ¡escríbenos!