
디지털 시스템과의 상호작용은 여전히 대부분 입력창에 글을 쓰거나 화면을 누르는 방식입니다. 작동은 하지만 번거로움이 없는 것은 아닙니다. 음성은 이 과정을 더 빠르고 자연스럽게 만들고 사람들이 원래 소통하는 방식에 가깝게 해 줍니다. 제대로 구현하면 배우고, 도움을 받고, 언어를 넘나들며, 일을 처리하는 방식이 더 상호작용적으로 바뀔 수 있습니다.
음성으로 상호작용할 때는 생성된 발화 자체가 경험이 됩니다. 전달 방식의 작은 차이로 대화가 유용하거나 자연스럽게 느껴질 수도, 고장 난 것처럼 느껴질 수도 있습니다. 그래서 음성 합성은 기술 스택의 중요한 부분입니다. 글로 된 입력을 음성으로 바꾸면서 상호작용 전체의 느낌을 결정합니다. 하지만 모든 상황에 맞는 하나의 음성 경험은 없습니다.
예를 들어 TTS 모델이 생성한 오디오가 “좋다”고 할 때는 다음 중 하나 또는 여러 가지를 뜻할 수 있습니다.
정확성
모든 단어를 정확하게 말하나요?
오디오 품질
잡음, 배경 소음, 왜곡이 없나요?
맥락에 맞는 정확성
이름, 숫자, 모호한 단어를 맥락에 맞게 해석했나요?
자연스러움
사람처럼 들리나요?
입력 변화에 대한 안정성
대소문자 차이, 약어, 언어 전환처럼 정리되지 않은 입력에서도 품질을 유지하나요?
이런 다차원성 때문에 TTS 평가는 까다롭습니다. 모델이 발전할수록 평가는 잘못된 발음, 뭉개진 오디오, 배경 잡음처럼 명백한 결함에서 더 미묘한 요소로 이동합니다. 이 글에서는 단순해 보이는 다음 질문에 답하려 할 때 반복해서 나타나는 실패 유형을 살펴봅니다.
이 TTS 모델은 좋은 모델일까요?
1. TTS의 일대다 매핑 문제
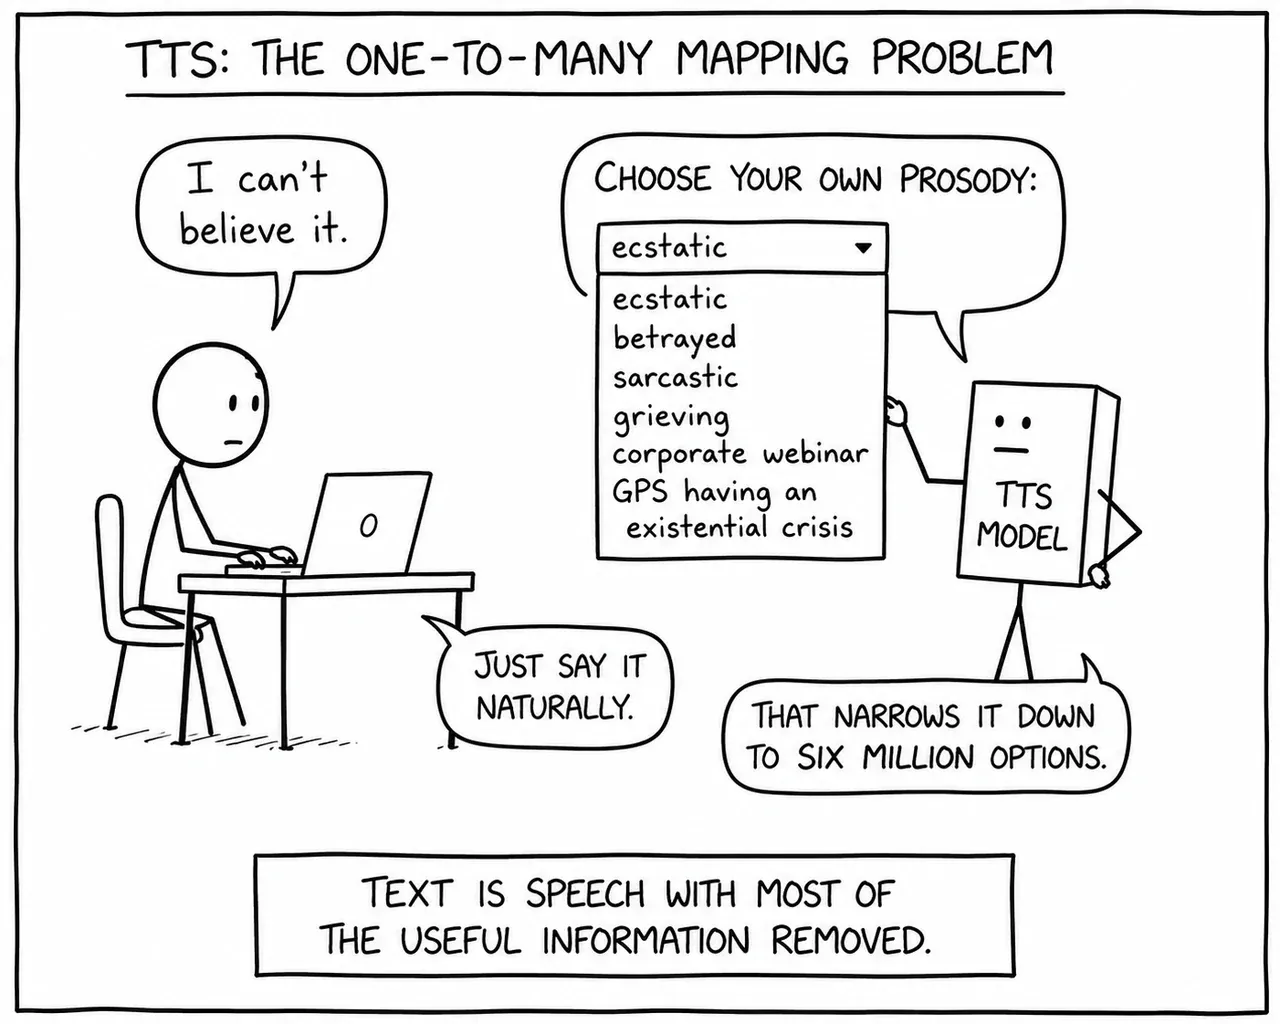
현대 TTS 모델은 텍스트를 오디오로 바꾸는 데서 끝나지 않습니다. 어떻게 말할지도 결정해야 합니다.
음성 합성은 일대다 문제입니다. 화자, 감정, 속도, 강조, 맥락에 따라 같은 원문을 읽는 방법은 무한합니다.
예를 들어 “I can’t believe it”은 서로 다른 네 상황에서 모두 맞는 표현일 수 있습니다.
- 신남. 뜻밖의 좋은 소식을 들었습니다.
- 분노. 답답한 배신에 반응합니다.
- 슬픔. 고통스러운 실망을 받아들이려 합니다.
- 풍자. 감탄하는 척하지만 반대 뜻입니다.
아래 녹음과 전사는 원래 언어를 유지합니다.
신남
분노
슬픔
풍자
이제 맥락을 바꿔 보세요. 화난 상황에서 신난 오디오를 재생하거나 슬픈 상황에서 풍자하는 오디오를 재생하면, 단어는 모두 맞아도 발화는 잘못된 느낌을 줍니다.
다음도 텍스트는 같지만 맥락이 다른 예입니다.
Tomorrow is the big day. There’s no changing it now.
클립 1
클립 2
첫 번째는 큰 행사를 기대하는 듯 신나게 들립니다. 두 번째는 어려운 시험처럼 부담스러운 일을 앞둔 것처럼 더 긴장하거나 두려워하는 느낌입니다.
이처럼 발화에 변이가 있기 때문에 TTS는 단어를 소리로 바꾸는 것보다 어렵습니다. 좋은 시스템은 각 단어의 발음뿐 아니라 어디서 쉬고, 어떤 단어를 강조하고, 얼마나 빠르게 말하고, 어떤 감정을 표현할지도 결정해야 합니다. 텍스트만으로는 이런 결정을 내릴 정보가 부족할 때가 많아 추가 맥락이나 원하는 발화 스타일에 대한 지시가 필요할 수 있습니다.
하지만 이런 미묘한 선택을 다루기 전에 평가는 대개 가장 기본적인 질문에서 시작합니다. 모델이 의도한 단어를 말했는가입니다.
2. 정확한 단어를 말하는 것은 첫 단계입니다
WER는 단어 오류율로, TTS 모델에서 가장 흔히 사용하는 지표 중 하나입니다. TTS로 입력 텍스트의 오디오를 합성하고 ASR인 자동 음성 인식 모델로 전사한 뒤 입력 텍스트와 비교합니다.
예시를 들어보겠습니다.
I can’t stop smiling, everything feels brighter, lighter, warmer, and somehow, after all the waiting, all the hoping, and all the uncertainty, this moment feels even better than I imagined.
클립 1
클립 2
두 오디오는 모든 단어를 정확하게 말하므로 WER가 같습니다. 하지만 대부분의 사람은 자연스럽게 두 번째를 선호할 것입니다.
WER는 방향을 파악하는 데 도움이 됩니다. 하지만 이해도가 대체로 해결된 뒤에는 차이가 잡음 수준으로 작아집니다.
- WER는 포화됩니다. 위 예처럼 두 모델의 체감 품질은 뚜렷하게 달라도 WER 차이는 무시할 만큼 작을 수 있습니다. 특히 깨끗한 낭독형 테스트 세트에서 그렇습니다.
- ASR 품질에 종속됩니다. WER의 신뢰도는 계산에 사용하는 음성 인식기의 신뢰도를 넘지 못합니다. ASR이 특정 억양, 언어, 잡음 있는 클립, 표현적인 발화, 전문 용어에 약하면 TTS의 실제 합성 오류가 아닌 ASR 오류 때문에 감점할 수 있습니다.
- 반대로 좋은 ASR은 불분명한 발화를 보정하거나 추론하여 결함 있는 샘플이 사람에게 들리는 것보다 좋아 보이게 만들 수 있습니다.
WER는 특히 일반 단어가 아닌 영숫자가 포함된 많은 용도에서 필요한 지표입니다. 하지만 기업용 음성 에이전트에서는 WER만으로 충분한 경우가 드뭅니다.
3. 맥락에 맞는 정확성도 과제입니다
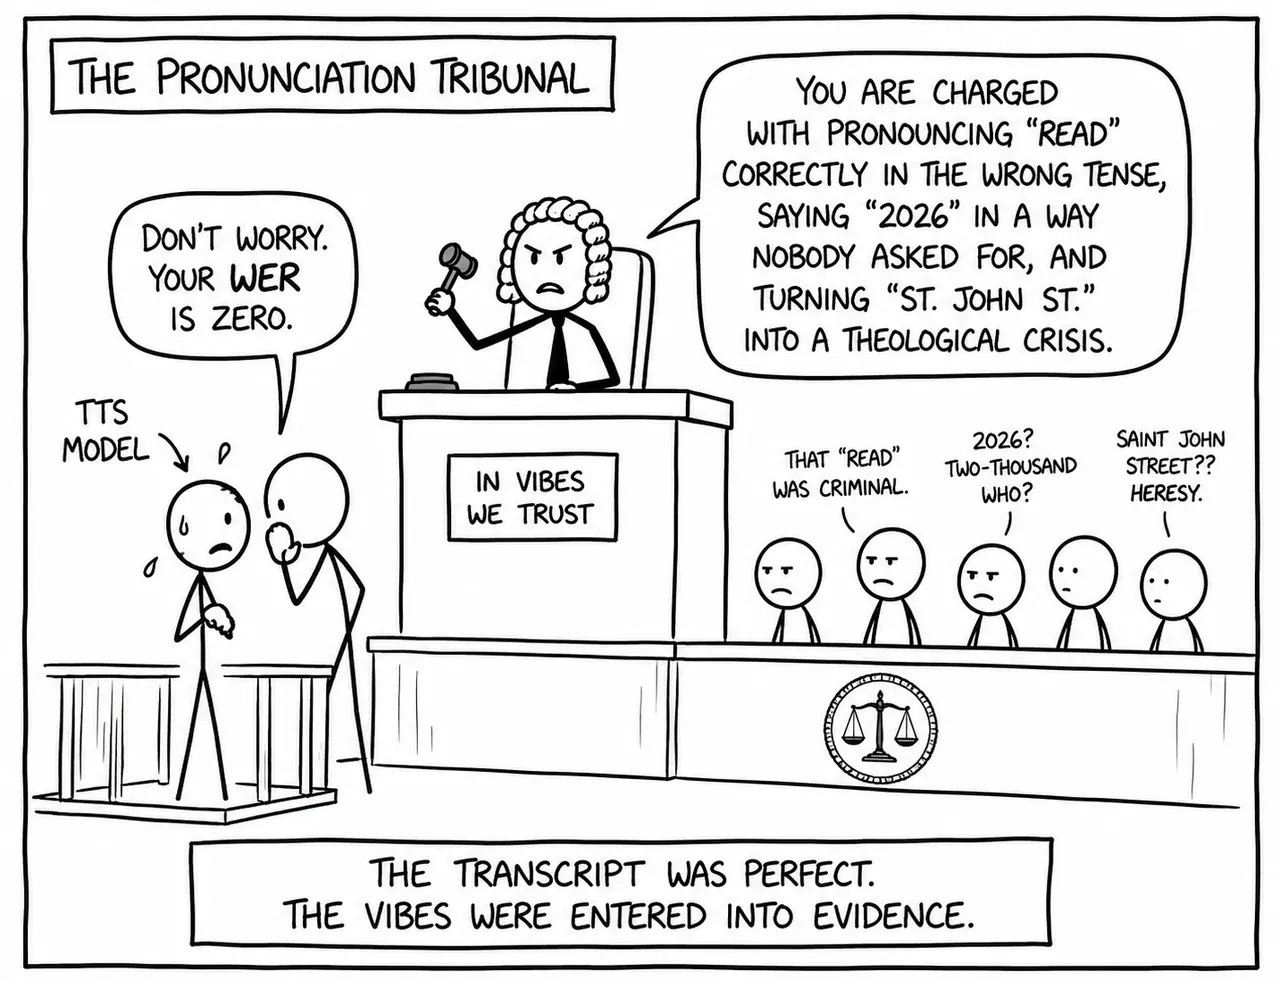
많은 오류는 올바름을 정의하기 위해서도 의미를 구분해야 합니다.
- “read”의 현재형과 과거형
- 금속과 동사를 뜻하는 “lead”
- 국적과 동사를 뜻하는 “Polish”
- 물고기와 악기를 뜻하는 “bass”
- 동사와 형용사인 “live”
- “2026” 같은 연도를 twenty-twenty-six 또는 two thousand twenty-six로 읽는 방식
I had to wind the old clock before the wind picked up outside.
고유명사는 더 어렵습니다. 사람, 장소, 제품, 회사, 약물, 가상의 용어는 표준 발음이 없는 경우가 많고 사람끼리도 의견이 다릅니다. 언어가 다르면 특히 그렇습니다.
좋은 평가는 유창하게 들리더라도 모델이 잘못된 해석을 골랐는지 감지해야 합니다.
4. 텍스트 정규화는 별도의 평가 문제입니다
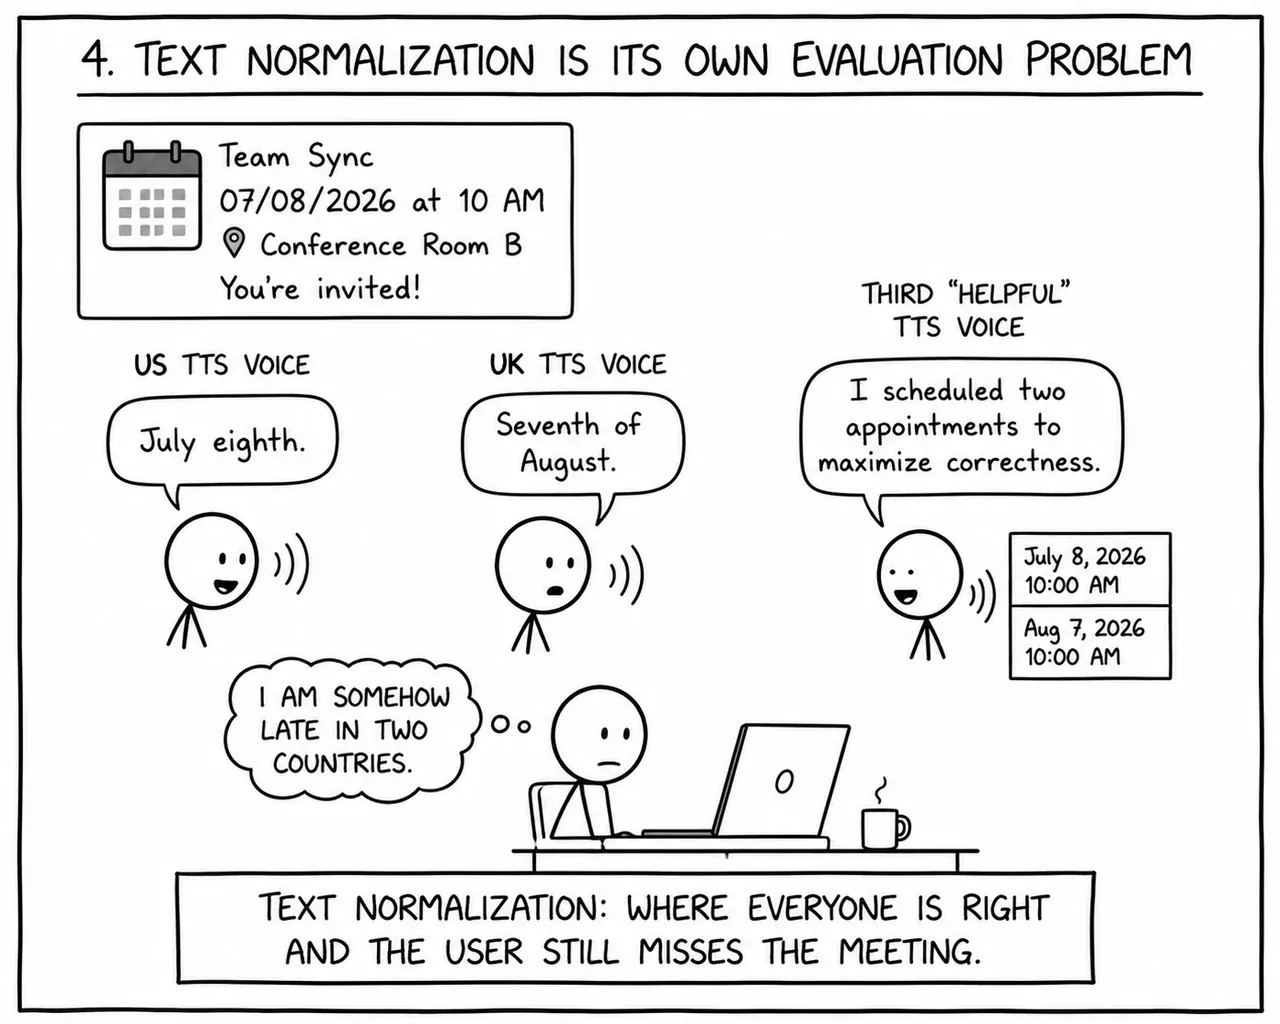
맥락이 필요한 곳은 발음만이 아닙니다. 모델은 발음하기 전에 글로 된 텍스트를 어떤 말로 풀어 읽을지 결정해야 할 때가 많습니다.
모호한 입력의 예입니다.
- “$1.05”를 one oh five 또는 one dollar and five cents로 읽기
- “3/4”를 three quarters 또는 three-fourths로 읽기
- “IV”를 four 또는 I-V로 읽기
- “St.”를 street 또는 saint로 읽기
- “No. 5”를 number five 또는 “no. five”로 읽기
지역별 날짜는 흥미로운 예입니다. 다음 텍스트에서 미국 영어는 7월 8일을, 영국 영어는 8월 7일을 기대합니다!
I’d like to schedule an appointment for 07/08/2026 at 10 AM. Could you confirm if that time is available?
미국 지역 설정
영국 지역 설정
맥락에 따라 여러 정규화가 모두 맞을 수 있습니다. 참조 전사에는 제품이 원하는 것과 다른 선택이 반영되어 있는 경우도 많습니다. 정규화 선호와 모델 오류를 분리하지 않으면 평가 점수의 의미가 흐려집니다.
5. 자동 품질 점수는 유용하지만 불완전합니다
원문 정확도는 기본 조건입니다. 모델이 올바른 단어를 말한 뒤 남는 품질 차이는 보통 운율, 표현력, 스타일, 안정성에 있습니다. 발화를 자연스럽고 적절하며 쓸 만하게 만드는 요소입니다.
자동 품질 예측기는 이를 대규모로 측정하려 합니다. DNSMOS, NISQA, UTMOS 같은 도구는 생성된 클립을 듣고 품질 점수를 매겨 수천 개 샘플의 성능 저하를 탐지하는 데 유용합니다.
하지만 이 점수는 여전히 대리 지표입니다. 실제로 “이 클립이 이 상황에 적합했는가?”를 묻는 것이 아니라 “이 클립이 내가 평가하도록 학습한 오디오와 비슷한가?”를 묻습니다.
이 차이는 중요합니다. 실패가 눈에 잘 띄지 않을 때가 많기 때문입니다.
- 도메인 불일치. 학습한 종류의 발화에서는 잘 작동해도 다른 환경의 오디오에서는 예측기를 신뢰하기 어려울 수 있습니다.
- 예를 들어 UTMOSv2는 주로 영어인 고품질 합성 음성의 자연스러움 MOS를 예측하도록 개발되었습니다. 코덱, 잡음 있는 발화, 다국어, 노래, 대화 오디오를 위한 범용 지표가 아닙니다.
- 보정 기준의 변화. 이전 모델을 구별하던 점수도 새 모델의 실패가 더 미묘해지면 의미를 잃을 수 있습니다. 자동 품질 예측기도 유효성을 유지하려면 재학습해야 하는 경우가 많습니다.
- 사각지대. 잡음이나 왜곡은 감지하면서 어색한 감정, 부자연스러운 페이싱, 스트리밍 결함, 점진적인 음성 변화는 놓칠 수 있습니다.
- 예를 들어 자동 MOS 예측기 연구에서는 같은 발화를 생성하면서 잘못된 일본어 고저 악센트의 양을 늘렸습니다. 사람의 점수는 1.84 MOS점 떨어졌지만 모든 자동 모델의 변화는 0.1 미만이었습니다. 일부 예측기는 심하게 손상된 발화에 오히려 약간 높은 점수를 줬습니다.
| 없음, 기준값 | 낮음, 10-20% 교체 | 높음, 80-90% 교체 | |
|---|---|---|---|
| 사람의 MOS | 4.00 ± 0.07 | 3.19 ± 0.09 | 2.16 ± 0.09 |
| UTMOS | 3.44 ± 0.12 | 3.43 ± 0.11 | 3.47 ± 0.11 |
| UTMOSv2 | 3.56 ± 0.08 | 3.62 ± 0.06 | 3.61 ± 0.08 |
| NISQA | 3.81 ± 0.16 | 3.74 ± 0.15 | 3.84 ± 0.16 |
| DNSMOS | 3.82 ± 0.05 | 3.81 ± 0.06 | 3.83 ± 0.05 |
즉 이런 점수는 명백한 성능 저하를 대규모로 찾는 데 유용하지만 무엇이 좋은 클립을 만드는지 실제로 이해하는 과정을 대신하지는 못합니다.
이쯤 되면 사람의 평가로 넘어가야 한다고 생각하기 쉽지만, 여기에도 다른 함정이 있습니다.
6. 사람의 평가가 최선의 기준일까요?
사람이 직접 듣는 테스트는 여전히 최선의 기준이지만 점수는 안정적인 측정값이 아닙니다. 청자의 배경, 원어민 여부, 지시문 표현, 평가 세트에 포함된 기준 샘플, 헤드폰과 스피커 같은 재생 환경, 음량 정규화, 세션 길이와 피로 등에 따라 판단이 달라집니다.
흔한 형식은 MOS인 평균 의견 점수와 선호도 평가입니다. MOS 테스트에서는 각 클립의 품질이나 자연스러움을 독립적으로 보통 1~5점으로 평가합니다. 선호도 테스트에서는 두 개 이상의 클립을 비교하여 선호하는 것을 고릅니다. MOS는 절대 점수처럼 보이고 선호도는 직접 비교에 가깝지만 둘 다 지시문, 청자 집단, 제시 방식의 영향을 받습니다. 어느 방식을 사용하든 다음 문제가 있습니다.
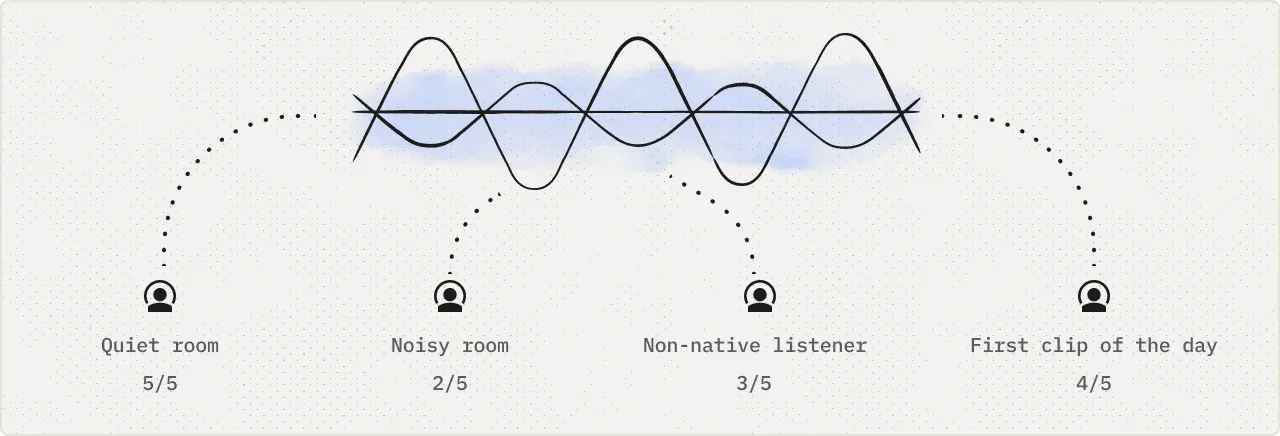
6.1 청자의 반응은 맥락에 따라 달라집니다
청자는 아무 맥락 없이 듣지 않습니다. 같은 문장을 듣더라도 주변 상황을 다르게 상상할 수 있습니다. “That’s great”는 어떤 맥락에서는 진심으로, 다른 맥락에서는 풍자로, 또 다른 맥락에서는 무미건조하거나 혼란스럽게 들릴 수 있습니다.
따라서 청자가 목소리의 역할을 어떻게 생각하는지에 따라 같은 오디오의 점수가 달라집니다. 과제에 의도한 상황이 명확하지 않으면 공통 목표 대신 각자의 기대를 기준으로 판단하게 됩니다.
6.2 비교는 제시 방식의 세부 사항에 민감합니다
사소하고 무관해 보이는 선택이 결과를 좌우할 수 있습니다.
- 음량과 피크 정규화 전략. 모델이 더 좋지 않아도 더 큰 소리의 샘플이 명확하고 자신감 있으며 고품질로 느껴질 수 있습니다.
- 샘플레이트, 코덱, 리샘플링. 압축이나 리샘플링 결함 때문에 모델 합성 품질과 무관하게 한 시스템이 더 나쁘게 들릴 수 있습니다.
- 프롬프트 텍스트, UI 맥락, 주변 샘플. 텍스트와 제시 방식이 기대를 만들어 청자가 주목하거나 선호하는 것을 바꿀 수 있습니다.
- 무음, 호흡, 시작 지연의 잘라내기. 쉼, 호흡, 시작 지연을 조금만 편집해도 샘플이 자연스럽거나 어색하거나 반응이 빠르게 느껴지는 정도가 달라집니다.
이를 고정하지 않으면 모델 대신 오디오 파이프라인을 평가할 수 있습니다.
6.3 모델이 안정적이어도 평가 기준은 변합니다
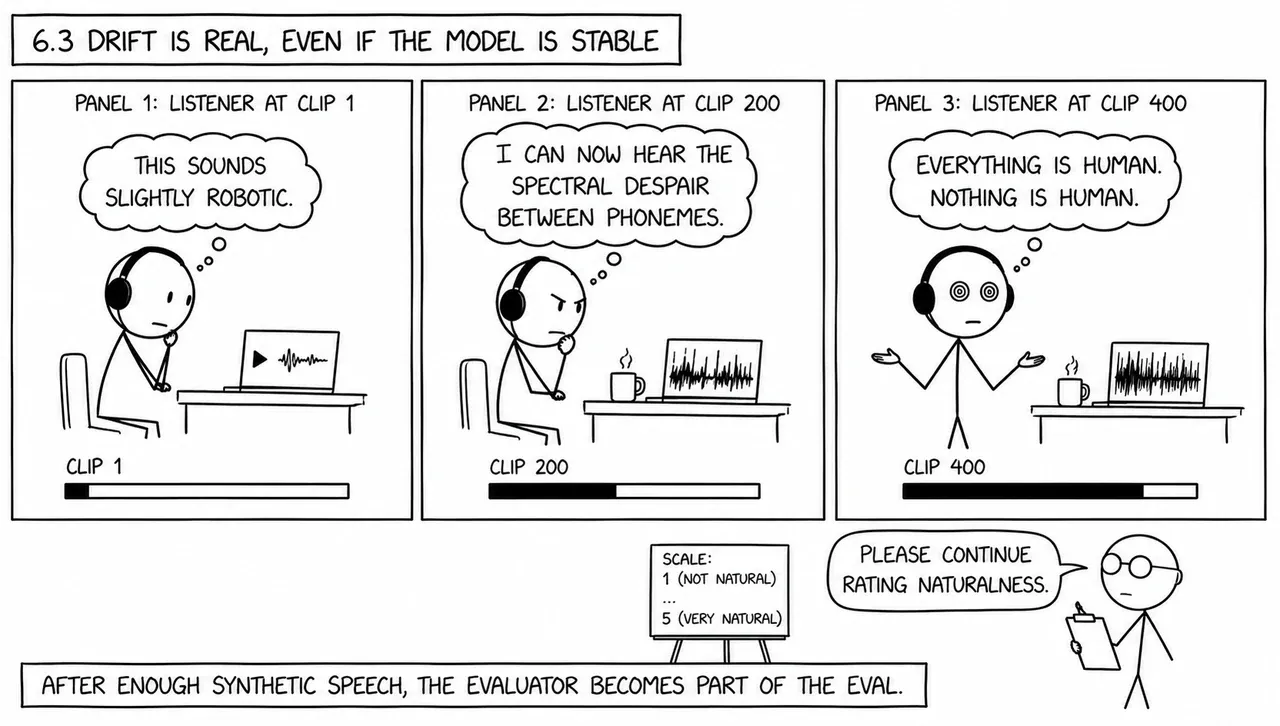
시간이 지나면 청자도 변합니다.
- 적응. 많은 합성 클립을 들으면 결함에 더 민감하거나 더 관대해지는 등 주목하는 기준을 다시 조정합니다.
- 피로. 오디오 평가는 지치는 작업이며 세션이 길어지면 판단 품질이 떨어집니다.
- 환경 차이. 헤드폰에서 두드러지는 소리가 휴대전화 스피커에서는 사라질 수 있고 그 반대도 가능합니다.
사람의 MOS를 변하지 않는 정답으로 취급하면 나중에 문제가 됩니다.
6.4 선호와 취향은 다릅니다
반복해서 마주치는 문제는 사람들이 같은 것을 원하지 않는다는 점입니다. 주의 깊게 듣는 사람끼리도 다음 선호가 다릅니다.
- 목소리 정체성과 음색. 밝고 선명한 목소리를 좋아하는 사람도, 따뜻하고 낮거나 질감이 풍부한 목소리를 좋아하는 사람도 있습니다.
- 말하는 속도. 빠른 속도가 누군가에게는 효율적으로, 다른 사람에게는 성급하거나 스트레스를 주는 것으로 느껴집니다.
- 억양과 방언. 한 청중에게 익숙하고 자연스러운 목소리가 다른 청중에게는 산만하거나 맞지 않을 수 있습니다.
- 감정의 강도. 표현적인 전달을 좋아하는 사람도 있고 같은 표현을 과장되거나 피곤하게 느끼는 사람도 있습니다.
- 나이와 페르소나의 단서. 같은 목소리에서 서로 다른 성격을 추론하거나 제품별로 다른 페르소나를 선호할 수 있습니다.
Please call Stella. Ask her to bring these things with her from the store: Six spoons of fresh snow peas, five thick slabs of blue cheese, and maybe a snack for her brother Bob. We also need a small plastic snake and a big toy frog for the kids. She can scoop these things into three red bags, and we will go meet her Wednesday at the train station.
미국 남부 억양
뉴욕 억양
George Mason University의 Speech Accent Archive에 수록된 사람의 녹음
따라서 누구에게 묻느냐에 따라 두 시스템이 각각 더 좋을 수 있습니다. 평가 질문은 “누구에게 더 좋은가?”가 됩니다.
7. 긴 발화와 스트리밍은 다른 실패를 드러냅니다
대부분의 TTS 평가는 생성하고 듣고 점수를 매기기 쉬운 짧은 클립을 사용합니다. 하지만 실제 제품은 기사 읽기, 장 단위 내레이션, 지원 통화, 주고받는 대화처럼 목소리가 계속 이어져야 할 때가 많습니다. 여기서 새로운 문제가 나타납니다.
긴 오디오는 문장마다 좋게 들리는 것만으로 부족합니다. 시간이 지나도 일관성을 유지해야 합니다. 흔한 변화는 다음과 같습니다.
- 화자 정체성 변화
- 억양 변화
- 말하는 속도 변화
- 문단 간 감정 일관성 문제
스트리밍은 또 다른 계층을 더합니다. 전체 응답을 생성하기 전에 오디오 재생을 시작하는 방식입니다. 문단이나 답변 전체를 기다리는 대신 작은 단위로 음성을 생성하여 즉시 청자에게 보냅니다. 문장의 나머지를 만드는 중에도 빠르게 발화를 시작하므로 음성 비서의 반응성이 높아집니다.
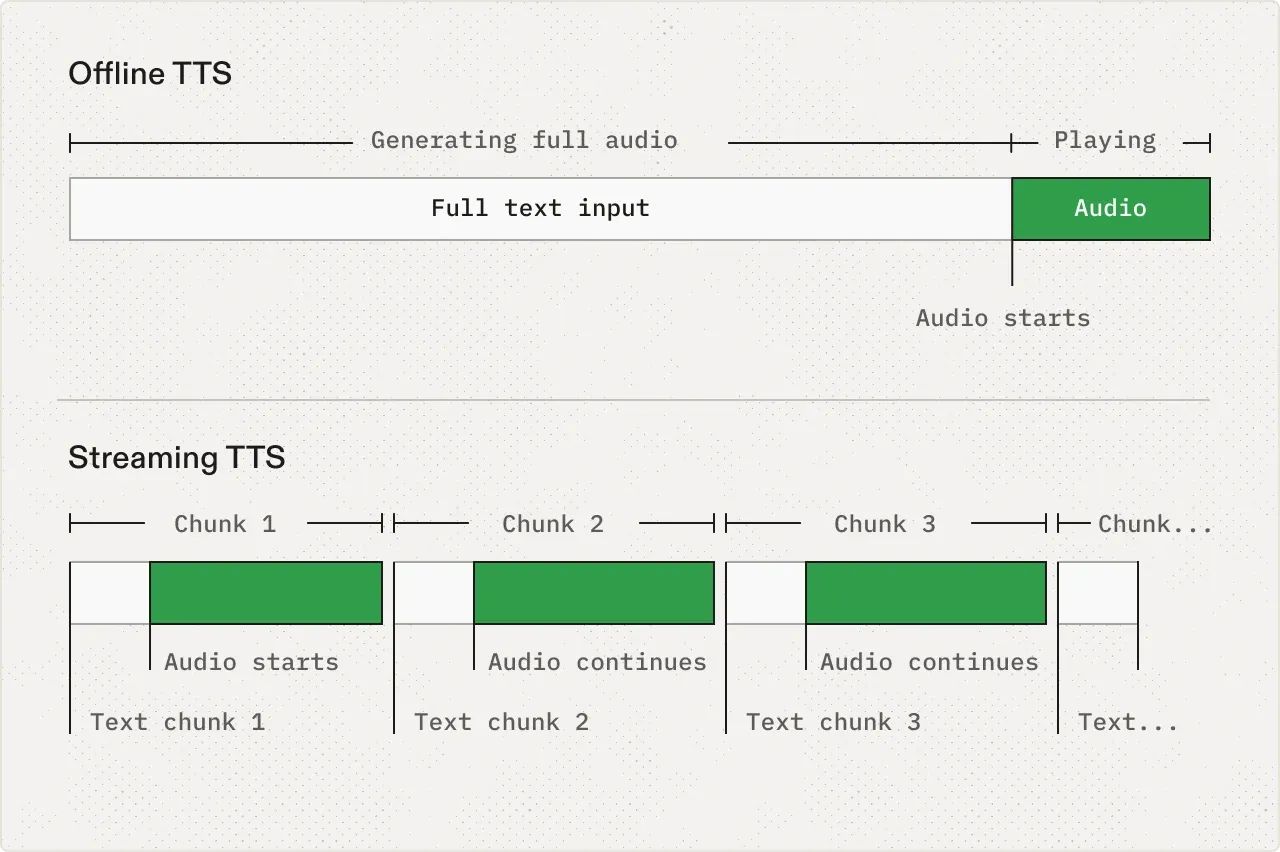
속도는 유용하지만 절충이 따릅니다. 다음 내용을 정확히 알기 전에 말하기 시작해야 하므로 스트리밍에서는 오프라인 클립에 없는 실패가 생길 수 있습니다.
- 청크 사이의 어색한 연결. 각 부분은 괜찮아도 이어지는 지점이 짜깁기처럼 들립니다.
- 음절이나 단어 반복. 연결 지점에서 “look-look-looking”이나 “is is scheduled”처럼 반복할 수 있습니다.
- 잘린 소리. 단어의 시작이나 끝이 너무 급하게 잘려 “stop”이 “top”처럼 들릴 수 있습니다.
- 초기에 잘못 고른 표현. 잘못된 속도, 감정, 강조로 시작한 뒤 회복하기 어려울 수 있습니다.
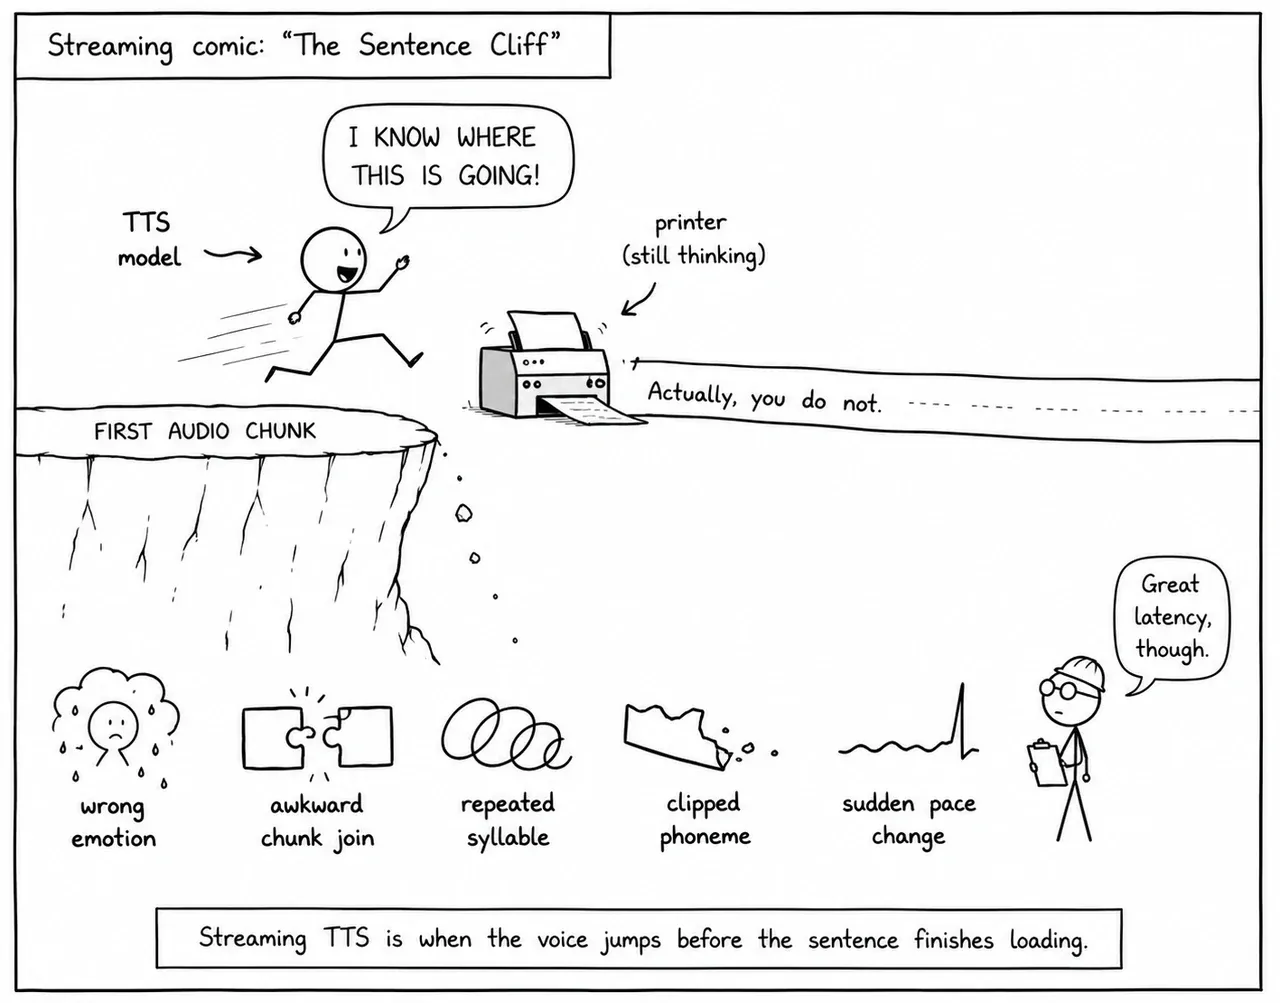
짧은 클립은 실시간 TTS에서만 나타나는 실패를 숨길 수 있습니다. 긴 발화 테스트는 시간에 따라 목소리가 일관적인지 확인합니다. 스트리밍 테스트는 전체 응답을 모른 채 빠르게 시작해야 할 때도 자연스럽게 들리는지 확인합니다.
이런 실패는 무작위가 아닙니다. 평가 환경이 실제 제품 사용 방식과 달라질 때 주로 나타납니다. 그래서 다음 계층은 도메인입니다. 일반 낭독에서는 좋은 목소리도 전문적인 관례, 수식, 이름, 페이싱 기대가 담긴 텍스트에서는 무너질 수 있습니다.
8. 전문 분야 텍스트는 기존 가정을 깨뜨립니다
법률, 의료, 게임, 수학, 시, 종교 문서, 고객 지원 등 각 분야는 다음 기대가 다릅니다.
- 서식과 정규화
- 드문 단어의 처리
- 리듬에 대한 기대
- 정확성 제약과 스타일 제약
한 분야에서 최첨단 수준인 모델도 다른 분야에서는 결함이 뚜렷하게 들릴 수 있습니다.
The process of photosynthesis relies on a specific chemical reaction. Plants take in carbon dioxide and water to produce glucose and oxygen: 6CO₂ + 6H₂O → C₆H₁₂O₆ + 6O₂. This balanced equation shows how life sustains itself on Earth.
H₂O 발음의 리듬이 깨지고 ”→“를 읽지 않는 점에 주목하세요. 화학 전공자는 이를 “yields”나 “produces”라고 읽을 것입니다.
도메인은 변화의 한 축입니다. 언어와 지역은 또 다른 축이며 평가 체계를 전혀 다른 방식으로 무너뜨리는 경우가 많습니다.
9. 다국어에는 고유한 과제가 있습니다
다국어 TTS는 영어 문제를 N번 반복하는 것이 아닙니다. 언어마다 평가 체계의 다른 부분이 깨집니다. 모르는 언어를 채점할 수 없으므로 원어민 청자가 필수입니다. 구체적인 문제는 다음과 같습니다.
자동 지표가 조용히 작동을 멈춥니다. WER는 계산에 사용하는 ASR의 편향을 물려받습니다. 인식기가 영어 외 억양, 문자 체계, 저자원 언어에 약하면 TTS는 자기 오류 대신 인식기의 오류 때문에 감점할 수 있습니다. 학습된 품질 예측기도 마찬가지입니다. UTMOS 같은 도구는 주로 영어로 학습되어 분포를 벗어나면 거의 아무것도 측정하지 못할 수 있습니다. 영어 평가를 확장할 때 의지하던 자동화 계층이 더 많은 처리량이 필요한 곳에서 오히려 가장 불안정해집니다.
올바른 단어는 언어별로 다르며 실제로 모호할 때가 많습니다. 프랑스어의 리에종에서는 다음 단어가 모음으로 시작하면 보통 묵음인 마지막 자음을 발음합니다. les amis는 “lay-amis”가 아닌 “lez-ami”처럼 들립니다. 잘못 적용해도 단어는 알아들을 수 있지만 비원어민처럼 들립니다.
Liaison
일본어는 더 어렵습니다. 특히 이름에서는 한자만으로 발음이 정해지지 않는 경우가 많습니다. 上手에는 jōzu, uwate, kamite라는 여러 유효한 읽기가 있어 맥락이 없으면 그럴듯하지만 틀린 발음을 고를 수 있습니다.
jōzu
田中さんは日本語が上手です。
Tanaka-san wa nihongo ga jōzu desu.
다나카 씨는 일본어를 잘합니다.
uwate
交渉では相手の方が一枚上手だった。
Kōshō de wa aite no hō ga ichimai uwate datta.
협상에서는 상대가 한 수 위였습니다.
kamite
役者は上手から登場した。
Yakusha wa kamite kara tōjō shita.
배우는 무대 오른쪽에서 등장했습니다.
같은 종류의 함정은 여러 언어에 다른 형태로 나타납니다. 중국어에서는 성조가 틀리면 단어가 달라지고, 아랍어에는 표기하지 않는 단모음이 있으며, 힌디어에는 슈와 탈락이 있습니다. 이를 정확히 채점하려면 원어민 지식이 필요합니다.
언어는 맞지만 억양이 틀릴 수 있습니다. 캐나다 프랑스어 단어를 파리 억양으로 말하거나 유럽 스페인어 목소리가 클립 도중 멕시코 발음으로 바뀌는 등, 유창하고 완전히 이해할 수 있어도 지역이 틀릴 수 있습니다.
Je remarque que votre facture de cette fin de semaine comprend des frais d’utilisation de données pour votre cellulaire.
캐나다 프랑스어, 예상한 결과
프랑스 프랑스어, 예상하지 않은 결과
이런 예시는 이해도와 표현력 검사를 모두 통과해도 여전히 틀립니다. 언어를 넘나드는 목소리에는 반대 방향의 실패도 있습니다. 힌디어 화자가 영어 단어를 발음할 때 인도 억양을 유지하는 것이 맞으며, 이를 일반 미국 영어로 고치는 것은 개선이 아니라 오류입니다. 단일 언어 평가에서는 보이지 않는 정확성의 축입니다.
숫자 하나가 차이를 숨깁니다. 언어마다 한 언어는 운율, 다른 언어는 발음, 또 다른 언어는 지역별 정규화처럼 다른 차원에서 실패가 집중됩니다. 따라서 다국어 종합 점수 하나로 평균을 내면 실제 개선에 필요한 신호가 사라집니다. 다국어에서 더 좋다는 말은 지역별, 차원별로 볼 때만 의미가 있습니다.
결국 다국어 평가는 하나의 전역 점수 대신 원어민이 평가 과정에 참여하는 품질 관점을 요구합니다. 지역, 실패 유형, 실제로 중요한 제품 기대에 따라 구분해야 합니다.
마무리. TTS는 하나의 차원으로 평가할 수 없습니다
좋다는 말이 하나의 뜻이 아니기 때문에 TTS 평가는 어렵습니다. 여러 측면에 따라 달라집니다. 오디오북, 내비게이션, 고객 지원 에이전트의 목소리를 정확히 같은 목표로 최적화해서는 안 됩니다.
Cartesia는 대화형 발화에 특히 집중합니다. 빠르게 응답하면서도 자연스러워야 하는 음성 에이전트, 상호작용형 비서, 그 밖의 실시간 환경입니다. 이런 제품에서는 아름다운 오프라인 클립만으로 부족합니다. 고객이 음성 에이전트에서 필요한 성과를 얻으려면 기업 규모의 실시간 대화 안에서 목소리가 제대로 작동해야 합니다.
그래서 다음을 최적화합니다.
낮은 지연시간
어색한 공백은 대화가 끊긴 것처럼 느끼게 합니다.
명료도
사용자는 이름, 숫자, 주소, 코드를 처음 듣고 이해해야 합니다.
자연스럽고 절제된 표현
연극처럼 과장하지 않으면서 대화에 참여하는 느낌을 주어야 합니다.
맥락에 맞는 정확성
상황에 맞는 내용을 적절한 방식으로 말해야 합니다.
일관성
통화 내내 같은 화자의 목소리를 안정적으로 유지해야 합니다.
스트리밍 안정성
실시간 음성에 어색한 연결, 반복, 잘린 소리가 없어야 합니다.
원하는 제품 경험을 먼저 정의하고, 모델이 실제로 이를 제공하는지 측정하는 다차원 평가를 구축해야 합니다. 우리에게는 실시간 대화가 빠르고 명확하며 자연스럽게 느껴지도록 발화를 최적화하는 것이 그 의미입니다.