
デジタルシステムとのやり取りの多くは、今も入力欄に文字を打ったり、画面をタップしたりして行います。機能はしますが、手間がないわけではありません。音声なら、人が普段行うコミュニケーションに近く、速く自然な体験にできます。うまく実現できれば、学習、支援、多言語のやり取り、作業の完了を、より対話的に進められます。
音声でやり取りするときは、生成された発話そのものが体験になります。話し方の小さな違いで、役立つ、自然、壊れているといった印象が変わります。TTSが重要なのは、書かれた入力を発話に変え、やり取り全体の感触を形づくるからです。ただし、誰にでも合う一つの声があるわけではありません。
TTSの音声が「よい」と言うとき、意味するのは次の一つ、あるいはいくつかです。
正確さ
すべての単語を正しく話しているか。
音声品質
雑音、背景音、ひずみがないか。
文脈に応じた正確さ
名前、数字、曖昧な語を文脈に沿って正しく解釈しているか。
自然さ
人間らしく聞こえるか。
安定性
大文字と小文字の違い、略語、言語の切り替えなど、不規則な入力でも品質を保てるか。
多面的であるため、TTSの評価は難しくなります。モデルが改善すると、読み間違い、乱れた音声、背景の雑音といった明らかな欠点から、より微妙な違いに評価が移ります。この記事では、一見単純な次の問いに答えようとすると現れる失敗をたどります。
このTTSモデルは、よいモデルでしょうか。
1. TTSは一対多の対応という問題
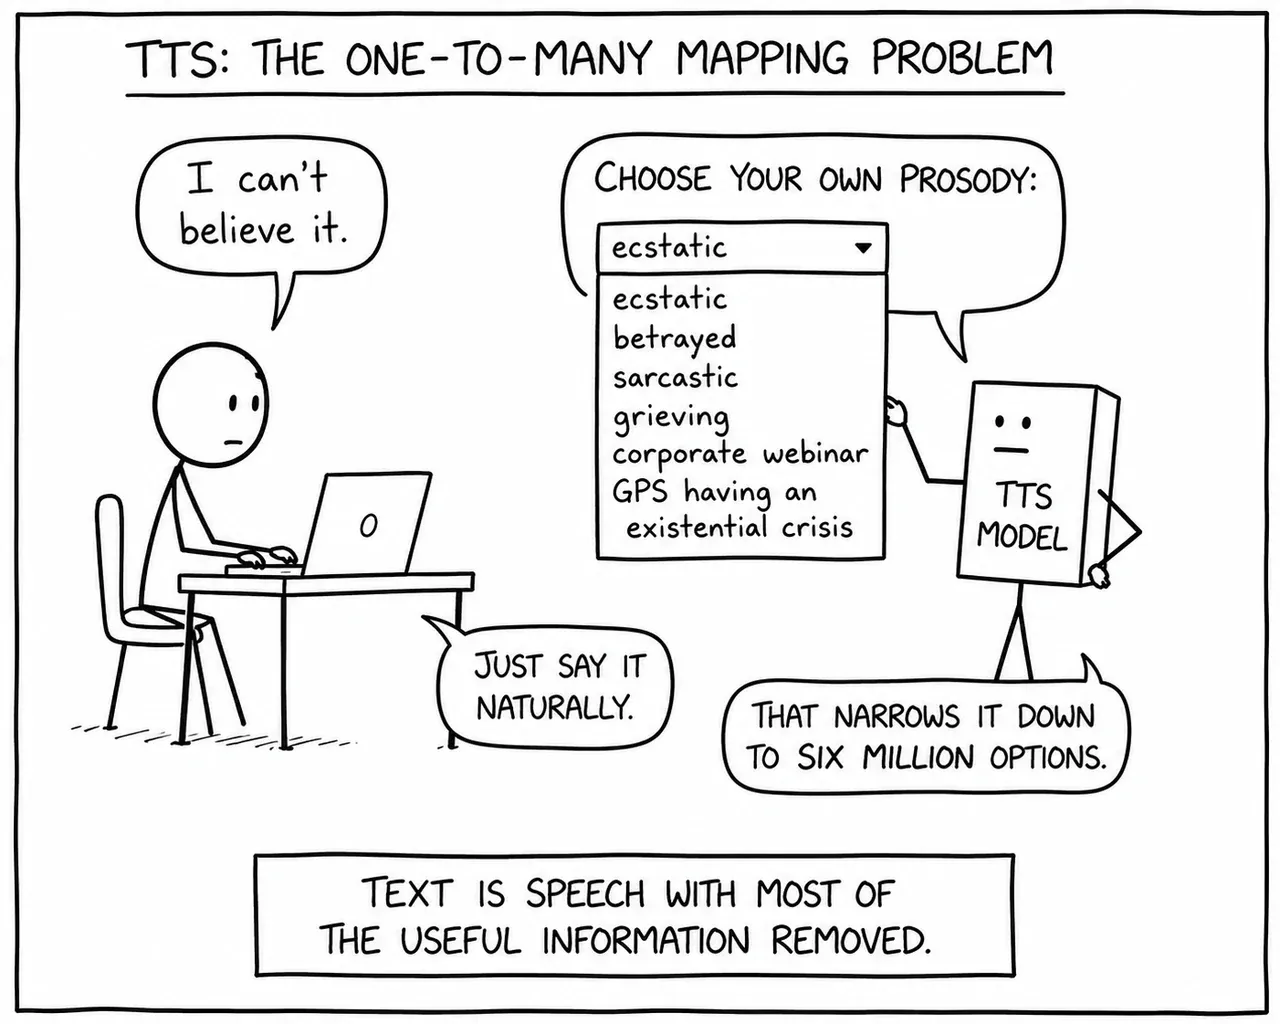
現代のTTSモデルは、テキストを音声に変えるだけではありません。どう話すかを決める必要があります。
同じテキストでも、話者、感情、速さ、強調、文脈によって読み方は無数にあります。これが一対多の問題です。
たとえば「信じられない」は、まったく異なる四つの文脈で正しく使えます。
- 喜び。予想外によい知らせを聞いた。
- 怒り。腹立たしい裏切りに反応している。
- 悲しみ。つらい失望を受け止めようとしている。
- 皮肉。感心したふりをして、実際は逆のことを思っている。
以下の録音は元の英語のままです。
喜び(英語)
怒り(英語)
悲しみ(英語)
皮肉(英語)
文脈を入れ替えてみましょう。怒る場面で喜んだ声を、悲しい場面で皮肉な声を再生すると、単語はすべて正しくても、発話は不適切に感じられます。
同じテキストで文脈が違う、別の例です。
Tomorrow is the big day. There’s no changing it now.
音声1(英語)
音声2(英語)
最初の音声は、大きな出来事を楽しみにしているように聞こえます。二つ目は、難しい試験のような緊張する出来事を前に、不安や恐れを感じているようです。
この幅の広さが、TTSを単なる文字から音への変換より難しくします。よいシステムは単語の発音だけでなく、間、強調、速さ、感情も決めます。テキストだけでは情報が足りないことも多く、追加の文脈や、望む話し方の指示が必要になる場合があります。
ただし、その微妙な選択の前に、評価は普通、意図した単語を話したかという基本から始まります。
2. 正しい単語を話すことは、最初の層にすぎない
単語誤り率、WERは、TTSでよく使われる指標の一つです。入力テキストから合成した音声をASRで文字起こしし、元のテキストと比較します。
例を聴いてみましょう。
I can’t stop smiling, everything feels brighter, lighter, warmer, and somehow, after all the waiting, all the hoping, and all the uncertainty, this moment feels even better than I imagined.
音声1(英語)
音声2(英語)
どちらもすべての単語を正しく話していてWERは同じですが、多くの人は自然に二つ目を選ぶでしょう。
WERは方向を知るには役立ちます。しかし、聞き取りやすさがほぼ解決すると、差は雑音に埋もれていきます。
- WERは頭打ちになる。上の例のように、特に明瞭な朗読形式のデータでは、WERにほとんど差がなくても、聞こえる品質は大きく違うことがあります。
- ASRの品質に依存する。特定のアクセント、言語、雑音、感情豊かな発話、専門語彙に弱いASRでは、合成の誤りでなくASRの誤りでTTSが減点されます。逆に、優れたASRは不明瞭な声を補正、推測して、人には悪く聞こえる音声を高く評価してしまうことがあります。
WERは、単語ではない英数字を含む用途などで必要な指標です。しかし企業向けの音声エージェントでは、これだけで十分なことはほとんどありません。
3. 文脈に応じた正しさも難しい
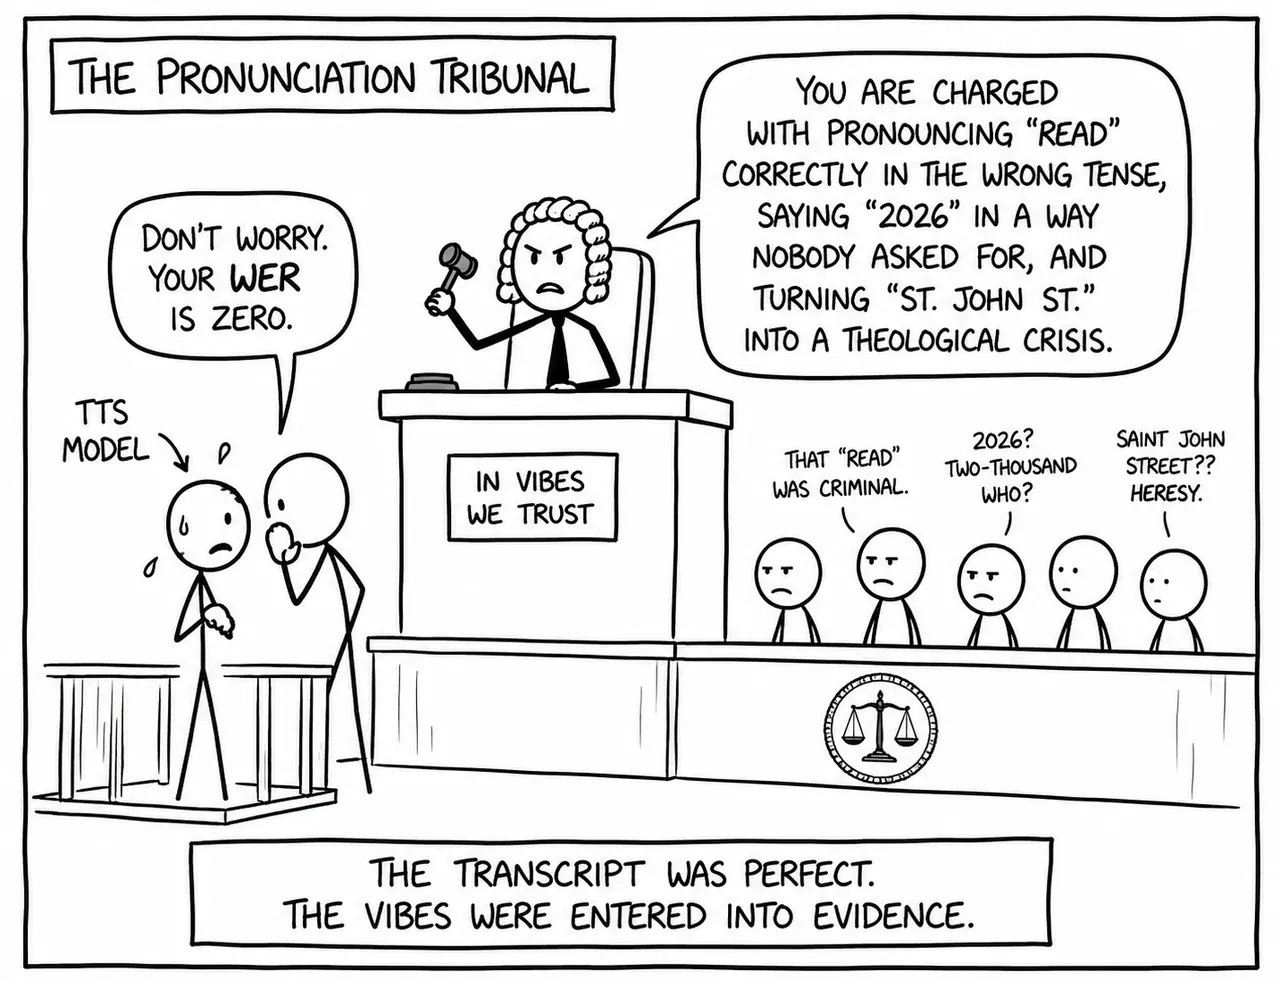
多くの誤りは、正しさを定義するだけでも意味の曖昧さを解消する必要があります。
- read:現在形か過去形か
- lead:金属か動詞か
- Polish:国籍か動詞か
- bass:魚か楽器か
- live:動詞か形容詞か
- 2026のような年:twenty-twenty-sixかtwo thousand twenty-sixか
I had to wind the old clock before the wind picked up outside.
固有名詞はさらに難しくなります。人、場所、製品、企業、薬、架空の用語には、標準の発音がないことが多く、特に言語をまたぐと人同士でも意見が割れます。
よい評価は、流暢に聞こえても解釈が間違っている場合を検出する必要があります。
4. テキストの正規化には独自の評価が必要
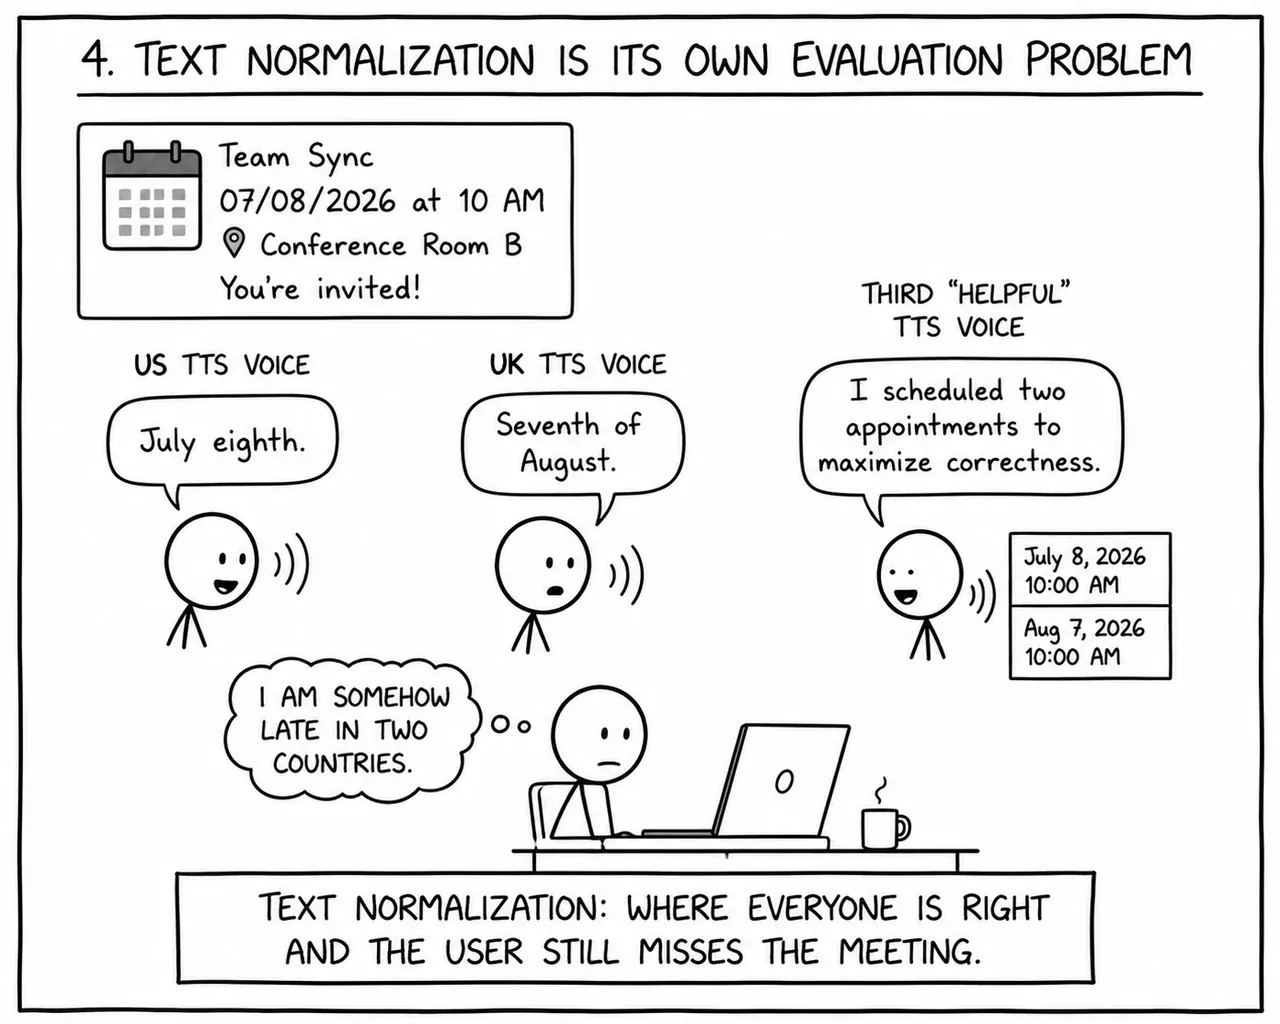
文脈が重要なのは発音だけではありません。発音する前に、書かれた文字を話し言葉へどう展開するかを決める必要があります。
多くの入力は曖昧です。
- $1.05:one oh fiveか、one dollar and five centsか
- 3/4:three quartersか、three-fourthsか
- IV:fourか、I-Vか
- St.:streetか、saintか
- No. 5:number fiveか、「no. five」か
日付の地域差はわかりやすい例です。次のテキストは、米国英語では7月8日、英国英語では8月7日を意味します。
I’d like to schedule an appointment for 07/08/2026 at 10 AM. Could you confirm if that time is available?
米国のロケール
英国のロケール
文脈によって複数の正規化が正しくなり、参照用のテキストが製品の望む読み方と異なることもよくあります。正規化の好みとモデルの誤りを分けなければ、評価値の意味が崩れます。
5. 自動の品質評価は役立つが、完全ではない
テキストの正確さは最低条件です。正しい語を言えるようになると、品質の差は主に韻律、表現力、スタイル、安定性に現れます。自然で、適切で、使える発話にする要素です。
DNSMOS、NISQA、UTMOSなどは、生成音声を聴いて品質を採点し、大量のサンプルの劣化を見つけるのに役立ちます。
しかし、これらは代理の指標です。「この場面でこの音声は役立ったか」ではなく、「採点を学んだ音声に似ているか」を問います。
この違いによる失敗は、しばしば見えにくいものです。
- 領域の不一致。学習した種類の発話ではよく動いても、別の状況では信頼できなくなります。たとえばUTMOSv2は、主に英語の高品質な合成音声の自然さのMOSを予測するためのもので、コーデック、雑音のある音声、多言語、歌、会話の万能な指標として設計されていません。
- 尺度のずれ。古いモデルを区別できた得点も、新モデルの失敗が微妙になると意味を失うことがあります。自動評価モデルにも再学習が必要になります。
- 見落とし。雑音やひずみは検出しても、不適切な感情、不自然な速さ、ストリーミングの乱れ、徐々に変わる声を見逃すことがあります。自動MOS予測の研究では、同じ発話に日本語のピッチアクセントの誤りを増やすと、人の評価は1.84ポイント下がりましたが、自動モデルの変化はすべて0.1未満でした。ひどく乱した音声をわずかに高く採点するモデルさえありました。
| なし(基準) | 低(10-20%を変更) | 高(80-90%を変更) | |
|---|---|---|---|
| 人によるMOS | 4.00 ± 0.07 | 3.19 ± 0.09 | 2.16 ± 0.09 |
| UTMOS | 3.44 ± 0.12 | 3.43 ± 0.11 | 3.47 ± 0.11 |
| UTMOSv2 | 3.56 ± 0.08 | 3.62 ± 0.06 | 3.61 ± 0.08 |
| NISQA | 3.81 ± 0.16 | 3.74 ± 0.15 | 3.84 ± 0.16 |
| DNSMOS | 3.82 ± 0.05 | 3.81 ± 0.06 | 3.83 ± 0.05 |
つまり、明らかな劣化を大量に見つけるには役立ちますが、何がよい音声をつくるかという理解を置き換えるものではありません。
ここで人による評価が必要になりますが、そこには別の落とし穴があります。
6. 人の評価は最良の基準か
人による試聴は今も最良の基準ですが、得点は安定した測定値ではありません。聞き手の背景、母語かどうか、指示の文言、基準となるサンプル、ヘッドホンかスピーカーか、音量の正規化、試聴時間と疲労などで変わります。
一般的な形式はMOS、平均オピニオン評点と選好評価です。MOSでは各音声の品質や自然さを、通常1〜5で独立に採点します。選好評価では複数を比較し、好むものを選びます。MOSは絶対的な点数に見え、選好評価は直接的な比較ですが、どちらも指示、聞き手の集団、提示方法に左右されます。いずれの形式にも次の課題があります。
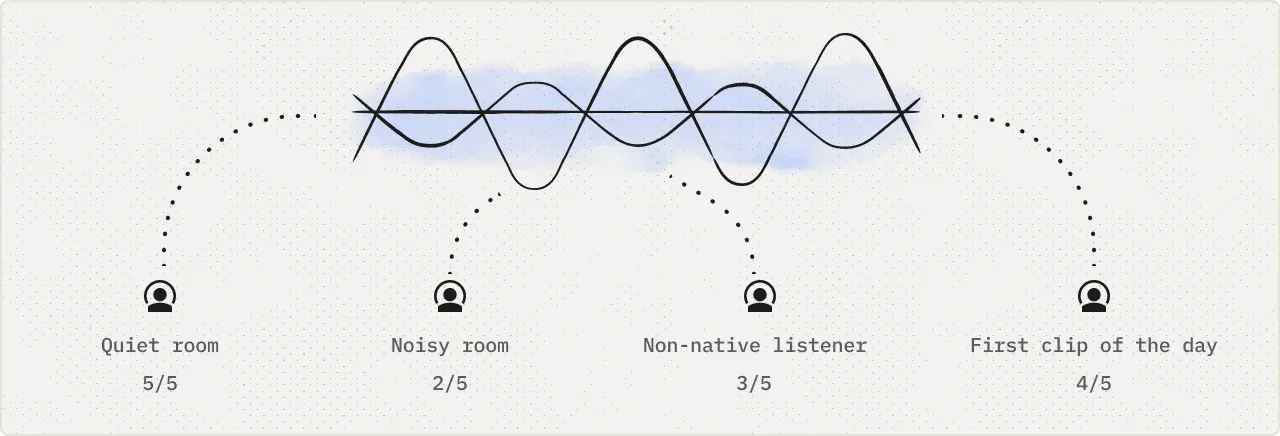
6.1 聞き手の反応は文脈に依存する
同じ文を聴いても、思い浮かべる状況は異なります。「それはすごいですね」は、ある場面では心からの言葉、別の場面では皮肉、さらに別では平坦でわかりにくい発話に聞こえます。
声に何を期待するかで、同じ音声の得点が変わります。想定する場面を明示しなければ、共有の基準でなく、各自の期待で判断することになります。
6.2 提示の細部が比較を左右する
無関係に見える小さな選択が、結果を決めることがあります。
- 音量やピークの正規化。モデルが優れていなくても、大きい音声は明瞭、自信がある、高品質と感じられます。
- サンプルレート、コーデック、リサンプリング。圧縮や再サンプリングの乱れが、合成の品質と無関係に印象を悪くします。
- プロンプトの文、UIの文脈、前後のサンプル。提示の仕方は期待を形づくり、気づく点や好みを変えます。
- 無音、息、開始時の遅れの切り取り。小さな編集でも、自然さ、不自然さ、応答の速さが変わります。
これらを固定しないと、モデルではなく音声の処理経路を評価しているかもしれません。
6.3 モデルが安定していても、評価は変わる
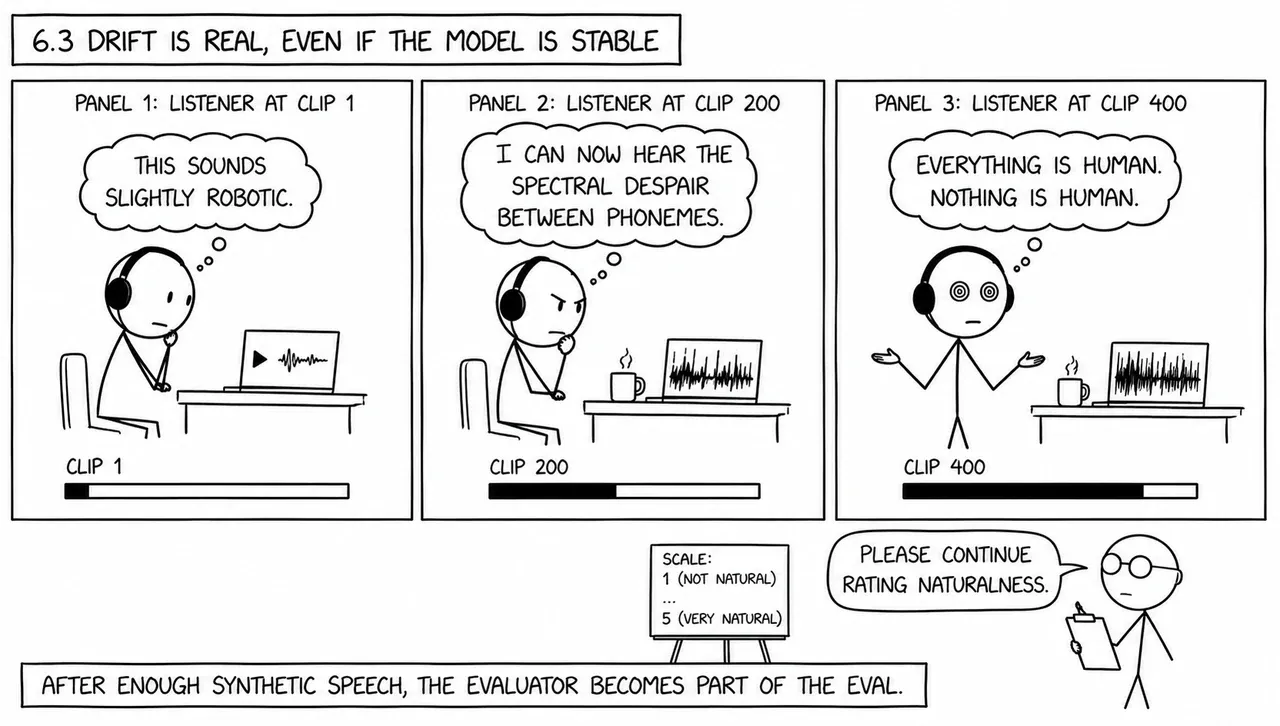
時間とともに聞き手も変わります。
- 慣れ。合成音声を多数聴くと、乱れに敏感になったり、寛容になったりして、気づく基準が変わります。
- 疲労。音声の評価は疲れる作業で、長く続けるほど判断の品質が落ちます。
- 環境の違い。ヘッドホンでは目立つ点が電話のスピーカーでは消え、逆も起こります。
人のMOSを変わらない正解として扱うと、後で問題になります。
6.4 好みは人によって違う
注意深い聞き手でも、望むものは同じではありません。
- 声の個性と音色。明るく明瞭な声、温かく低い声、質感のある声など、好みが分かれます。
- 話す速さ。効率的と感じる人も、急かされて負担と感じる人もいます。
- アクセントと方言。親しみや自然さを感じる相手もいれば、気になる、合わないと感じる相手もいます。
- 感情の強さ。表現豊かな話し方を好む人も、同じ演技を大げさで疲れると感じる人もいます。
- 年齢や人格の手掛かり。同じ声から違う性格を推測し、製品ごとに異なる人物像を好むことがあります。
以下は英語の原音と、そのままの文字起こしです。
Please call Stella. Ask her to bring these things with her from the store: Six spoons of fresh snow peas, five thick slabs of blue cheese, and maybe a snack for her brother Bob. We also need a small plastic snake and a big toy frog for the kids. She can scoop these things into three red bags, and we will go meet her Wednesday at the train station.
米国南部のアクセント
ニューヨークのアクセント
George Mason UniversityのSpeech Accent Archiveにある人の録音(英語)
このため、聞く人によっては**二つのシステムがそれぞれ「よい」**ことになります。問いは「誰にとってよいか」です。
7. 長い音声とストリーミングでは、別の失敗が現れる
多くのTTS評価は、生成、試聴、採点が簡単な短いクリップを使います。しかし実際の製品では、記事や章の読み上げ、サポート通話、双方向の会話など、話し続けることが求められます。そこで新しい問題が現れます。
長い音声は、一文ずつよく聞こえるだけでなく、時間を通して一貫している必要があります。よくある変化は次のとおりです。
- 話者の個性が変わる
- アクセントが変わる
- 話す速さが変わる
- 段落をまたいで感情の一貫性が失われる
ストリーミングでは、応答全体が生成される前に再生を始めます。段落や回答の完成を待たず、小さな断片を生成してすぐ送ります。文の残りをまだ作っていても、すぐ話し始めるので、アシスタントの反応が速く感じられます。
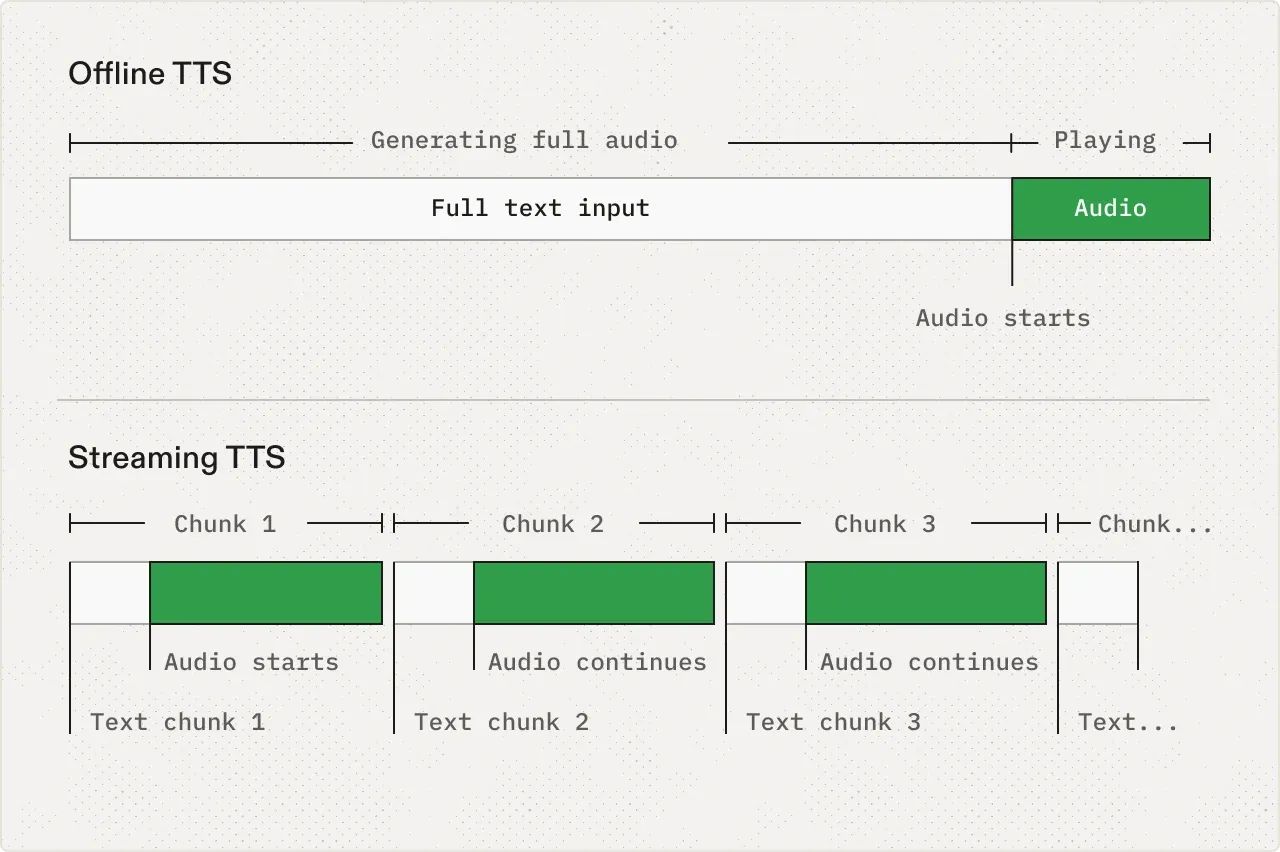
この速度には交換条件があります。次に何が来るかを完全には知らずに話し始めるため、オフラインにはない失敗が起こります。
- 不自然なつなぎ目。各断片はよくても、移り変わりが継ぎはぎに聞こえる。
- 音節や語の繰り返し。「look-look-looking」「is is scheduled」のように境目で重複する。
- 音の途切れ。「stop」が「top」になるなど、語の始まりや終わりが急に切れる。
- 話し方の早すぎる決定。誤った速さ、感情、強調で始め、修正できなくなる。
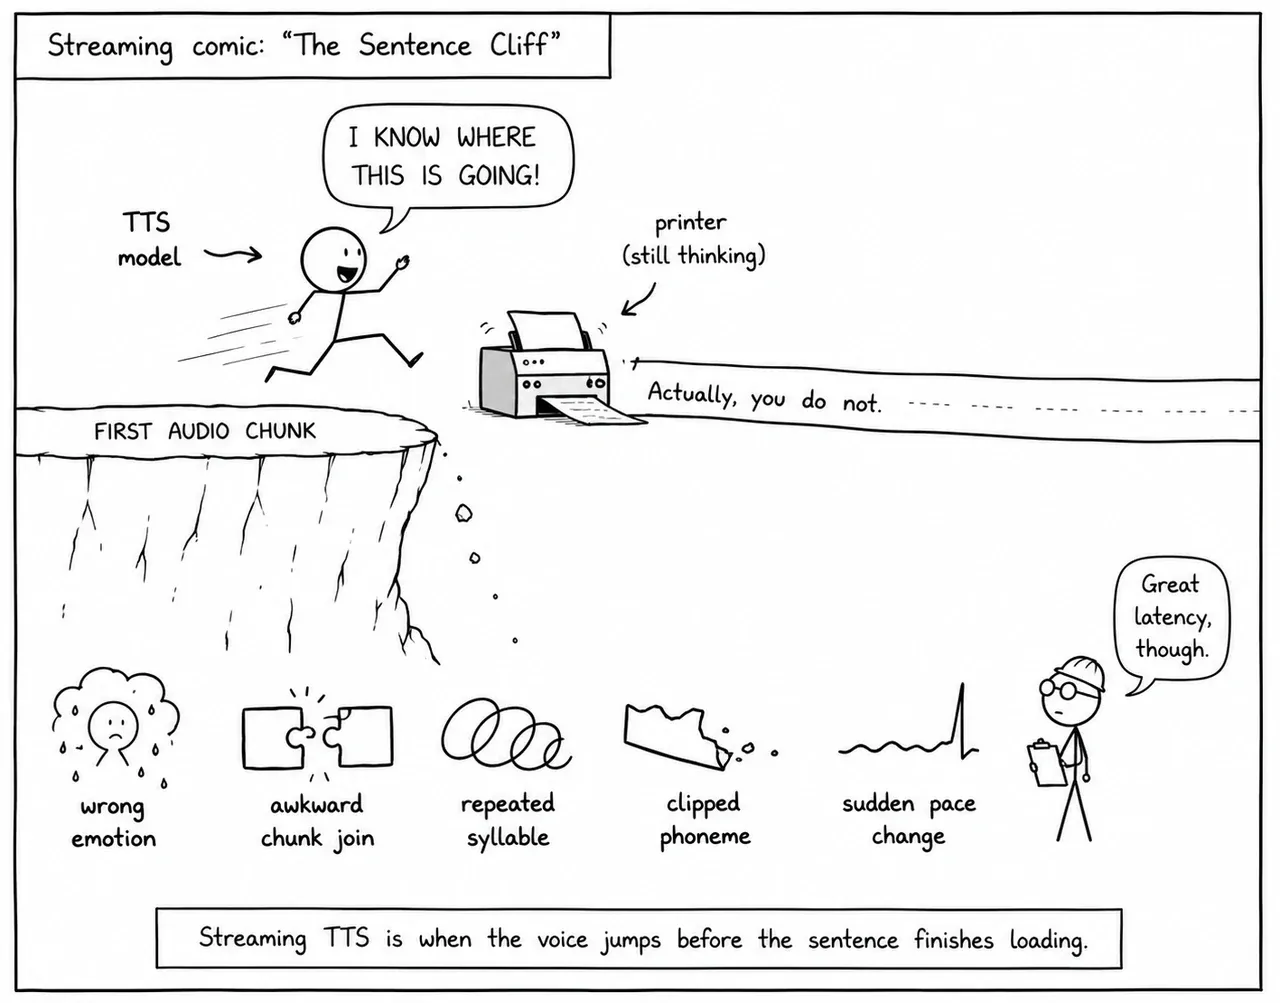
短いクリップは、ライブ生成でしか起こらない失敗を隠します。長文のテストは声を長く保てるかを問い、ストリーミングのテストは全文がわかる前に急いで話し始めても自然かを問います。
これらは無作為な失敗ではありません。評価条件が実際の使われ方から外れると起こりがちです。次は分野の違いを考えます。一般的な朗読では優れた声でも、専門の慣例、数式、名前、リズムがあると崩れることがあります。
8. 専門分野のテキストは前提を崩す
法律、医療、ゲーム、数学、詩、宗教の文章、顧客サポートなど、分野ごとに期待は違います。
- 書式と正規化
- 珍しい単語の扱い
- 話すリズム
- 正確さとスタイルそれぞれの制約
ある分野で最高水準でも、別の分野では明らかにおかしく聞こえることがあります。
The process of photosynthesis relies on a specific chemical reaction. Plants take in carbon dioxide and water to produce glucose and oxygen: 6CO₂ + 6H₂O → C₆H₁₂O₆ + 6O₂. This balanced equation shows how life sustains itself on Earth.
H₂Oの発音のリズムが崩れ、「→」が読まれていない点に注目してください。化学の専門家なら、yieldsやproducesと読みます。
分野は違いの一つの軸です。言語と地域は別の軸で、評価の仕組みをまったく違う形で崩します。
9. 多言語には固有の課題がある
多言語TTSは、英語の問題をN回繰り返すことではありません。言語ごとに評価の違う部分が崩れます。話せない言語は採点できないため、母語話者は必須です。具体的には次の問題があります。
自動指標が気づかないうちに機能しなくなる。WERはASRの偏りを引き継ぎます。英語以外のアクセント、文字、データの少ない言語に弱い認識器では、TTSではなく認識器の誤りが減点につながります。学習型の品質予測器も同じです。UTMOSなどは主に英語で学習しているため、分布が違うとほとんど測れないかもしれません。英語で評価を拡張するための自動化が、最も大量の評価を必要とする場面で最も頼れなくなります。
「正しい語」は言語によって異なり、曖昧な場合も多くあります。 フランス語にはリエゾンがあり、普段は読まない語末の子音を、次の語が母音で始まると発音します。les amisは「lez-ami」のように読み、「lay-amis」ではありません。誤っていても単語はわかることが多い一方、母語話者らしくは聞こえません。
Liaison
日本語はさらに難しく、特に名前では漢字だけで読みが決まりません。たとえば「上手」は、じょうず、うわて、かみてと読めます。文脈がなければ、ありそうでも誤った読みを選ぶことがあります。
jōzu
田中さんは日本語が上手です。
Tanaka-san wa nihongo ga jōzu desu.
田中さんは日本語が上手です。
uwate
交渉では相手の方が一枚上手だった。
Kōshō de wa aite no hō ga ichimai uwate datta.
交渉では相手の方が一枚上手だった。
kamite
役者は上手から登場した。
Yakusha wa kamite kara tōjō shita.
役者は上手から登場した。
同じ種類の問題は、普通話の声調、アラビア語で書かれない短母音、ヒンディー語のシュワーの脱落など、各言語に現れます。正しく採点するには母語話者の知識が必要です。
言語は正しくても、アクセントが違う。カナダのフランス語の単語をパリのイントネーションで話したり、スペインの声が途中からメキシコの発音に変わったりします。流暢で完全に理解できても、地域が違うのです。
次はフランス語の原音と文字起こしです。
Je remarque que votre facture de cette fin de semaine comprend des frais d’utilisation de données pour votre cellulaire.
想定するカナダのフランス語
想定と異なるフランスのフランス語
この例は、聞き取りやすさと表現力のテストをすべて通っても、依然として誤りです。言語をまたぐ声には逆の失敗もあります。ヒンディー語話者が英語の語を言うときは、インドのアクセントを保つべきです。それを一般的な米国英語に「直す」のは改善でなく誤りです。単一言語の評価には見えない、正しさの軸です。
一つの得点が差を隠す。ある言語では韻律、別では発音、さらに別では地域固有の正規化と、失敗は異なる次元に集中します。多言語の集計値一つでは、対処すべき信号が平均に消えます。「多言語で優れている」は、ロケールと評価の次元ごとに述べて初めて意味があります。
多言語の評価には、全体の一つの点数ではなく、母語話者を含め、地域、失敗の種類、製品で重要な期待ごとに分けた品質の見方が必要です。
おわりに:TTSは一つの次元では測れない
「よい」が一つのことを指さないため、TTS評価は難しくなります。オーディオブック、道案内、顧客サポートを、まったく同じ基準で最適化すべきではありません。
Cartesiaが特に重視するのは、音声エージェント、対話型アシスタントなど、速く応答しながら自然に聞こえる必要があるリアルタイムの会話です。美しいオフラインの録音だけでは足りません。お客様が必要な成果を得るには、企業規模の実際の会話の中で機能する声が必要です。
そのため、次の点を最適化します。
低レイテンシ
不自然な間は、会話が壊れているように感じさせます。
明瞭さ
名前、数字、住所、コードを一度で聞き取れる必要があります。
自然で抑制の利いた表現
芝居がかりすぎず、会話に関わっていると感じる声が必要です。
文脈に合う正確さ
状況に合う内容を、適切な話し方で伝える必要があります。
一貫性
通話を通して同じ話者の声を安定して保ちます。
ストリーミングの安定性
リアルタイムの発話に不自然なつなぎ目、繰り返し、音の途切れがあってはいけません。
望む製品体験を定義し、モデルが実際にそれを届けるかを測る多面的な評価をつくることが大切です。私たちは、リアルタイムの会話が速く、明瞭で、自然に感じられる音声を目指しています。