
A maioria das nossas interações com sistemas digitais ainda acontece digitando em campos ou tocando em telas. Funciona, mas nem sempre é simples. A voz pode tornar a interação mais rápida, natural e próxima da forma como as pessoas já se comunicam. Se funcionar bem, abre uma maneira mais interativa de aprender, pedir ajuda, transitar entre idiomas e realizar tarefas.
Quando a interação acontece por voz, a fala gerada passa a ser a experiência. Pequenas diferenças na interpretação mudam a percepção de utilidade, naturalidade ou falha. Por isso, texto para fala é uma parte tão importante da stack. Ele transforma texto em áudio e molda toda a interação. Mas não existe uma única experiência de voz adequada a todos os casos.
Quando alguém diz que um áudio gerado por TTS é bom, por exemplo, pode estar se referindo a um ou vários aspectos:
Exatidão
Todas as palavras são faladas corretamente?
Qualidade do áudio
O áudio está livre de estática, ruído de fundo e distorção?
Exatidão no contexto
Nomes, números e palavras ambíguas foram interpretados corretamente no contexto?
Naturalidade
Soa humano?
Resistência a variações
A qualidade se mantém com entradas irregulares, como diferenças entre maiúsculas e minúsculas, abreviações ou alternância de idiomas?
Essas várias dimensões tornam a avaliação difícil. Conforme os modelos melhoram, o foco deixa de ser defeitos óbvios, como pronúncia errada, áudio distorcido ou ruído, e passa a ser aspectos mais sutis. Este artigo percorre falhas recorrentes ao tentar responder a uma pergunta aparentemente simples:
Este modelo TTS é bom?
1. TTS e o problema de uma entrada com muitas saídas
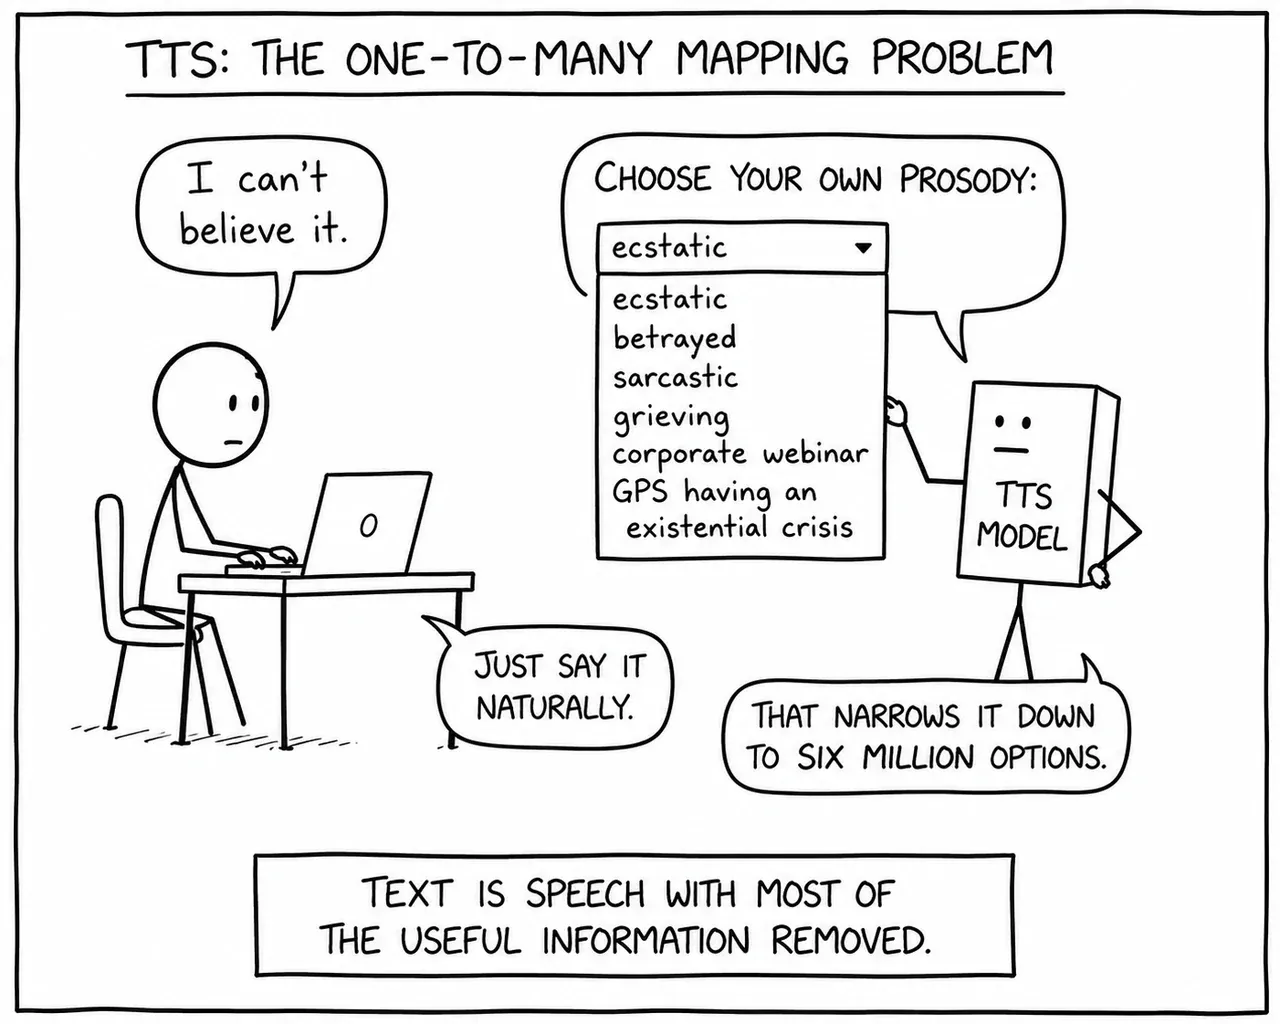
Um modelo TTS moderno faz mais que converter texto em áudio. Ele precisa decidir como falar.
Texto para fala admite muitas saídas para uma entrada. Há infinitas formas de ler uma transcrição conforme a pessoa, a emoção, o ritmo, a ênfase e o contexto.
Por exemplo, “I can’t believe it”, ou “Não acredito”, pode estar correto em quatro contextos muito diferentes:
- Entusiasmo: alguém acaba de receber uma notícia boa e inesperada.
- Raiva: alguém reage a uma traição frustrante.
- Tristeza: alguém tenta processar uma decepção dolorosa.
- Sarcasmo: alguém finge estar impressionado, mas quer dizer o contrário.
Entusiasmo
Raiva
Tristeza
Sarcasmo
Agora troque os contextos. Se o áudio entusiasmado tocar no cenário de raiva, ou o sarcástico no cenário triste, todas as palavras continuam certas, mas a fala soa errada.
Outro exemplo do mesmo texto em contextos diferentes:
Tomorrow is the big day. There’s no changing it now.
Áudio 1
Áudio 2
O primeiro áudio soa animado, como se a pessoa esperasse um grande evento. O segundo soa nervoso ou assustado, como se antecipasse algo estressante, como uma prova difícil.
Essa variação torna o TTS mais difícil que apenas converter palavras em som. O sistema precisa decidir como pronunciar, onde pausar, quais palavras enfatizar, em que velocidade falar e qual emoção expressar. Muitas vezes, o texto sozinho não contém informação suficiente. O sistema pode precisar de contexto ou instruções adicionais sobre o estilo desejado.
Antes dessas escolhas sutis, a avaliação costuma começar pela pergunta mais básica. O modelo falou as palavras pretendidas?
2. Dizer as palavras certas é apenas a primeira camada
A WER, taxa de erro de palavras, é uma das métricas mais comuns para TTS. Você sintetiza áudio a partir de um texto, transcreve-o com um modelo de reconhecimento automático de fala, ou ASR, e compara a transcrição ao texto original.
Veja alguns exemplos.
I can’t stop smiling, everything feels brighter, lighter, warmer, and somehow, after all the waiting, all the hoping, and all the uncertainty, this moment feels even better than I imagined.
Áudio 1
Áudio 2
Os dois áudios dizem todas as palavras corretamente e têm o mesmo WER, mas a maioria das pessoas naturalmente preferiria o segundo.
O WER pode orientar a avaliação. Mas, quando a inteligibilidade já está bem resolvida, as diferenças ficam pequenas demais para se distinguir do ruído.
- O WER satura: dois modelos podem ter diferenças relevantes de qualidade percebida e diferenças insignificantes de WER, especialmente em testes limpos de leitura.
- Ele depende do ASR: a métrica só é tão confiável quanto o reconhecedor usado para calculá-la. Se o ASR é mais fraco em certos sotaques, idiomas, áudios ruidosos, falas expressivas ou termos especializados, o TTS pode ser penalizado por erros do reconhecedor.
- No sentido contrário, um ASR forte pode corrigir ou inferir uma fala pouco clara, fazendo uma amostra parecer melhor na métrica do que soa para humanos.
WER é uma métrica necessária em muitos usos, especialmente com dados alfanuméricos que não são palavras. Mas raramente basta para agentes empresariais.
3. Acertar o contexto é outro desafio
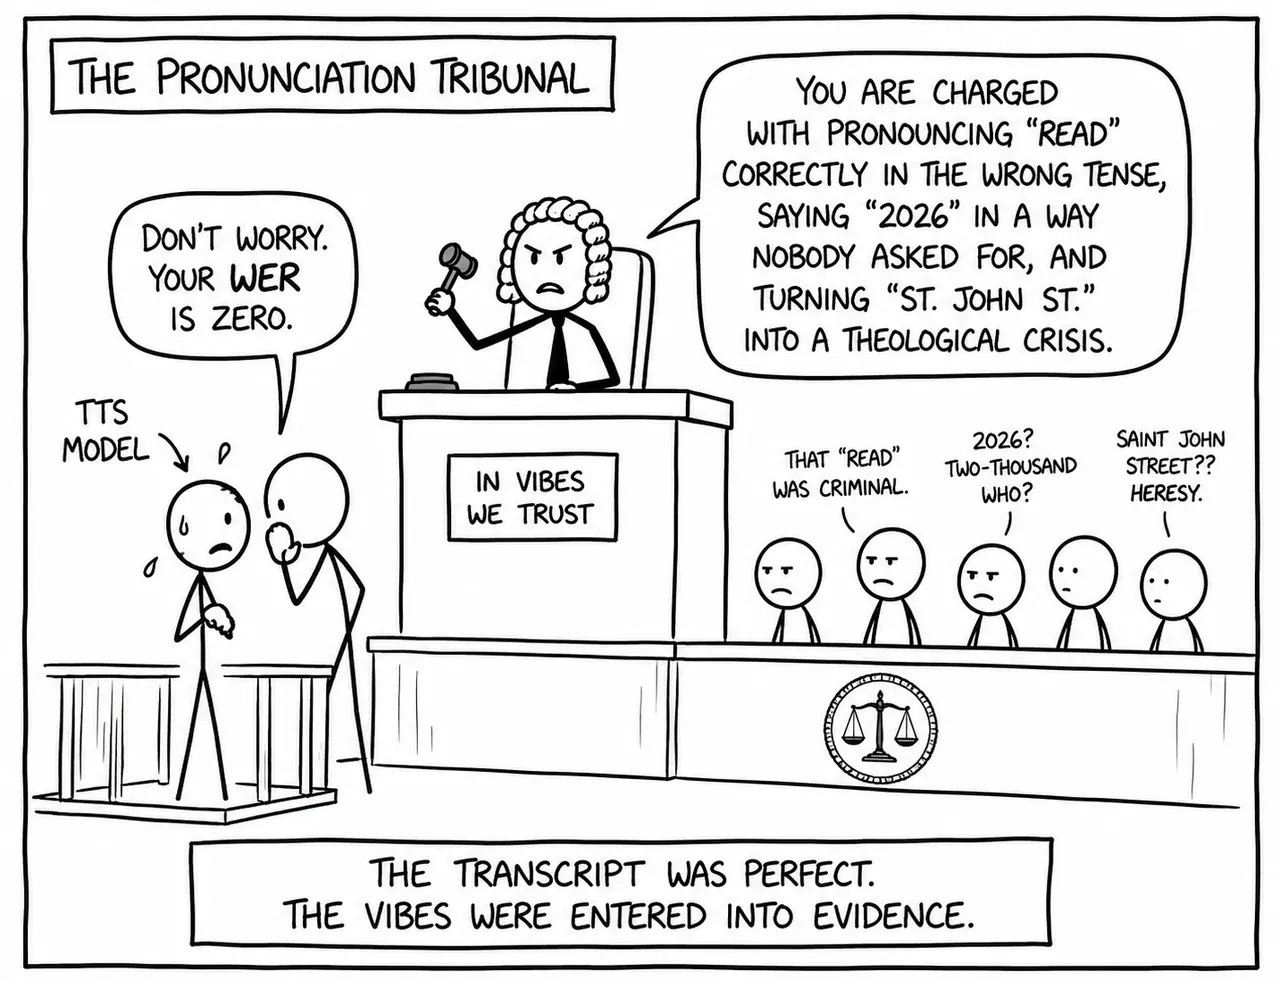
Muitos erros exigem desambiguar o significado antes mesmo de definir o que está correto:
- “read”, presente ou passado
- “lead”, metal ou verbo
- “Polish”, nacionalidade ou verbo
- “bass”, peixe ou instrumento
- “live”, verbo ou adjetivo
- anos como “2026”, lidos como “twenty-twenty-six” ou “two thousand twenty-six”
I had to wind the old clock before the wind picked up outside.
Nomes próprios são ainda mais difíceis. Pessoas, lugares, produtos, empresas, medicamentos e termos fictícios muitas vezes não têm uma pronúncia canônica. Até humanos discordam, especialmente entre idiomas.
Uma boa avaliação precisa detectar a interpretação errada mesmo quando a fala soa fluida.
4. A normalização do texto exige sua própria avaliação
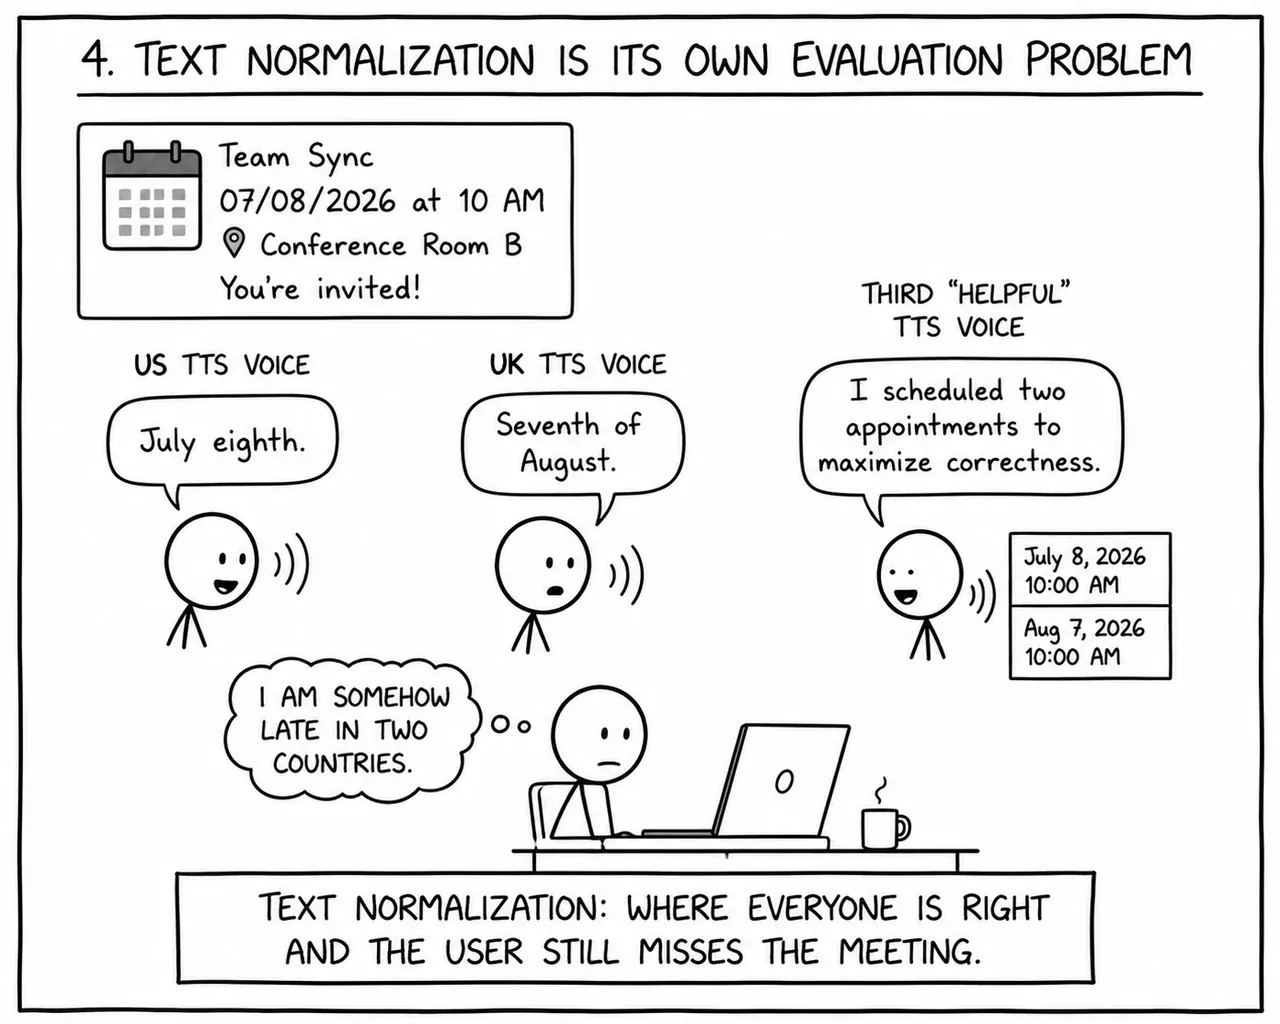
A pronúncia é apenas uma parte em que o contexto importa. Antes de pronunciar, o modelo muitas vezes precisa decidir como expandir o texto escrito em fala.
Muitas entradas são ambíguas:
- “$1.05”, como “one oh five” ou “one dollar and five cents”
- “3/4”, como “three quarters” ou “three-fourths”
- “IV”, como quatro ou as letras I-V
- “St.”, como street ou saint
- “No. 5”, como number five ou “no. five”
Datas em localidades diferentes são um bom exemplo. No texto abaixo, o inglês dos Estados Unidos espera 8 de julho, enquanto o britânico espera 7 de agosto!
I’d like to schedule an appointment for 07/08/2026 at 10 AM. Could you confirm if that time is available?
Localidade dos EUA
Localidade britânica
Várias normalizações podem estar corretas conforme o contexto. As transcrições de referência frequentemente registram uma escolha diferente da desejada pelo produto. Se você não separar preferência de normalização de erro do modelo, as pontuações ficam incoerentes.
5. Pontuações automáticas de qualidade ajudam, mas são incompletas
A fidelidade à transcrição é apenas o mínimo. Depois que o modelo diz as palavras certas, a diferença de qualidade costuma estar em prosódia, expressividade, estilo e estabilidade, os aspectos que tornam a fala natural, adequada e utilizável.
Preditores automáticos tentam medir isso em escala. Ferramentas como DNSMOS, NISQA e UTMOS analisam os áudios e atribuem notas, ajudando a detectar regressões em milhares de amostras.
Mas essas notas ainda são medidas indiretas. Elas não perguntam se o áudio funcionou naquela situação. Perguntam se ele se parece com os tipos de áudio que o preditor aprendeu a avaliar.
Essa diferença importa porque as falhas nem sempre são evidentes:
- Incompatibilidade de domínio: um preditor pode funcionar bem no tipo de fala do treinamento e se tornar pouco confiável em outro ambiente.
- O UTMOSv2, por exemplo, foi criado para prever MOS de naturalidade em fala sintética de alta qualidade, predominantemente em inglês. Não foi projetado como métrica universal para codecs, fala ruidosa, vários idiomas, canto ou conversas.
- Desvio de calibração: uma nota que separava modelos antigos pode perder significado quando os novos erram de formas mais sutis. Os preditores também podem precisar de novo treinamento.
- Pontos cegos: o preditor pode perceber ruído ou distorção e ignorar emoção inadequada, ritmo artificial, falhas de streaming ou mudanças graduais de voz.
- Neste estudo de preditores automáticos de MOS, a mesma fala foi gerada com quantidades crescentes de acentuação tonal incorreta em japonês. Humanos reduziram a nota em 1.84 ponto MOS. Todos os modelos automáticos variaram menos de 0.1. Alguns deram notas um pouco maiores às amostras muito corrompidas.
| Nenhuma alteração, referência | Baixa, troca de 10-20% | Alta, troca de 80-90% | |
|---|---|---|---|
| MOS humano | 4.00 ± 0.07 | 3.19 ± 0.09 | 2.16 ± 0.09 |
| UTMOS | 3.44 ± 0.12 | 3.43 ± 0.11 | 3.47 ± 0.11 |
| UTMOSv2 | 3.56 ± 0.08 | 3.62 ± 0.06 | 3.61 ± 0.08 |
| NISQA | 3.81 ± 0.16 | 3.74 ± 0.15 | 3.84 ± 0.16 |
| DNSMOS | 3.82 ± 0.05 | 3.81 ± 0.06 | 3.83 ± 0.05 |
Essas notas ajudam a identificar regressões óbvias em escala, mas não substituem entender o que torna um áudio bom.
Nesse ponto, muitas vezes é necessário recorrer à avaliação humana. Ela traz outras armadilhas.
6. Avaliação humana é o padrão de referência?
Testes com ouvintes humanos ainda são a referência, mas suas notas não são uma medida estável. Os julgamentos variam com a experiência da pessoa, o domínio nativo do idioma, as instruções, as referências do conjunto, o ambiente de reprodução, o uso de fones ou alto-falantes, a normalização de volume, a duração da sessão e o cansaço.
Dois formatos comuns são notas MOS, ou pontuação média de opinião, e avaliações de preferência. No MOS, cada áudio recebe uma nota independente, geralmente de 1 a 5, para qualidade ou naturalidade. Na preferência, ouvintes comparam dois ou mais áudios e escolhem o favorito. O MOS parece absoluto, enquanto a preferência é diretamente comparativa. Ambos dependem das instruções, dos ouvintes e da apresentação. Os dois formatos enfrentam os problemas a seguir.
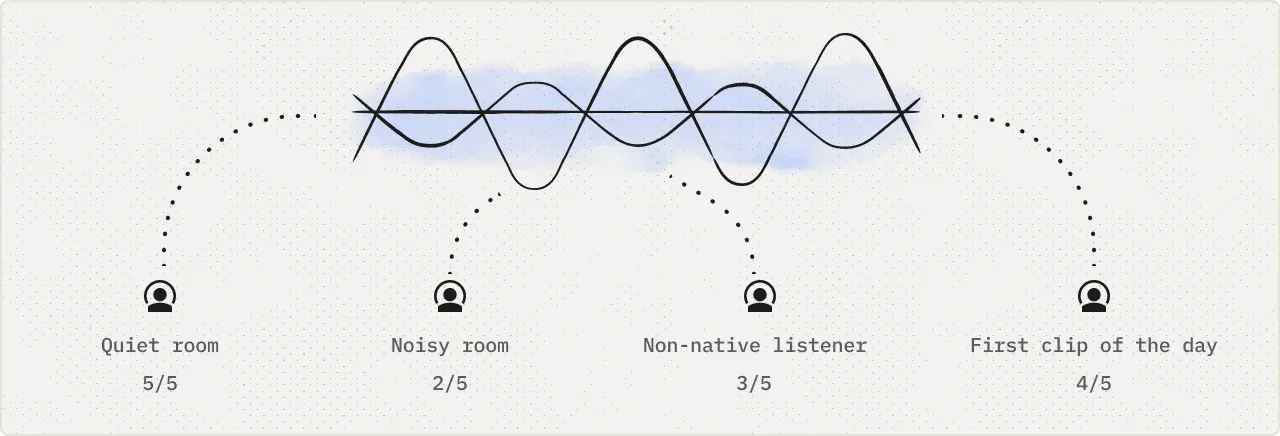
6.1 As respostas dos ouvintes dependem do contexto
As pessoas não ouvem áudios isolados de tudo. Mesmo com a mesma frase, imaginam situações diferentes. “Que ótimo” pode soar sincero em um contexto, sarcástico em outro e monótono ou confuso em um terceiro.
O mesmo áudio pode receber notas diferentes conforme o que o ouvinte acha que a voz deveria fazer. Se a tarefa não define o cenário pretendido, cada pessoa avalia pelas próprias expectativas, em vez de um objetivo comum.
6.2 Comparações são sensíveis à apresentação
Pequenas escolhas aparentemente irrelevantes podem dominar os resultados:
- Normalização de volume e picos: uma amostra mais alta pode parecer mais clara, confiante ou de melhor qualidade, mesmo sem um modelo melhor.
- Taxa de amostragem, codec e reamostragem: artefatos de compressão ou reamostragem podem prejudicar um sistema por motivos sem relação com a síntese.
- Texto do prompt, contexto da interface e amostras próximas: a apresentação molda as expectativas e muda o que as pessoas percebem ou preferem.
- Corte de silêncio, respiração ou atraso inicial: pequenas edições podem mudar a percepção de naturalidade, estranheza ou rapidez de resposta.
Sem controlar esses fatores, você pode estar avaliando o pipeline de áudio, em vez do modelo.
6.3 O julgamento muda, mesmo com o modelo estável
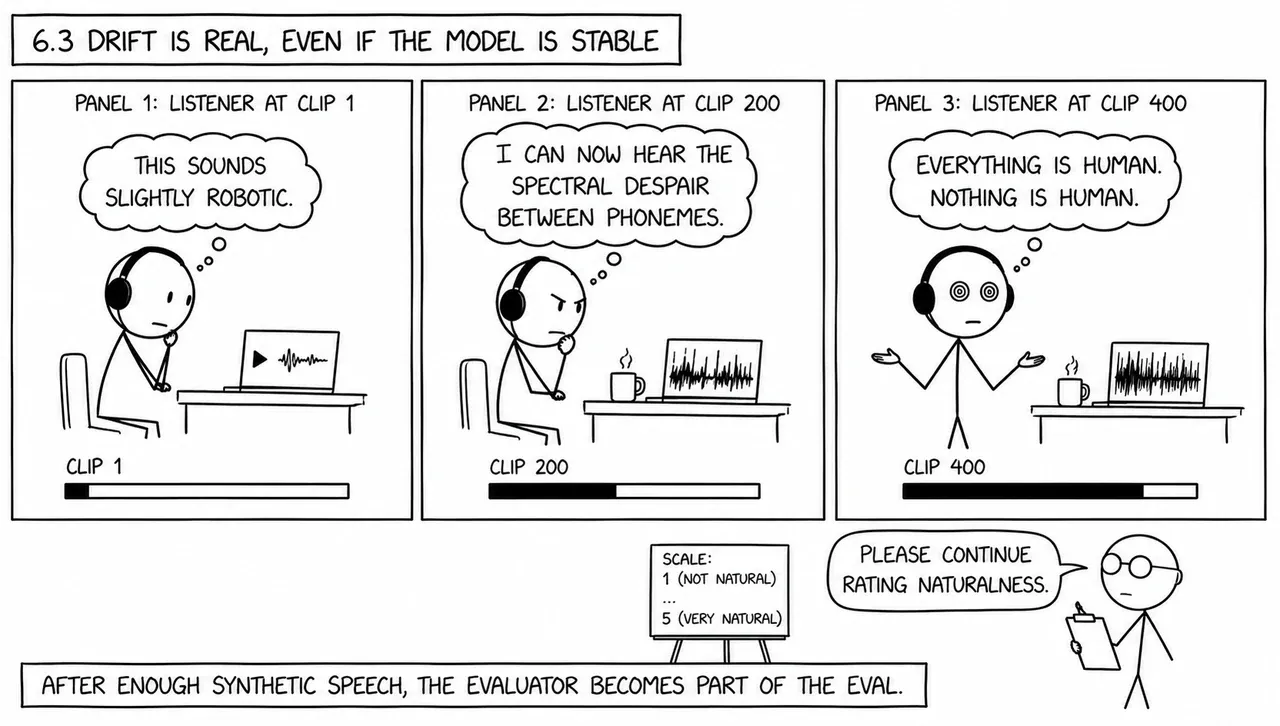
Com o tempo, os ouvintes também mudam:
- Adaptação: depois de muitos áudios sintéticos, recalibram a percepção e podem ficar mais sensíveis a artefatos ou mais tolerantes.
- Cansaço: anotar áudio é exaustivo, e a qualidade do julgamento cai em sessões longas.
- Variação de ambiente: o que chama atenção nos fones pode desaparecer no alto-falante do celular, e vice-versa.
Tratar MOS humano como verdade imutável trará problemas depois.
6.4 Preferências e gostos variam
As pessoas não querem a mesma coisa. Mesmo entre ouvintes atentos, as preferências diferem em:
- Identidade e timbre: alguns preferem vozes brilhantes e nítidas, outros vozes mais quentes, graves ou texturizadas.
- Velocidade: um ritmo rápido pode parecer eficiente para uma pessoa e apressado ou estressante para outra.
- Sotaque e dialeto: a mesma voz pode parecer familiar e natural para um público e inadequada para outro.
- Intensidade emocional: alguns gostam de expressividade, enquanto outros acham a mesma interpretação exagerada ou cansativa.
- Sinais de idade e personalidade: ouvintes podem inferir personalidades diferentes e preferir perfis distintos em produtos diferentes.
Please call Stella. Ask her to bring these things with her from the store: Six spoons of fresh snow peas, five thick slabs of blue cheese, and maybe a snack for her brother Bob. We also need a small plastic snake and a big toy frog for the kids. She can scoop these things into three red bags, and we will go meet her Wednesday at the train station.
Sotaque do sul dos EUA
Sotaque de Nova York
Gravações humanas do Speech Accent Archive da George Mason University
Sotaque do sul dos EUA, Plantersville, Arkansas · Sotaque de Nova York, Brooklyn
É possível, portanto, que dois sistemas sejam considerados melhores, dependendo de quem responde. A pergunta passa a ser “melhor para quem?”.
7. Áudio longo e streaming revelam falhas diferentes
A maioria das avaliações usa trechos curtos, fáceis de gerar, ouvir e pontuar. Mas produtos reais pedem que a voz continue, lendo um artigo, narrando um capítulo, atendendo uma chamada ou sustentando uma conversa. É aí que aparecem novos problemas.
Em áudio longo, não basta cada frase soar bem. A voz precisa manter coerência ao longo do tempo. Mudanças comuns incluem:
- Alteração da identidade do locutor
- Desvio de sotaque
- Mudança na velocidade de fala
- Inconsistência emocional entre parágrafos
O streaming adiciona outra camada. O sistema começa a reproduzir antes de gerar a resposta inteira. Em vez de esperar o parágrafo completo, o modelo produz pequenos trechos e os envia imediatamente. Isso faz o assistente parecer responsivo, porque ele começa a falar rapidamente enquanto o restante da frase ainda está sendo criado.
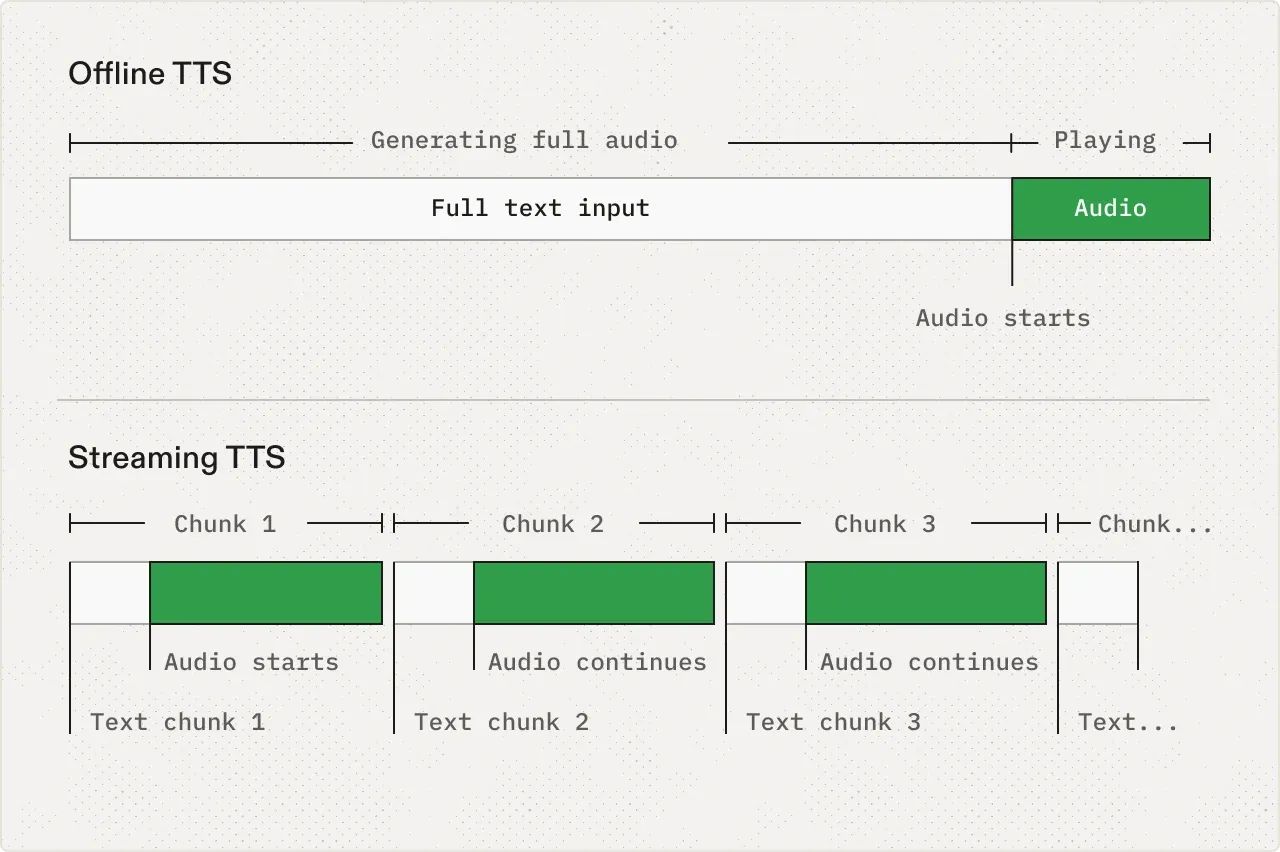
A velocidade ajuda, mas exige um compromisso. Como o modelo começa antes de saber exatamente o que vem depois, a versão em streaming pode falhar de formas ausentes no áudio offline. Por exemplo:
- Junções estranhas: cada trecho soa bem sozinho, mas a transição parece uma colagem.
- Sílabas ou palavras repetidas: a voz pode repetir na junção, como “look-look-looking” ou “is is scheduled”.
- Sons cortados: uma palavra começa ou termina abruptamente, como “stop” virando “top”.
- Interpretação escolhida cedo demais: o modelo começa com ritmo, emoção ou ênfase errados e tem dificuldade para corrigir.
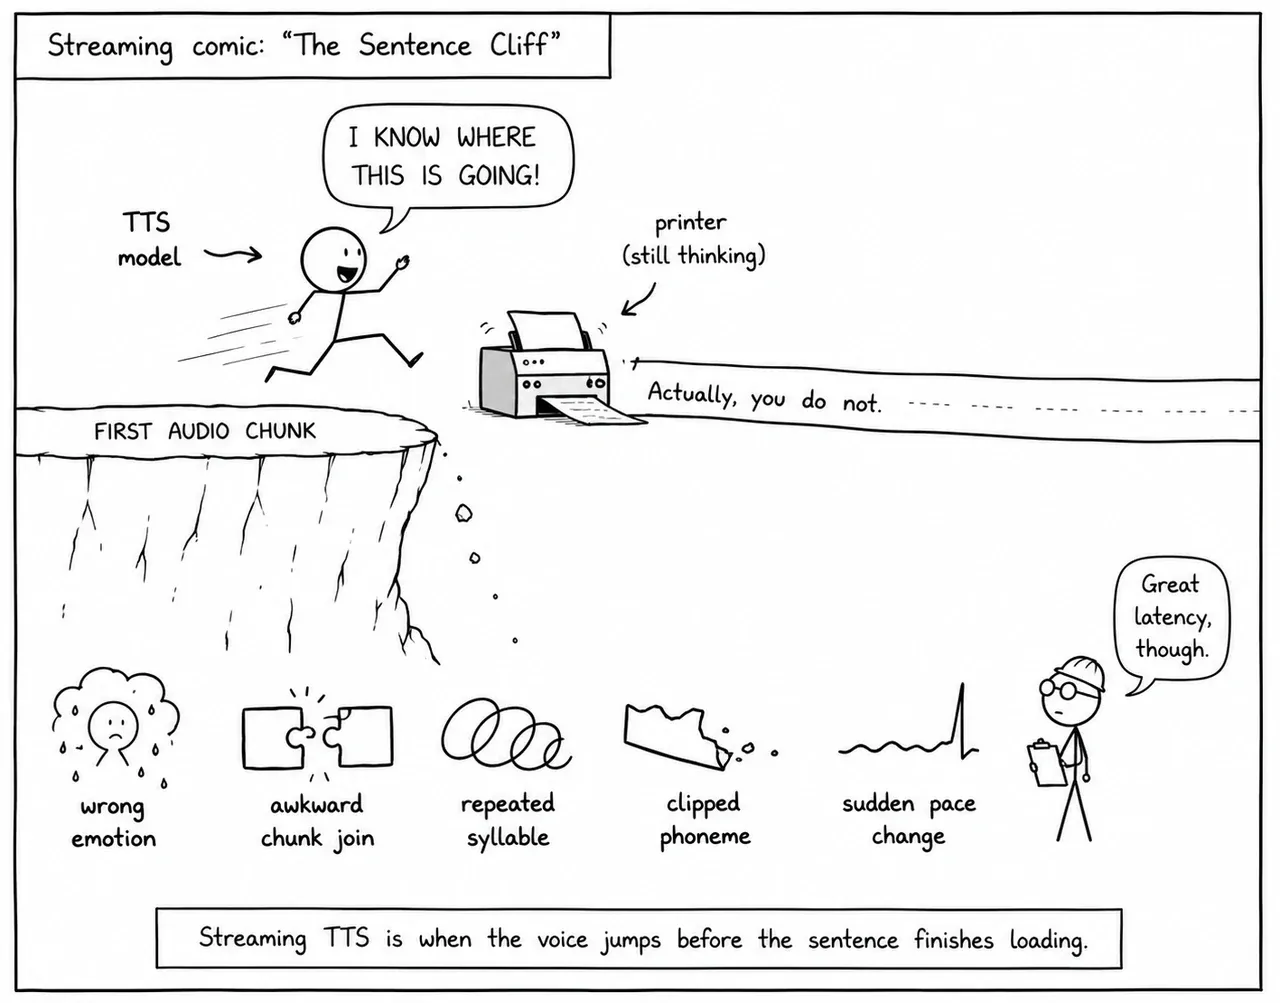
Trechos curtos podem esconder falhas que só aparecem na geração ao vivo. Testes longos verificam a consistência no tempo. Testes de streaming verificam a naturalidade quando a fala precisa começar antes de a resposta inteira ser conhecida.
Essas falhas não são aleatórias. Elas costumam aparecer quando a avaliação deixa de representar o uso real. Por isso, a próxima dimensão é o domínio. Uma voz boa em leitura genérica pode falhar diante de convenções, fórmulas, nomes ou ritmos especializados.
8. Textos especializados quebram premissas
Cada domínio, como direito, medicina, jogos, matemática, poesia, textos religiosos ou atendimento, tem expectativas diferentes:
- Formatação e normalização
- Tratamento de palavras raras
- Cadência esperada
- Restrições de exatidão e de estilo
Um modelo pode ter qualidade de ponta em um domínio e soar claramente defeituoso em outro.
The process of photosynthesis relies on a specific chemical reaction. Plants take in carbon dioxide and water to produce glucose and oxygen: 6CO₂ + 6H₂O → C₆H₁₂O₆ + 6O₂. This balanced equation shows how life sustains itself on Earth.
Observe como a cadência de H₂O falha e como o TTS não pronuncia “→”. Uma pessoa formada em química leria esse símbolo como “produz” ou “resulta em”.
O domínio é uma dimensão de variação. Idioma e localidade acrescentam outra e frequentemente afetam a avaliação de maneiras diferentes.
9. O multilinguismo traz desafios próprios
TTS multilíngue não é apenas repetir o problema do inglês N vezes. Cada idioma afeta uma parte diferente da avaliação. Você também não consegue avaliar um idioma que não fala, então ouvintes nativos deixam de ser opcionais. Veja o que falha:
As métricas automáticas deixam de funcionar sem aviso. WER herda os vieses do ASR usado no cálculo. Reconhecedores costumam ser mais fracos em sotaques não ingleses, outros sistemas de escrita e idiomas com poucos recursos. O TTS pode ser penalizado por erros do reconhecedor. Preditores de qualidade aprendidos têm o mesmo problema. Ferramentas como UTMOS foram treinadas principalmente em inglês e podem medir muito pouco fora dessa distribuição. A camada automática que permite escalar avaliações em inglês se torna menos confiável justamente onde você mais precisa ampliar a avaliação.
A palavra certa depende do idioma e muitas vezes é ambígua. O francês tem liaison, em que uma consoante final normalmente muda é pronunciada antes de uma vogal. Les amis soa como “lez-ami”, não “lay-amis”. Um uso incorreto ainda permite reconhecer as palavras, mas soa não nativo.
Liaison
O japonês é mais difícil. O kanji muitas vezes não determina a pronúncia, especialmente em nomes. 上手, por exemplo, admite jōzu, uwate e kamite. Sem contexto, o modelo pode escolher uma leitura plausível, mas errada.
jōzu
田中さんは日本語が上手です。
Tanaka-san wa nihongo ga jōzu desu.
Tanaka-san fala japonês bem.
uwate
交渉では相手の方が一枚上手だった。
Kōshō de wa aite no hō ga ichimai uwate datta.
Na negociação, o outro lado tinha vantagem.
kamite
役者は上手から登場した。
Yakusha wa kamite kara tōjō shita.
O ator entrou pela direita do palco.
Armadilhas semelhantes aparecem em todo lugar, como tons em mandarim, em que o tom errado muda a palavra, vogais curtas não escritas em árabe e supressão do schwa em hindi. Avaliá-las corretamente exige conhecimento nativo.
Idioma certo, sotaque errado. Um modelo pode produzir fala fluida e inteligível na localidade errada, como palavras do francês canadense com entonação parisiense ou uma voz do espanhol europeu que adota pronúncia mexicana no meio do áudio.
Je remarque que votre facture de cette fin de semaine comprend des frais d’utilisation de données pour votre cellulaire.
Francês canadense, esperado
Francês da França, inesperado
Esses exemplos passariam em testes de inteligibilidade e expressividade, mas ainda estariam errados. Há também a falha inversa em vozes entre idiomas. A pronúncia de palavras inglesas por uma pessoa que fala hindi deve preservar seu sotaque indiano. Corrigi-la para o inglês americano geral é um erro, não uma melhoria. Avaliações monolíngues não enxergam essa dimensão inteira.
Um número esconde a diferença. As falhas se concentram em dimensões distintas por idioma, como prosódia, pronúncia ou normalização local. Uma nota multilíngue agregada dilui justamente o sinal que orientaria uma ação. Dizer que um modelo é melhor em vários idiomas só faz sentido por localidade e dimensão.
A avaliação multilíngue leva a uma visão de qualidade com participação de falantes nativos, separada por localidade, tipo de falha e expectativas relevantes do produto, em vez de uma nota global única.
TTS tem mais de uma dimensão
Avaliar TTS é difícil porque bom não significa uma única coisa. Uma voz de audiolivro, uma de navegação e um agente de atendimento não devem ser otimizados exatamente da mesma forma.
Na Cartesia, priorizamos a fala conversacional, com agentes, assistentes interativos e outros usos em tempo real que precisam responder rápido e soar naturais. Um belo áudio offline não basta. A voz precisa funcionar em uma conversa ao vivo, em escala empresarial, para que nossos clientes obtenham os resultados esperados.
Por isso, otimizamos para:
Baixa latência
Pausas desconfortáveis fazem a conversa parecer interrompida.
Clareza
Usuários precisam entender nomes, números, endereços e códigos na primeira vez.
Expressão natural e controlada
A voz deve parecer envolvida sem soar teatral.
Exatidão contextual
O modelo precisa dizer a coisa certa da forma adequada à situação.
Consistência
A mesma voz deve se manter estável durante a chamada.
Estabilidade em streaming
A fala em tempo real não deve ter junções estranhas, repetições ou sons cortados.
Defina a experiência de produto que deseja e crie avaliações multidimensionais para verificar se o modelo realmente a entrega. Para nós, isso significa otimizar a fala para conversas em tempo real rápidas, claras e naturais.