
La plupart de nos échanges avec les systèmes numériques passent encore par du texte saisi dans des champs ou des gestes sur un écran. Cela fonctionne, mais ne se fait pas sans effort. La voix peut rendre ces échanges plus rapides, plus naturels et plus proches de la manière dont les humains communiquent déjà. Si nous la faisons bien fonctionner, nous pouvons créer une façon plus interactive d’apprendre, d’obtenir de l’aide, de passer d’une langue à l’autre et d’accomplir des tâches plus facilement.
Dans une interaction vocale, la parole générée devient l’expérience elle-même. De petites différences d’interprétation peuvent rendre l’échange utile, naturel ou défaillant. C’est ce qui fait de la synthèse vocale un composant si important : elle transforme le texte en parole et façonne le ressenti de toute l’interaction. Mais une même voix ne convient pas à toutes les situations.
Lorsqu’une personne juge « bon » un audio généré par un modèle TTS, elle peut désigner une ou plusieurs qualités :
Exactitude
Chaque mot est-il prononcé correctement ?
Qualité audio
L'audio est-il exempt de parasites, de bruit de fond et de distorsion ?
Exactitude en contexte
Les noms, nombres et mots ambigus sont-ils bien interprétés dans leur contexte ?
Naturel
La voix paraît-elle humaine ?
Fiabilité
La qualité résiste-t-elle aux variations de casse, abréviations et changements de langue ?
Cette multiplicité rend l’évaluation difficile. À mesure que les modèles progressent, on passe des défauts évidents, comme les mots mal prononcés, l’audio brouillé ou le bruit de fond, à des aspects plus subtils. Cet article parcourt les problèmes qui reviennent lorsque nous tentons de répondre à une question trompeusement simple :
Ce modèle TTS est-il bon ?
1. La synthèse vocale, un problème à sorties multiples
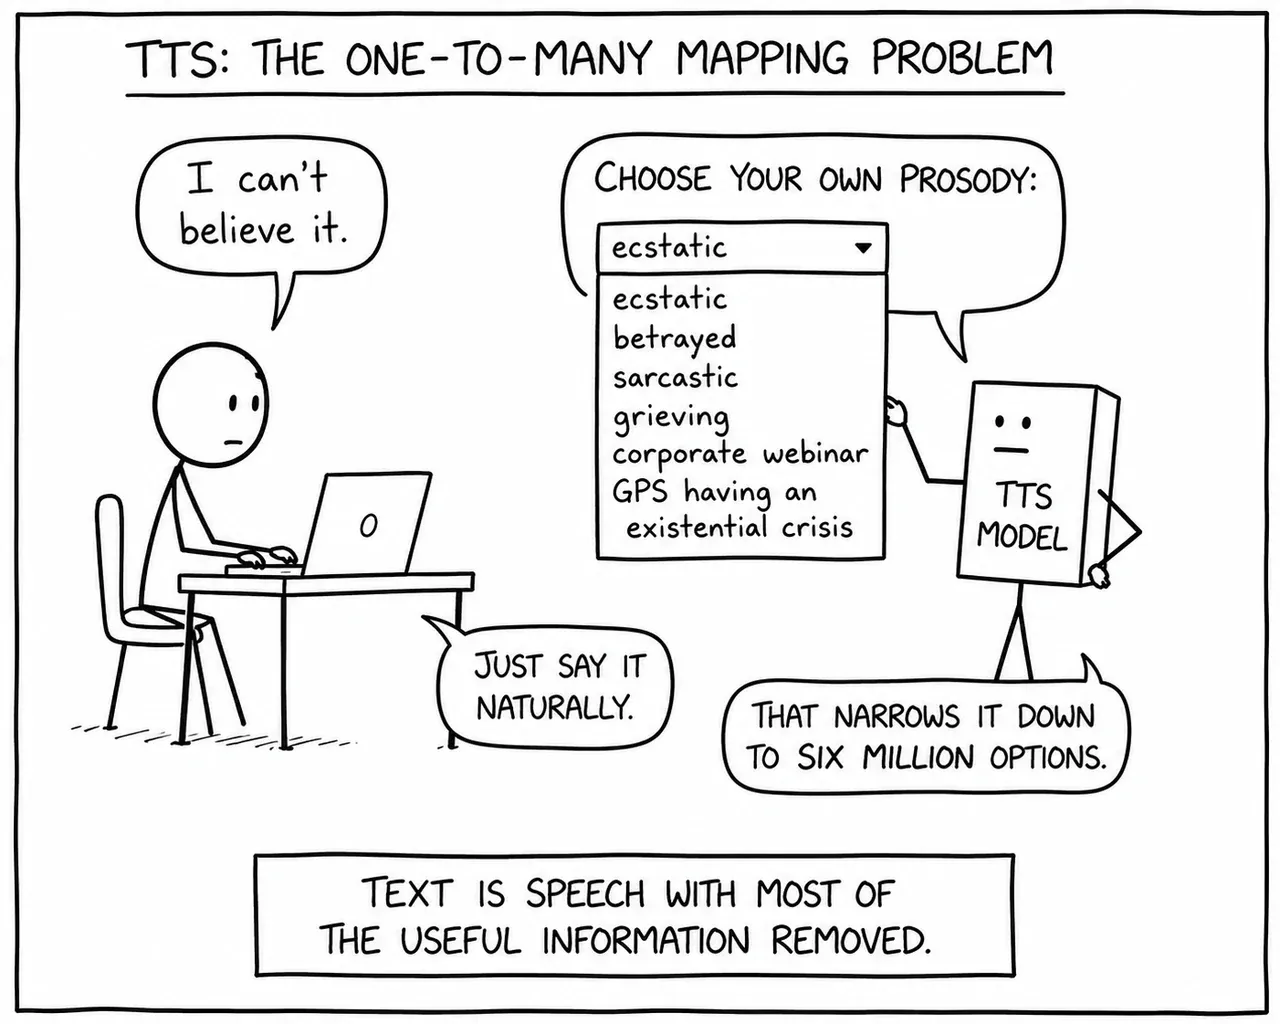
Un modèle TTS moderne ne se contente pas d’associer texte et audio. Il doit décider comment parler.
À un texte correspondent une infinité de lectures possibles, selon le locuteur, l’émotion, le rythme, l’accentuation et le contexte.
Par exemple, « Je n’arrive pas à y croire » peut convenir à quatre contextes très différents :
- Enthousiasme : une personne vient d’apprendre une bonne nouvelle inattendue.
- Colère : elle réagit à une trahison frustrante.
- Tristesse : elle essaie d’accepter une déception douloureuse.
- Sarcasme : elle fait semblant d’être impressionnée, mais pense le contraire.
Enthousiasme
Colère
Tristesse
Sarcasme
Inversez les contextes. Si l’audio enthousiaste était joué dans la situation de colère, ou le sarcastique dans la situation triste, tous les mots resteraient corrects, mais la voix semblerait inadaptée.
Voici un autre exemple de texte identique dans des contextes différents. Les extraits et leurs transcriptions conservent leur langue d’origine.
Tomorrow is the big day. There’s no changing it now.
Extrait 1
Extrait 2
Le premier extrait semble enthousiaste, comme si la personne attendait avec impatience un grand événement. Le second paraît plus nerveux ou inquiet, comme si elle anticipait une situation stressante, par exemple un examen difficile.
Cette variabilité rend la synthèse vocale plus difficile qu’une simple conversion de mots en sons. Un bon système doit choisir la prononciation de chaque mot, les pauses, les mots à accentuer, la vitesse et l’émotion de la voix. Le texte seul ne donne souvent pas assez d’informations. Le système peut donc avoir besoin de contexte supplémentaire ou de consignes sur le style souhaité.
Avant ces choix subtils, l’évaluation commence généralement par une question élémentaire : le modèle a-t-il prononcé les mots prévus ?
2. Dire les bons mots n’est que la première couche
Le WER, taux d’erreur sur les mots, est l’une des mesures les plus courantes pour les modèles TTS. On synthétise un texte, on transcrit l’audio obtenu avec un modèle de reconnaissance vocale automatique (ASR), puis on compare la transcription au texte d’entrée.
Examinons quelques exemples.
I can’t stop smiling, everything feels brighter, lighter, warmer, and somehow, after all the waiting, all the hoping, and all the uncertainty, this moment feels even better than I imagined.
Extrait 1
Extrait 2
Les deux extraits prononcent tous les mots correctement et ont le même WER, mais la plupart des personnes préféreront naturellement le second.
Le WER peut donc indiquer une direction utile. Mais une fois l’intelligibilité largement maîtrisée, les écarts se noient dans le bruit.
- Le WER sature : comme ci-dessus, deux modèles peuvent présenter une différence sensible de qualité perçue avec un écart de WER négligeable, surtout sur des jeux de test propres de lecture à voix haute.
- Il dépend de l’ASR : sa fiabilité dépend du système de reconnaissance utilisé. Si celui-ci est moins bon sur certains accents, langues, extraits bruyants, paroles expressives ou termes spécialisés, le TTS peut être pénalisé pour des erreurs de l’ASR plutôt que pour des erreurs de synthèse.
- À l’inverse, un ASR performant peut parfois corriger ou déduire une parole peu claire, donnant à un extrait défectueux un meilleur score que ce qu’entendent les humains.
Le WER est nécessaire dans beaucoup d’usages, notamment pour les données alphanumériques qui ne sont pas des mots. Il suffit cependant rarement à évaluer des agents vocaux d’entreprise.
3. L’exactitude en contexte est un autre défi
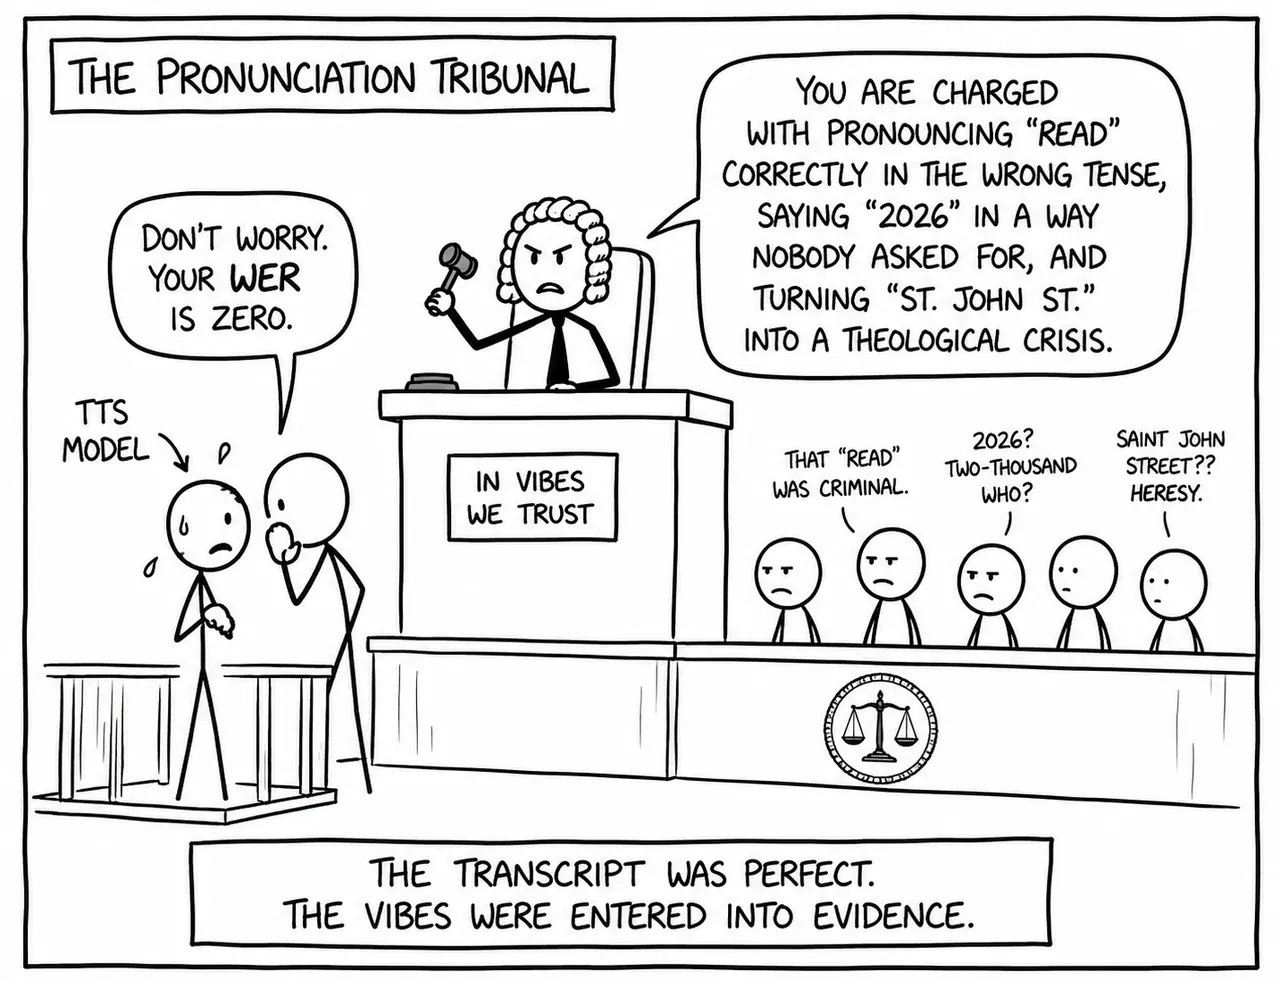
Pour définir certaines erreurs, il faut d’abord lever une ambiguïté sémantique :
- « read » en anglais, au présent ou au passé ;
- « lead », le métal ou le verbe ;
- « Polish », la nationalité, ou « polish », le verbe ;
- « bass », le poisson ou l’instrument ;
- « live », le verbe ou l’adjectif ;
- les années comme « 2026 », lues en anglais « twenty-twenty-six » ou « two thousand twenty-six ».
I had to wind the old clock before the wind picked up outside.
Les noms propres compliquent encore les choses. Les noms de personnes, lieux, produits, entreprises, médicaments et termes fictifs n’ont souvent pas de prononciation de référence. Même les humains ne sont pas toujours d’accord, surtout d’une langue à l’autre.
Une bonne évaluation doit détecter une mauvaise interprétation même si la voix reste fluide.
4. La normalisation du texte demande sa propre évaluation
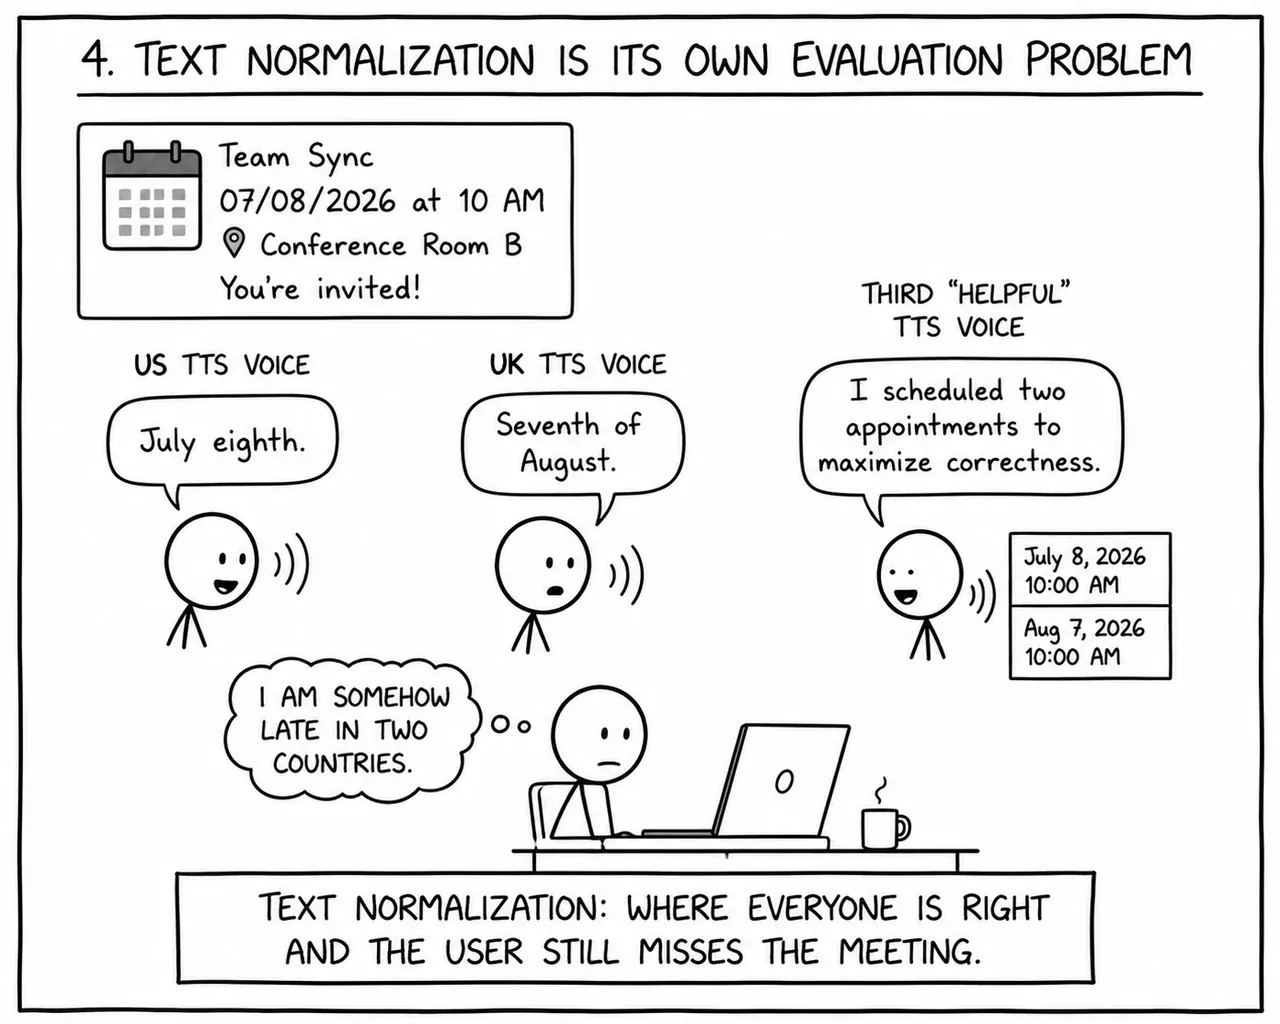
Le contexte ne compte pas seulement pour la prononciation. Avant de prononcer quoi que ce soit, le modèle doit souvent décider comment développer le texte écrit à l’oral.
Beaucoup d’entrées sont ambiguës :
- « $1.05 », lu en anglais « one oh five » ou « one dollar and five cents » ;
- « 3/4 », « three quarters » ou « three-fourths » ;
- « IV », quatre ou les lettres I-V ;
- « St. », rue ou saint ;
- « No. 5 », numéro cinq ou « no. five ».
Les dates selon les régions donnent un exemple parlant. Pour le texte suivant, l’anglais américain attend le 8 juillet, tandis que l’anglais britannique attend le 7 août !
I’d like to schedule an appointment for 07/08/2026 at 10 AM. Could you confirm if that time is available?
Variante américaine
Variante britannique
Plusieurs normalisations peuvent être correctes selon le contexte. Les transcriptions de référence encodent souvent un choix différent de celui voulu pour votre produit. Si vous ne distinguez pas préférence de normalisation et erreur du modèle, vos scores deviennent incohérents.
5. Les scores automatiques de qualité sont utiles, mais incomplets
La fidélité au texte n’est que le minimum. Une fois les mots corrects, l’écart de qualité restant concerne généralement la prosodie, l’expressivité, le style et la stabilité, qui rendent la parole naturelle, adaptée et utilisable.
Les prédicteurs automatiques de qualité tentent de mesurer ces dimensions à grande échelle. DNSMOS, NISQA et UTMOS écoutent les extraits générés et attribuent des scores. Ils sont utiles pour repérer des régressions sur des milliers d’échantillons.
Ces scores restent toutefois des indicateurs indirects. Ils ne demandent pas vraiment « Cet extrait convient-il à cette situation ? », mais « Ressemble-t-il aux audios que j’ai appris à noter ? »
Cette distinction compte, car les défaillances sont souvent peu évidentes :
- Décalage de domaine : un prédicteur peut être fiable sur la parole de son entraînement et ne plus l’être dans un autre environnement.
- Par exemple, UTMOSv2 a été conçu pour prédire le MOS de naturel d’une parole synthétique de haute qualité, principalement en anglais. Ce n’est pas une mesure universelle pour les codecs, la parole bruitée, le multilingue, le chant ou l’audio conversationnel.
- Dérive de l’étalonnage : un score qui distinguait d’anciens modèles peut perdre son sens quand les nouveaux échouent de façon plus subtile. Les prédicteurs doivent alors eux aussi être réentraînés pour rester pertinents.
- Angles morts : le prédicteur peut détecter le bruit ou la distorsion mais manquer une émotion inadaptée, un rythme peu naturel, des défauts de diffusion ou une dérive progressive de la voix.
- Dans cette étude des prédicteurs automatiques de MOS, une même parole a été générée avec de plus en plus d’erreurs d’accent tonal japonais. Les humains abaissent les notes de 1,84 point de MOS. Aucun modèle automatique ne varie de plus de 0,1. Certains notent même légèrement mieux la parole très dégradée.
| Aucune (référence) | Faible (échange 10-20%) | Élevée (échange 80-90%) | |
|---|---|---|---|
| MOS humain | 4.00 ± 0.07 | 3.19 ± 0.09 | 2.16 ± 0.09 |
| UTMOS | 3.44 ± 0.12 | 3.43 ± 0.11 | 3.47 ± 0.11 |
| UTMOSv2 | 3.56 ± 0.08 | 3.62 ± 0.06 | 3.61 ± 0.08 |
| NISQA | 3.81 ± 0.16 | 3.74 ± 0.15 | 3.84 ± 0.16 |
| DNSMOS | 3.82 ± 0.05 | 3.81 ± 0.06 | 3.83 ± 0.05 |
Ces scores repèrent donc utilement les régressions évidentes à grande échelle, mais ne remplacent pas une compréhension de ce qui rend un extrait bon.
À ce stade, il faut souvent passer aux évaluations humaines, qui présentent d’autres pièges.
6. Les évaluations humaines sont-elles la référence absolue ?
Les tests d’écoute humains restent la référence, mais leurs scores ne sont pas une mesure stable. Les jugements varient selon le parcours de l’auditeur, sa langue maternelle, la formulation des consignes, les références du jeu, l’environnement de lecture, casque ou haut-parleurs, la normalisation du volume, la durée de la session et la fatigue, entre autres.
Deux formats courants sont les notes MOS, moyenne d’opinion, et les notes de préférence. Dans un test MOS, chaque extrait est évalué indépendamment, souvent sur une échelle de 1 à 5 pour la qualité ou le naturel. Dans un test de préférence, les auditeurs comparent plusieurs extraits et choisissent leur préféré. Le MOS ressemble à une note absolue, tandis que la préférence est directement comparative. Les deux dépendent cependant des consignes, des auditeurs et de la présentation. Quel que soit le format, les évaluations humaines ont les limites suivantes.
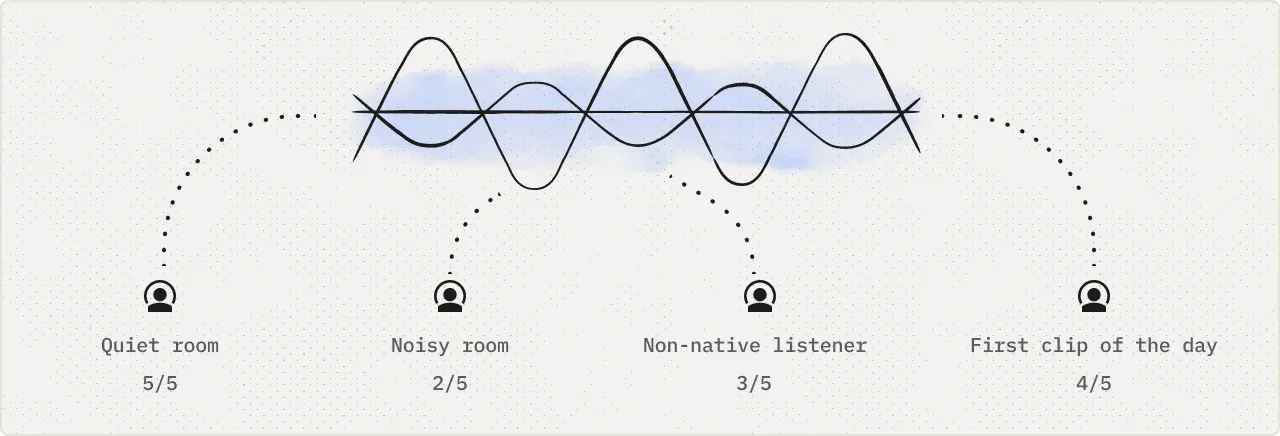
6.1 Les réponses dépendent du contexte
Les auditeurs n’écoutent pas hors de tout contexte. Même avec une phrase identique, chacun peut imaginer une situation différente. « C’est super » peut paraître sincère dans un contexte, sarcastique dans un autre, ou plat et confus dans un troisième.
Le même audio peut donc recevoir des notes différentes selon ce que l’auditeur pense que la voix doit accomplir. Si la tâche ne précise pas le scénario visé, chacun juge selon ses propres attentes plutôt qu’un objectif commun.
6.2 Les comparaisons sont sensibles à la présentation
Des choix apparemment insignifiants peuvent dominer les résultats :
- Normalisation du volume et des crêtes : un échantillon plus fort peut paraître plus clair, plus assuré ou de meilleure qualité sans que son modèle soit meilleur.
- Fréquence d’échantillonnage, codec et rééchantillonnage : les artefacts de compression ou de conversion peuvent dégrader un système pour des raisons étrangères à la synthèse.
- Texte du prompt, contexte de l’interface et extraits voisins : le texte et la présentation orientent les attentes et peuvent changer ce que les auditeurs remarquent ou préfèrent.
- Découpe des silences, respirations et délais initiaux : de petites modifications peuvent rendre un extrait naturel, maladroit ou réactif.
Sans maîtrise de ces éléments, vous risquez d’évaluer la chaîne audio plutôt que le modèle.
6.3 La dérive existe, même si le modèle reste stable
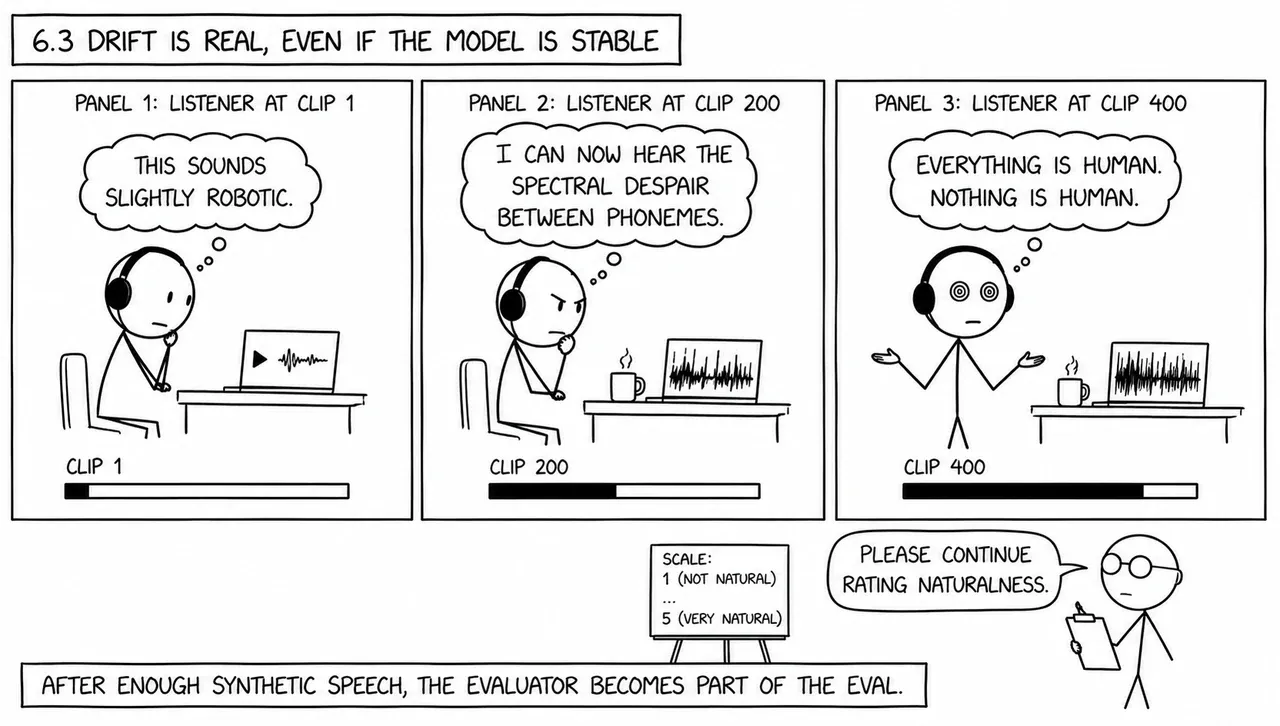
Les auditeurs changent eux aussi au fil du temps :
- Adaptation : après de nombreux extraits synthétiques, ils recalibrent leur attention, devenant plus sensibles aux artefacts ou plus indulgents.
- Fatigue : l’annotation audio est éprouvante et la qualité du jugement baisse quand les sessions s’allongent.
- Variation d’environnement : ce qui saute aux oreilles au casque peut disparaître sur les haut-parleurs d’un téléphone, et inversement.
Considérer le MOS humain comme une vérité immuable finit par coûter cher.
6.4 Les préférences et les goûts varient
Les gens ne veulent pas tous la même chose. Même entre auditeurs attentifs, les préférences diffèrent selon :
- L’identité et le timbre : certains préfèrent des voix claires et nettes, d’autres des voix plus chaudes, graves ou texturées.
- Le débit : un rythme rapide paraît efficace à l’un, précipité ou stressant à l’autre.
- L’accent et le dialecte : une voix paraît familière et naturelle à un public, mais distrayante ou inadaptée à un autre.
- L’intensité émotionnelle : certains aiment une interprétation expressive que d’autres trouvent excessive ou fatigante.
- Les indices d’âge et de personnalité : une même voix peut évoquer plusieurs personnalités, plus ou moins adaptées à chaque produit.
Please call Stella. Ask her to bring these things with her from the store: Six spoons of fresh snow peas, five thick slabs of blue cheese, and maybe a snack for her brother Bob. We also need a small plastic snake and a big toy frog for the kids. She can scoop these things into three red bags, and we will go meet her Wednesday at the train station.
Accent du Sud des États-Unis
Accent new-yorkais
Enregistrements humains du Speech Accent Archive de l'université George Mason
Accent du Sud, Plantersville, Arkansas · Accent new-yorkais, Brooklyn
Il est donc tout à fait possible que deux systèmes soient chacun « meilleurs », selon l’auditeur interrogé. La question devient « meilleur pour qui ? »
7. Les formats longs et la diffusion en continu révèlent d’autres défaillances
La plupart des évaluations TTS utilisent de courts extraits, plus faciles à générer, écouter et noter. Mais les produits demandent souvent à la voix de continuer : lire un article, raconter un chapitre, gérer un appel d’assistance ou poursuivre une conversation. De nouveaux problèmes apparaissent alors.
Dans un audio long, chaque phrase ne doit pas seulement bien sonner. L’ensemble doit aussi rester cohérent dans le temps. Les dérives courantes concernent :
- l’identité du locuteur ;
- l’accent ;
- le débit ;
- la cohérence émotionnelle entre les paragraphes.
La diffusion en continu ajoute une couche. Le système commence à lire l’audio avant d’avoir généré toute la réponse. Au lieu d’attendre le paragraphe complet, le modèle produit de petits fragments de parole et les envoie immédiatement. Cela rend l’assistant réactif : il commence vite à parler, tandis que le reste de la phrase est encore en cours de création.
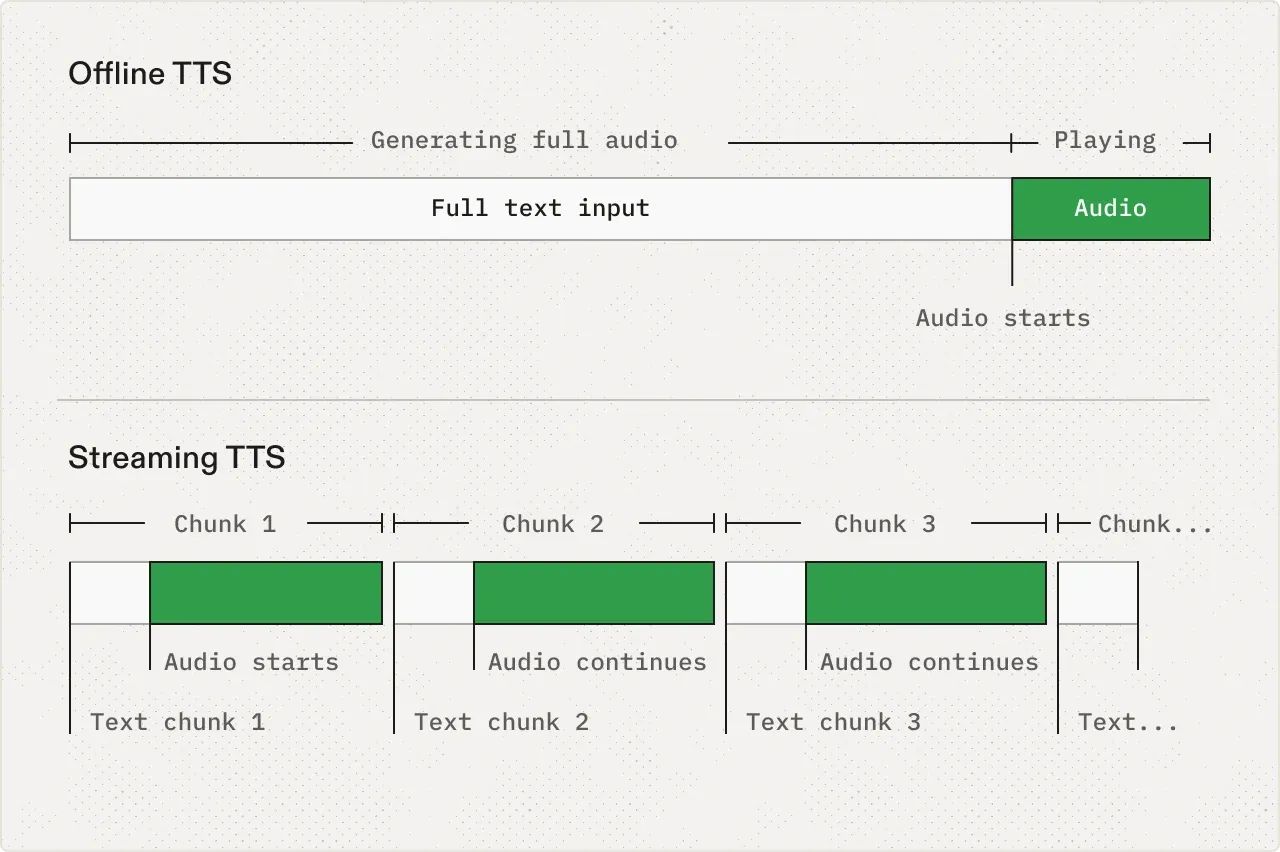
Cette vitesse est utile, mais implique un compromis. Le modèle doit parler avant de savoir exactement ce qui suit. La version en continu peut donc échouer là où un extrait généré intégralement réussit, par exemple :
- Raccords maladroits : chaque fragment paraît correct seul, mais les transitions semblent artificielles.
- Syllabes ou mots répétés : la voix se répète autour d’un raccord, comme « look-look-looking » ou « is is scheduled ».
- Sons tronqués : un mot commence ou finit trop brusquement, par exemple « stop » devient « top ».
- Interprétation choisie trop tôt : le modèle adopte un mauvais rythme, une mauvaise émotion ou une mauvaise accentuation, puis peine à se corriger.
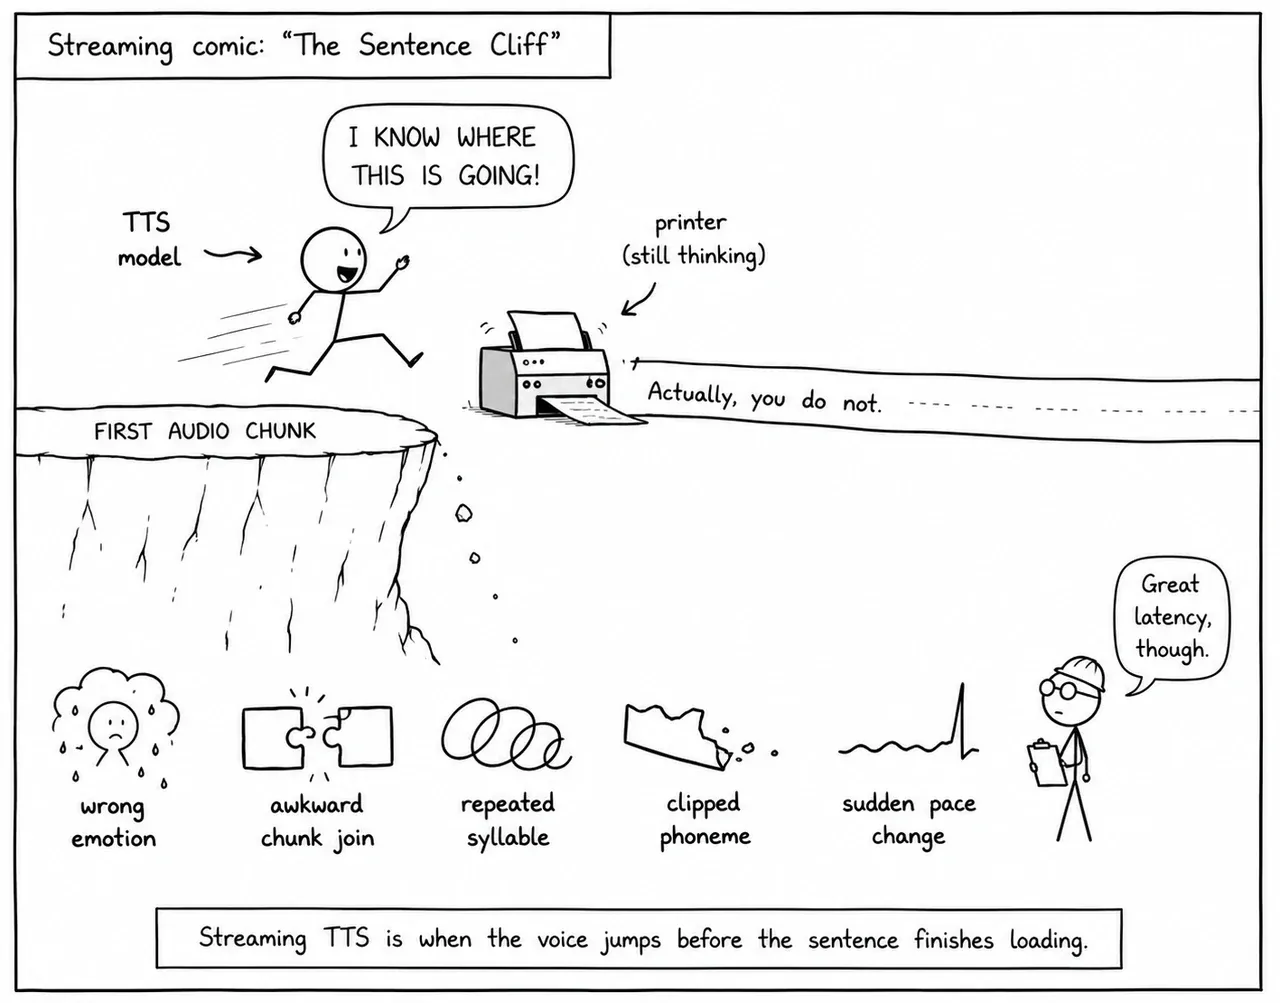
Les extraits courts peuvent donc masquer des défauts qui n’apparaissent qu’en génération directe. Les tests longs vérifient la stabilité dans le temps. Les tests en continu vérifient le naturel lorsque la voix doit démarrer vite, avant de connaître toute la réponse.
Ces échecs ne sont pas aléatoires. Ils apparaissent généralement quand l’évaluation ne correspond plus à l’usage réel du produit. Le domaine est donc la couche suivante : une voix convaincante en lecture générique peut échouer sur des conventions spécialisées, formules, noms ou attentes de rythme.
8. Les textes spécialisés remettent les hypothèses en cause
Chaque domaine, droit, médecine, jeux vidéo, mathématiques, poésie, textes religieux ou support client, a ses attentes concernant :
- la mise en forme et la normalisation ;
- le traitement des mots rares ;
- la cadence ;
- les contraintes d’exactitude et de style.
Un modèle peut atteindre les meilleures performances dans un domaine et sembler manifestement défaillant dans un autre.
The process of photosynthesis relies on a specific chemical reaction. Plants take in carbon dioxide and water to produce glucose and oxygen: 6CO₂ + 6H₂O → C₆H₁₂O₆ + 6O₂. This balanced equation shows how life sustains itself on Earth.
Remarquez le rythme incorrect de la prononciation de H₂O et l’absence de lecture du symbole « → ». Une personne formée en chimie le lirait comme « donne » ou « produit ».
Le domaine est un axe de variation. La langue et la région en ajoutent un autre, qui met souvent l’évaluation en difficulté de façons entièrement différentes.
9. Le multilingue pose des défis particuliers
La synthèse multilingue ne consiste pas à répéter N fois le problème anglais. Chaque langue met en défaut une partie différente de l’évaluation. Et on ne peut pas noter une langue que l’on ne parle pas : les auditeurs natifs deviennent indispensables. Voici ce qui échoue précisément.
Les mesures automatiques cessent discrètement de fonctionner. Le WER hérite des biais de l’ASR utilisé. Les systèmes de reconnaissance sont souvent moins bons sur les accents non anglophones, les autres écritures et les langues peu dotées en données. Le TTS est alors pénalisé pour les erreurs du système de reconnaissance. Les prédicteurs de qualité ont le même problème. UTMOS, par exemple, a surtout été entraîné sur l’anglais et peut mesurer peu de choses hors de cette distribution. La couche automatique qui permet d’évaluer l’anglais à grande échelle devient moins fiable précisément là où vous avez le plus besoin de capacité.
Le « bon mot » dépend de la langue et reste souvent ambigu. En français, la liaison fait prononcer une consonne finale normalement muette lorsque le mot suivant commence par une voyelle : les amis se prononce avec le son « z » de liaison. Une mauvaise application laisse souvent les mots reconnaissables, mais produit une prononciation manifestement non native.
Liaison
Le japonais est plus difficile : les kanji ne déterminent souvent pas la prononciation, surtout pour les noms. 上手 admet par exemple plusieurs lectures valides, jōzu, uwate ou kamite. Sans contexte, le modèle peut en choisir une plausible mais incorrecte.
jōzu
田中さんは日本語が上手です。
Tanaka-san wa nihongo ga jōzu desu.
Tanaka-san parle bien japonais.
uwate
交渉では相手の方が一枚上手だった。
Kōshō de wa aite no hō ga ichimai uwate datta.
Dans la négociation, l'autre partie avait l'avantage.
kamite
役者は上手から登場した。
Yakusha wa kamite kara tōjō shita.
L'acteur est entré par la droite de la scène.
Ce piège revient sous différentes formes : tons du mandarin, où un mauvais ton change le mot, voyelles brèves non écrites en arabe, suppression du schwa en hindi. Les évaluer correctement exige la connaissance d’un locuteur natif.
La bonne langue, le mauvais accent. Un modèle peut produire une parole fluide et parfaitement intelligible dans la mauvaise variante régionale, par exemple du vocabulaire français canadien avec une intonation parisienne, ou une voix espagnole d’Europe qui dérive vers une prononciation mexicaine au milieu d’un extrait.
Je remarque que votre facture de cette fin de semaine comprend des frais d’utilisation de données pour votre cellulaire.
Français canadien, attendu
Français de France, inattendu
Ces exemples peuvent réussir tous les tests d’intelligibilité et d’expressivité tout en restant incorrects. Le problème inverse apparaît avec les voix translingues : un locuteur hindi qui prononce des mots anglais doit garder son accent indien. Le corriger vers un accent américain standard est une erreur, pas une amélioration. C’est un axe entier d’exactitude qu’une évaluation monolingue ne voit jamais.
Un chiffre unique masque les écarts. Les erreurs se concentrent sur des dimensions différentes selon la langue : prosodie ici, prononciation ailleurs, normalisation régionale dans une troisième. Un score multilingue global efface le signal qui permettrait d’agir. « Meilleur en multilingue » n’a de sens que par région linguistique et par dimension.
L’évaluation multilingue pousse donc à abandonner le score global unique pour une approche associant des locuteurs natifs, ventilée par région, par type de défaillance et par attentes réelles du produit.
Pour conclure, la synthèse vocale a plusieurs dimensions
L’évaluation TTS est difficile parce que « bon » ne désigne pas une seule qualité. Plusieurs aspects interviennent. Une voix de livre audio, une voix de navigation et un agent de support ne doivent pas être optimisés exactement de la même façon.
Chez Cartesia, nous nous concentrons sur la parole conversationnelle : agents vocaux, assistants interactifs et autres situations en temps réel où le système doit répondre vite tout en restant naturel. Un bel extrait produit hors ligne ne suffit pas. La voix doit fonctionner dans une conversation directe à l’échelle de l’entreprise pour que nos clients obtiennent les résultats attendus de leurs agents.
C’est pourquoi nous optimisons les éléments suivants :
Faible latence
Des pauses gênantes donnent l'impression d'une conversation défaillante.
Clarté
Les utilisateurs doivent comprendre les noms, nombres, adresses et codes dès la première écoute.
Expression naturelle et maîtrisée
La voix doit paraître impliquée sans devenir théâtrale.
Exactitude contextuelle
Le modèle doit dire ce qu'il faut, de la bonne manière, selon la situation.
Cohérence
La voix du locuteur doit rester stable tout au long de l'appel.
Fiabilité en diffusion continue
La parole en temps réel doit éviter les raccords maladroits, répétitions et sons tronqués.
L’objectif est donc de définir l’expérience produit souhaitée, puis de construire des évaluations multidimensionnelles qui vérifient si le modèle la fournit réellement. Pour nous, cela signifie optimiser la parole pour des conversations en temps réel rapides, claires et naturelles.