
Seguimos interactuando con muchos sistemas digitales escribiendo en casillas o tocando pantallas. Funciona, pero no siempre resulta cómodo. La voz puede hacer que la interacción sea más rápida, natural y cercana a cómo nos comunicamos. Si funciona bien, ofrece una forma más interactiva de aprender, pedir ayuda, pasar de un idioma a otro y resolver tareas.
Cuando interactuamos por voz, el habla generada se convierte en la experiencia. Pequeñas diferencias de interpretación cambian si la interacción parece útil, natural o defectuosa. Por eso TTS es importante: convierte texto en habla y da forma a toda la interacción. Pero una voz no sirve igual para todos los usos.
Cuando alguien dice que un audio TTS es “bueno”, puede referirse a varias cosas:
Corrección
¿Se pronuncia correctamente cada palabra?
Calidad de audio
¿Está libre de interferencias, ruido de fondo y distorsión?
Corrección en contexto
¿Se interpretan correctamente nombres, números y palabras ambiguas según el contexto?
Naturalidad
¿Suena humano?
Resistencia a variaciones
¿Mantiene la calidad con variaciones de mayúsculas, abreviaturas o cambios de idioma?
Estas dimensiones complican la evaluación. A medida que mejoran los modelos, dejamos de centrarnos en errores evidentes, como palabras mal pronunciadas, audio distorsionado o ruido, y pasamos a matices. Este artículo recorre los fallos que aparecen al intentar responder una pregunta aparentemente sencilla:
¿Es bueno este modelo TTS?
1. TTS: un texto, muchas interpretaciones
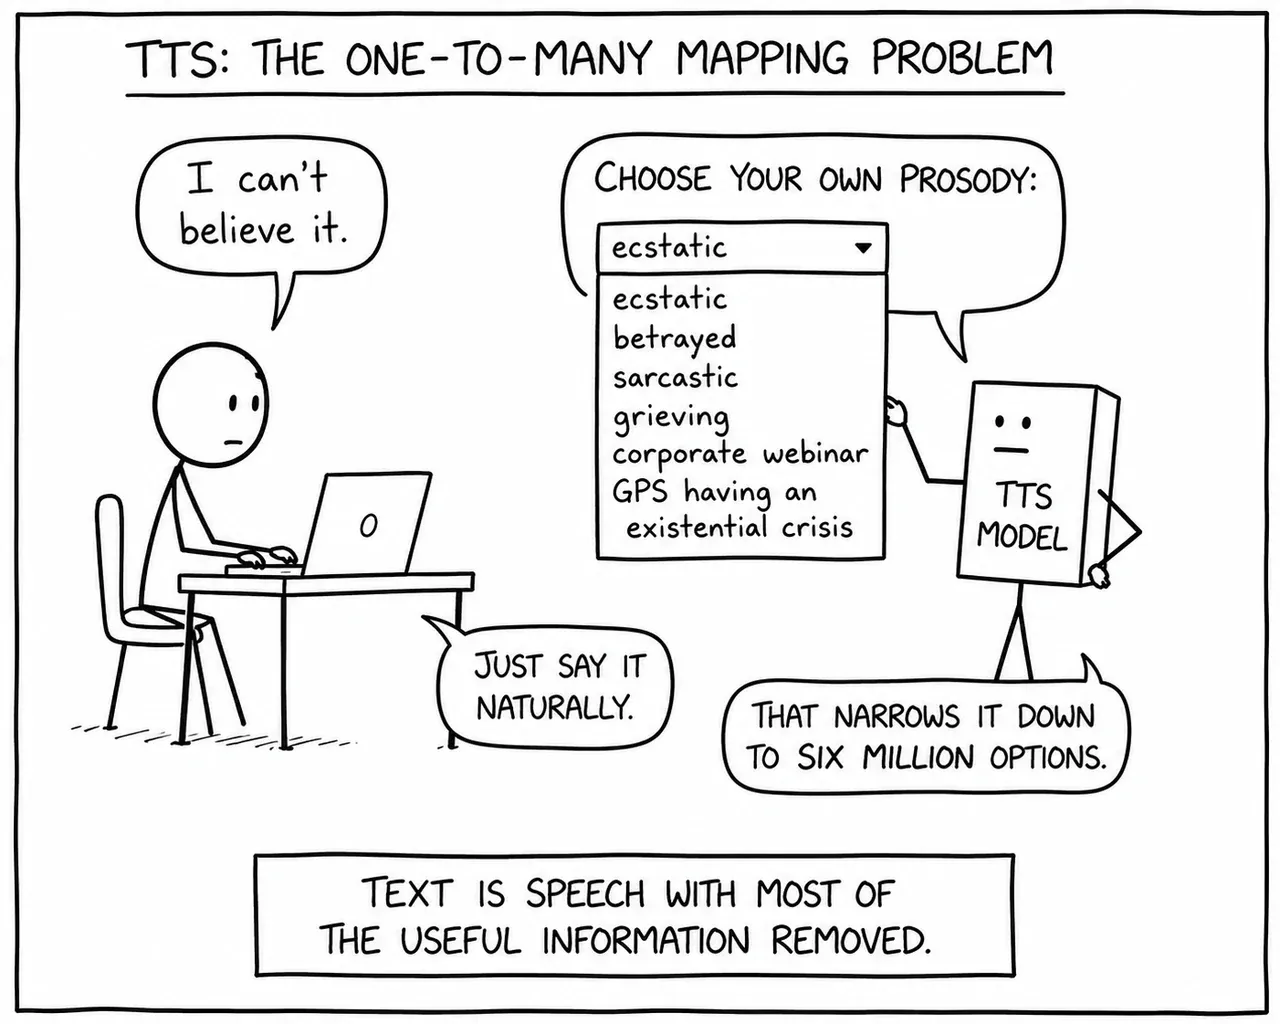
Un modelo TTS moderno hace más que convertir texto en audio. Debe decidir cómo hablar.
Hay infinitas formas de leer un texto según hablante, emoción, ritmo, énfasis y contexto.
Por ejemplo, “No me lo puedo creer” puede ser correcto en cuatro situaciones:
- Entusiasmo: alguien acaba de recibir una buena noticia inesperada.
- Enfado: alguien reacciona a una traición frustrante.
- Tristeza: alguien intenta asimilar una decepción dolorosa.
- Sarcasmo: alguien finge estar impresionado, pero quiere decir lo contrario.
Los ejemplos mantienen las grabaciones y transcripciones originales en sus respectivos idiomas.
Entusiasmo
Enfado
Tristeza
Sarcasmo
Intercambia ahora los contextos. Si el audio entusiasta sonara en la situación de enfado, o el sarcástico en la triste, todas las palabras seguirían siendo correctas, pero el habla no encajaría.
Otro ejemplo del mismo texto en contextos distintos:
Tomorrow is the big day. There’s no changing it now.
Clip 1
Clip 2
El primer audio transmite ilusión, como si la persona esperara un gran acontecimiento. El segundo suena nervioso o asustado, como ante un examen difícil.
Esta variabilidad hace que TTS sea más que convertir palabras en sonido. Un buen sistema decide pronunciación, pausas, énfasis, velocidad y emoción. A menudo el texto no aporta suficiente información y hacen falta contexto o instrucciones sobre el estilo.
Antes de llegar a esos matices, la evaluación suele empezar por algo básico: ¿dijo el modelo las palabras previstas?
2. Decir las palabras correctas es solo la primera capa
La tasa de error de palabras, WER, es una métrica habitual de TTS. Generas audio, lo transcribes con ASR y comparas la transcripción con el texto original.
Veamos ejemplos.
I can’t stop smiling, everything feels brighter, lighter, warmer, and somehow, after all the waiting, all the hoping, and all the uncertainty, this moment feels even better than I imagined.
Clip 1
Clip 2
Ambos audios dicen todas las palabras correctamente y tienen la misma WER, pero la mayoría preferiría el segundo.
WER puede orientar. Pero cuando la inteligibilidad está prácticamente resuelta, las diferencias se reducen hasta confundirse con ruido.
- WER se satura: dos modelos pueden tener diferencias claras de calidad percibida y una WER casi igual, especialmente con textos limpios y leídos.
- Depende del ASR: solo es tan fiable como el reconocedor utilizado. Si este falla con ciertos acentos, idiomas, ruido, expresividad o vocabulario especializado, penaliza al TTS por errores de reconocimiento en lugar de síntesis.
- A la inversa, un ASR potente puede corregir o inferir habla poco clara y hacer que una muestra parezca mejor de lo que suena.
WER es necesaria en muchos usos, especialmente con datos alfanuméricos que no son palabras. Pero rara vez basta para agentes empresariales.
3. La corrección en contexto es otro reto
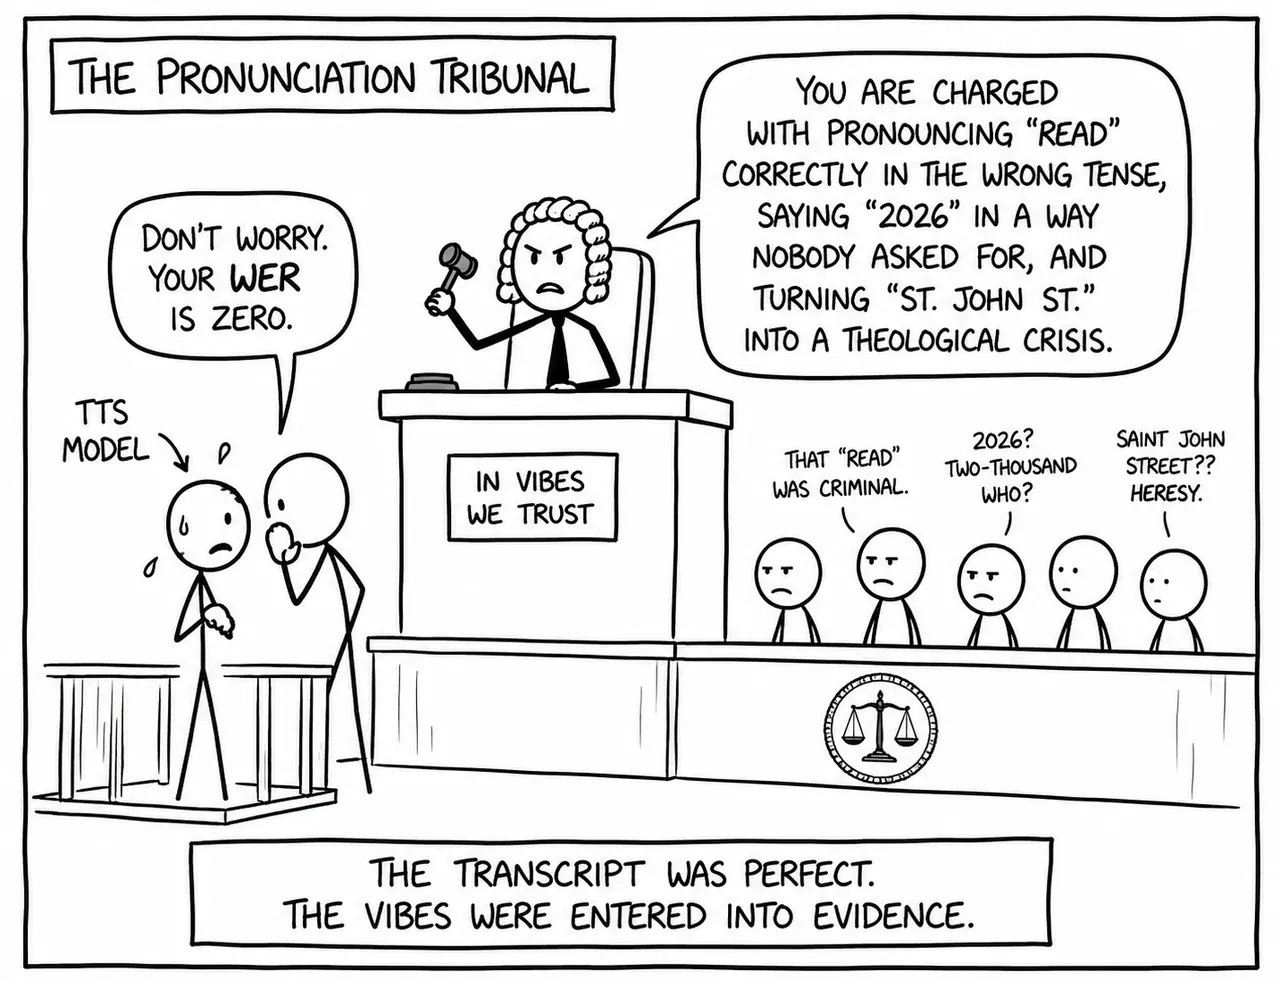
Muchos errores exigen resolver el significado antes de definir qué es correcto. En inglés:
- “read”, presente o pasado.
- “lead”, metal o verbo.
- “Polish”, nacionalidad o verbo.
- “bass”, pez o instrumento.
- “live”, verbo o adjetivo.
- Años como “2026”, que pueden leerse “twenty-twenty-six” o “two thousand twenty-six”.
I had to wind the old clock before the wind picked up outside.
Los nombres propios son aún más difíciles. Personas, lugares, productos, empresas, medicamentos y términos ficticios a menudo no tienen una pronunciación canónica. Incluso las personas discrepan, sobre todo entre idiomas.
Una buena evaluación debe detectar que el modelo eligió una interpretación incorrecta aunque suene fluido.
4. Normalizar texto requiere su propia evaluación
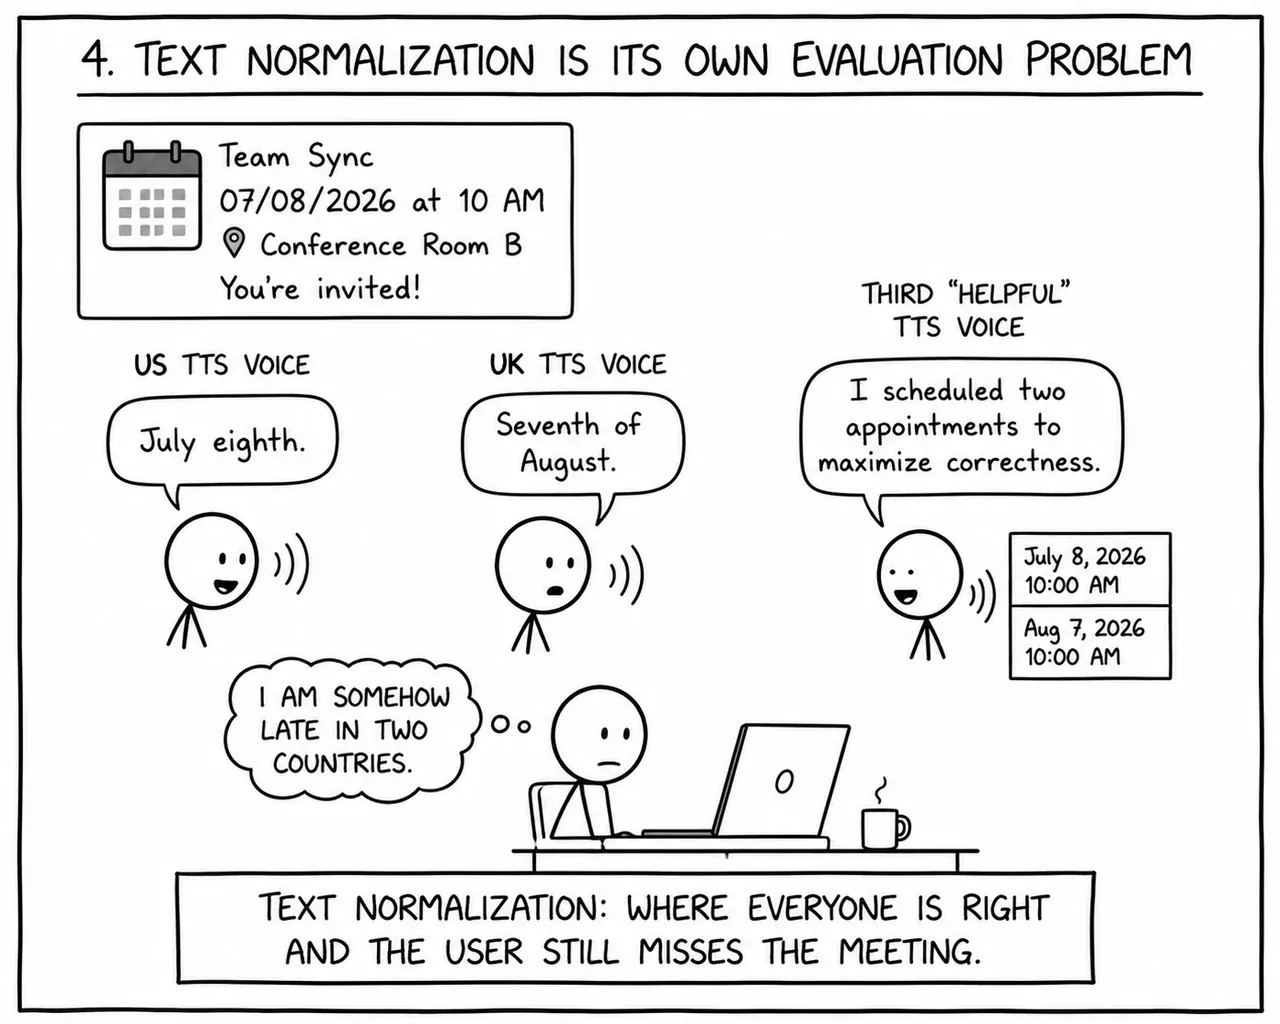
El contexto importa antes de pronunciar. El modelo suele tener que decidir cómo convertir la forma escrita en habla.
Muchas entradas son ambiguas. En inglés:
- “$1.05”: “one oh five” o “one dollar and five cents”.
- “3/4”: “three quarters” o “three-fourths”.
- “IV”: cuatro o las letras I y V.
- “St.”: calle o santo.
- “No. 5”: número cinco o “no. five”.
Las fechas son un buen ejemplo. Para el siguiente texto, el inglés estadounidense espera el 8 de julio y el británico, el 7 de agosto.
I’d like to schedule an appointment for 07/08/2026 at 10 AM. Could you confirm if that time is available?
Variante estadounidense
Variante británica
Varias normalizaciones pueden ser correctas según el contexto. Las referencias suelen recoger una opción distinta de la que necesita tu producto. Si no separas preferencia de normalización y error del modelo, las puntuaciones pierden coherencia.
5. Las puntuaciones automáticas ayudan, pero no bastan
Decir las palabras correctas es el mínimo. Después, las diferencias suelen estar en prosodia, expresividad, estilo y estabilidad, que hacen que el habla sea natural, adecuada y utilizable.
Los predictores automáticos intentan medirlo a escala. DNSMOS, NISQA y UTMOS escuchan clips y asignan puntuaciones, útiles para detectar regresiones en miles de muestras.
Pero siguen siendo aproximaciones. No preguntan realmente “¿funciona este clip en esta situación?”, sino “¿se parece al audio que aprendí a puntuar?”.
La diferencia importa porque los fallos no siempre son evidentes:
- Desajuste de ámbito: un predictor puede funcionar con el habla de entrenamiento y fallar en otro contexto.
- UTMOSv2 se desarrolló para predecir MOS de naturalidad en habla sintética de alta calidad, predominantemente inglesa. No es una métrica universal para códecs, ruido, multilingüismo, canto o conversación.
- Pérdida de calibración: una puntuación que distinguía modelos antiguos puede dejar de ser útil ante fallos más sutiles. Los predictores también pueden necesitar reentrenamiento.
- Puntos ciegos: detectan ruido o distorsión, pero pueden omitir emoción inadecuada, ritmo extraño, fallos de streaming o cambios graduales de voz.
- En este estudio, se generó la misma habla con cantidades crecientes de acento tonal japonés incorrecto. Las personas redujeron la puntuación en 1,84 puntos MOS. Todos los modelos automáticos variaron menos de 0,1. Algunos puntuaron ligeramente mejor el habla más alterada.
| Ninguno, referencia | Bajo, cambio del 10-20 % | Alto, cambio del 80-90 % | |
|---|---|---|---|
| MOS humano | 4.00 ± 0.07 | 3.19 ± 0.09 | 2.16 ± 0.09 |
| UTMOS | 3.44 ± 0.12 | 3.43 ± 0.11 | 3.47 ± 0.11 |
| UTMOSv2 | 3.56 ± 0.08 | 3.62 ± 0.06 | 3.61 ± 0.08 |
| NISQA | 3.81 ± 0.16 | 3.74 ± 0.15 | 3.84 ± 0.16 |
| DNSMOS | 3.82 ± 0.05 | 3.81 ± 0.06 | 3.83 ± 0.05 |
Estas puntuaciones detectan regresiones evidentes a escala, pero no sustituyen comprender qué hace bueno un clip.
A menudo hay que pasar a evaluaciones humanas, que presentan otros problemas.
6. Evaluaciones humanas: ¿la referencia definitiva?
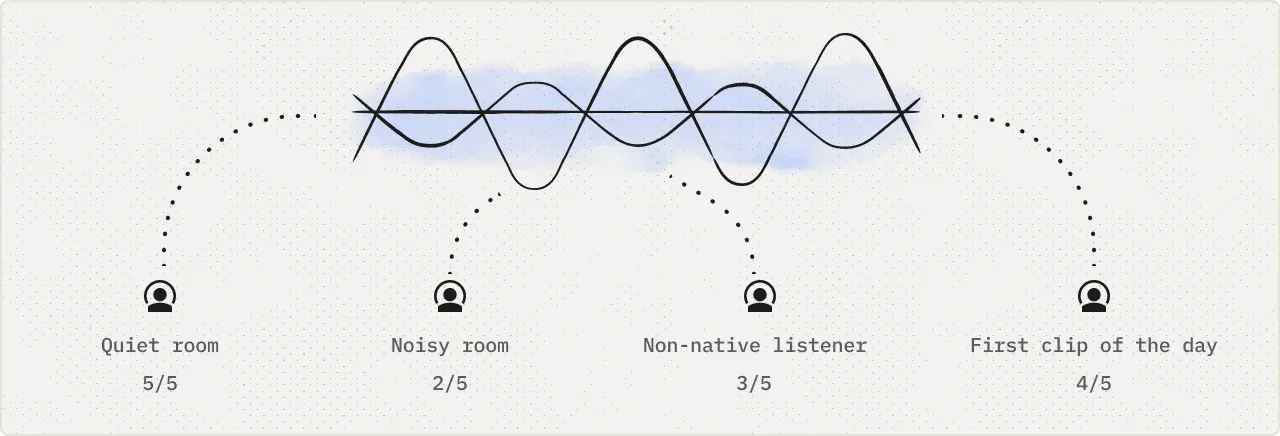
Las pruebas de escucha siguen siendo la referencia, pero sus puntuaciones no son estables. Influyen el origen del oyente, si es nativo, las instrucciones, los ejemplos de referencia, los auriculares o altavoces, el volumen normalizado y la fatiga, entre otros factores.
Dos formatos habituales son MOS y preferencias. En MOS, se puntúa cada clip por separado, normalmente del 1 al 5 en calidad o naturalidad. En preferencias, se comparan dos o más clips y se elige. MOS parece absoluto y la preferencia es comparativa, pero ambos dependen de las instrucciones, los oyentes y la presentación. Comparten estos problemas:
6.1 Las respuestas dependen del contexto
Los oyentes imaginan situaciones distintas incluso al oír la misma frase. “Eso está muy bien” puede sonar sincero, sarcástico, plano o confuso.
El mismo audio recibe distintas puntuaciones según lo que se cree que debería hacer la voz. Sin definir el escenario, cada persona juzga con sus expectativas privadas y no con un objetivo compartido.
6.2 Las comparaciones dependen de la presentación
Decisiones aparentemente pequeñas pueden dominar los resultados:
- Normalización de volumen o picos: una muestra más fuerte puede parecer más clara, segura o de mayor calidad sin que el modelo sea mejor.
- Frecuencia de muestreo, códec y remuestreo: sus artefactos pueden empeorar un sistema por causas ajenas a la síntesis.
- Texto, interfaz y muestras cercanas: enmarcan las expectativas y cambian lo que se nota o prefiere.
- Recorte de silencios, respiraciones o latencia inicial: pequeños cambios alteran la naturalidad y la sensación de respuesta.
Sin controlar estas variables, puedes estar evaluando el procesamiento de audio en vez del modelo.
6.3 El criterio cambia aunque el modelo sea estable
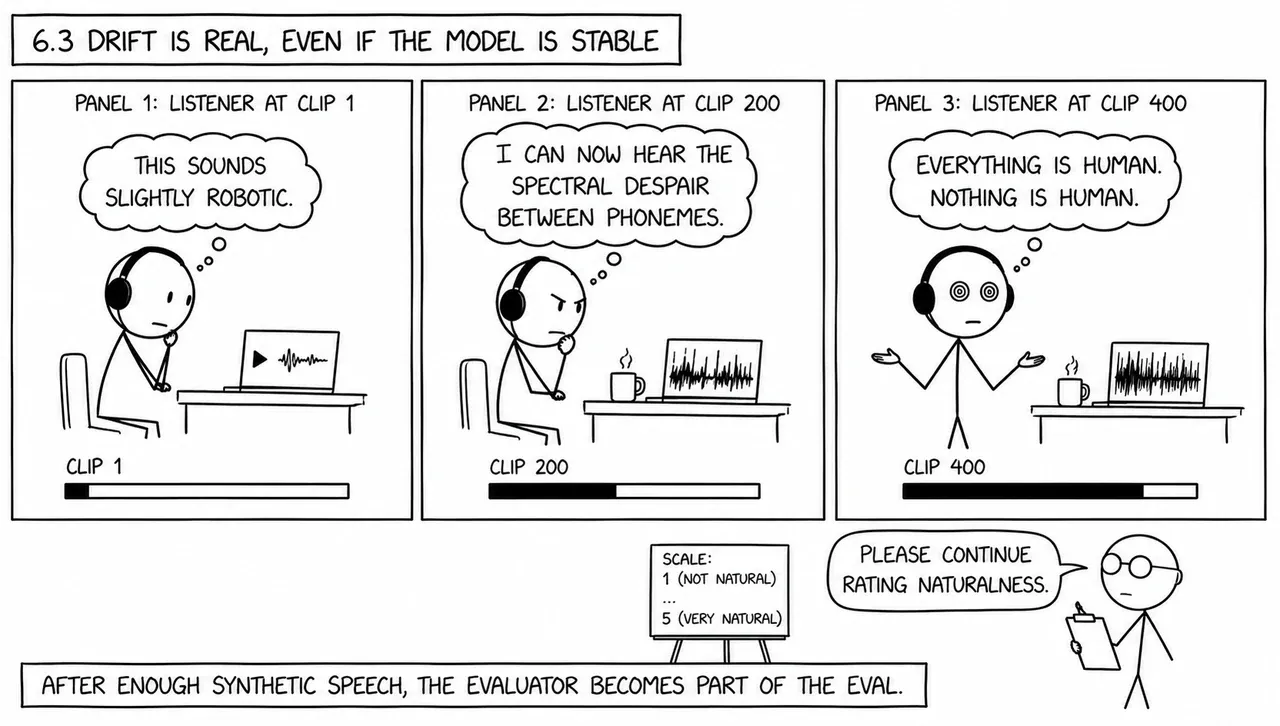
Los oyentes también cambian:
- Adaptación: tras muchos clips sintéticos, pueden ser más sensibles a defectos o más tolerantes.
- Fatiga: etiquetar audio cansa y las sesiones largas reducen la calidad del juicio.
- Entorno: lo evidente con auriculares puede desaparecer en el altavoz del móvil, y viceversa.
Tratar MOS humano como una verdad inmutable acabará causando problemas.
6.4 Los gustos varían
Las personas no quieren lo mismo. Incluso los oyentes atentos difieren en:
- Identidad y timbre: voces brillantes y claras frente a cálidas, graves o con textura.
- Velocidad: lo eficiente para uno puede resultar apresurado o estresante para otro.
- Acento y dialecto: una voz familiar para un público puede distraer a otro.
- Intensidad emocional: una interpretación expresiva puede parecer exagerada o agotadora.
- Edad y personalidad: la misma voz sugiere personalidades distintas, preferibles para distintos productos.
Please call Stella. Ask her to bring these things with her from the store: Six spoons of fresh snow peas, five thick slabs of blue cheese, and maybe a snack for her brother Bob. We also need a small plastic snake and a big toy frog for the kids. She can scoop these things into three red bags, and we will go meet her Wednesday at the train station.
Acento del sur de EE. UU.
Acento de Nueva York
Grabaciones humanas de Speech Accent Archive de George Mason University
Acento del sur, Plantersville, Arkansas · Acento de Nueva York, Brooklyn
Dos sistemas pueden ser “mejores” según a quién preguntes. La pregunta pasa a ser: ¿mejor para quién?
7. El audio largo y el streaming revelan fallos distintos
Las pruebas suelen usar clips cortos porque son fáciles de generar, escuchar y puntuar. Los productos reales exigen seguir hablando: leer artículos, narrar capítulos, atender llamadas o conversar. Ahí aparecen otros problemas.
El audio largo debe sonar bien frase a frase y mantener coherencia en el tiempo. Puede cambiar:
- La identidad del hablante.
- El acento.
- La velocidad.
- La emoción entre párrafos.
En streaming, la reproducción empieza antes de generar toda la respuesta. El modelo produce pequeños fragmentos y los envía inmediatamente. Por eso un asistente puede empezar a hablar rápido mientras todavía crea el resto de la frase.
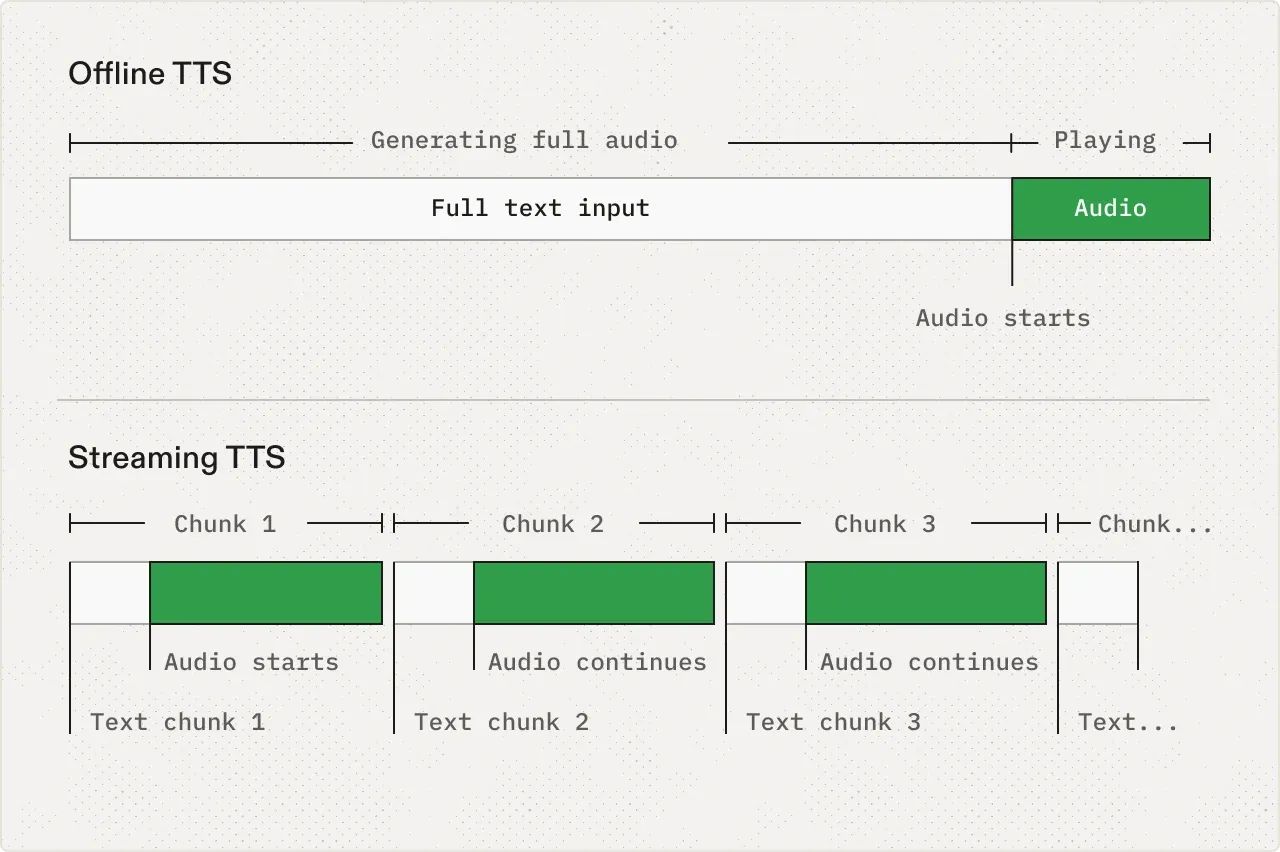
Esa velocidad tiene un coste. El modelo empieza sin saber exactamente qué viene después y puede fallar de formas que no aparecen en un clip generado por completo:
- Uniones extrañas: cada fragmento suena bien, pero la transición parece pegada.
- Sílabas o palabras repetidas: por ejemplo, “look-look-looking” o “is is scheduled”.
- Sonidos cortados: una palabra empieza o termina bruscamente, como “stop” convertido en “top”.
- Interpretación elegida demasiado pronto: adopta un ritmo, emoción o énfasis incorrectos y no consigue corregirlos.
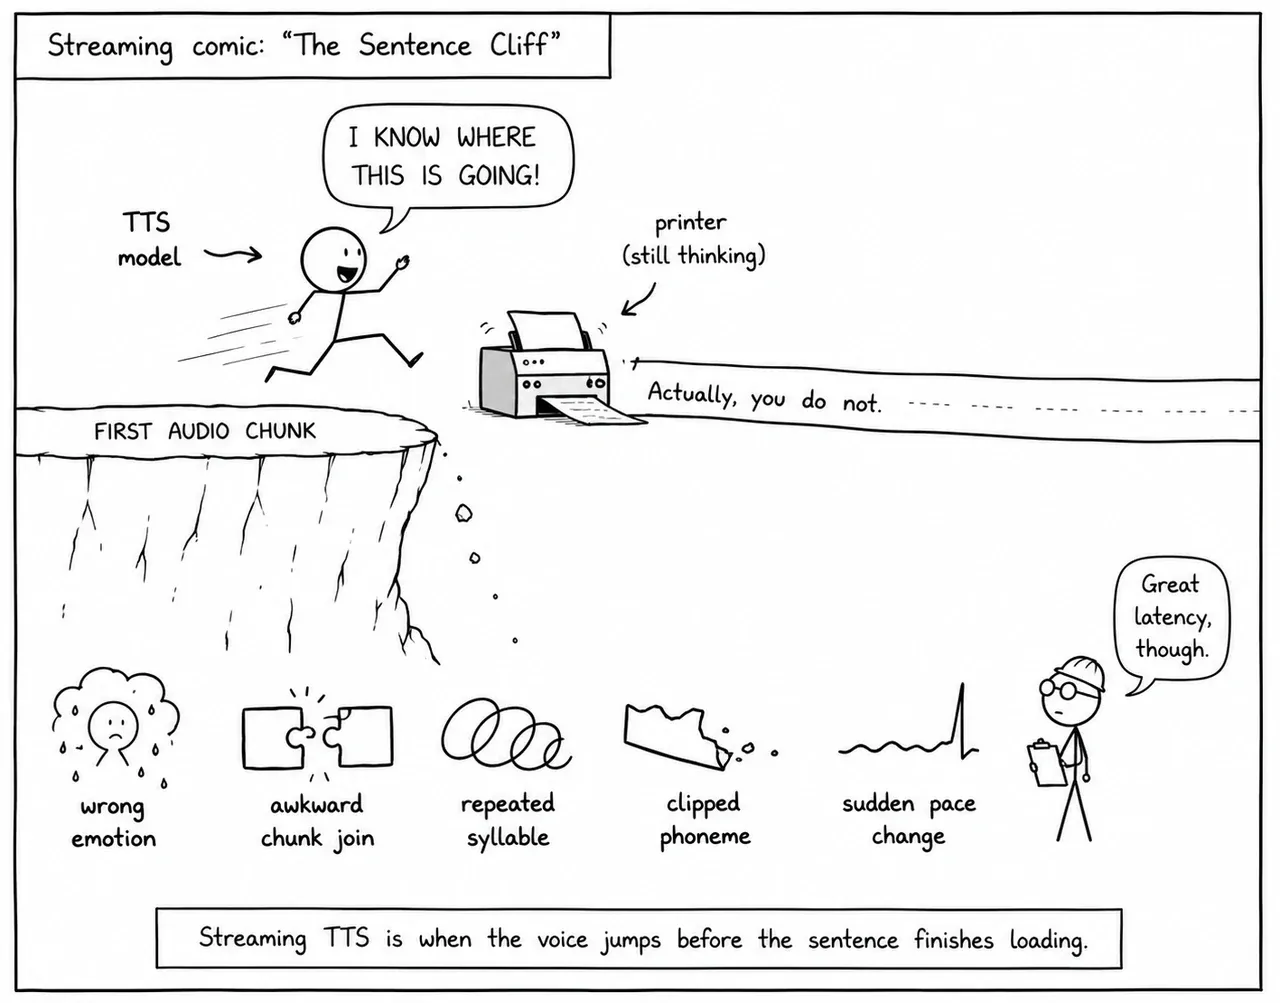
Los clips cortos pueden ocultar fallos que solo aparecen al generar en directo. Las pruebas largas evalúan la consistencia; las de streaming, si la voz sigue siendo natural cuando empieza antes de conocer toda la respuesta.
Estos fallos suelen aparecer cuando la evaluación deja de representar el uso real. La siguiente dimensión es el ámbito: una voz buena leyendo texto general puede fallar con convenciones, fórmulas, nombres o ritmos especializados.
8. El texto especializado rompe las suposiciones
Cada ámbito, como derecho, medicina, videojuegos, matemáticas, poesía, religión o atención al cliente, tiene expectativas distintas:
- Formato y normalización.
- Tratamiento de palabras poco frecuentes.
- Cadencia.
- Requisitos de corrección frente a estilo.
Un modelo puede ser excelente en un ámbito y sonar defectuoso en otro.
The process of photosynthesis relies on a specific chemical reaction. Plants take in carbon dioxide and water to produce glucose and oxygen: 6CO₂ + 6H₂O → C₆H₁₂O₆ + 6O₂. This balanced equation shows how life sustains itself on Earth.
Observa el ritmo incorrecto al pronunciar H₂O y cómo omite ”→”. Una persona formada en química lo leería como “produce” o “da lugar a”.
El ámbito es una dimensión. El idioma y la región añaden otra y pueden romper partes completamente distintas de la evaluación.
9. Los retos particulares del multilingüismo
Evaluar TTS multilingüe no equivale a repetir la evaluación inglesa N veces. Cada idioma afecta a una parte distinta del proceso. Si no hablas un idioma, no puedes puntuarlo adecuadamente: los oyentes nativos son necesarios.
Las métricas automáticas dejan de funcionar sin avisar. WER hereda los sesgos del ASR, que suele ser peor con otros acentos, escrituras e idiomas con pocos recursos. Puede penalizar al TTS por errores del reconocedor. Los predictores de calidad tienen el mismo problema: UTMOS se entrenó principalmente en inglés y fuera de esa distribución puede medir muy poco. La capa automática se vuelve menos fiable justo donde más necesitas escalar la evaluación.
La palabra correcta depende del idioma y puede ser ambigua. En francés existe la liaison: una consonante final normalmente muda se pronuncia si la siguiente palabra empieza por vocal. Les amis suena como “lez-ami”, no “lay-amis”. Si se aplica mal, las palabras se entienden, pero suenan extranjeras.
Liaison
En japonés, los kanji a menudo no determinan la pronunciación, especialmente en nombres. 上手 admite jōzu, uwate o kamite; sin contexto, el modelo puede elegir una lectura plausible pero incorrecta.
jōzu
田中さんは日本語が上手です。
Tanaka-san wa nihongo ga jōzu desu.
Tanaka habla bien japonés.
uwate
交渉では相手の方が一枚上手だった。
Kōshō de wa aite no hō ga ichimai uwate datta.
En la negociación, la otra parte tenía ventaja.
kamite
役者は上手から登場した。
Yakusha wa kamite kara tōjō shita.
El actor entró por la derecha del escenario.
Ocurre de distintas formas en otros idiomas: tonos del mandarín, vocales cortas no escritas del árabe o eliminación de schwa en hindi. Puntuar bien exige conocimiento nativo.
Idioma correcto, acento equivocado. Un modelo puede producir habla fluida e inteligible con la variante regional incorrecta: vocabulario francocanadiense con entonación parisina o una voz de España que deriva hacia pronunciaciones mexicanas.
Je remarque que votre facture de cette fin de semaine comprend des frais d’utilisation de données pour votre cellulaire.
Francés canadiense, esperado
Francés de Francia, inesperado
Estas muestras pueden superar las pruebas de inteligibilidad y expresividad y seguir siendo incorrectas. También ocurre lo contrario entre idiomas: un hablante de hindi debería conservar su acento indio al pronunciar inglés; convertirlo al inglés estadounidense general es un error. Una evaluación monolingüe no ve esta dimensión.
Una cifra oculta las diferencias. Los fallos se concentran en distintas dimensiones según el idioma: prosodia, pronunciación o normalización regional. Una media multilingüe elimina precisamente la señal útil. “Mejor en varios idiomas” solo tiene sentido por región y dimensión.
La evaluación multilingüe exige abandonar una única puntuación global e incorporar hablantes nativos, desglosando calidad por región, tipo de fallo y expectativas del producto.
TTS tiene más de una dimensión
Evaluar TTS es difícil porque “bueno” significa varias cosas. Una voz de audiolibro, una de navegación y un agente de atención no deberían optimizarse igual.
En Cartesia nos centramos especialmente en habla conversacional: agentes, asistentes interactivos y situaciones en tiempo real donde hay que responder rápido y con naturalidad. Un buen clip pregrabado no basta. La voz debe funcionar dentro de una conversación en directo a escala empresarial para que los clientes obtengan los resultados que necesitan.
Por eso optimizamos estos aspectos:
Baja latencia
Las pausas incómodas rompen la conversación.
Claridad
Hay que entender nombres, números, direcciones y códigos a la primera.
Expresión natural y controlada
La voz debe mostrar interés sin sonar teatral.
Corrección contextual
Debe decir lo adecuado de la manera adecuada para la situación.
Consistencia
La identidad del hablante debe mantenerse durante la llamada.
Estabilidad en streaming
El habla en tiempo real no debe tener uniones extrañas, repeticiones ni sonidos cortados.
Define la experiencia de producto que quieres y crea evaluaciones multidimensionales que midan si el modelo la ofrece. Para nosotros, eso significa habla que haga las conversaciones en tiempo real rápidas, claras y naturales.