
La maggior parte delle nostre interazioni con i sistemi digitali avviene ancora digitando in caselle di testo o toccando uno schermo. Funziona, ma comporta comunque qualche ostacolo. La voce può rendere questa interazione più veloce, naturale e vicina al modo in cui le persone comunicano già. Se riusciamo a farla funzionare bene, possiamo aprire la strada a un modo più interattivo di imparare, ricevere aiuto, passare da una lingua all’altra e portare a termine le attività con meno difficoltà.
Quando le persone interagiscono attraverso la voce, il parlato generato diventa l’esperienza stessa. Piccole differenze nell’esecuzione possono far sembrare l’interazione utile, naturale o malfunzionante. È questo che rende la sintesi vocale una parte tanto importante dello stack: trasforma il testo in parlato e determina il carattere dell’intera interazione. La voce, però, non offre un’esperienza uguale per tutti.
Per esempio, quando qualcuno dice che un audio generato da un modello TTS è “buono”, può intendere una o più cose:
Correttezza
Ogni parola viene pronunciata correttamente?
Qualità audio
L'audio è privo di fruscii, rumore di fondo e distorsioni?
Correttezza nel contesto
Nomi, numeri e parole ambigue sono stati interpretati correttamente nel contesto?
Naturalezza
Sembra una voce umana?
Resistenza alle variazioni
La qualità regge anche con input irregolari, come differenze tra maiuscole e minuscole, abbreviazioni o cambi di lingua?
Questa molteplicità di dimensioni rende difficile valutare il TTS. Man mano che i modelli migliorano, la valutazione si allontana dai difetti evidenti, come parole pronunciate male, audio incomprensibile o rumore di fondo, per concentrarsi su aspetti più sfumati. Questo articolo passa in rassegna i problemi che continuano a emergere quando proviamo a rispondere a una domanda solo apparentemente semplice:
Questo modello TTS è valido?
1. TTS: il problema della corrispondenza uno a molti
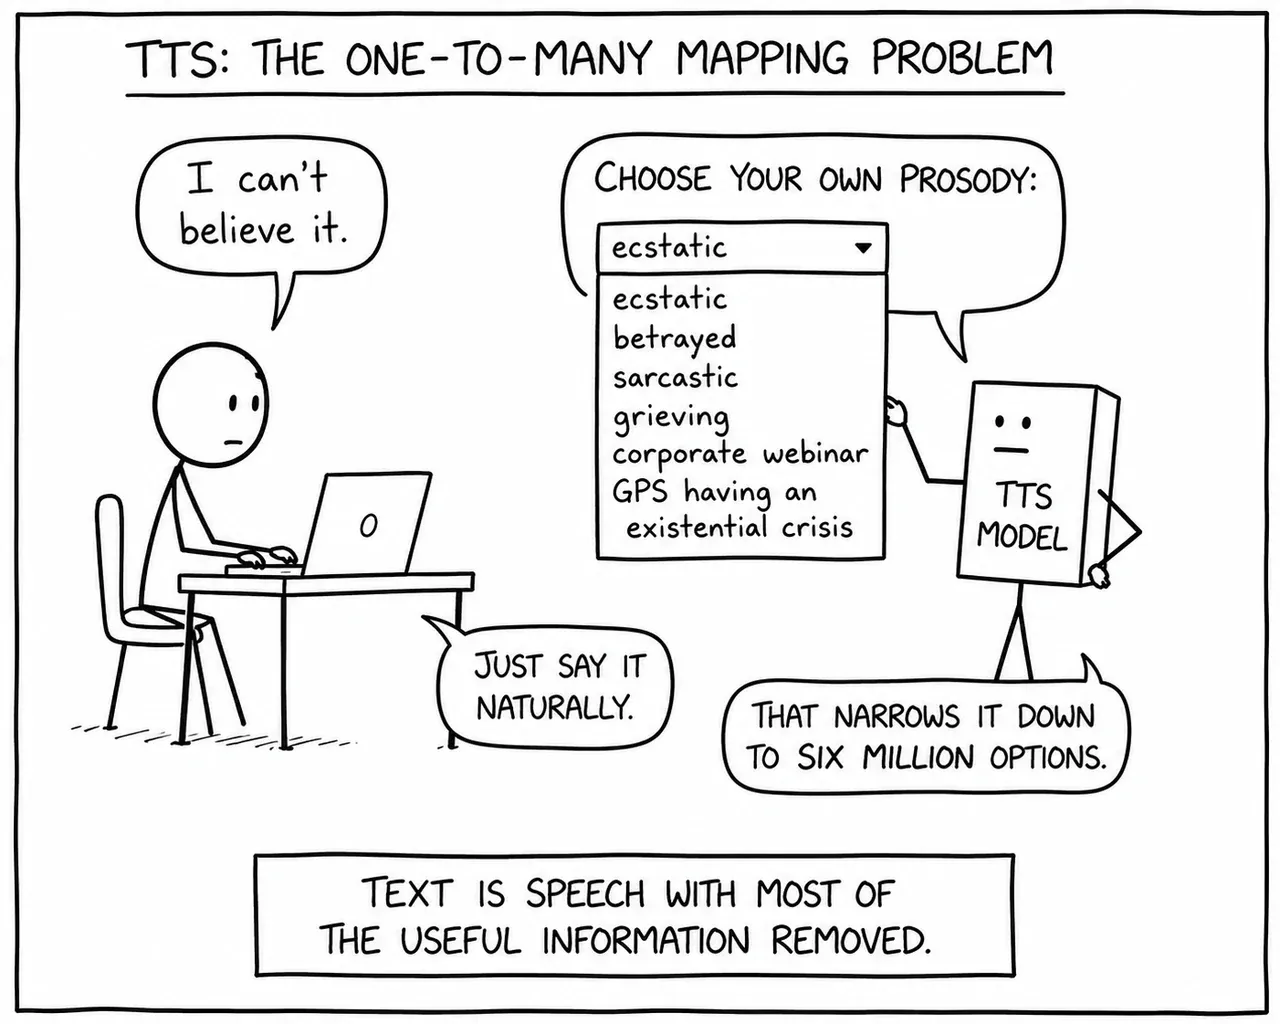
Un modello TTS moderno fa più che trasformare testo → audio. Deve decidere come parlare.
La sintesi vocale è un problema uno a molti: esistono infiniti modi di leggere un testo, a seconda di chi parla, dell’emozione, del ritmo, dell’enfasi e del contesto.
Per esempio, “I can’t believe it” può essere corretto in quattro contesti molto diversi:
- Entusiasmo: una persona ha appena ricevuto una notizia inaspettatamente buona.
- Rabbia: una persona reagisce a un tradimento frustrante.
- Tristezza: una persona cerca di elaborare una delusione dolorosa.
- Sarcasmo: una persona finge di essere colpita, ma intende il contrario.
Entusiasmo
Rabbia
Tristezza
Sarcasmo
Ora scambia i contesti. Se l’audio entusiasta venisse riprodotto nella situazione di rabbia, o quello sarcastico nella situazione triste, ogni parola sarebbe ancora corretta, ma il parlato sembrerebbe sbagliato.
Un altro esempio di contesti diversi con lo stesso testo:
Tomorrow is the big day. There’s no changing it now.
Audio 1
Audio 2
Il primo audio suona entusiasta, come se chi parla non vedesse l’ora di partecipare a un grande evento. Il secondo sembra più nervoso o spaventato, come se anticipasse qualcosa di stressante, per esempio un esame difficile.
Questa variabilità rende la sintesi vocale più difficile della semplice conversione delle parole in suoni. Un buon sistema deve decidere come pronunciare ogni parola, dove fare una pausa, quali parole enfatizzare, a quale velocità parlare e quale emozione esprimere. In molti casi, il testo da solo non contiene informazioni sufficienti per prendere queste decisioni. Il sistema può quindi aver bisogno di ulteriore contesto o di istruzioni sullo stile desiderato.
Prima di arrivare a queste scelte più sottili, però, la valutazione parte in genere dalla domanda più elementare: il modello ha pronunciato le parole previste?
2. Pronunciare le parole giuste è solo il primo livello
WER, Word Error Rate o tasso di errore sulle parole, è una delle metriche più usate per i modelli TTS. Si sintetizza l’audio di un testo con il modello TTS, lo si trascrive con un modello ASR, riconoscimento vocale automatico, e si confronta la trascrizione con il testo iniziale.
Vediamo alcuni esempi.
I can’t stop smiling, everything feels brighter, lighter, warmer, and somehow, after all the waiting, all the hoping, and all the uncertainty, this moment feels even better than I imagined.
Audio 1
Audio 2
Entrambi questi audio pronunciano correttamente tutte le parole e hanno lo stesso WER, ma la maggior parte delle persone preferirebbe spontaneamente il secondo.
Il WER può quindi dare un’indicazione utile. Ma una volta risolto in gran parte il problema dell’intelligibilità, le differenze si riducono fino a confondersi con il rumore.
- Il WER raggiunge la saturazione: come mostra l’esempio precedente, due modelli possono differire sensibilmente nella qualità percepita pur presentando differenze trascurabili di WER, soprattutto nei test con letture pulite.
- Dipendenza dalla qualità dell’ASR: il WER è affidabile quanto il riconoscitore usato per calcolarlo. Se il modello ASR è meno efficace con certi accenti, lingue, audio rumorosi, parlato espressivo o termini specialistici, il sistema TTS può essere penalizzato per errori dell’ASR anziché per veri errori di sintesi.
- Al contrario, un ASR potente può talvolta “correggere” o dedurre un parlato poco chiaro, facendo apparire un campione difettoso migliore di come lo percepiscono le persone.
Il WER è una metrica necessaria per molti casi d’uso, soprattutto quelli che coinvolgono sequenze alfanumeriche che non sono parole. Ma raramente basta per gli agenti vocali destinati alle aziende.
3. La correttezza nel contesto è un’altra sfida
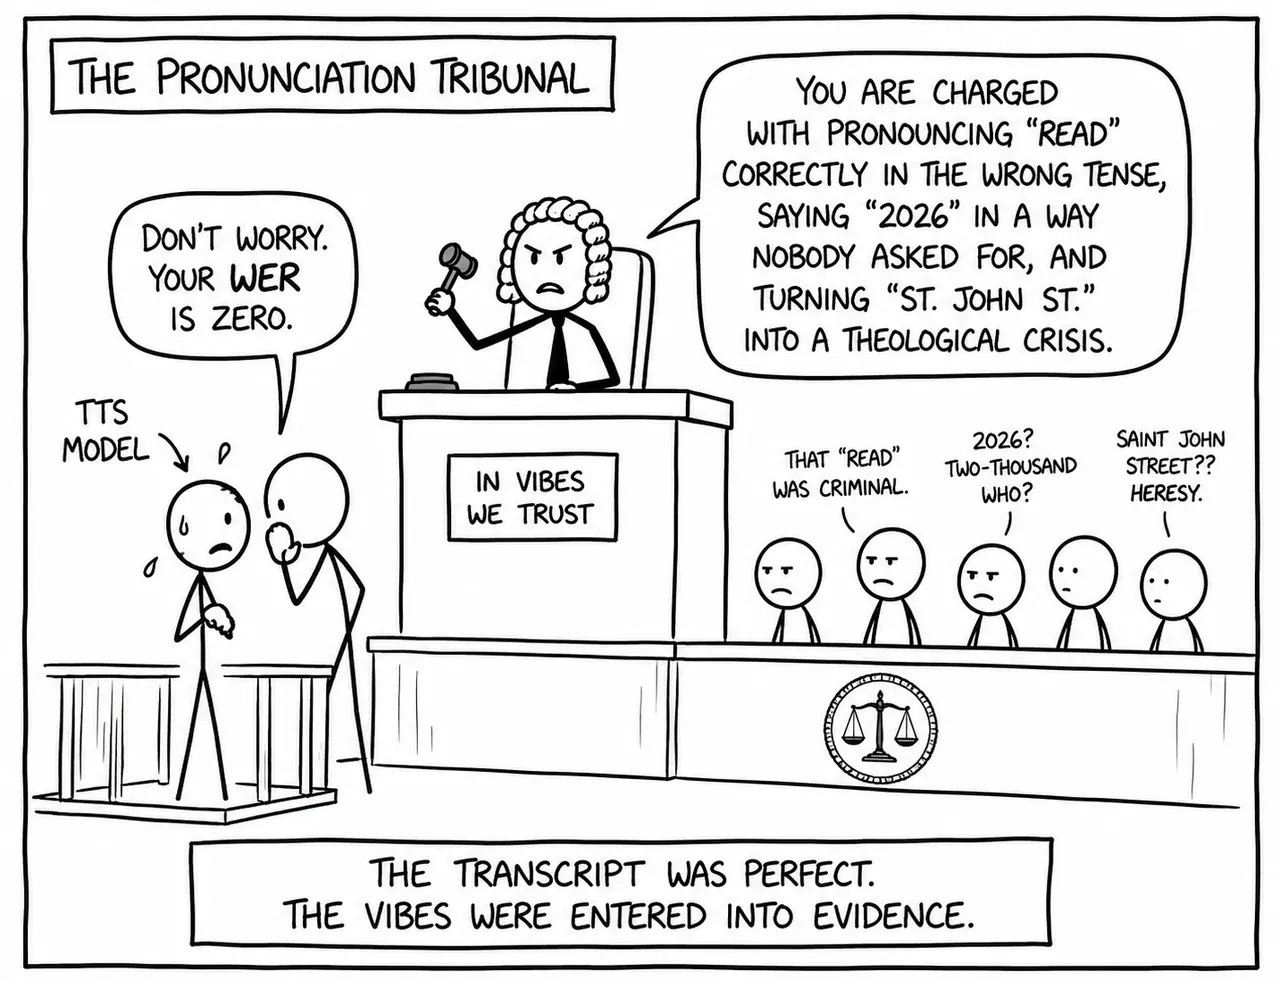
Molti errori richiedono una disambiguazione semantica anche solo per definire cosa sia corretto:
- “read”, presente o passato
- “lead”, metallo o verbo
- “Polish”, nazionalità o verbo
- “bass”, pesce o strumento
- “live”, verbo o aggettivo
- anni come “2026”, twenty-twenty-six oppure two thousand twenty-six
I had to wind the old clock before the wind picked up outside.
I nomi propri sono ancora più difficili: nomi di persone, luoghi, prodotti, aziende, farmaci e termini inventati spesso non hanno una pronuncia canonica. Persino le persone non concordano, soprattutto tra lingue diverse.
Una buona valutazione deve rilevare quando il modello sceglie l’interpretazione sbagliata anche se il risultato suona fluido.
4. La normalizzazione del testo è un problema di valutazione a sé
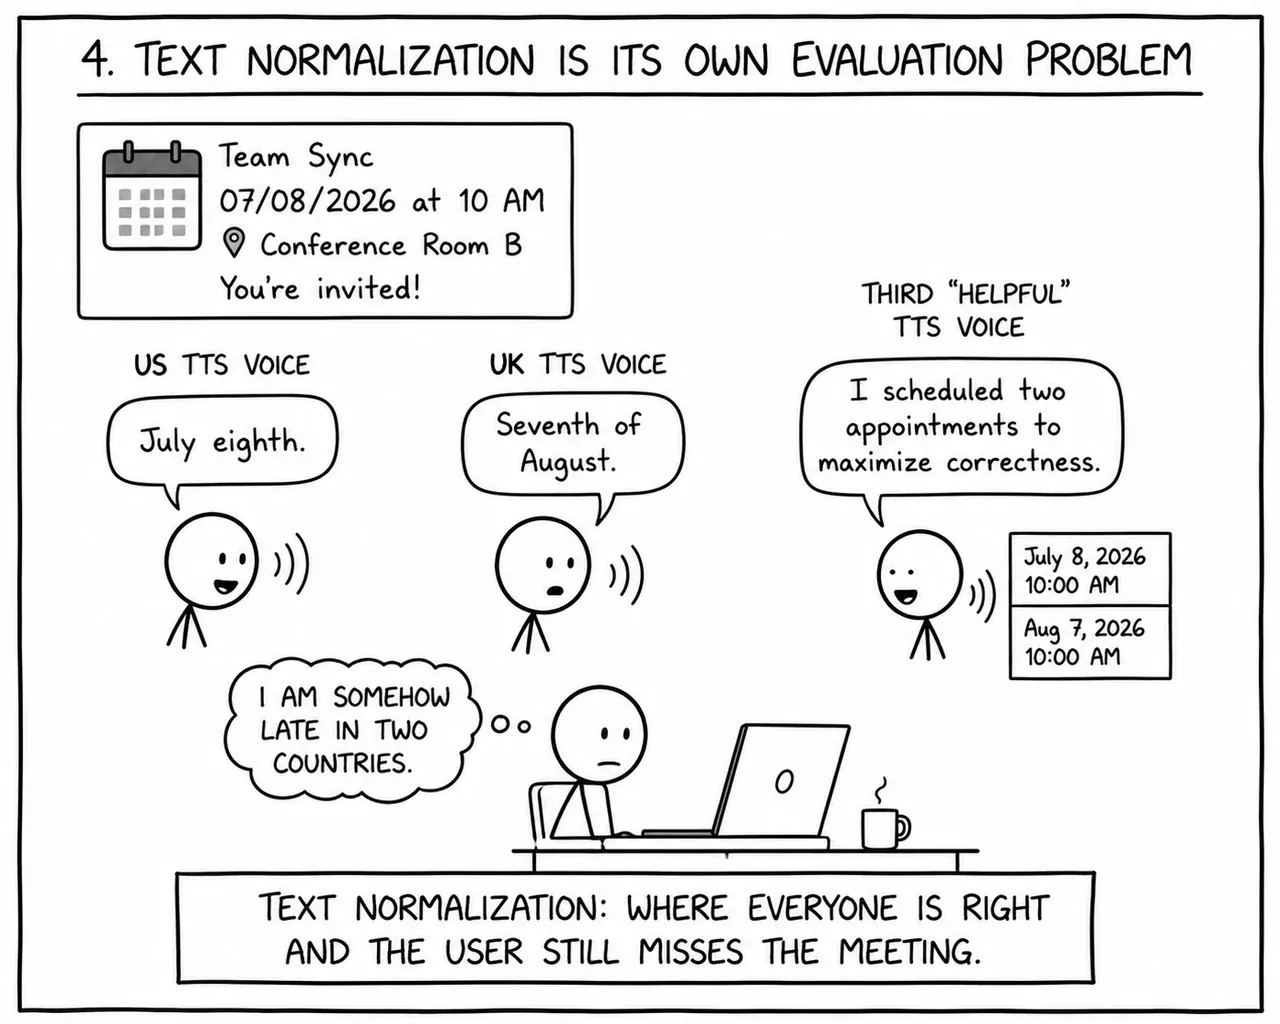
La pronuncia è solo uno degli aspetti in cui conta il contesto. Prima di pronunciare qualsiasi cosa, il modello deve spesso decidere come espandere il testo scritto in parlato.
Molti input sono ambigui:
- “$1.05”, one oh five oppure one dollar and five cents
- “3/4”, three quarters oppure three-fourths
- “IV”, four oppure I-V
- “St.”, street oppure saint
- “No. 5”, number five oppure “no. five”
Un esempio interessante è la data nelle diverse convenzioni locali. Per il testo seguente, l’inglese americano si aspetta l’8 luglio, mentre l’inglese britannico si aspetta il 7 agosto!
I’d like to schedule an appointment for 07/08/2026 at 10 AM. Could you confirm if that time is available?
Variante statunitense
Variante britannica
Più normalizzazioni possono essere corrette a seconda del contesto, e le trascrizioni di riferimento spesso incorporano una scelta diversa da quella richiesta dal prodotto. Se non separi la preferenza di normalizzazione dall’errore del modello, i punteggi di valutazione diventano incoerenti.
5. I punteggi automatici di qualità sono utili, ma incompleti
L’accuratezza della trascrizione è solo la base. Una volta che il modello pronuncia le parole giuste, il divario di qualità riguarda in genere prosodia, espressività, stile e stabilità, cioè gli aspetti che rendono il parlato naturale, appropriato e utilizzabile.
I predittori automatici di qualità cercano di misurare questi aspetti su larga scala. Strumenti come DNSMOS, NISQA e UTMOS ascoltano gli audio generati e assegnano punteggi di qualità, utili per individuare regressioni su migliaia di campioni.
Questi punteggi restano però indicatori indiretti. Non chiedono davvero “Questo audio funzionava in questa situazione?”. Chiedono “Questo audio assomiglia ai tipi di audio che ho imparato a valutare?”
La distinzione conta perché i problemi spesso non sono evidenti:
- Disallineamento del dominio: un predittore di qualità può funzionare bene sul tipo di parlato usato per addestrarlo, ma diventare inaffidabile quando l’audio proviene da un contesto diverso.
- Per esempio, UTMOSv2 è stato sviluppato appositamente per prevedere il MOS di naturalezza del parlato sintetico di alta qualità, prevalentemente in inglese. Non è stato progettato come metrica universale per codec, parlato rumoroso, audio multilingue, canto o conversazioni.
- Deriva della calibrazione: un punteggio che distingueva i modelli precedenti può perdere significato quando quelli nuovi sbagliano in modi più sottili. Spesso questo significa che anche i predittori automatici devono essere riaddestrati per restare utili.
- Punti ciechi: il predittore può rilevare rumore o distorsione ma non emozioni inappropriate, ritmo innaturale, difetti nello streaming o una deriva graduale della voce.
- Per esempio, in questo studio sui predittori MOS automatici, lo stesso parlato è stato generato aumentando gli errori nell’accento tonale giapponese. Gli ascoltatori umani abbassano il punteggio dei campioni di 1.84 punti MOS. Ogni modello automatico varia di meno di 0.1. Alcuni predittori assegnano persino un punteggio leggermente più alto al parlato pesantemente alterato.
| Nessuno (riferimento) | Basso (scambio 10-20%) | Alto (scambio 80-90%) | |
|---|---|---|---|
| MOS umano | 4.00 ± 0.07 | 3.19 ± 0.09 | 2.16 ± 0.09 |
| UTMOS | 3.44 ± 0.12 | 3.43 ± 0.11 | 3.47 ± 0.11 |
| UTMOSv2 | 3.56 ± 0.08 | 3.62 ± 0.06 | 3.61 ± 0.08 |
| NISQA | 3.81 ± 0.16 | 3.74 ± 0.15 | 3.84 ± 0.16 |
| DNSMOS | 3.82 ± 0.05 | 3.81 ± 0.06 | 3.83 ± 0.05 |
In altre parole, questi punteggi aiutano a rilevare regressioni evidenti su larga scala, ma non sostituiscono la comprensione di ciò che rende valido un audio.
A questo punto spesso si “deve” passare alle valutazioni umane, che però introducono un altro insieme di insidie.
6. Le valutazioni umane sono il riferimento assoluto?
I test di ascolto umano restano il riferimento principale, ma i punteggi non sono misure stabili. I giudizi variano con il profilo dell’ascoltatore, il fatto che sia madrelingua, la formulazione delle istruzioni, i campioni di riferimento inclusi, l’ambiente di riproduzione, cuffie o altoparlanti, la normalizzazione del volume, la durata della sessione e la conseguente stanchezza, e altri fattori.
Due formati comuni sono le valutazioni MOS, Mean Opinion Score, e le valutazioni di preferenza. In un test MOS, gli ascoltatori valutano ogni audio separatamente, spesso su una scala da 1 a 5 per qualità o naturalezza. In un test di preferenza, confrontano due o più audio e scelgono quello che preferiscono. Il MOS produce un punteggio dall’apparenza assoluta, mentre i test di preferenza sono più direttamente comparativi. Entrambi, però, dipendono dalle istruzioni, dal gruppo di ascoltatori e dalle modalità di presentazione. Qualunque formato si usi, le valutazioni umane presentano i problemi seguenti:
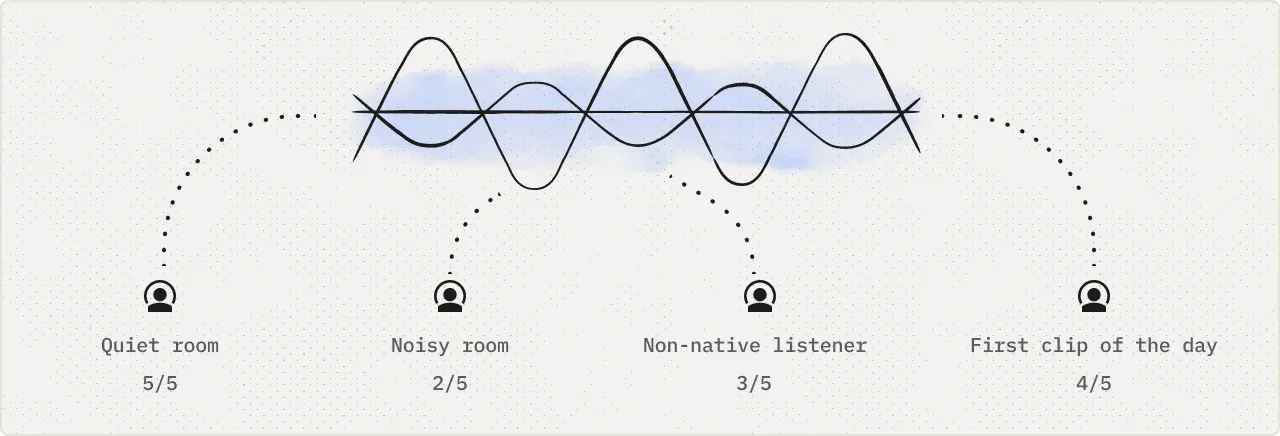
6.1 Le risposte degli ascoltatori dipendono dal contesto
Gli ascoltatori non sentono gli audio nel vuoto. Anche ascoltando la stessa frase, possono immaginare situazioni diverse. Una frase come “That’s great” può suonare sincera in un contesto, sarcastica in un altro e piatta o confusa in un terzo.
Lo stesso audio può quindi ricevere punteggi diversi a seconda di ciò che l’ascoltatore pensa che la voce debba fare. Se il compito non specifica chiaramente lo scenario previsto, le persone giudicano in base alle proprie aspettative personali anziché a un obiettivo condiviso.
6.2 I confronti sono sensibili ai dettagli di presentazione
Piccole scelte apparentemente “irrilevanti” possono dominare i risultati:
- Strategia di normalizzazione del volume e dei picchi: un campione più forte può sembrare più chiaro, sicuro o di qualità superiore anche se il modello non è migliore.
- Frequenza di campionamento, codec e ricampionamento: gli artefatti di compressione o ricampionamento possono peggiorare il suono di un sistema per ragioni estranee alla qualità della sintesi.
- Testo del prompt, contesto dell’interfaccia e campioni circostanti: testo e presentazione definiscono le aspettative degli ascoltatori e possono cambiare ciò che notano o preferiscono.
- Taglio di silenzi, respiri e latenza iniziale: piccole modifiche a pause, respiri o ritardo iniziale possono rendere un campione naturale, impacciato o reattivo.
Se questi aspetti non sono fissati, rischi di valutare la pipeline audio anziché il modello.
6.3 La deriva è reale, anche con un modello stabile
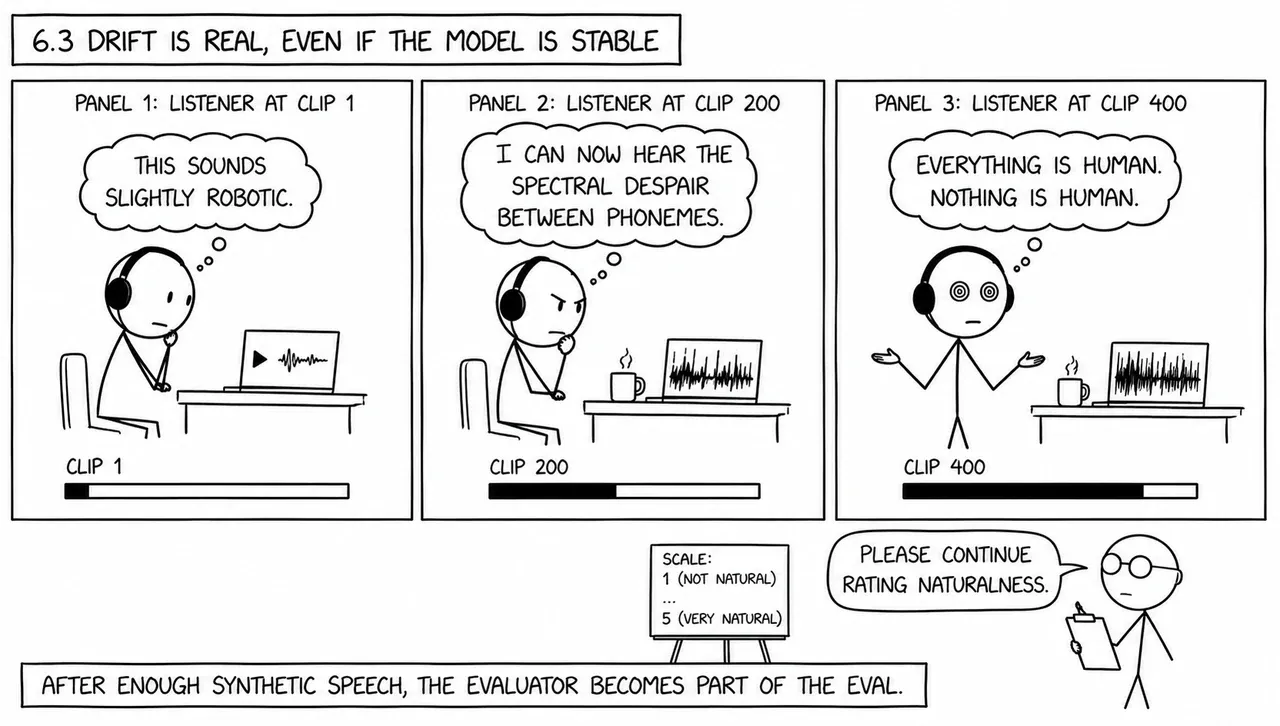
Anche gli ascoltatori cambiano nel tempo:
- Adattamento: dopo molti audio sintetici, gli ascoltatori ricalibrano ciò che notano, diventando più sensibili agli artefatti oppure più indulgenti.
- Stanchezza: annotare audio è faticoso e la qualità del giudizio cala con l’allungarsi delle sessioni.
- Variazioni dell’ambiente: ciò che risalta in cuffia può scomparire dagli altoparlanti di un telefono, e viceversa.
Trattare il MOS umano come una verità di riferimento immutabile presenterà il conto in seguito.
6.4 Preferenze e gusti variano
Un problema ricorrente è che le persone non vogliono tutte la stessa cosa. Anche tra ascoltatori attenti, le preferenze differiscono per:
- Identità vocale e timbro: alcuni preferiscono voci brillanti e nitide, altri voci più calde, profonde o caratterizzate.
- Velocità del parlato: un ritmo veloce può sembrare efficiente a un ascoltatore e frettoloso o stressante a un altro.
- Accento e dialetto: una voce può risultare familiare e naturale a un pubblico, ma distraente o poco adatta a un altro.
- Intensità emotiva: alcuni apprezzano una resa espressiva, mentre altri trovano la stessa interpretazione eccessiva o stancante.
- Indizi sull’età e sulla personalità: gli ascoltatori possono dedurre personalità diverse dalla stessa voce e preferire personaggi diversi per prodotti diversi.
Please call Stella. Ask her to bring these things with her from the store: Six spoons of fresh snow peas, five thick slabs of blue cheese, and maybe a snack for her brother Bob. We also need a small plastic snake and a big toy frog for the kids. She can scoop these things into three red bags, and we will go meet her Wednesday at the train station.
Accento del sud degli Stati Uniti
Accento di New York
Registrazioni umane dallo Speech Accent Archive della George Mason University
Accento del sud degli Stati Uniti, Plantersville, Arkansas · Accento di New York, Brooklyn
Esiste quindi la possibilità concreta che due sistemi siano entrambi “migliori”, a seconda dell’ascoltatore. La domanda diventa “migliore per chi?”.
7. Audio lunghi e streaming rivelano problemi diversi
La maggior parte delle valutazioni TTS usa audio brevi perché sono più facili da generare, ascoltare e valutare. Ma i prodotti reali spesso richiedono che una voce continui a parlare: leggere un articolo, narrare un capitolo, gestire una chiamata di assistenza o sostenere una conversazione. È qui che emergono nuovi problemi.
Negli audio lunghi, non basta che ogni frase suoni bene. La voce deve anche restare coerente nel tempo. Le derive comuni includono:
- Cambiamenti nell’identità di chi parla
- Deriva dell’accento
- Cambiamenti nella velocità del parlato
- Coerenza emotiva tra i paragrafi
Lo streaming aggiunge un altro livello. Il sistema inizia a riprodurre l’audio prima di aver generato la risposta completa. Anziché aspettare che tutto il paragrafo o la risposta siano pronti, il modello produce il parlato in piccole parti e le invia subito all’ascoltatore. È ciò che fa sembrare reattivo un assistente vocale: lo senti iniziare a parlare rapidamente mentre il resto della frase viene ancora creato.
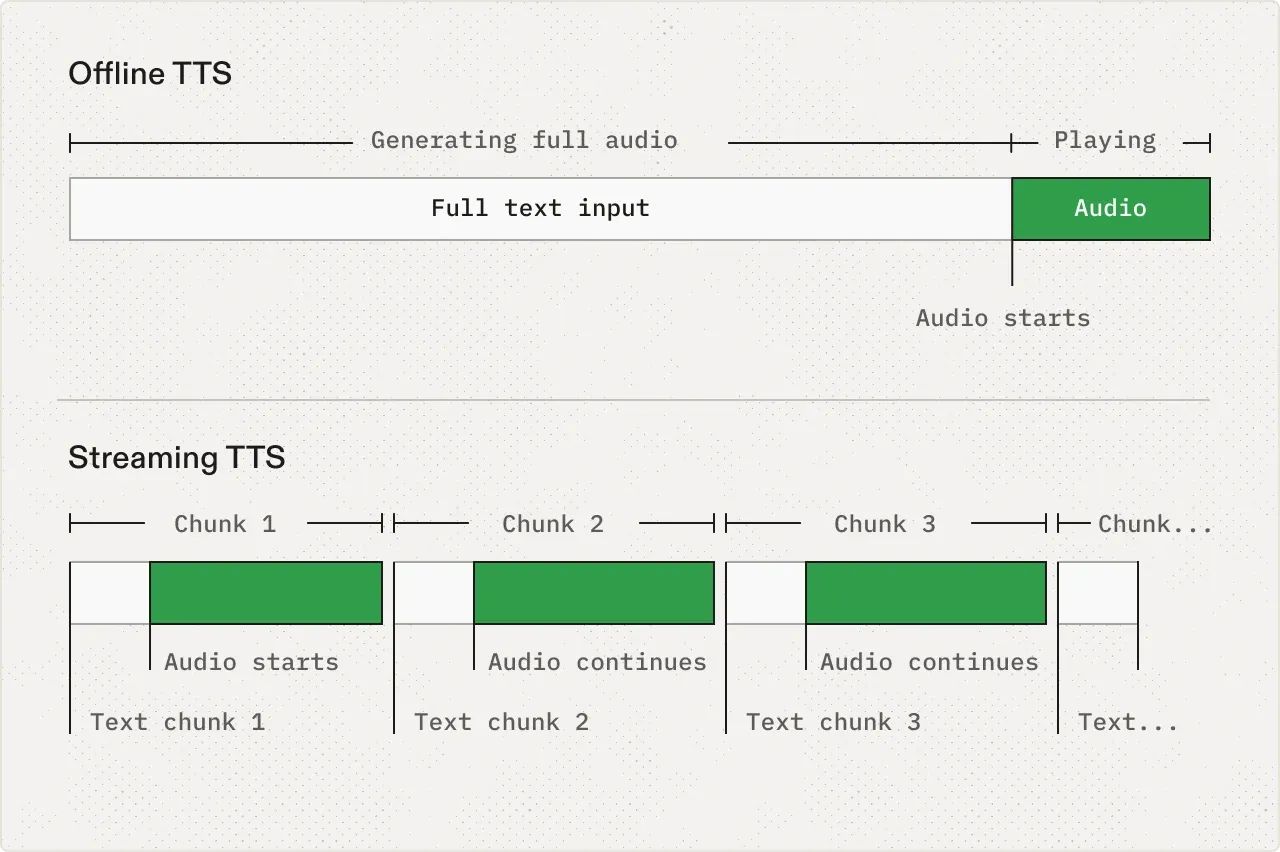
Questa velocità è utile, ma comporta un compromesso. Il modello deve iniziare a parlare prima di sapere esattamente cosa seguirà. La versione in streaming può quindi fallire in modi che non si verificano in un audio generato offline. Per esempio:
- Raccordi innaturali tra segmenti: ogni parte suona bene da sola, ma il passaggio sembra assemblato.
- Sillabe o parole ripetute: la voce può ripetersi vicino a un raccordo, per esempio “look-look-looking” oppure “is is scheduled”.
- Suoni troncati: una parola può iniziare o finire troppo bruscamente, come “stop” che diventa “top”.
- Scelta prematura di una resa sbagliata: il modello può iniziare con ritmo, emozione o enfasi inappropriati e faticare a correggersi.
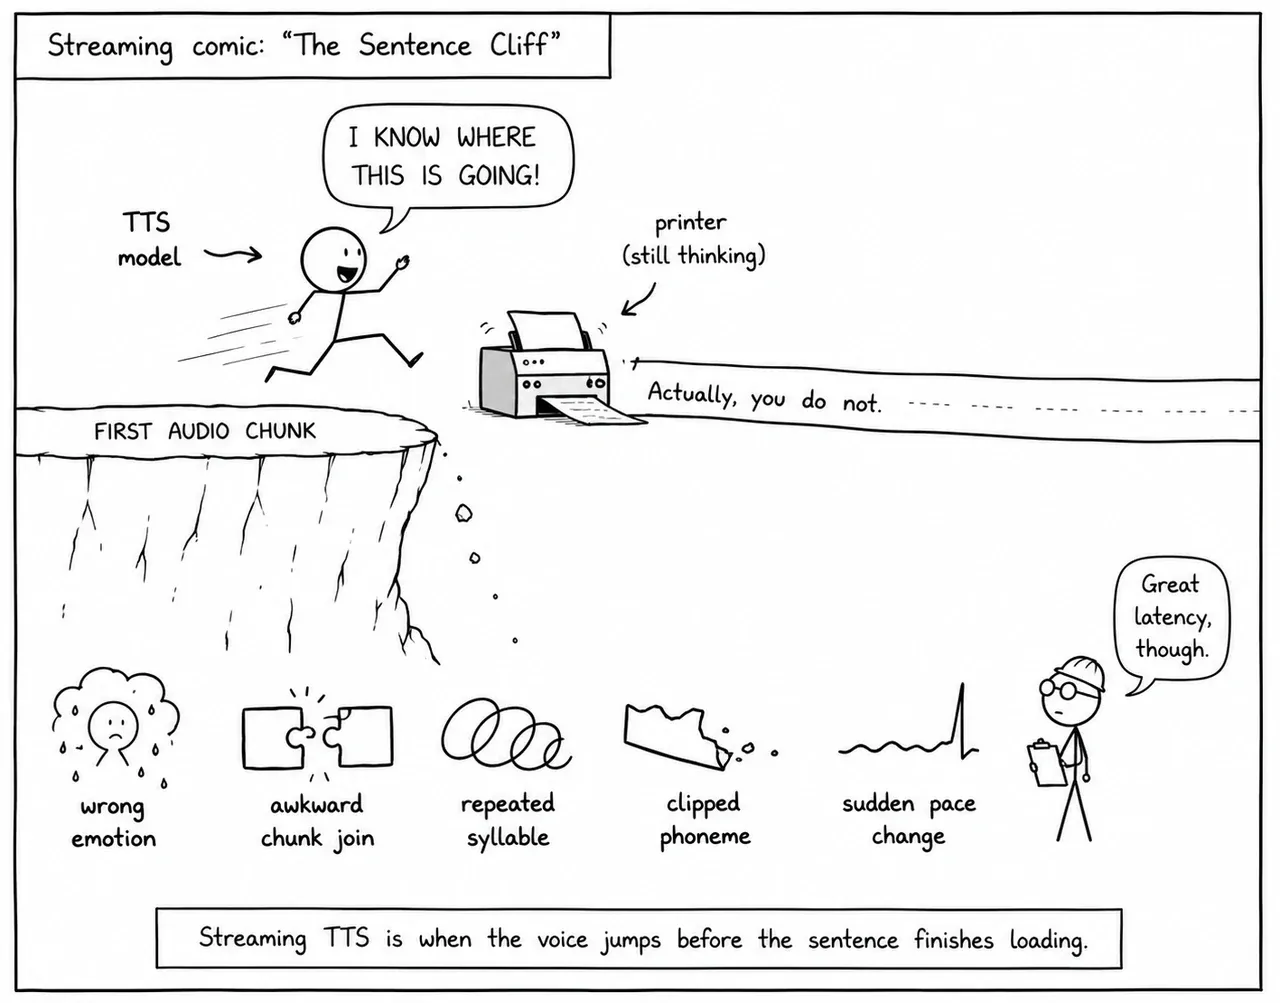
Il punto generale è che gli audio brevi possono nascondere difetti che emergono solo quando il TTS viene generato dal vivo. I test su audio lunghi verificano se la voce resta coerente nel tempo. Quelli in streaming verificano se resta naturale quando deve iniziare rapidamente, prima di conoscere la risposta completa.
Questi difetti non sono casuali. Di solito emergono quando la configurazione della valutazione smette di corrispondere all’uso reale del prodotto. Per questo il livello successivo è il dominio: una voce che funziona bene nella lettura generica può cedere quando il testo contiene convenzioni specialistiche, formule, nomi o aspettative particolari sul ritmo.
8. Il testo specialistico mette in crisi le ipotesi
Ogni dominio, per esempio diritto, medicina, videogiochi, matematica, poesia, testi religiosi o assistenza clienti, comporta aspettative diverse:
- Formattazione e normalizzazione
- Gestione di parole rare
- Aspettative sulla cadenza
- Vincoli di correttezza rispetto ai vincoli di stile
Un modello può raggiungere una qualità “SOTA” in un dominio e presentare difetti udibili in un altro.
The process of photosynthesis relies on a specific chemical reaction. Plants take in carbon dioxide and water to produce glucose and oxygen: 6CO₂ + 6H₂O → C₆H₁₂O₆ + 6O₂. This balanced equation shows how life sustains itself on Earth.
Nota la cadenza errata nella pronuncia di H₂O e il fatto che il TTS non pronunci “→”. Una persona esperta di chimica lo leggerebbe come “yields” o “produces”.
Il dominio è un asse di variazione. Lingua e variante locale ne aggiungono un altro e spesso mettono in crisi lo stack di valutazione in modi completamente diversi.
9. Il multilinguismo introduce sfide specifiche
Il TTS multilingue non equivale a ripetere N volte il problema dell’inglese. Ogni lingua mette in crisi una parte diversa dello stack di valutazione. Non puoi valutare una lingua che non parli, quindi gli ascoltatori madrelingua diventano necessari. Ecco cosa smette di funzionare:
Le metriche automatiche smettono di funzionare senza segnalarlo. Il WER eredita le distorsioni del modello ASR usato per calcolarlo. I riconoscitori sono spesso meno efficaci con accenti non inglesi, altri sistemi di scrittura e lingue con poche risorse. Il sistema TTS può quindi essere penalizzato per gli errori del riconoscitore. I predittori di qualità appresi hanno lo stesso problema. Strumenti come UTMOS sono stati addestrati soprattutto sull’inglese e, fuori da quella distribuzione, possono misurare ben poco. Il livello automatico su cui fai affidamento per ampliare le valutazioni in inglese diventa meno affidabile proprio dove servirebbe più capacità.
La “parola giusta” dipende dalla lingua ed è spesso ambigua. Il francese ha la liaison: una consonante finale normalmente muta viene pronunciata quando la parola successiva inizia per vocale. Les amis suona come “lez-ami”, non “lay-amis”. Applicarla male lascia in genere le parole riconoscibili, ma rende la pronuncia chiaramente non nativa.
Liaison
Il giapponese è più difficile: i kanji spesso non determinano la pronuncia, soprattutto nei nomi. Per esempio, 上手 ha diverse letture valide, jōzu, uwate o kamite. Senza contesto, il modello può sceglierne una plausibile ma sbagliata.
jōzu
田中さんは日本語が上手です。
Tanaka-san wa nihongo ga jōzu desu.
Tanaka-san parla bene il giapponese.
uwate
交渉では相手の方が一枚上手だった。
Kōshō de wa aite no hō ga ichimai uwate datta.
Nella trattativa, l'altra parte aveva il vantaggio.
kamite
役者は上手から登場した。
Yakusha wa kamite kara tōjō shita.
L'attore è entrato dalla destra del palco.
La stessa insidia ricorre ovunque in forme diverse: i toni del mandarino, dove un tono sbagliato cambia la parola, le vocali brevi non scritte dell’arabo, l’elisione dello schwa in hindi. Valutare correttamente questi aspetti richiede conoscenze da madrelingua.
Lingua corretta, accento sbagliato. Un modello può produrre un parlato fluido e del tutto comprensibile nella variante locale sbagliata. Per esempio, parole del francese canadese con intonazioni parigine, oppure una voce spagnola europea che passa gradualmente a pronunce messicane nello stesso audio.
Je remarque que votre facture de cette fin de semaine comprend des frais d’utilisation de données pour votre cellulaire.
Francese canadese, previsto
Francese di Francia, inatteso
Questi esempi supererebbero ogni verifica di intelligibilità ed espressività, ma sarebbero comunque sbagliati. Esiste un errore speculare nelle voci tra lingue diverse: la pronuncia inglese di una persona di lingua hindi dovrebbe mantenere il suo accento indiano. “Correggerla” verso l’inglese americano standard è un errore, non un miglioramento. È un intero asse di correttezza che una valutazione monolingue non vede.
Un numero nasconde il divario. I problemi si concentrano in dimensioni diverse per ogni lingua: prosodia in una, pronuncia in un’altra, normalizzazione locale in una terza. Un singolo punteggio multilingue aggregato annulla nella media proprio il segnale su cui agiresti. “Migliore nel multilingue” ha senso solo per singola variante locale e singola dimensione.
Nel complesso, la valutazione multilingue spinge ad abbandonare un unico punteggio globale a favore di una visione della qualità con madrelingua coinvolti, distinta per variante locale, tipo di errore e aspettative del prodotto che contano davvero.
Conclusione: il TTS ha più di una dimensione
Valutare il TTS è difficile perché “buono” non significa una sola cosa. Dipende da più aspetti. Una voce per audiolibri, una per la navigazione e un agente di assistenza clienti non dovrebbero essere ottimizzati per gli stessi obiettivi.
In Cartesia ci interessa in particolare il parlato conversazionale: agenti vocali, assistenti interattivi e altri contesti in tempo reale in cui il sistema deve rispondere rapidamente e restare naturale. In questi prodotti un ottimo audio offline non basta. La voce deve funzionare in una conversazione dal vivo su scala aziendale, perché i nostri clienti ottengano dagli agenti vocali i risultati di cui hanno bisogno.
Per questo ottimizziamo per:
Bassa latenza
Le pause innaturali fanno sembrare la conversazione interrotta.
Chiarezza
Gli utenti devono capire nomi, numeri, indirizzi e codici al primo ascolto.
Espressione naturale ma controllata
La voce deve sembrare partecipe senza risultare teatrale.
Correttezza contestuale
Il modello deve dire la cosa giusta nel modo adatto alla situazione.
Coerenza
La voce dello stesso interlocutore deve restare stabile durante una chiamata.
Stabilità nello streaming
Il parlato in tempo reale non deve avere raccordi innaturali, ripetizioni o suoni troncati.
Il punto è quindi definire l’esperienza che vuoi offrire nel prodotto, poi costruire valutazioni multidimensionali che misurino se il modello la realizza davvero. Per noi significa ottimizzare il parlato per rendere le conversazioni in tempo reale veloci, chiare e naturali.