


앞으로 몇 년간 온디바이스 AI의 새 시대가 열릴 것입니다. 휴대전화의 개인 비서, AR 안경의 실시간 번역기, 집안일을 하는 휴머노이드 로봇까지 온디바이스 모델이 다양한 애플리케이션을 지원하게 됩니다.
모델이 주로 클라우드에서 실행되고 짧은 지연 시간, 개인정보 보호, 보안에 추가 비용이 드는 오늘날의 방식에서 크게 달라지는 것입니다.
이 변화를 위해서는 유능한 모델의 효율성을 대폭 높여 자원이 제한된 더 많은 하드웨어 환경에서 사용할 수 있어야 합니다.
최신 기술 보고서 “Llamba: Scaling Distilled Recurrent Models for Efficient Language Processing”는 아키텍처 증류에 관한 새 아이디어를 설명합니다. 아키텍처 증류는 사전 학습된 모델을 더 효율적인 새 아키텍처로 바꾸는 방법입니다. 비슷한 품질을 유지하면서 추론 성능을 높일 수 있습니다.
이 접근법을 연구하는 이유는 세 가지입니다.
- 효율성 향상. Mamba-2 같은 새 아키텍처는 Transformer와 셀프 어텐션보다 효율적인 대안입니다. 더 엄격한 성능 제약에서도 비슷한 품질을 내므로 높은 처리량의 추론과 온디바이스 배포에 중요합니다.
- 배포의 유연성. Transformer 생태계는 방대하며 오픈소스 커뮤니티에서는 매주 많은 모델을 공개합니다. 이 생태계를 새로운 아키텍처로 옮기면 사용자와 기업이 더 유연하게 배포하고 더 많은 선택지를 얻습니다.
- 소형 모델의 역량. 소형 모델도 계속 발전하는 분야입니다. 아키텍처 증류로 품질을 높일 수 있습니다. 대규모 사전 학습 모델의 역량을 더 적은 파라미터와 훨씬 낮은 비용으로 제공할 수 있습니다.
이번 연구는 사전 학습 비용의 일부만으로 빠르고 효율적인 모델을 만들 수 있음을 보여줍니다.
새 아키텍처 증류 방식 MOHAWK를 소개합니다. Transformer 같은 한 아키텍처를 Mamba-2 같은 다른 아키텍처로 바꾸는 데 사용할 수 있습니다. 이 방식으로 품질을 유지하면서 Transformer를 효율적인 Mamba-2 변형으로 바꿨습니다. 처음부터 사전 학습할 때보다 학습 데이터는 1000배 적게 사용했습니다.
MOHAWK 개요
MOHAWK 증류 프레임워크는 여러 단계에 걸쳐 표준 Transformer 백본의 지식을 효율적인 Mamba-2 백본에 정렬하고 전달합니다. 이 과정은 교사 모델의 핵심 역량을 유지하면서 Mamba-2 계층의 효율성을 활용하는 아키텍처로 바꿉니다.
원래 아키텍처에 몇 가지 변경을 가한 뒤 다단계 증류를 적용합니다.
- MLP 블록 교차 배치. Llama의 게이트 MLP와 Mamba-2 믹싱 계층을 번갈아 놓습니다. 성능을 유지하면서 시간축 믹싱 계층 수를 줄여 추론 처리량을 높이고, MLP가 없는 순수 Mamba-2 모델보다 메모리 사용량을 절반으로 줄입니다.
- 멀티헤드 구조 조정. 기존 모델은 속도를 높이기 위해 임베딩 가중치를 공유하는 그룹 쿼리 어텐션을 사용합니다. Llamba는 가중치를 공유하지 않는 멀티헤드 설계를 채택합니다. 특히 긴 문맥에서 상태 크기의 일관성을 달성하는 데 중요한 변경입니다.
- 비선형 연산과 이산화 최적화. 정렬을 방해할 수 있는 불필요한 정규화와 활성화 단계를 제거합니다. 입력 행렬을 직접 투영하는 Discrete-Mamba-2 변형을 사용해 추가 부담 없이 어텐션의 이산적 특성에 맞춥니다.
실제 온디바이스 구현
Apple의 Metal 프레임워크로 Mamba-2 커널을 최적화해 Apple Silicon의 GPU 병렬성과 통합 메모리 아키텍처를 충분히 활용합니다.
MLX 머신러닝 프레임워크와 통합해 동적 그래프 구성과 효율적인 텐서 연산을 지원합니다. 자원이 제한된 하드웨어의 4비트 양자화 환경에서도 일관되게 높은 처리량으로 모델을 실행할 수 있습니다.
Llamba 모델군
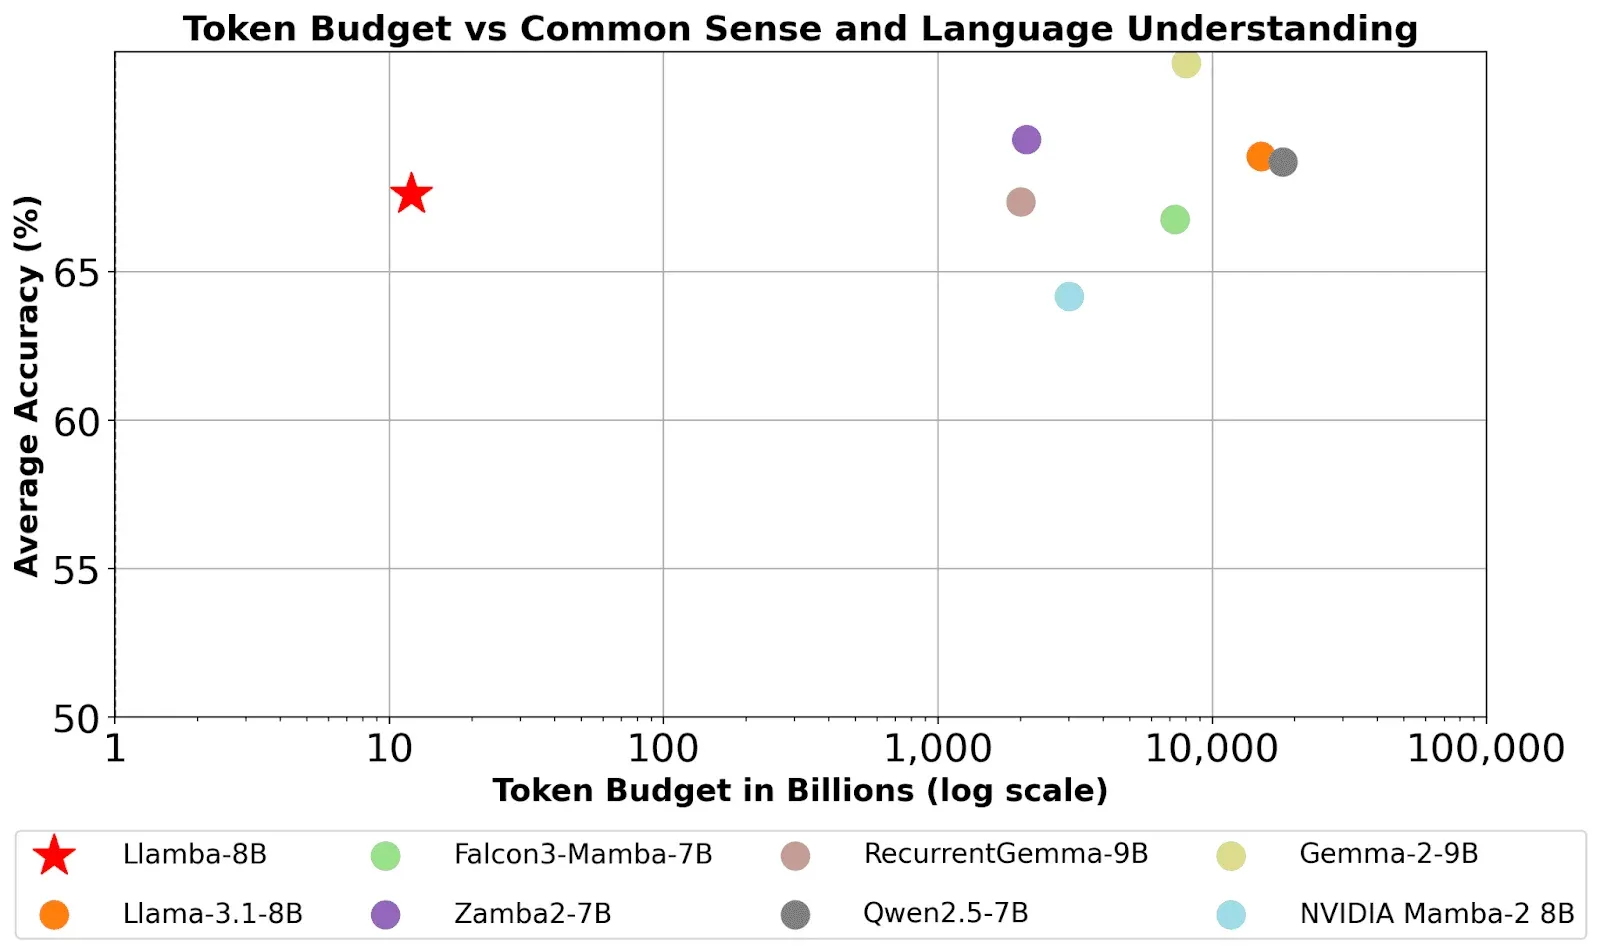
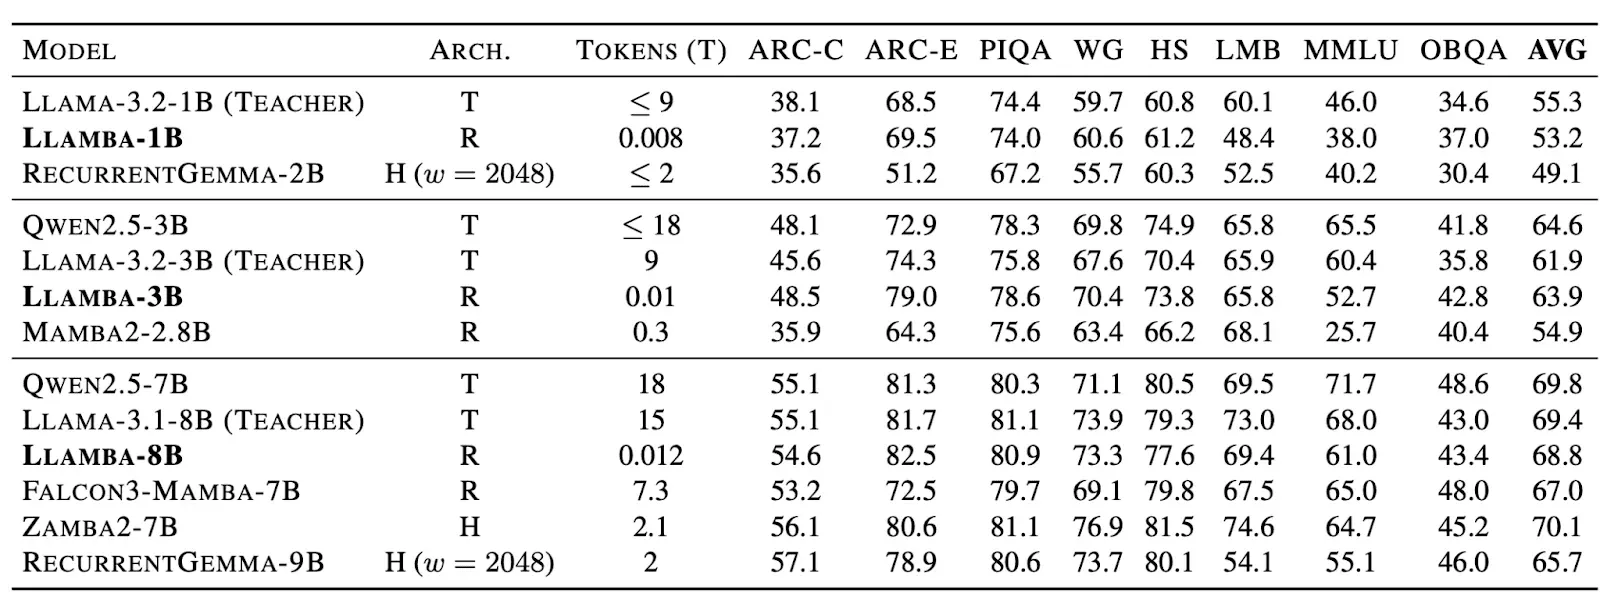
Llamba-1B, Llamba-3B, Llamba-8B의 가중치를 공개합니다. 해당 Llama-3.X 모델을 증류하고 다시 설계해 높은 효율성과 최신 수준의 성능을 제공합니다. 지금 Edge에서 사용할 수 있습니다.
Llamba 모델은 다양한 벤치마크에서 Transformer 기반 교사 모델과 비슷한 성능을 내면서 처리량도 크게 높입니다.
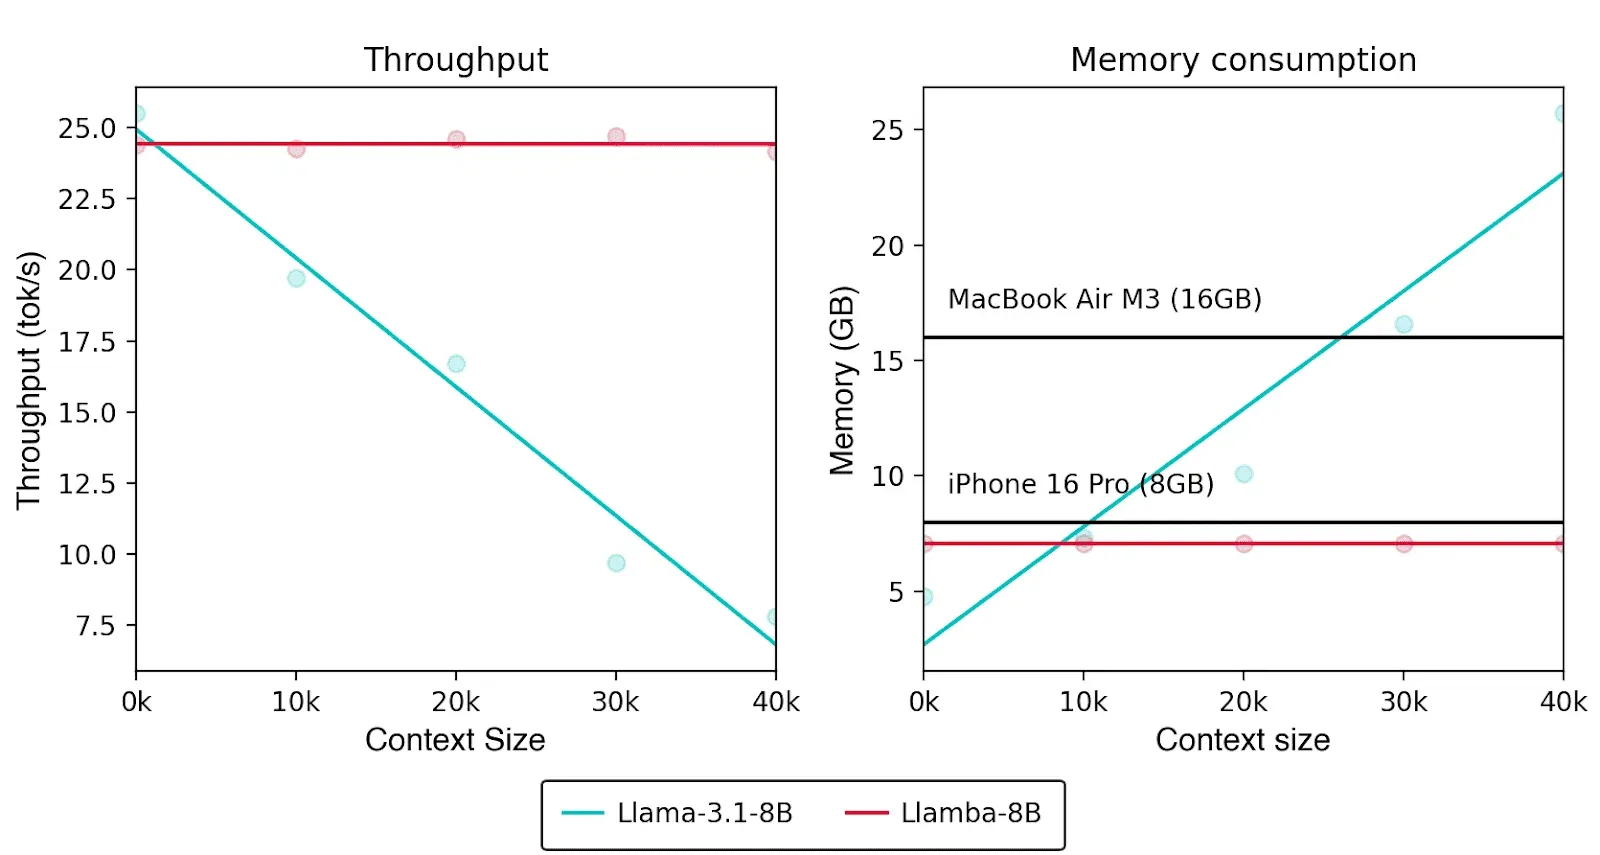
예를 들어 NVIDIA H100 80GB GPU에서 생성 길이 8192토큰으로 평가했을 때 Llamba-8B는 Llama-3.1-8B보다 최대 12배 높은 토큰 처리량을 기록했습니다. 이 성능 향상은 시퀀스 길이와 관계없이 상태 크기를 일정하게 유지하는 순환 Mamba-2 계층에서 나옵니다. 문맥이 길어져도 효율적으로 확장할 수 있습니다.
일반적으로 필요한 데이터와 연산의 일부만 사용해 어떤 모델이든 높은 처리량의 클라우드 추론이나 실시간 온디바이스 배포에 적합한 효율적인 변형으로 빠르게 바꿀 수 있습니다.
AI는 점점 더 분산되고 효율적인 방향으로 나아갑니다. 우리 팀은 아키텍처 증류와 딥러닝의 기본 아키텍처·알고리즘을 발전시키고 있습니다. 이 기술로 새로운 애플리케이션을 만들고 모든 기기에 똑똑하고 반응이 빠르며 쉽게 이용할 수 있는 AI를 제공하겠습니다.