


これからの数年で、デバイス上のAIは新たな時代を迎えます。スマートフォンの個人アシスタント、ARグラスのリアルタイム翻訳、家事を行う人型ロボットまで、幅広いアプリケーションをデバイス上のモデルが支えるようになります。
これは、主にクラウドでモデルを動かし、低レイテンシ、プライバシー、セキュリティに追加の費用がかかることの多い現在から、大きく変わることを意味します。
そのためには、高性能なモデルの効率を大幅に改善し、制約のあるさまざまなハードウェアでも利用できるようにする必要があります。
最新の技術報告「Llamba: Scaling Distilled Recurrent Models for Efficient Language Processing」では、アーキテクチャ蒸留について検討している新しい方法を説明しています。事前学習済みモデルを、より効率的な別のアーキテクチャに変換する手法です。同等の品質のモデルを、より高い性能で推論できます。
これらの方法を検討する理由は3つあります。
- 効率の改善: Mamba-2などの新しいアーキテクチャは、Transformerや自己注意機構より効率的な選択肢です。厳しい性能制約の下でも同等の品質を実現でき、高スループットの推論やデバイス上への展開に役立ちます。
- 配置の柔軟性: Transformerのエコシステムは大きく、オープンソースでは毎週多数のモデルが公開されます。それらを新しいアーキテクチャに移すことで、利用者や企業は配置方法やモデルの選択肢を増やせます。
- 小型モデルの能力: 小型モデルも進歩の最前線にあります。アーキテクチャ蒸留によって、大規模な事前学習済みモデルの能力を、少ないパラメーター数と低いコストで利用でき、小型モデルの品質を高められます。
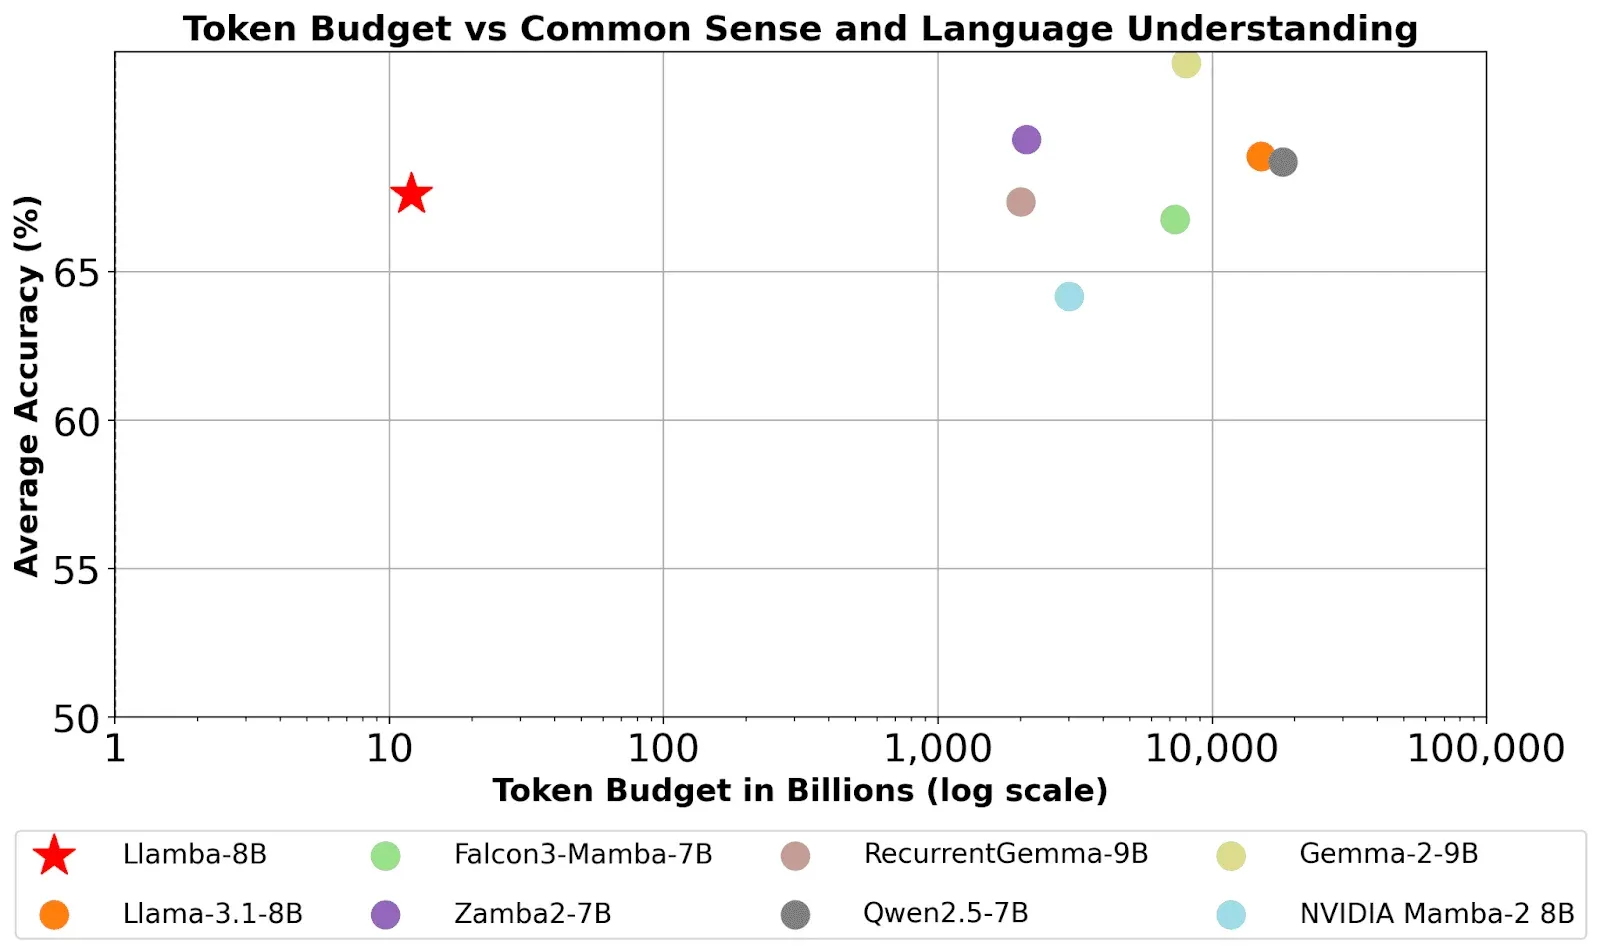
今回の研究では、アーキテクチャ蒸留によって、事前学習よりはるかに低いコストで、高速で効率的なモデルを構築できることを示しました。
MOHAWKという新しいアーキテクチャ蒸留の方法を紹介します。TransformerからMamba-2というように、異なるアーキテクチャへモデルを変換できます。この手法でTransformerを効率の高いMamba-2の変種に変換し、品質を保ちながら、ゼロから事前学習する場合の1,000分の1の学習データで実現しました。
MOHAWKの概要
MOHAWKは、複数の段階を通じて、標準的なTransformerの基盤から効率的なMamba-2の基盤へ知識を対応付け、移します。この段階的な処理により、教師モデルの中核的な能力を保ちながら、Mamba-2層の効率を利用するアーキテクチャへ変換できます。
元のアーキテクチャにいくつかの変更を加え、この多段階の蒸留手順を適用します。
- MLPブロックを交互に配置: Llamaのゲート付きMLPとMamba-2の混合層を交互に置きます。性能を保ちながら時間方向の混合層を減らし、MLPを持たない純粋なMamba-2モデルに比べ、推論スループットを高め、メモリ使用量を半分にします。
- マルチヘッド構造の変更: 従来のモデルは、速度向上のために、埋め込み重みを共有するグループ化クエリ注意機構を使います。Llambaは、共有しないマルチヘッド設計を採用します。特に長いコンテキストで、状態サイズの一貫性を保つために重要な変更です。
- 非線形性と離散化の最適化: 対応付けを妨げる不要な正規化や活性化を取り除きます。また、入力行列を直接射影するDiscrete-Mamba-2を採用し、追加の処理負荷なく注意機構の離散的な性質に合わせます。
デバイス上での実装
AppleのMetalフレームワークでMamba-2のカーネルを最適化し、Apple SiliconのGPU並列処理とユニファイドメモリアーキテクチャを活用できるようにしました。
機械学習フレームワークMLXとの統合により、動的なグラフ構築と効率的なテンソル演算が可能になりました。制約のあるハードウェアで4ビット量子化を使う場合でも、高いスループットを安定して維持できます。
Llambaモデル群
Llamba-1B、Llamba-3B、Llamba-8Bの重みを公開します。それぞれ対応するLlama-3.Xモデルを蒸留し、高い性能と効率を両立するよう再設計したものです。Edgeで今すぐ試せます。
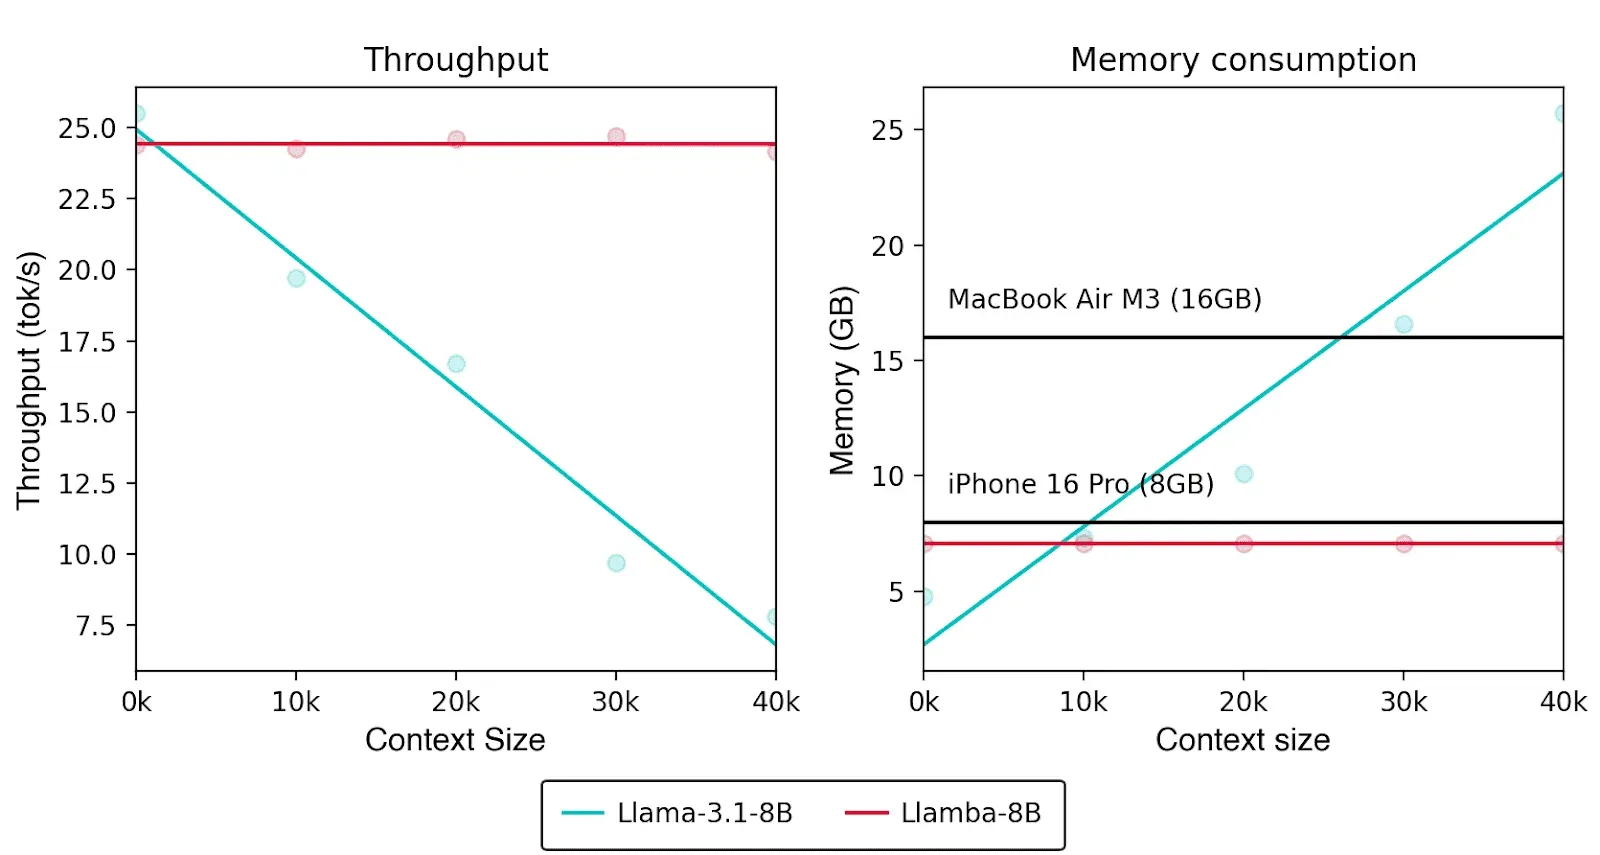
Llambaモデルは、幅広いベンチマークでTransformerの教師モデルと同等の性能を持つとともに、スループットも大きく向上しています。
たとえばNVIDIA H100 80GB GPUで、生成長を8192トークンにした評価では、Llamba-8BのスループットはLlama-3.1-8Bの最大12倍でした。再帰的なMamba-2層は、系列長にかかわらず状態サイズが一定です。そのため、コンテキストが長くなっても効率を保てます。
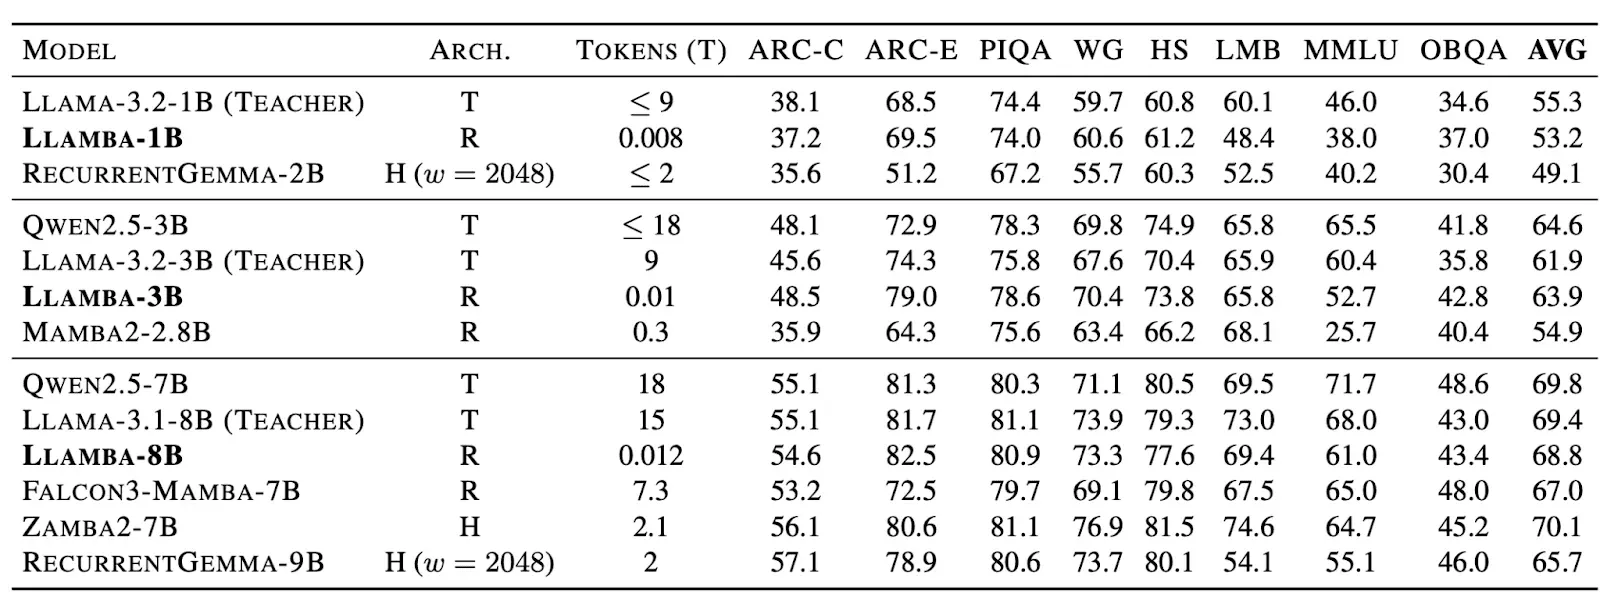
通常必要なデータと計算量のごく一部を使うこの方法で、モデルを短期間で効率の高い変種に変換できます。クラウドでの高スループット推論や、デバイス上でのリアルタイム実行に適したモデルです。
AIは、より分散し、効率を重視する方向へ進んでいます。私たちのチームは、アーキテクチャ蒸留と、深層学習の基礎となるアーキテクチャやアルゴリズムの研究を進めています。これらの技術で新しいアプリケーションをつくり、賢く、すぐに応答し、利用しやすいAIをあらゆるデバイスに届けたいと考えています。