


Os próximos anos darão início a uma nova era de IA no dispositivo. Esses modelos vão alimentar uma ampla variedade de aplicações, de assistentes pessoais no celular e tradutores em tempo real em óculos de realidade aumentada a robôs humanoides que realizam tarefas domésticas.
Isso representa uma grande mudança em relação ao cenário atual, em que os modelos rodam principalmente na nuvem e baixa latência, privacidade e segurança costumam ter um custo adicional.
Para viabilizar essa mudança, precisamos aumentar muito a eficiência dos modelos mais capazes, tornando-os acessíveis em uma variedade maior de ambientes com limitações de hardware.
Nosso relatório técnico mais recente, “Llamba: Scaling Distilled Recurrent Models for Efficient Language Processing”, descreve novas ideias que estamos explorando em destilação de arquitetura. Esse método transforma um modelo pré-treinado em uma arquitetura nova e mais eficiente, permitindo inferência de maior desempenho com qualidade semelhante.
Estamos explorando essas novas abordagens por três motivos principais.
- Ganhos de eficiência: novas arquiteturas, como Mamba-2, oferecem uma alternativa mais eficiente à arquitetura Transformer e à autoatenção. Elas permitem qualidade semelhante com restrições de desempenho mais rigorosas, algo essencial para inferência de alta vazão e implantações no dispositivo.
- Flexibilidade de implantação: o ecossistema de modelos Transformer é vasto, e a comunidade de código aberto lança muitos modelos toda semana. Levar esse ecossistema a um novo conjunto de arquiteturas dará a usuários e empresas mais flexibilidade de implantação e mais opções.
- Capacidades dos modelos pequenos: modelos pequenos continuam sendo uma fronteira de avanço, e as técnicas de destilação de arquitetura nos permitem melhorar sua qualidade. Podemos aproveitar as capacidades de grandes modelos pré-treinados e disponibilizá-las com menos parâmetros, por uma fração do custo.
Nossa nova pesquisa mostra que a destilação de arquitetura pode nos ajudar a construir modelos rápidos e eficientes por uma fração do custo do pré-treinamento.
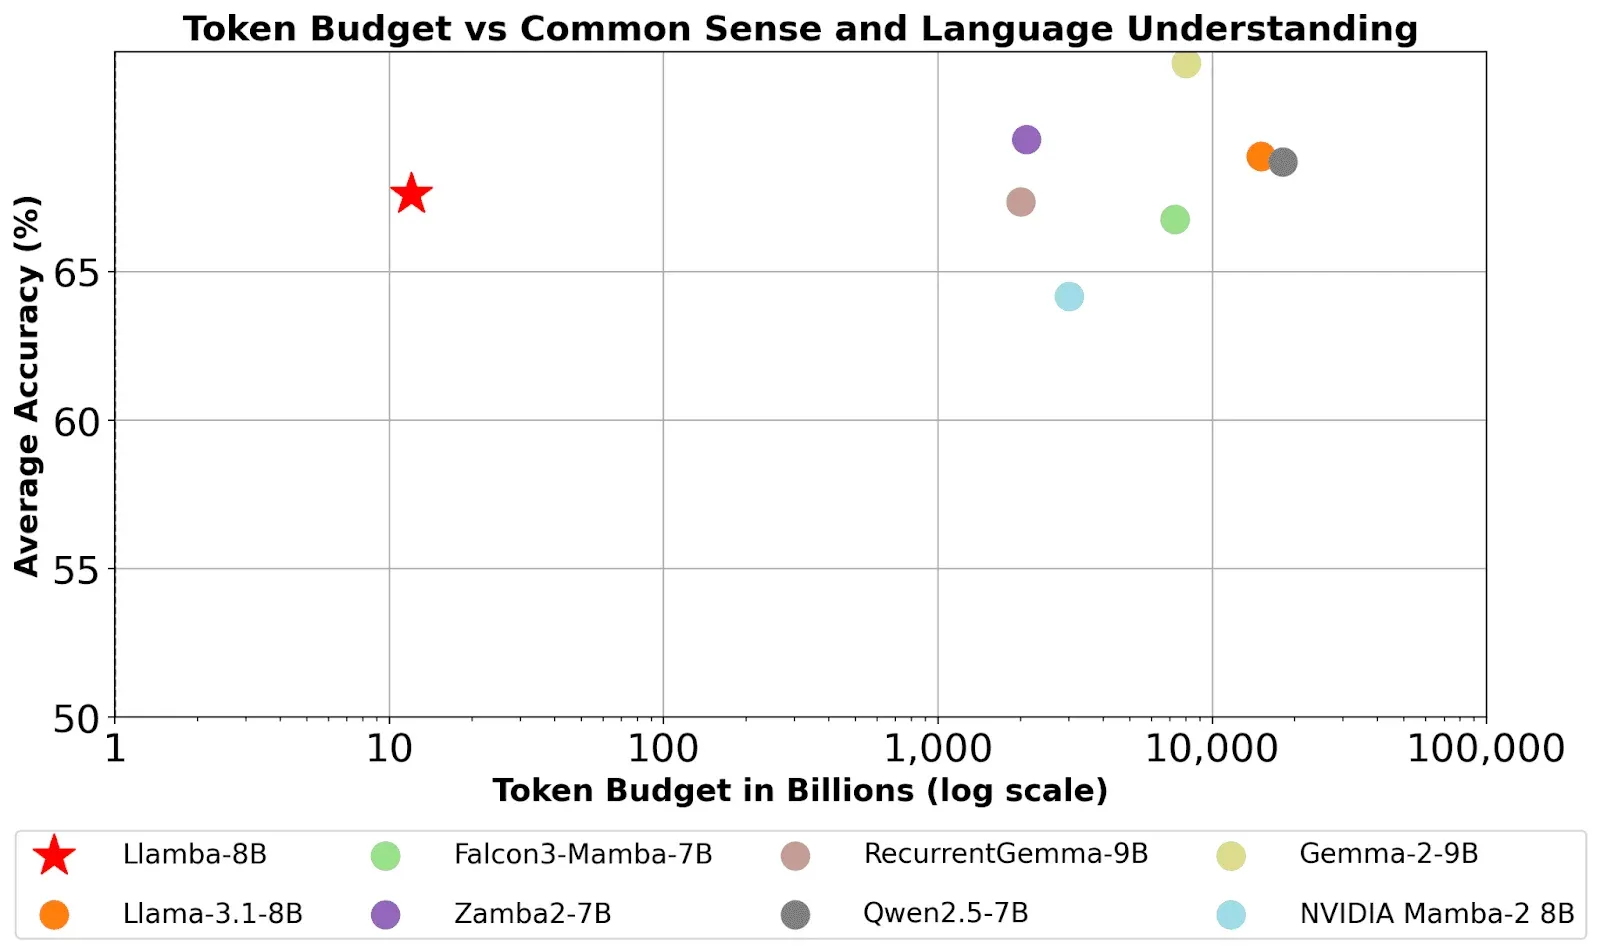
Apresentamos uma nova abordagem de destilação de arquitetura chamada MOHAWK. Ela permite converter modelos de uma arquitetura, como Transformer, para outra, como Mamba-2. Com essa técnica, convertemos modelos Transformer em variantes Mamba-2 altamente eficientes, preservando a qualidade e usando 1000x menos dados de treinamento do que no pré-treinamento do zero!
Visão geral do MOHAWK
Nossa abordagem usa o framework de destilação MOHAWK, que alinha e transfere conhecimento de uma estrutura Transformer padrão para uma estrutura Mamba-2 eficiente em várias etapas. Esse processo preserva as principais capacidades do modelo professor enquanto converte sua arquitetura em uma que aproveita a eficiência das camadas Mamba-2.
Fazemos algumas modificações na arquitetura original e aplicamos essa receita de destilação em várias etapas.
- Blocos MLP alternados: ao intercalar os componentes MLP com portas do Llama com camadas de mistura Mamba-2, mantemos o desempenho e reduzimos o número de camadas de mistura temporal. Isso aumenta a vazão de inferência e reduz o uso de memória em 2x em comparação com modelos Mamba-2 puros, sem MLPs.
- Adaptação da estrutura de múltiplas cabeças: modelos tradicionais usam atenção com consultas agrupadas e pesos de embeddings compartilhados para aumentar a velocidade. Nossos modelos Llamba adotam, em vez disso, uma estrutura de múltiplas cabeças sem esse compartilhamento. Essa modificação é essencial para manter a consistência do tamanho do estado, especialmente em cenários de contexto longo.
- Não linearidades e discretização otimizadas: removemos etapas desnecessárias de normalização e ativação que poderiam prejudicar o alinhamento. Também adotamos uma variante Discrete-Mamba-2 que projeta diretamente as matrizes de entrada, garantindo que o modelo corresponda à natureza discreta da atenção sem custo adicional.
Uma implementação prática no dispositivo
Otimizamos os kernels Mamba-2 com o framework Metal da Apple, permitindo que nossos modelos aproveitem todo o paralelismo da GPU e a arquitetura de memória unificada do Apple Silicon.
Nossa integração com o framework de aprendizado de máquina MLX permite construir grafos dinamicamente e executar operações eficientes com tensores. Isso possibilita rodar esses modelos com vazão alta e consistente, mesmo com quantização de 4 bits em hardware limitado.
A família de modelos Llamba
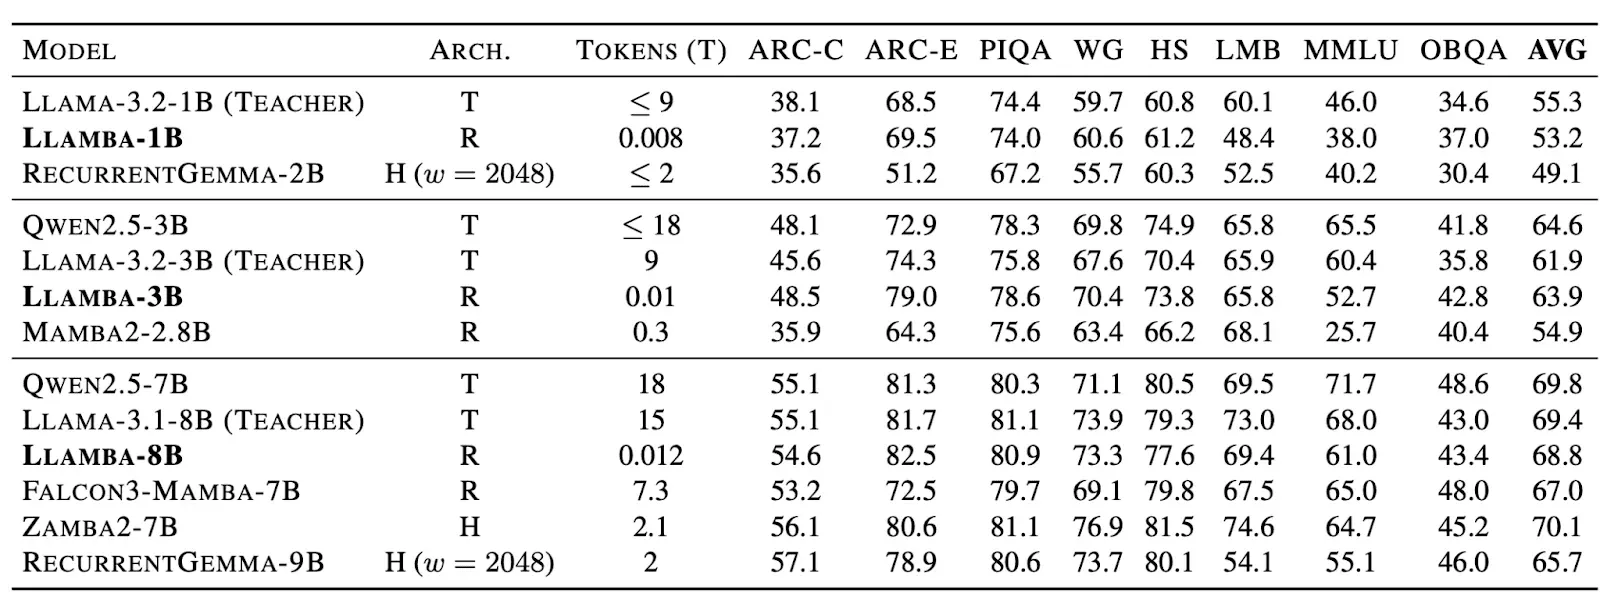
Estamos disponibilizando os pesos de uma nova família de modelos: Llamba-1B, Llamba-3B e Llamba-8B. São variantes destiladas dos modelos Llama-3.X correspondentes, reprojetadas para oferecer desempenho de ponta com grande eficiência. Você já pode experimentá-las no Edge.
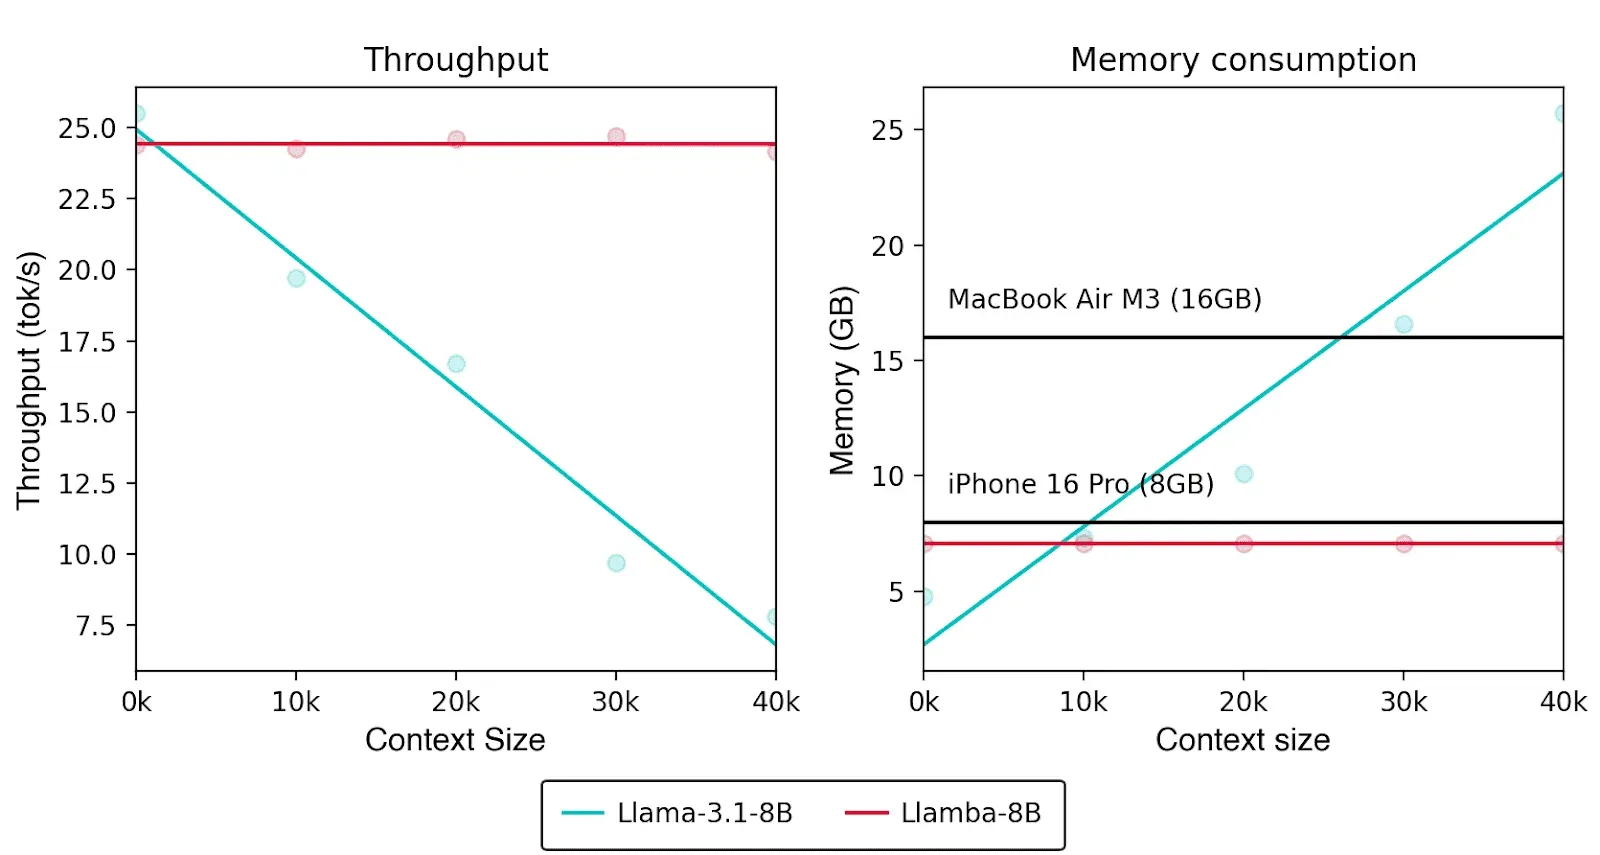
Os modelos Llamba igualam seus professores baseados em Transformer em uma ampla variedade de benchmarks e também oferecem ganhos expressivos de vazão.
Por exemplo, em uma GPU NVIDIA H100 80GB, com geração de 8192 tokens, o Llamba-8B processou tokens com vazão até 12X maior que o Llama-3.1-8B. Esse ganho vem das camadas recorrentes Mamba-2 do Llamba, cujo tamanho de estado permanece constante independentemente do comprimento da sequência. Isso permite escalar com eficiência mesmo quando o contexto aumenta.
Usando uma pequena fração dos dados e da computação normalmente necessários, nossa abordagem permite converter rapidamente qualquer modelo em uma variante eficiente, pronta para inferência de alta vazão na nuvem ou implantação em tempo real no dispositivo.
O futuro da IA caminha cada vez mais para a descentralização e a eficiência. Nossa equipe está avançando na destilação de arquitetura e inovando nas arquiteturas e nos algoritmos fundamentais do aprendizado profundo. Queremos usar essas tecnologias para criar uma nova geração de aplicações, levando IA inteligente, responsiva e acessível a todos os dispositivos.