


I prossimi anni apriranno una nuova fase dell’IA sui dispositivi. Questi modelli supporteranno molte applicazioni: assistenti personali sul telefono, traduttori in tempo reale negli occhiali AR e robot umanoidi che svolgono le faccende di casa.
È un cambiamento importante rispetto al paradigma attuale, in cui i modelli funzionano soprattutto nel cloud e bassa latenza, privacy e sicurezza spesso hanno un costo aggiuntivo.
Per rendere possibile questo cambiamento, dobbiamo aumentare molto l’efficienza dei modelli capaci, rendendoli accessibili su più tipi di hardware con risorse limitate.
Il nostro ultimo rapporto tecnico, “Llamba: Scaling Distilled Recurrent Models for Efficient Language Processing”, descrive nuove idee che stiamo esplorando nella distillazione delle architetture. Questo metodo trasforma un modello preaddestrato in una nuova architettura più efficiente, migliorando l’inferenza con qualità simile.
Esploriamo questi approcci per tre motivi principali.
- Efficienza. Architetture come Mamba-2 offrono un’alternativa più efficiente ai Transformer e alla self-attention. Mantengono una qualità simile con vincoli di prestazioni più severi, un aspetto essenziale per inferenza ad alto throughput e distribuzione sui dispositivi.
- Flessibilità di distribuzione. L’ecosistema Transformer è vasto e la comunità open source pubblica molti modelli ogni settimana. Portare questo ecosistema su nuove architetture offrirà più flessibilità e scelta a utenti e aziende.
- Capacità dei modelli piccoli. I modelli piccoli continuano a essere un’area di progresso e la distillazione delle architetture ci aiuta a migliorarne la qualità. Possiamo sfruttare le capacità di grandi modelli preaddestrati e renderle disponibili con meno parametri, a una frazione del costo.
La nostra ricerca mostra che la distillazione delle architetture permette di costruire modelli veloci ed efficienti a una frazione del costo del preaddestramento.
Presentiamo MOHAWK, un nuovo approccio alla distillazione delle architetture. Può convertire modelli da un’architettura, per esempio Transformer, a un’altra, come Mamba-2. Con questa tecnica convertiamo i Transformer in varianti Mamba-2 molto efficienti mantenendo la qualità e usando 1000 volte meno dati di addestramento rispetto al preaddestramento da zero.
Come funziona MOHAWK
Il nostro approccio si basa sul framework di distillazione MOHAWK, che allinea e trasferisce conoscenza da una struttura Transformer standard a una struttura Mamba-2 efficiente attraverso più fasi. Questo processo conserva le capacità principali del modello insegnante, convertendone l’architettura per sfruttare l’efficienza dei livelli Mamba-2.
Modifichiamo alcuni elementi dell’architettura originale e applichiamo questa procedura di distillazione in più fasi.
- Blocchi MLP alternati. Intercalando i componenti MLP con gating di Llama con i livelli di mescolamento Mamba-2, manteniamo le prestazioni e riduciamo il numero di livelli di mescolamento temporale. Questo aumenta il throughput di inferenza e dimezza l’uso di memoria rispetto ai modelli Mamba-2 puri senza MLP.
- Adattamento della struttura multi-head. I modelli tradizionali usano grouped-query attention con pesi di embedding condivisi per aumentare la velocità. Llamba adotta invece una struttura multi-head non condivisa. Questa modifica è essenziale per mantenere coerente la dimensione dello stato, soprattutto con contesti lunghi.
- Non linearità e discretizzazione ottimizzate. Rimuoviamo passaggi non necessari di normalizzazione e attivazione che potrebbero ostacolare l’allineamento e adottiamo una variante Discrete-Mamba-2 che proietta direttamente le matrici di input. Il modello corrisponde così alla natura discreta dell’attenzione senza costi aggiuntivi.
Un’implementazione pratica sui dispositivi
Abbiamo ottimizzato i kernel Mamba-2 con il framework Metal di Apple, così i modelli sfruttano appieno il parallelismo GPU e l’architettura di memoria unificata di Apple Silicon.
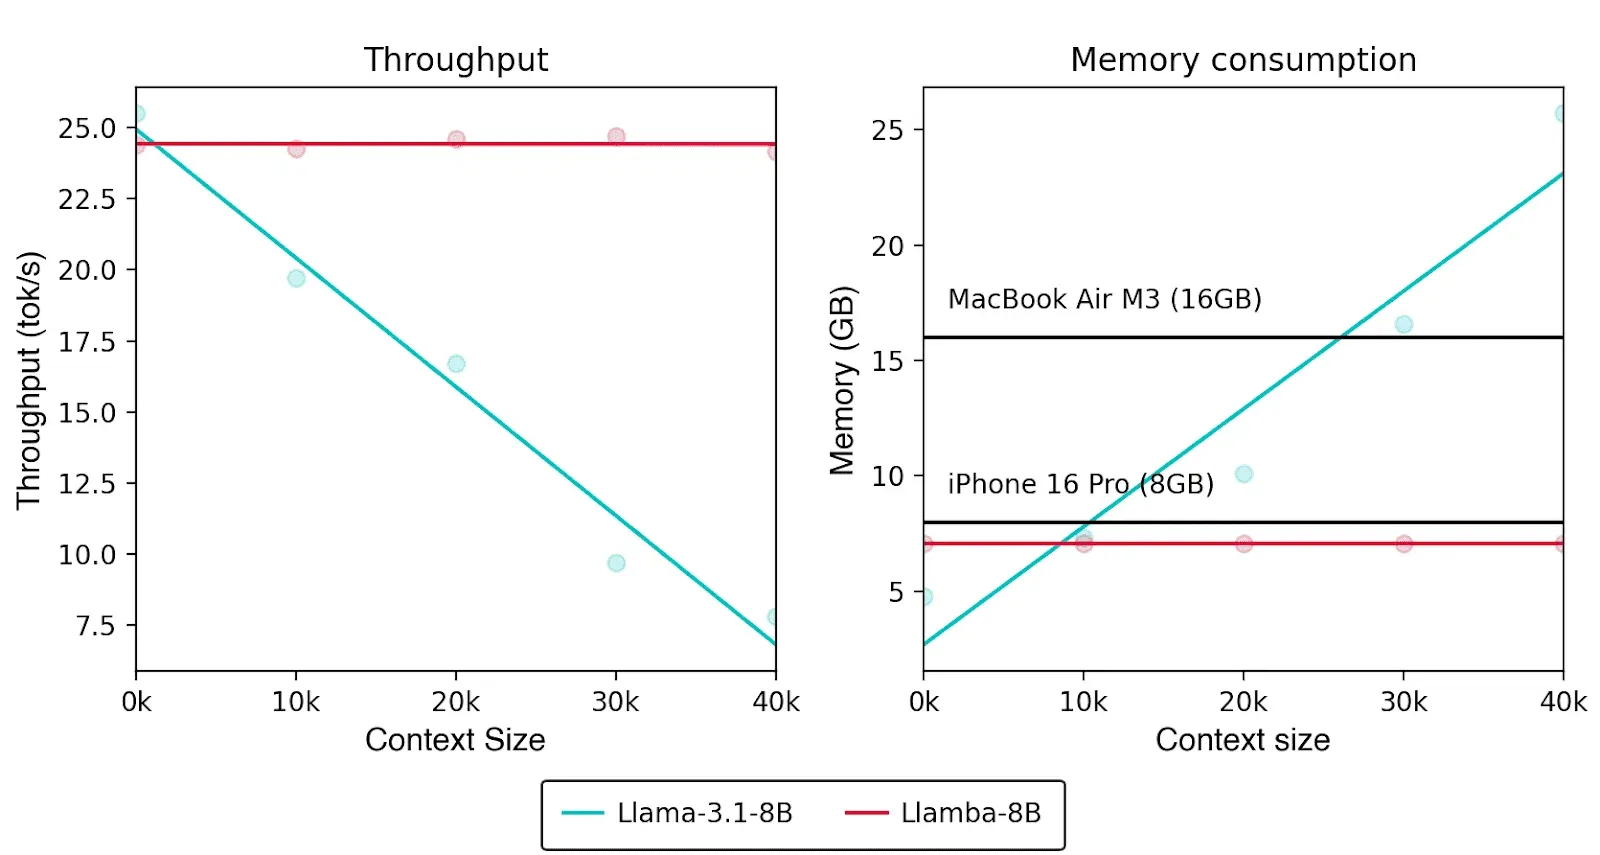
L’integrazione con il framework di machine learning MLX permette di costruire grafi dinamici ed eseguire operazioni efficienti sui tensori. Questi modelli mantengono così un throughput elevato anche con quantizzazione a 4 bit su hardware limitato.
La famiglia di modelli Llamba
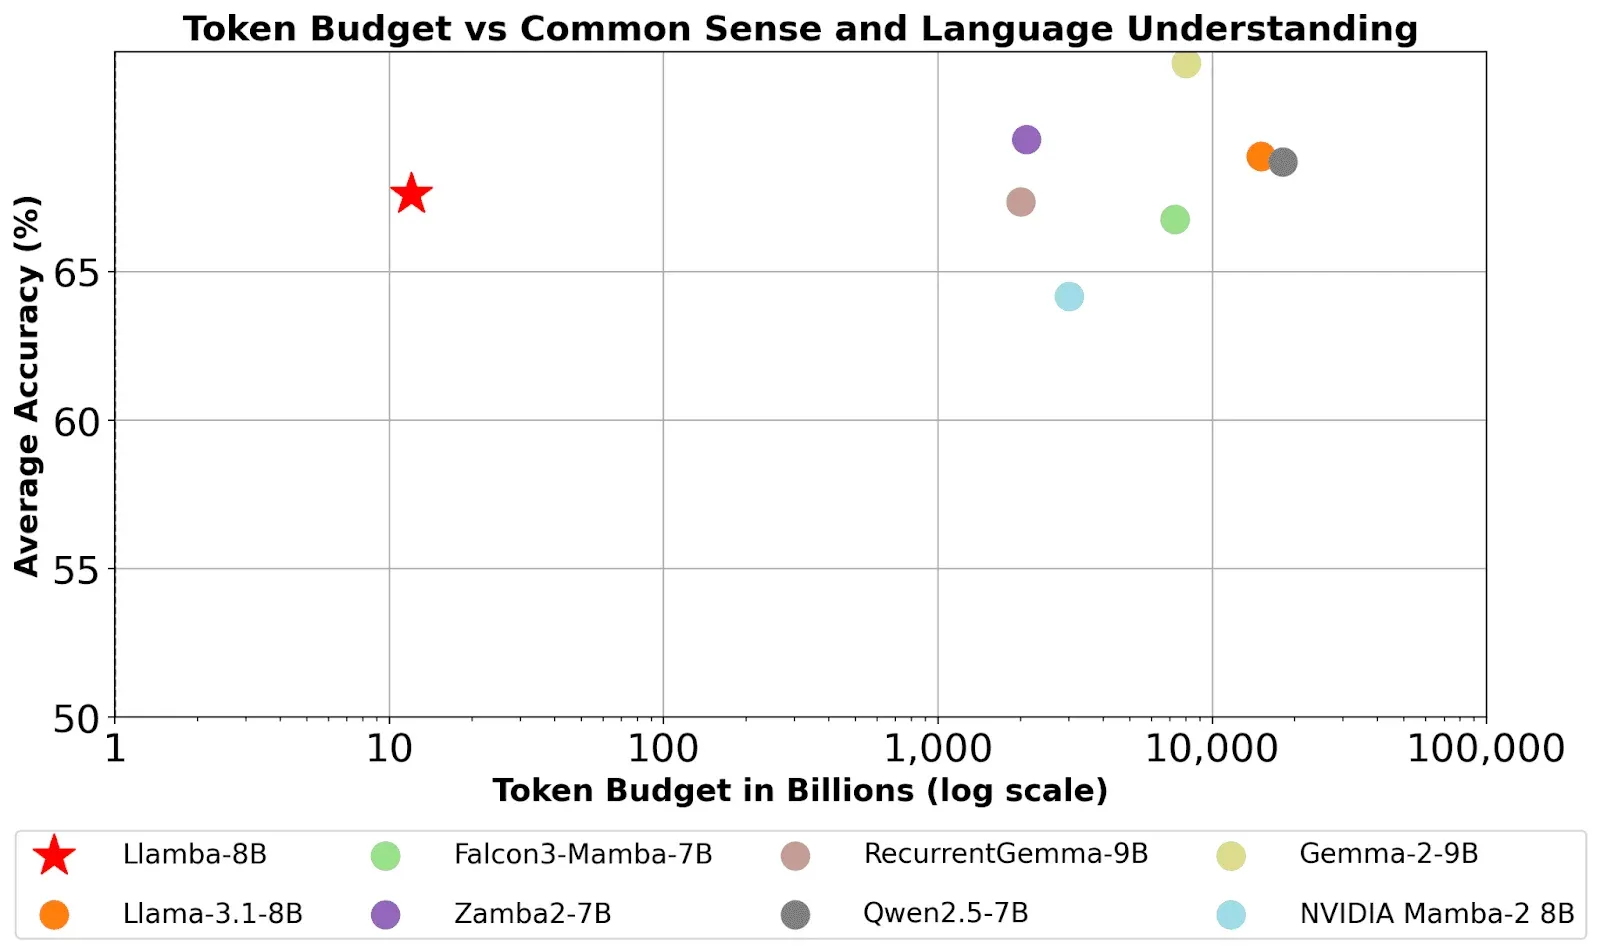
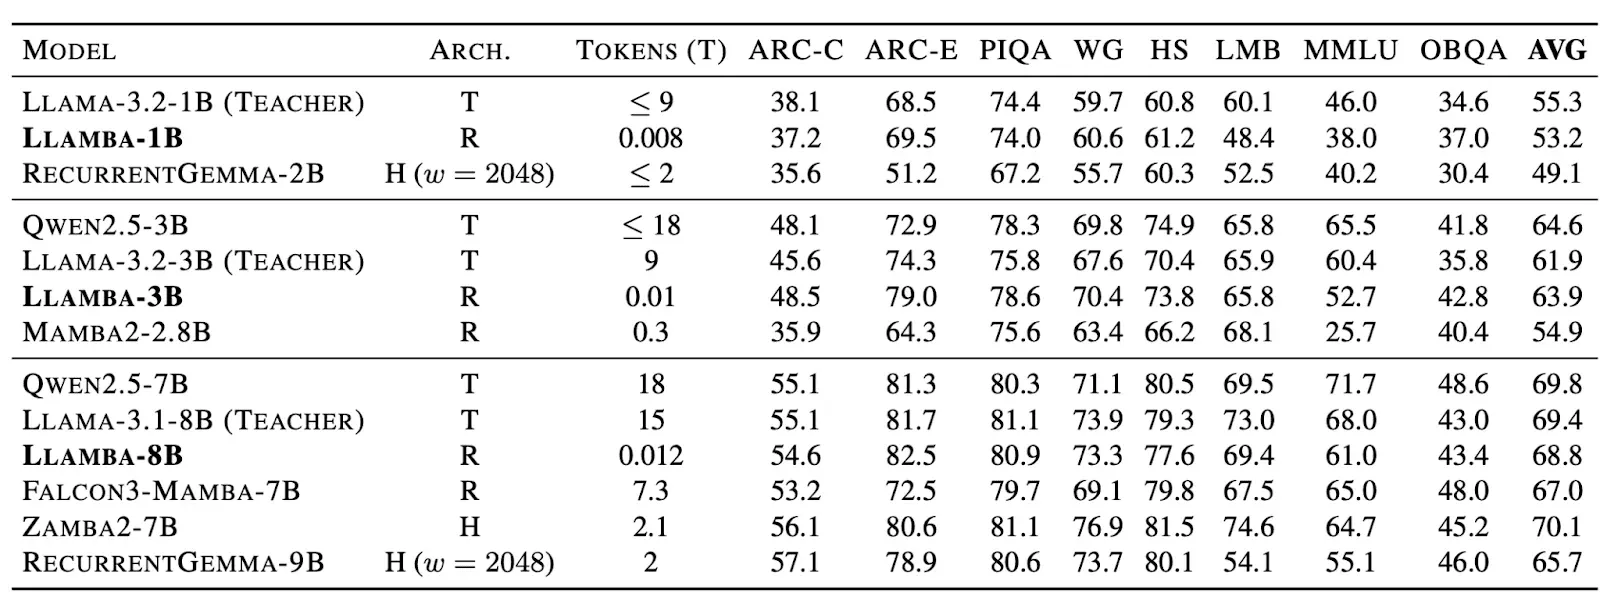
Rendiamo disponibili i pesi di una nuova famiglia: Llamba-1B, Llamba-3B e Llamba-8B. Sono varianti distillate dei corrispondenti modelli Llama-3.X, riprogettate per offrire prestazioni avanzate con grande efficienza. Puoi provarle oggi su Edge.
I modelli Llamba raggiungono i risultati dei loro insegnanti Transformer su molti benchmark e offrono importanti miglioramenti di throughput.
Per esempio, su una GPU NVIDIA H100 80GB, Llamba-8B con una lunghezza di generazione di 8192 token ha raggiunto un throughput fino a 12 volte superiore a Llama-3.1-8B. Il vantaggio deriva dai livelli ricorrenti Mamba-2 di Llamba, il cui stato mantiene dimensioni costanti indipendentemente dalla lunghezza della sequenza, rendendo efficiente la crescita del contesto.
Usando una piccola frazione dei dati e del calcolo normalmente necessari, il nostro approccio permette di convertire rapidamente qualsiasi modello in una variante efficiente, pronta per inferenza cloud ad alto throughput o esecuzione in tempo reale sui dispositivi.
Il futuro dell’IA si sposta sempre più verso decentralizzazione ed efficienza. Il nostro team fa progressi nella distillazione delle architetture e innova le architetture e gli algoritmi di base del deep learning. Vogliamo usare queste tecnologie per creare nuove applicazioni e portare un’IA intelligente, reattiva e accessibile su ogni dispositivo.