


Los próximos años abrirán una nueva etapa de IA en el dispositivo. Los modelos locales permitirán aplicaciones muy diversas, desde asistentes personales en el móvil hasta traductores en tiempo real en gafas de realidad aumentada y robots humanoides que realizan tareas cotidianas en casa.
Esto supone un cambio importante respecto al enfoque actual, en el que los modelos se ejecutan principalmente en la nube y reducir la latencia o mejorar la privacidad y la seguridad suele tener un coste adicional.
Para hacerlo posible, necesitamos aumentar drásticamente la eficiencia de los modelos capaces y llevarlos a más entornos de hardware con recursos limitados.
Nuestro último informe técnico, “Llamba: Scaling Distilled Recurrent Models for Efficient Language Processing”, describe nuevas ideas que exploramos en destilación de arquitecturas. Este método transforma un modelo preentrenado en una arquitectura nueva y más eficiente, lo que mejora la inferencia manteniendo una calidad similar.
Exploramos estos enfoques por tres motivos principales.
- Mejoras de eficiencia: nuevas arquitecturas como Mamba-2 ofrecen una alternativa más eficiente a Transformer y a la autoatención. Permiten mantener una calidad similar bajo restricciones de rendimiento más exigentes, algo necesario para la inferencia con gran capacidad de procesamiento y los despliegues en el dispositivo.
- Flexibilidad de despliegue: existe un gran número de modelos Transformer y cada semana la comunidad de código abierto publica más. Llevar estos modelos a otras arquitecturas dará más opciones y flexibilidad a usuarios y empresas.
- Capacidades de los modelos pequeños: los modelos pequeños siguen avanzando, y la destilación de arquitecturas permite mejorar su calidad. Podemos aprovechar las capacidades de grandes modelos preentrenados y ofrecerlas con menos parámetros y una fracción del coste.
Nuestra investigación demuestra que la destilación de arquitecturas permite crear modelos rápidos y eficientes por una fracción del coste del preentrenamiento.
Presentamos MOHAWK, un nuevo enfoque para destilar arquitecturas. Permite convertir modelos de una arquitectura, como Transformer, a otra, como Mamba-2. Aplicando esta técnica convertimos Transformers en variantes Mamba-2 muy eficientes, conservando la calidad y utilizando 1.000 veces menos datos de entrenamiento que al preentrenar desde cero.
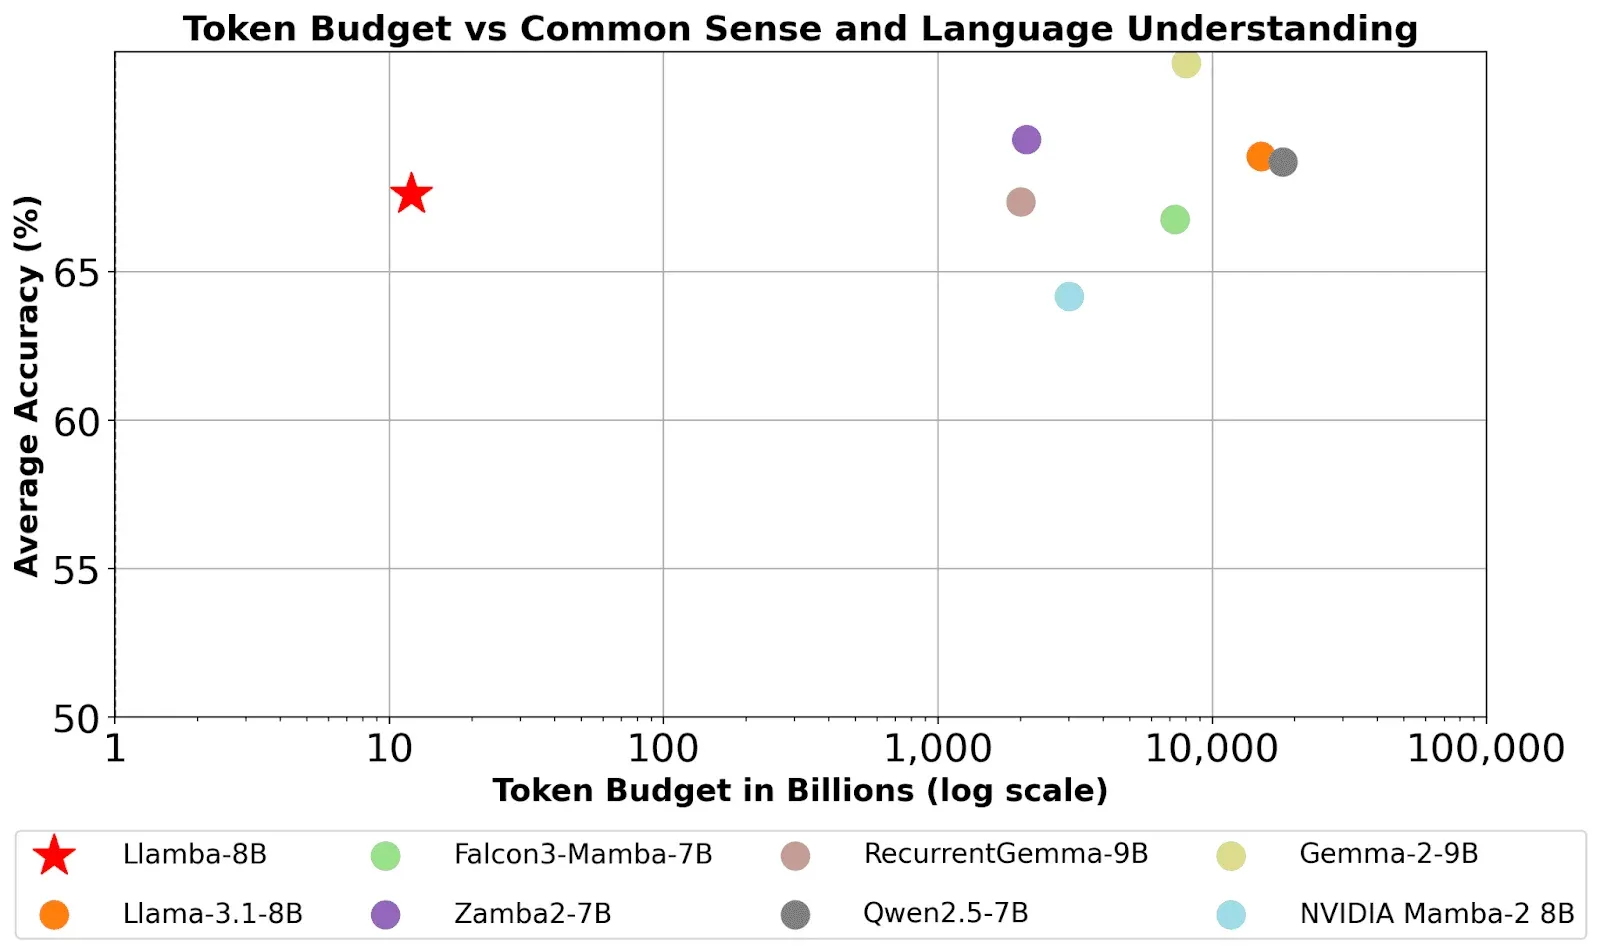
Descripción de MOHAWK
Nuestro enfoque utiliza el sistema de destilación MOHAWK, que alinea y transfiere conocimientos de una arquitectura base Transformer a una Mamba-2 eficiente mediante varias etapas. Este proceso conserva las capacidades principales del modelo profesor mientras convierte su arquitectura para aprovechar la eficiencia de las capas Mamba-2.
Introducimos algunos cambios en la arquitectura original y aplicamos este proceso de destilación por etapas.
- Bloques MLP alternos: al intercalar los componentes MLP con compuertas de Llama y las capas de mezcla Mamba-2, mantenemos el rendimiento y reducimos el número de capas de mezcla temporal. Esto aumenta la capacidad de inferencia y reduce a la mitad el uso de memoria frente a modelos Mamba-2 puros sin MLP.
- Adaptación de la estructura multicabeza: los modelos tradicionales utilizan atención de consultas agrupadas con pesos de embeddings compartidos para acelerar la ejecución. Nuestros modelos Llamba adoptan un diseño multicabeza sin pesos compartidos. Este cambio permite mantener constante el tamaño del estado, especialmente con contextos largos.
- No linealidades y discretización optimizadas: eliminamos pasos innecesarios de normalización y activación que podrían dificultar la alineación y utilizamos una variante Discrete-Mamba-2 que proyecta directamente las matrices de entrada. Así, el modelo se ajusta a la naturaleza discreta de la atención sin añadir sobrecarga.
Una implementación práctica en el dispositivo
Hemos optimizado los kernels Mamba-2 con el framework Metal de Apple para que los modelos aprovechen el paralelismo de la GPU y la memoria unificada de Apple Silicon.
La integración con el framework de aprendizaje automático MLX permite construir grafos dinámicos y ejecutar operaciones eficientes con tensores. Así, estos modelos mantienen una capacidad de procesamiento elevada incluso con cuantización a 4 bits en hardware limitado.
La familia de modelos Llamba
Publicamos los pesos de una nueva familia de modelos: Llamba-1B, Llamba-3B y Llamba-8B. Son variantes destiladas de los modelos Llama-3.X correspondientes, rediseñadas para ofrecer rendimiento avanzado con gran eficiencia. Puedes probarlos hoy en Edge.
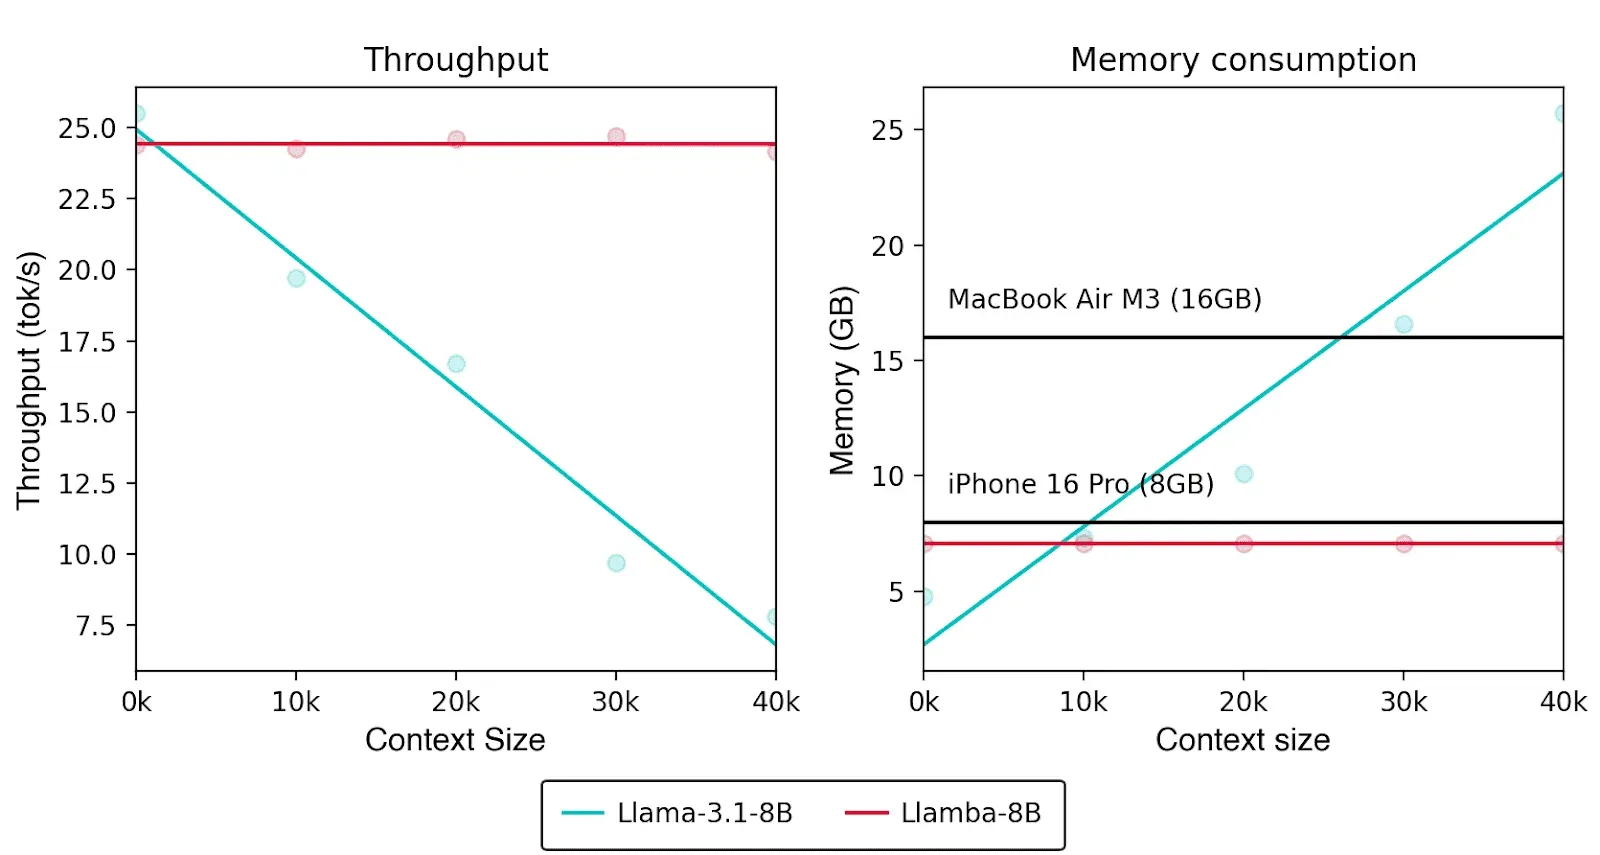
Los modelos Llamba igualan a sus profesores Transformer en numerosas pruebas y, además, mejoran considerablemente la capacidad de procesamiento.
Por ejemplo, al evaluarlo en una GPU NVIDIA H100 de 80 GB con una longitud de generación de 8192 tokens, Llamba-8B procesó tokens con una capacidad hasta 12 veces superior a Llama-3.1-8B. Esta mejora procede de sus capas recurrentes Mamba-2, cuyo estado mantiene un tamaño constante independientemente de la longitud de la secuencia. Eso permite escalar de forma eficiente incluso cuando aumenta el contexto.
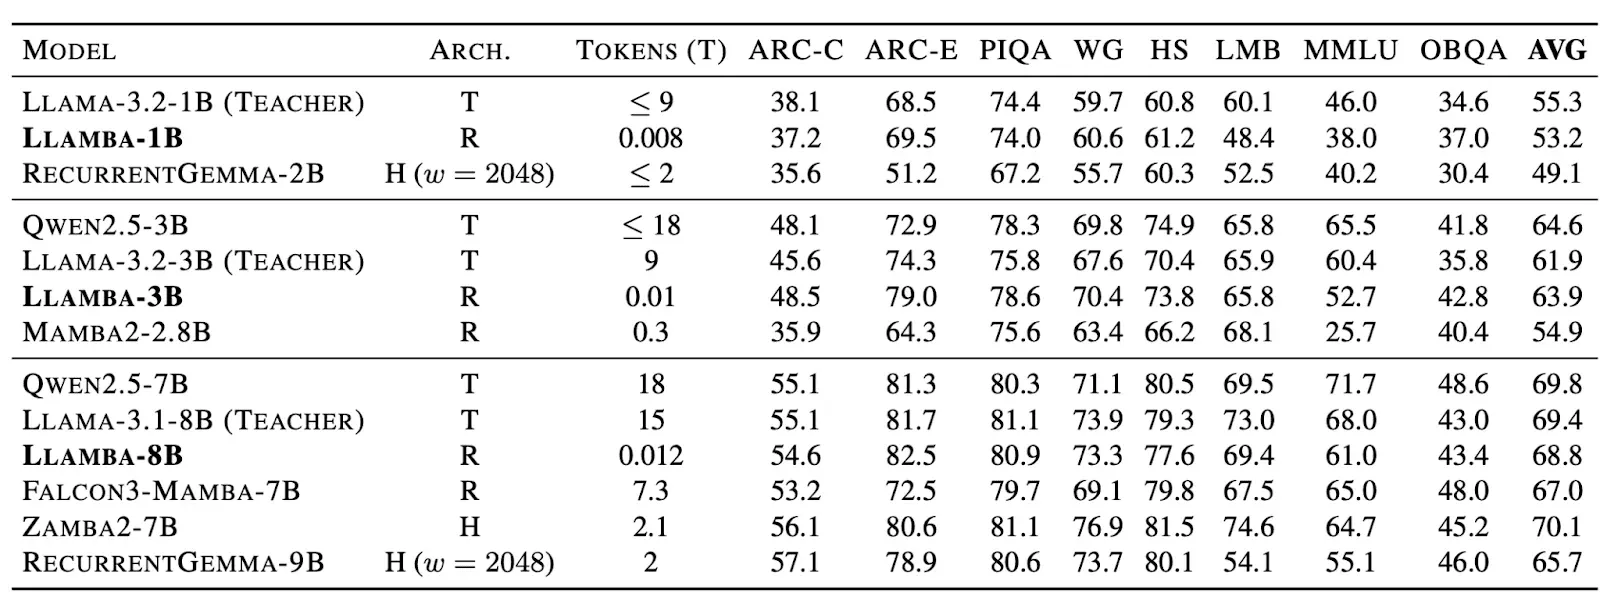
Con una pequeña fracción de los datos y del cómputo habituales, nuestro enfoque permite convertir rápidamente cualquier modelo en una variante eficiente, lista para inferencia de gran capacidad en la nube o despliegues en tiempo real en el dispositivo.
El futuro de la IA avanza hacia la descentralización y la eficiencia. Nuestro equipo está progresando en destilación de arquitecturas e innovando en las arquitecturas y algoritmos fundamentales del aprendizaje profundo. Queremos utilizar estas tecnologías para crear nuevas aplicaciones y llevar IA inteligente, receptiva y accesible a todos los dispositivos.