


Les prochaines années ouvriront une nouvelle ère de l’IA sur appareil. Les modèles embarqués alimenteront de nombreuses applications : assistants personnels sur téléphone, traducteurs en temps réel dans des lunettes de réalité augmentée et robots humanoïdes accomplissant les tâches quotidiennes à domicile.
C’est un changement majeur par rapport à l’approche actuelle, où les modèles fonctionnent principalement dans le cloud et où la latence, la confidentialité et la sécurité ont souvent un coût supplémentaire.
Pour permettre ce changement, nous devons améliorer fortement l’efficacité des modèles les plus capables afin de les rendre accessibles dans davantage d’environnements matériels contraints.
Notre dernier rapport technique, “Llamba: Scaling Distilled Recurrent Models for Efficient Language Processing”, décrit de nouvelles pistes que nous explorons en distillation d’architecture. Cette méthode transforme un modèle préentraîné en une nouvelle architecture plus efficace, permettant une inférence plus performante avec une qualité similaire.
Trois raisons principales nous conduisent à explorer ces approches.
- Gains d’efficacité : de nouvelles architectures comme Mamba-2 offrent une solution plus efficace que l’architecture Transformer et l’auto-attention. Elles permettent une qualité similaire sous des contraintes de performance plus strictes, ce qui compte pour l’inférence à haut débit et les déploiements sur appareil.
- Souplesse de déploiement : l’écosystème des Transformers est vaste et la communauté open source publie de nombreux modèles chaque semaine. Transférer cet écosystème vers de nouvelles architectures donnera davantage de souplesse de déploiement et de choix aux utilisateurs et aux entreprises.
- Capacités des petits modèles : les petits modèles restent un domaine de progrès, et les techniques de distillation d’architecture nous permettent d’améliorer leur qualité. Nous pouvons exploiter les capacités de grands modèles préentraînés et les rendre disponibles avec moins de paramètres, pour une fraction du coût.
Nos nouveaux travaux montrent que la distillation d’architecture peut produire des modèles rapides et efficaces pour une fraction du coût d’un préentraînement.
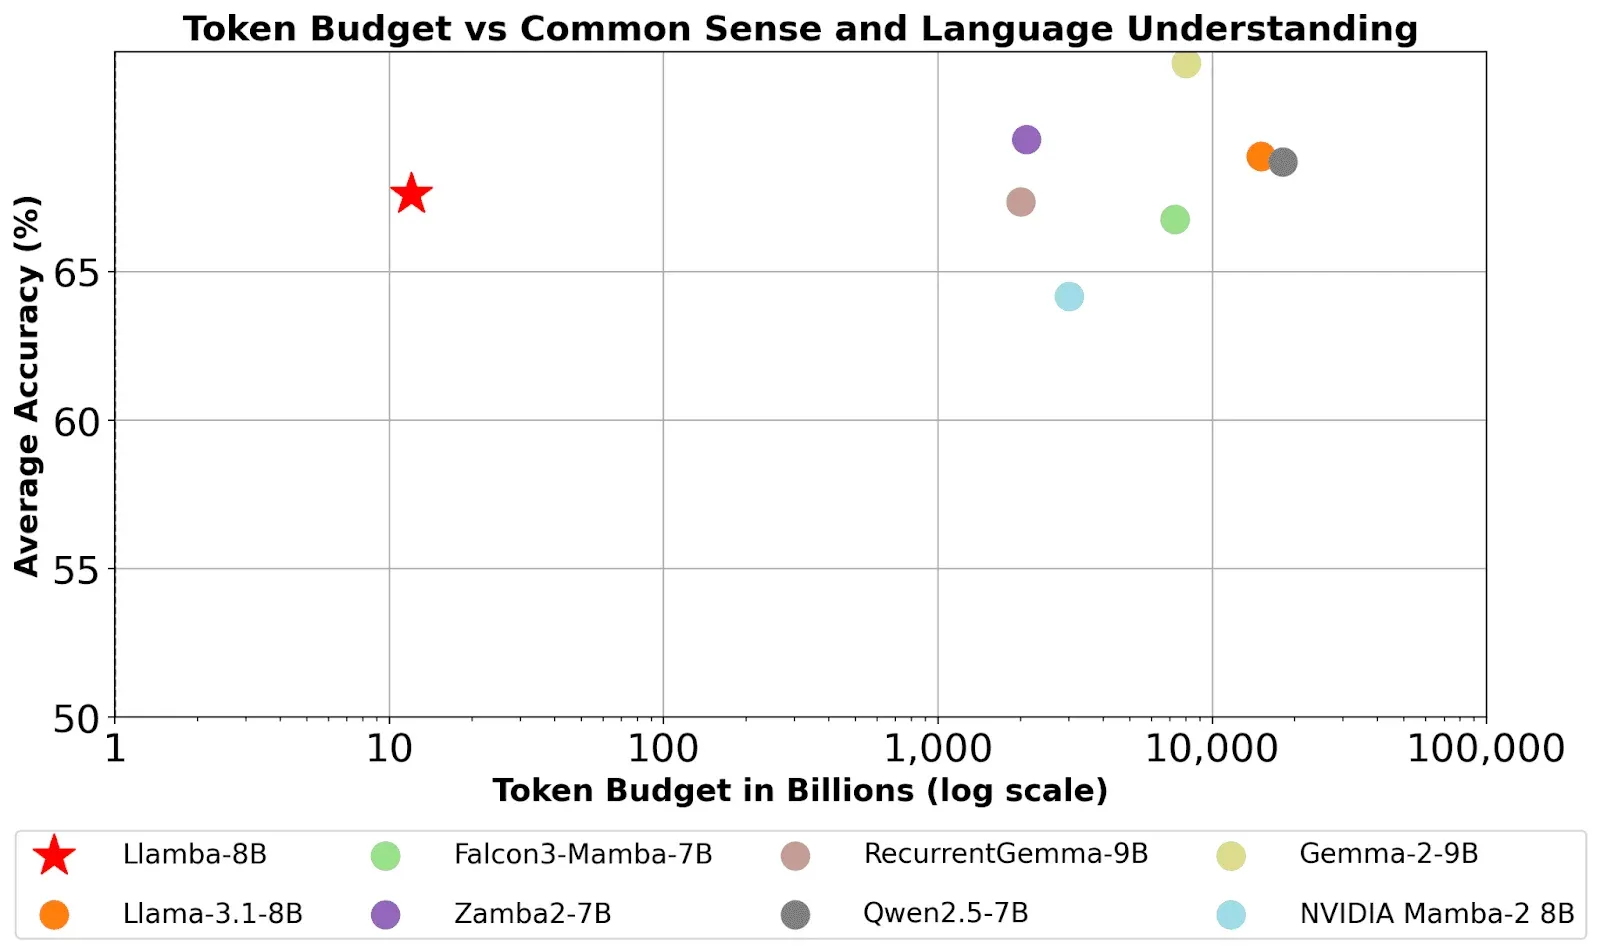
Nous présentons MOHAWK, une nouvelle approche de distillation d’architecture. Elle permet de convertir un modèle d’une architecture, comme Transformer, vers une autre, comme Mamba-2. Nous convertissons ainsi des Transformers en variantes Mamba-2 très efficaces tout en préservant leur qualité, avec 1 000 fois moins de données d’entraînement qu’un préentraînement à partir de zéro !
Présentation de MOHAWK
Notre approche repose sur le framework de distillation MOHAWK, qui aligne et transfère en plusieurs étapes les connaissances d’une architecture Transformer standard vers une architecture Mamba-2 efficace. Ce processus préserve les compétences principales du modèle enseignant tout en convertissant son architecture pour bénéficier de l’efficacité des couches Mamba-2.
Nous apportons quelques modifications à l’architecture d’origine, puis appliquons cette méthode de distillation en plusieurs étapes.
- Alternance de blocs MLP : en intercalant les composants MLP à portes de Llama avec les couches de mélange Mamba-2, nous maintenons les performances et réduisons le nombre de couches de mélange temporel. Cela augmente le débit d’inférence et divise par deux l’utilisation de mémoire par rapport aux modèles Mamba-2 purs sans MLP.
- Adaptation de la structure multitête : les modèles traditionnels utilisent l’attention à requêtes groupées avec des poids de plongement partagés pour gagner en vitesse. Nos modèles Llamba adoptent plutôt une conception multitête sans partage. Cette modification permet de conserver une taille d’état cohérente, notamment dans les scénarios à contexte long.
- Optimisation des non-linéarités et de la discrétisation : nous supprimons les étapes de normalisation et d’activation inutiles qui pourraient gêner l’alignement. Nous adoptons une variante Discrete-Mamba-2 qui projette directement les matrices d’entrée, afin de correspondre à la nature discrète de l’attention sans surcoût.
Une mise en œuvre concrète sur appareil
Nous avons optimisé les noyaux Mamba-2 avec le framework Metal d’Apple pour tirer pleinement parti du parallélisme GPU et de l’architecture de mémoire unifiée d’Apple Silicon.
Notre intégration au framework d’apprentissage automatique MLX permet la construction dynamique de graphes et des opérations efficaces sur les tenseurs. Ces modèles peuvent ainsi fonctionner avec un débit élevé et régulier, même avec une quantification sur 4 bits sur du matériel contraint.
La famille de modèles Llamba
Nous publions les poids d’une nouvelle famille de modèles : Llamba-1B, Llamba-3B et Llamba-8B. Ce sont des variantes distillées des modèles Llama-3.X correspondants, repensées pour offrir des performances de pointe avec une grande efficacité. Vous pouvez les essayer dès aujourd’hui sur Edge.
Les modèles Llamba égalent leurs enseignants Transformer sur de nombreux tests de référence et améliorent fortement le débit.
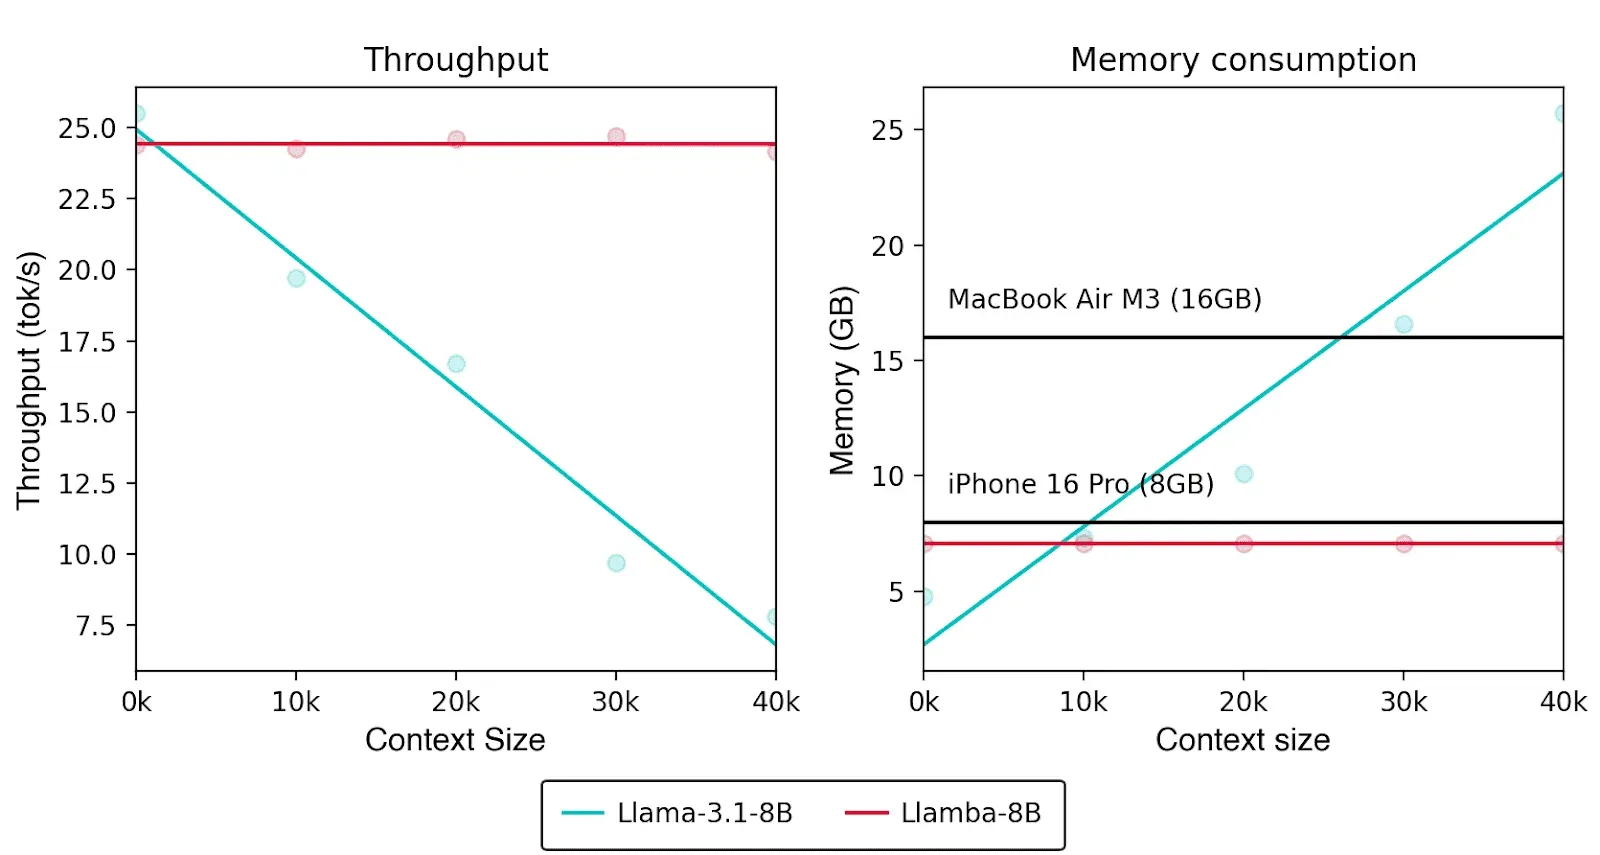
Par exemple, lors d’une évaluation sur un GPU NVIDIA H100 de 80 Go avec une longueur de génération de 8192 tokens, Llamba-8B a traité les tokens à un débit jusqu’à 12 fois supérieur à celui de Llama-3.1-8B. Ce gain vient des couches récurrentes Mamba-2 de Llamba, dont la taille d’état reste constante quelle que soit la longueur des séquences. La montée en charge reste donc efficace même lorsque le contexte s’allonge.
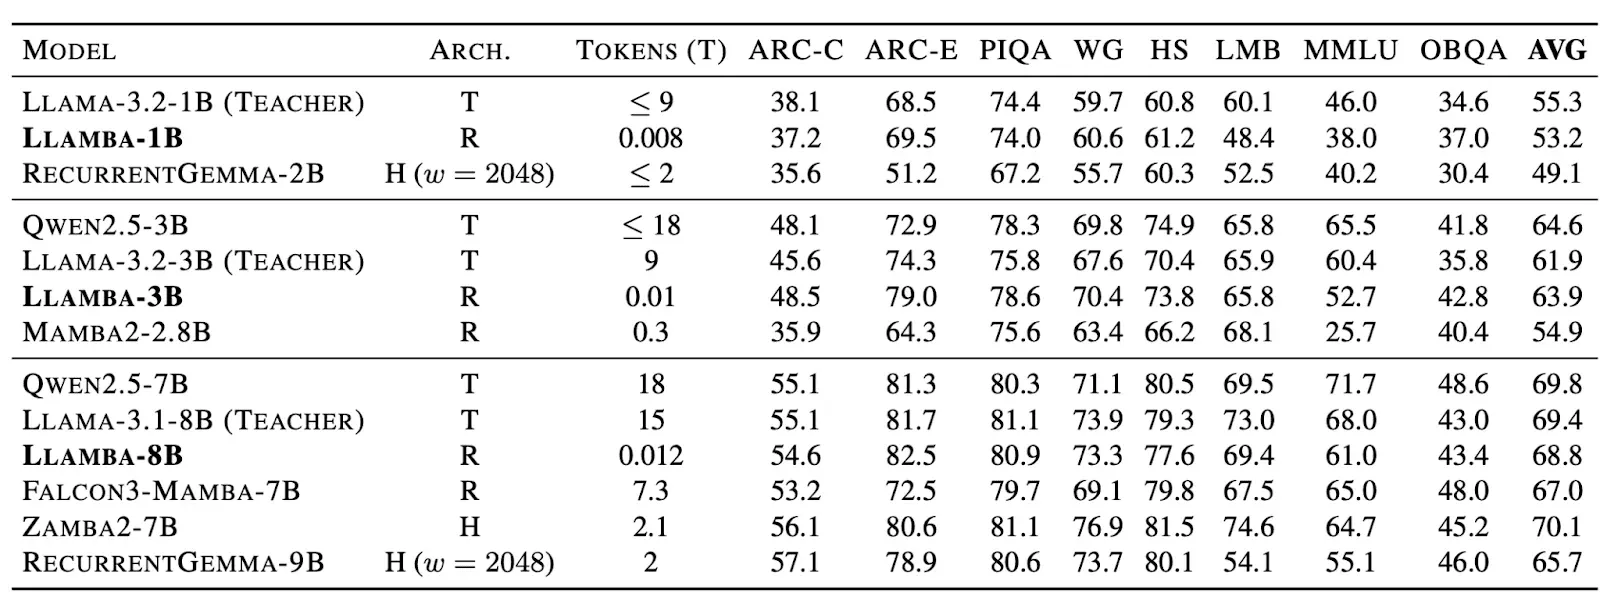
En utilisant une petite fraction des données et du calcul habituellement nécessaires, notre approche permet de convertir rapidement n’importe quel modèle en une variante efficace, prête pour l’inférence cloud à haut débit ou le déploiement sur appareil en temps réel.
L’avenir de l’IA s’oriente de plus en plus vers la décentralisation et l’efficacité. Notre équipe progresse dans la distillation d’architecture et innove sur les architectures et les algorithmes fondamentaux de l’apprentissage profond. Nous souhaitons utiliser ces technologies pour créer une nouvelle génération d’applications et apporter une IA intelligente, réactive et accessible à chaque appareil.