이 글은 Cartesia 수석 과학자 Albert Gu가 이끄는 Goomba Lab의 글을 함께 게시한 것입니다.
2024년 중반 Mamba-2가 출시된 뒤 대부분의 아키텍처가 Mamba-1에서 전환했습니다. 이유는 무엇일까요? Mamba-2는 상태 공간 모델인 SSM의 가장 큰 병목이 학습 효율이라고 판단했습니다. 기저 SSM 메커니즘을 단순화하여 이전 모델보다 2~8배 빠른 학습을 제공했고, 채택이 늘었습니다.
그 뒤 LLM 환경은 바뀌기 시작했습니다. 사전 학습은 여전히 매우 중요하지만, 추론 비중이 매우 높은 사후 학습과 배포에 더 많은 관심이 쏠렸습니다. 특히 코딩이나 수학에서 검증 가능한 보상을 사용하는 강화 학습인 RLVR을 확장하려면 엄청난 양의 롤아웃을 생성해야 합니다. 최근에는 Codex, Claude Code, OpenClaw 같은 에이전트 작업 흐름이 추론 수요를 폭발적으로 늘렸습니다.
추론의 중요성이 분명하게 커지고 있지만 Mamba-2를 포함한 많은 선형 아키텍처는 학습 우선 관점에서 개발되었습니다. 사전 학습을 가속하기 위해 기저 SSM을 점진적으로 단순화했습니다. 예를 들어 대각 전이를 스칼라와 단위 행렬의 곱으로 줄였습니다. 학습은 빨라졌지만 추론 단계가 지나치게 단순해져 메모리 대역폭에 묶였습니다. GPU는 대부분의 시간을 계산이 아니라 메모리 이동에 씁니다.
이 새로운 추론 시대에 우리는 품질과 효율의 한계를 넓히고자 합니다. 더 좋은 모델이 더 빠르게 실행되기를 원합니다.
자연스럽게 다음 질문이 나옵니다.
추론을 염두에 두고 설계한 SSM은 어떤 모습일까요?
Mamba-3 모델
무엇이 부족할까요? 선형 모델의 매력은 이름에 있습니다. 고정 크기 상태 덕분에 계산량이 시퀀스 길이에 선형으로 증가합니다. 하지만 공짜는 없습니다. 효율적인 계산을 가능하게 하는 고정 상태 크기 때문에 모든 과거 정보를 하나의 표현에 압축해야 합니다. 상태인 KV 캐시를 계속 늘려 과거 정보를 저장하는 트랜스포머와 정반대이며, 근본적인 차이입니다. 상태를 키울 수 없다면 고정된 상태가 더 많은 일을 하게 하려면 어떻게 해야 할까요?
이전 설계는 빠른 학습을 위해 점화식과 전이 행렬을 단순화했습니다. 하지만 이 변화는 동역학의 표현력도 줄였고, 디코딩을 메모리 병목에 묶어 두었습니다. 각 토큰 업데이트가 메모리 이동에 비해 수행하는 계산이 매우 적기 때문입니다. 따라서 세 가지를 바꿀 수 있습니다. 점화식 자체의 표현력을 높이고, 더 풍부한 전이 행렬을 사용하고, 업데이트 안에 거의 추가 비용 없이 병렬 계산을 더하는 것입니다.
이 관찰을 바탕으로 Mamba-2를 세 가지 핵심 방식으로 개선합니다.
- 지수-사다리꼴 이산화 방식에서 도출한 더 일반적인 점화식으로 SSM 메커니즘의 표현력을 높입니다.
- 복소수 값 SSM 시스템을 모델링하여 상태 추적 능력을 확장합니다.
- 기존 단일 입력 단일 출력인 SISO 대신 여러 SSM을 병렬로 모델링하는 다중 입력 다중 출력인 MIMO SSM을 사용하여, 디코딩 지연시간에 거의 영향을 주지 않으면서 전반적인 성능을 높입니다.
이 세 변화로 Mamba-3는 비슷한 추론 지연시간을 유지하며 성능의 한계를 넓힙니다.
세 변화 모두 더 고전적인 제어 이론과 상태 공간 모델 문헌에서 영감을 받았습니다.
우리의 접근은 선형 어텐션이나 테스트 시점 학습처럼 점화식을 다른 방식으로 해석하는 현대 선형 아키텍처의 흐름과 다릅니다. 그런 해석으로는 이 개념들을 쉽게 포착하기 어렵습니다.
아키텍처
Mamba-2 계층에서 무엇이 달라졌을까요? 위에서 설명한 핵심 SSM의 세 가지 개선 외에도 현대 언어 모델의 일반적인 구성에 더 가까워지도록 아키텍처를 조정했습니다.
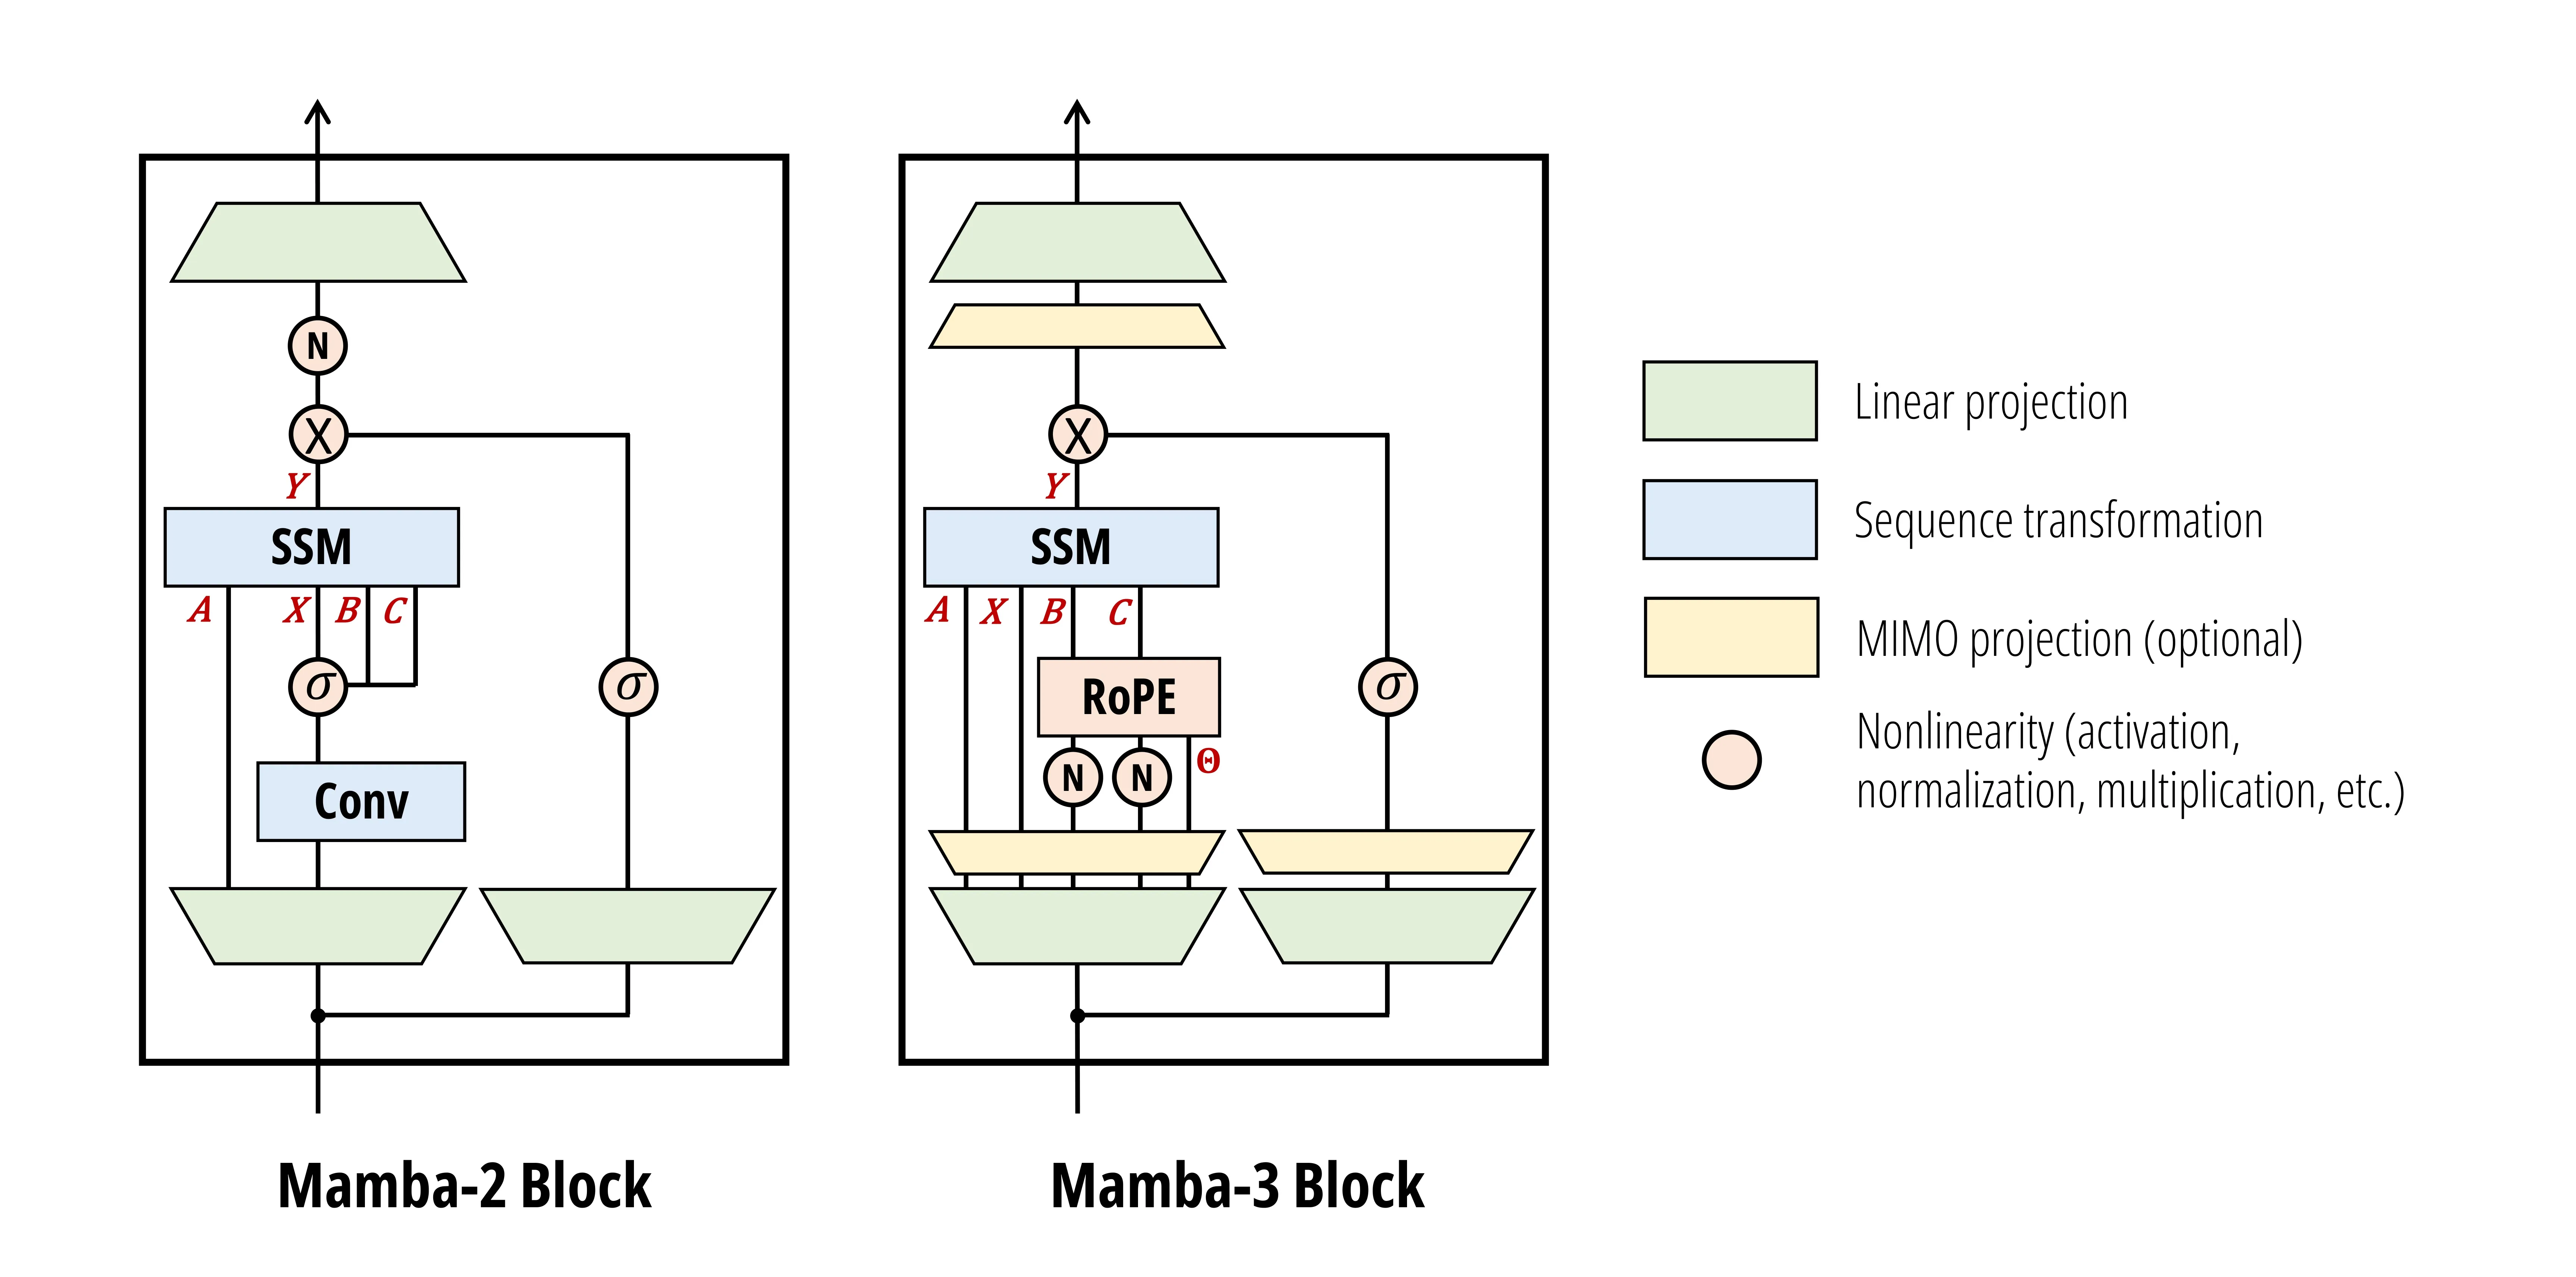
그림에서 몇 가지 변화를 볼 수 있습니다. 큰 틀에서는 다음과 같습니다.
정규화. Mamba-3 학습을 경험적으로 안정화하는 QKNorm 1 1을 추가했습니다. 이 정규화로 현대 트랜스포머 및 Gated DeltaNet인 GDN 모델과 구성이 비슷해집니다. QKNorm을 사용하면 Mamba-2의 RMSNorm은 선택 사항이 됩니다. 하지만 하이브리드 모델에서는 길이 외삽에 도움이 되어 유지할 가치가 있다는 것을 실험으로 확인했습니다. 뒤에서 더 설명하겠습니다.
짧은 합성곱 제거. BCNorm 뒤의 B와 C에 단순 편향을 더하고 새로운 이산화 기반 점화식을 함께 사용하여 Mamba-1/2의 짧은 인과적 합성곱을 없앴습니다. 새 점화식은 은닉 상태의 입력에 암묵적으로 합성곱을 적용합니다. 이 원리는 글의 2부에서 설명합니다.
짧은 합성곱을 정말 없앨 수 있을까요?
Mamba-3의 변화는 SSM 점화식 내부에 합성곱과 비슷한 요소를 추가합니다. 하지만 점화식 바깥에 두는 표준 짧은 합성곱과 정확히 대체 가능한 것은 아닙니다.
바깥의 합성곱을 Mamba-3와 함께 사용할 수도 있지만, 사용하지 않기로 한 결정은 실험에 근거합니다. 표준 짧은 합성곱을 다시 추가했을 때 관찰한 결과는 다음과 같습니다.
- 성능을 개선하지 않으며 오히려 약간 떨어뜨립니다.
- 더 실제적인 검색 과제인 NIAH 등에서는 합성곱 제거가 검색 능력을 떨어뜨리지 않습니다. 다만 짧은 합성곱이 없으면 MQAR 같은 소규모 합성 과제의 학습이 다소 어려워집니다. 실제 검색 동작은 영향을 받지 않으므로 큰 한계로 보지는 않습니다.
왜 그럴까요? 이론적 메커니즘은 연구하지 않았지만, 논문에서는 BC 편향과 지수-사다리꼴 점화식 모두 비슷한 합성곱 유사 메커니즘을 수행하여 외부의 짧은 합성곱과 경험적으로 같은 역할을 한다고 가정합니다.
짧은 합성곱의 간단한 역사
새 구성 요소인 RoPE와 MIMO 투영도 볼 수 있습니다. RoPE 모듈은 복소수 전이를 회전으로 해석하여 복소수 값 SSM을 표현합니다. 비용이 큰 커널 재구현을 피할 수 있습니다. MIMO 투영은 B와 C 행렬을 MIMO SSM에 필요한 표현으로 확장합니다.
두 요소의 동기와 정확한 구현은 2부에서 더 자세히 다룹니다. 지금은 각각 모델 성능이나 능력을 높이는 독립적이고 근본적인 개선이라고 생각하면 됩니다.
마지막으로 전체 아키텍처는 트랜스포머와 다른 선형 모델의 일반적인 방식에 따라 MLP 계층을 교차 배치합니다.
실험 결과
최종 Mamba-3를 널리 쓰이는 다른 선형 모델과 트랜스포머 기준 모델에 비교했습니다.
언어 모델링
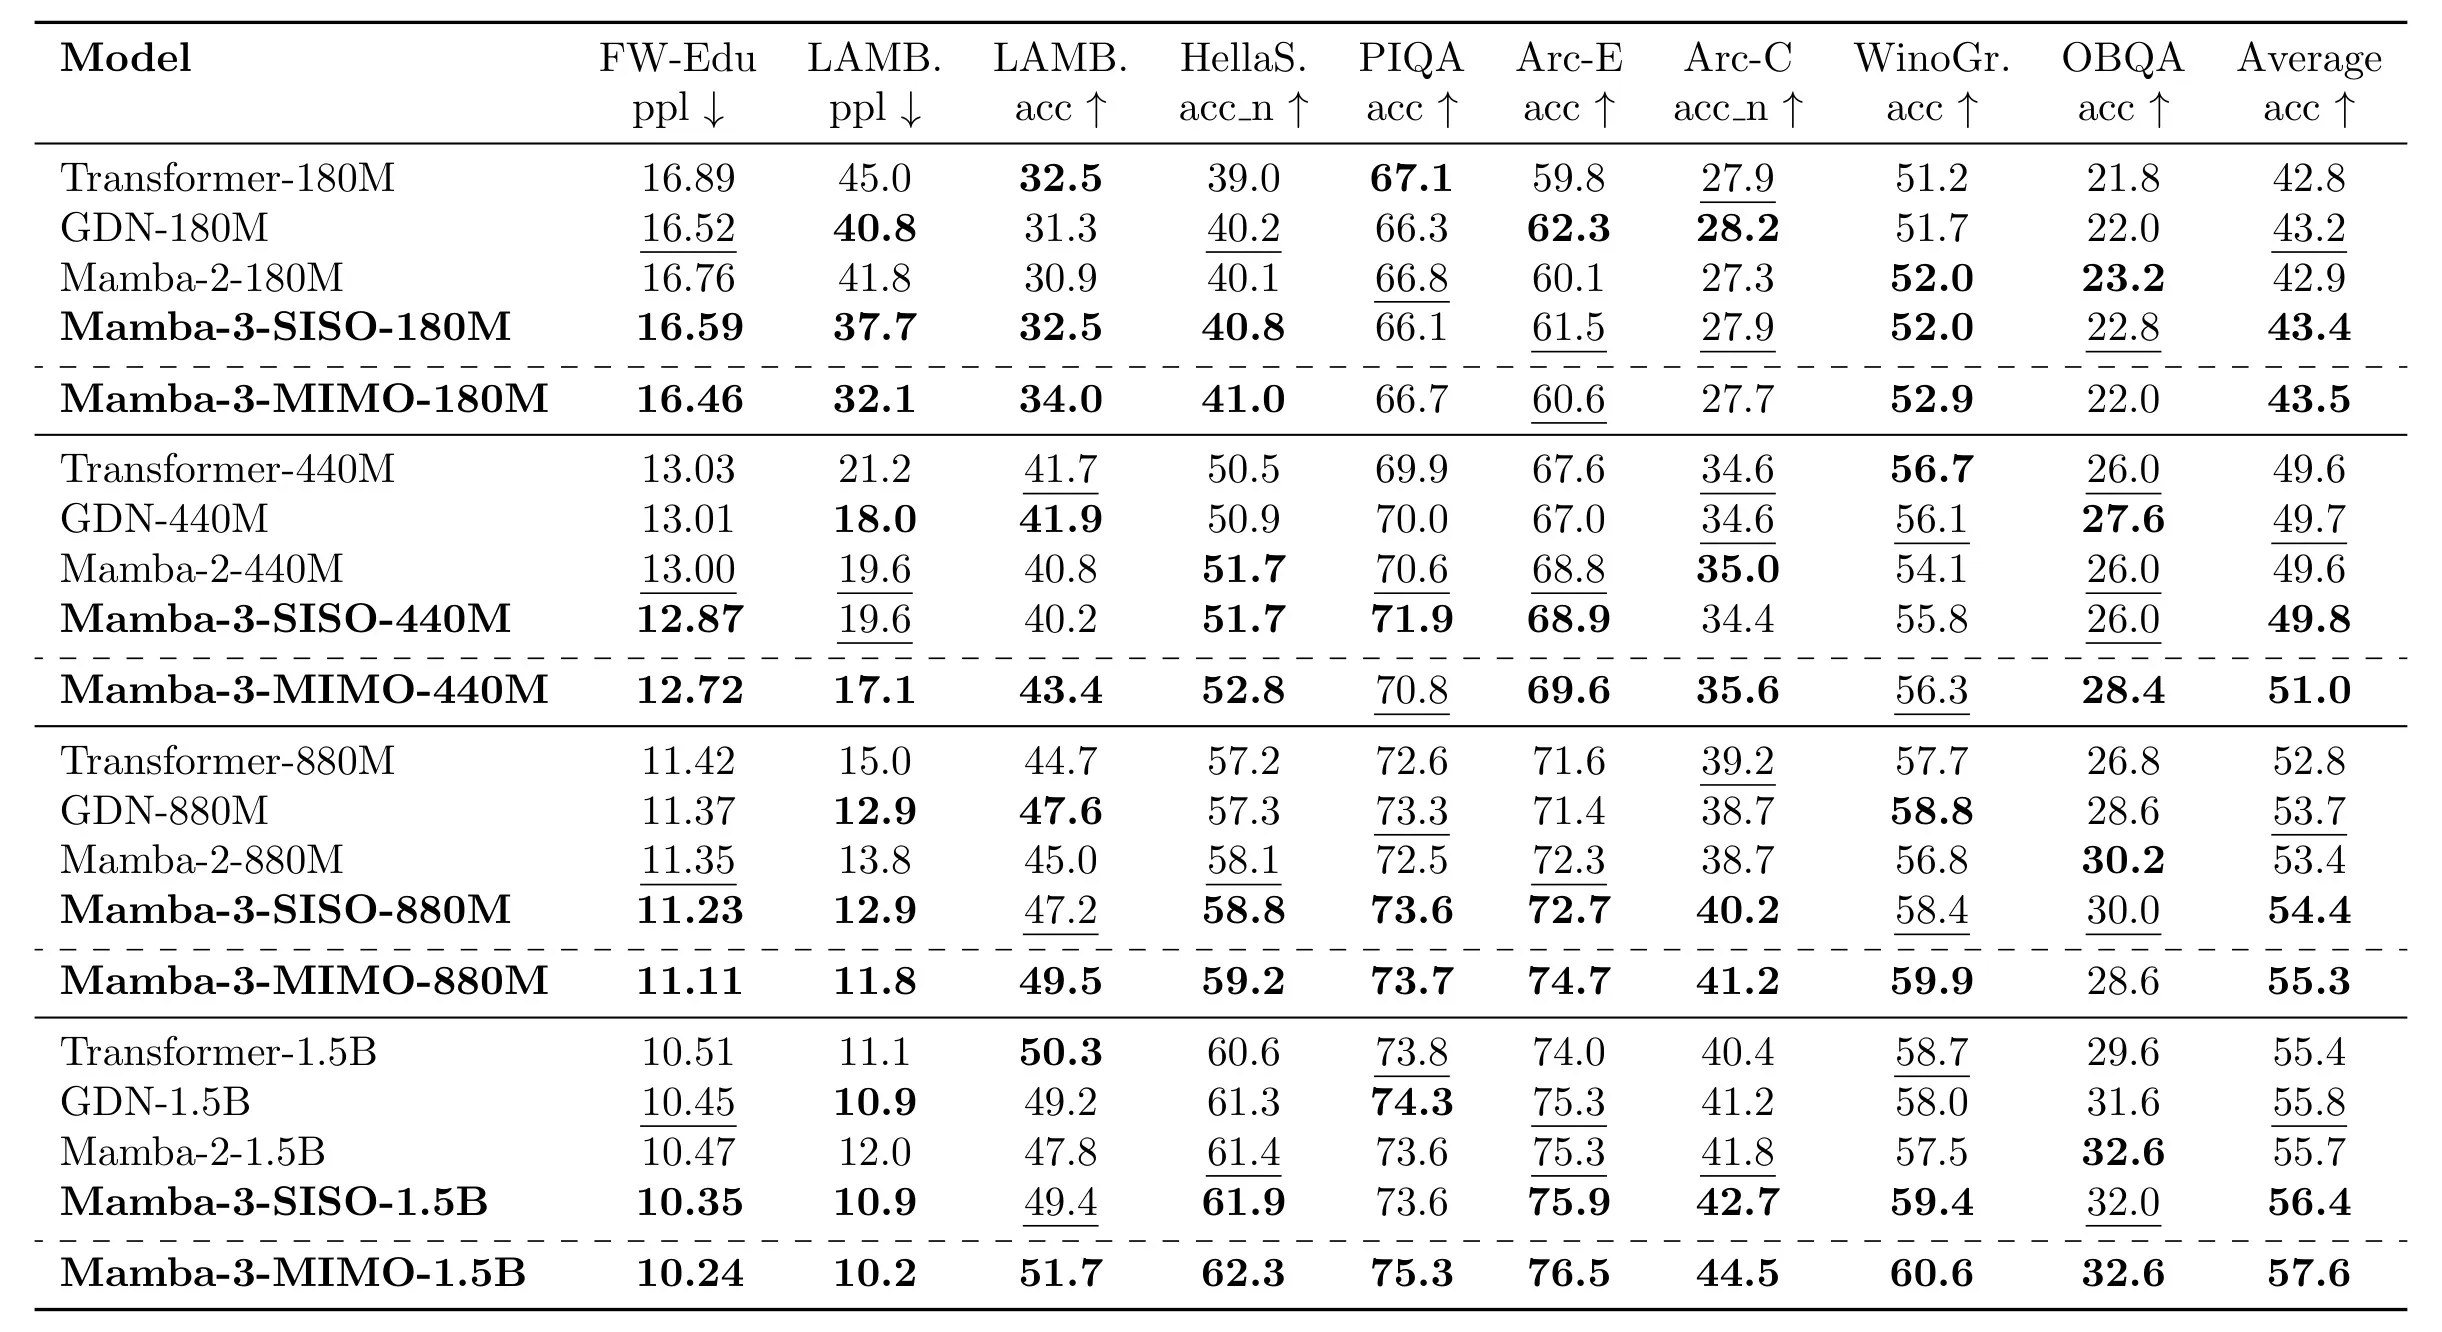
Mamba-3는 다양한 사전 학습 모델 규모에서 이전 Mamba-2와 GDN 같은 강력한 선형 어텐션 모델보다 언어 모델링 성능이 좋았습니다. Mamba-3-SISO는 기존 선형 모델과 직접 비교할 수 있습니다. 예를 들어 모델 차원과 상태 크기 등 아키텍처 형태가 Mamba-2와 정확히 같고 학습 시간도 비슷합니다. Mamba-3의 MIMO 변형은 1B 규모에서 일반 Mamba-3보다 다운스트림 과제의 정확도를 1%포인트 이상 더 높입니다. MIMO는 학습 시간이 더 길지만 디코딩 지연시간이 늘지는 않습니다!
학습 비용은 늘어나는데 추론 비용은 왜 늘지 않을까요?
2부에서 자세히 설명하겠지만 여기서 간단히 소개합니다.
이 차이는 학습이 계산에, 추론이 메모리에 제약을 받는 특성에서 비롯됩니다. 현재 선형 모델은 빠른 학습을 위해 많은 GPU 텐서 코어를 사용하도록 설계되었습니다. 이는 Mamba-2의 주요 기여 중 하나입니다. 반면 디코딩의 각 시간 단계는 계산량이 너무 적어 하드웨어가 대부분 쉬고 있습니다.
따라서 각 시간 단계에 필요한 FLOPs를 늘리는 방향으로 아키텍처를 설계하면 유휴 코어 일부를 사용할 수 있어 추론 지연시간은 거의 일정합니다. 학습에서는 그렇지 않습니다!
검색 과제
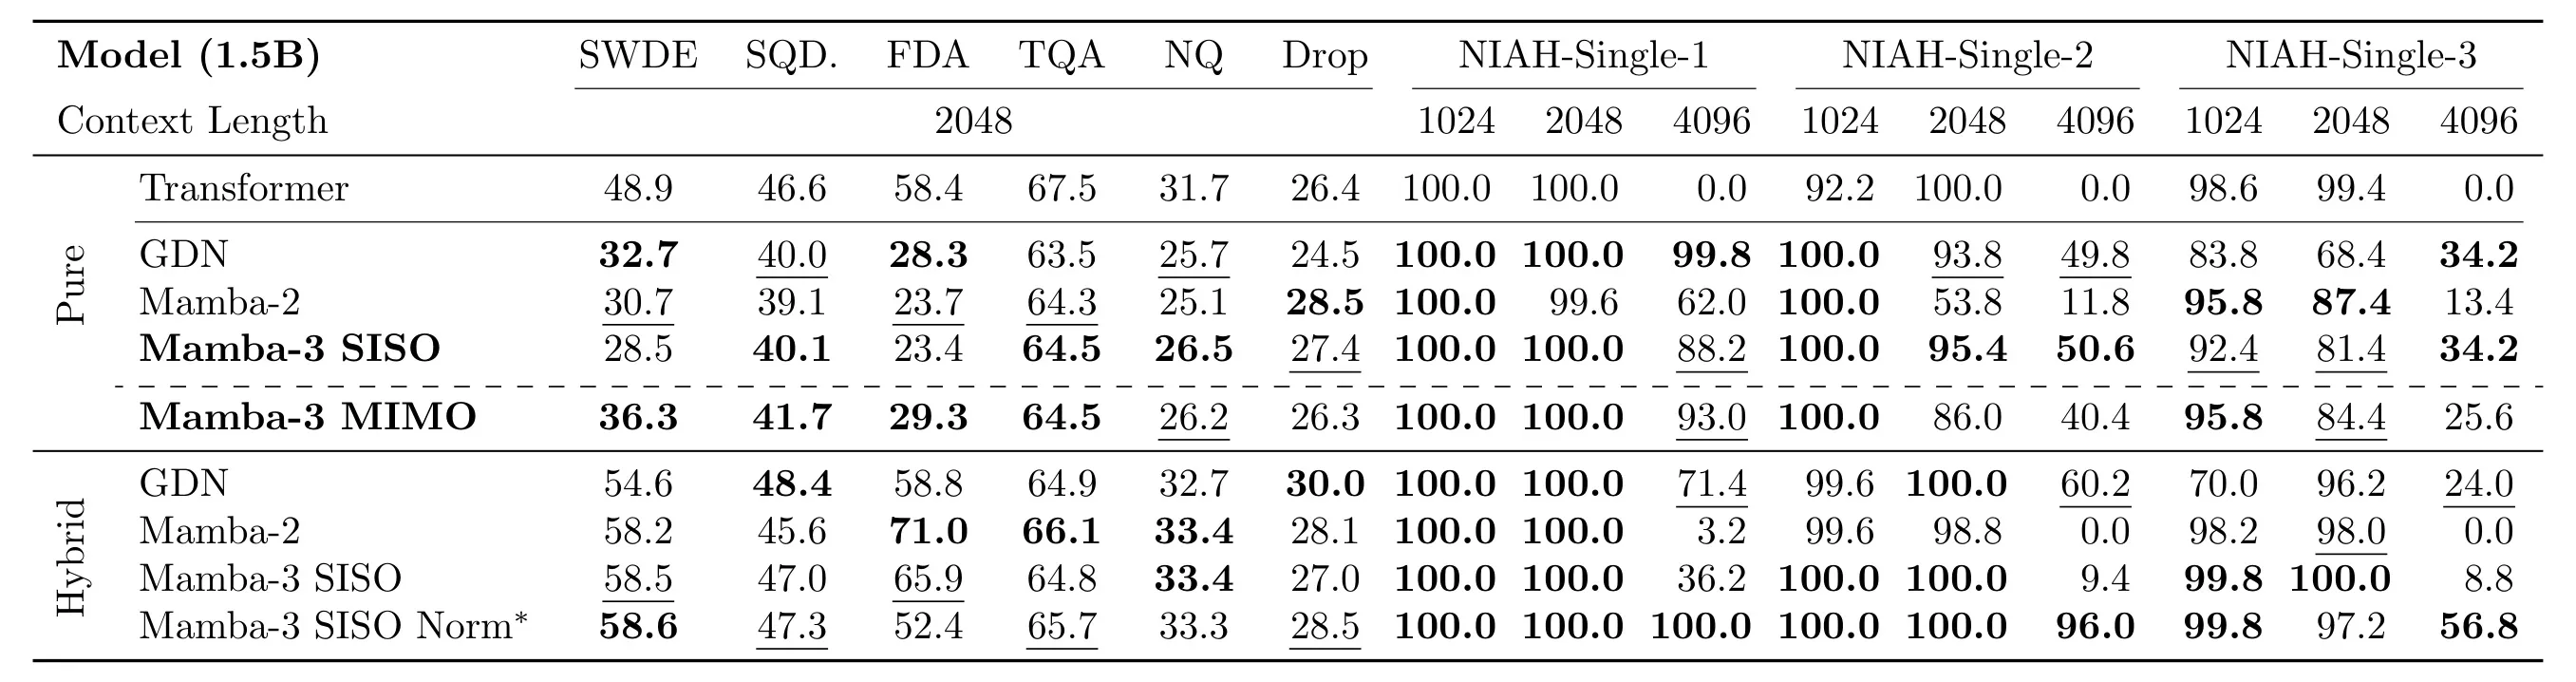
고정 크기 상태를 사용하는 선형 모델은 검색 기반 과제에서 트랜스포머보다 본질적으로 불리합니다. 예상대로 순수 모델 중에서는 트랜스포머가 검색에 우수하지만, Mamba-3는 이차보다 낮은 복잡도의 대안들 사이에서 좋은 성능을 보입니다. 흥미롭게도 MIMO를 추가하면 상태 크기를 늘리지 않고도 검색 성능이 더 좋아집니다.
이러한 내재적 약점과 전반적으로 좋은 모델링 성능을 고려하면,
앞으로 선형 계층은 주로 전역 셀프 어텐션 계층과 함께 사용될 것으로 예상합니다.*
*적어도 언어 모델링에서는 그렇습니다.
선형 계층의 일반적인 기억과 유사한 특성과 셀프 어텐션 KV 캐시의 정확한 데이터베이스 같은 저장을 결합한 하이브리드 모델은 메모리와 계산을 크게 절약하면서 순수 모델보다 좋은 성능을 보인 바 있습니다 10. 이번에도 선형 계층과 셀프 어텐션의 조합이 기본 트랜스포머보다 검색 성능을 높인다는 사실을 확인했습니다.
하지만 선형 모델이 셀프 어텐션과 상호작용하는 정확한 방식은 아직 완전히 이해되지 않았습니다. 예를 들어 Mamba-3에서 선택적인 출력 투영 전 구성 요소를 사용하면 실제 컨텍스트 내 검색 과제 성능을 조금 희생하는 대신 합성 NIAH 과제의 길이 일반화가 개선됩니다. 또한 다시 도입한 정규화의 위치가 게이트 전인지 후인지, 종류가 그룹형인지 일반형인지 같은 세부 사항도 FDA나 SWDE처럼 반정형 및 비정형 데이터로 구성된 과제의 정확도에 무시할 수 없는 영향을 줍니다.
다양한 커널 구현
Mamba-3로 어떤 것을 만들지 기대됩니다. 이를 돕기 위해 기존 Mamba-2 Triton 커널과 속도가 대등한 커널을 오픈소스로 공개합니다.
지연시간 벤치마크
프리필 지연시간
| 모델 | n=512 | 1024 | 2048 | 4096 | 16384 |
|---|---|---|---|---|---|
| vLLM (Llama-3.2-1B) | 0.26 | 0.52 | 1.08 | 2.08 | 12.17 |
| Gated DeltaNet | 0.51 | 1.01 | 2.01 | 4.00 | 16.21 |
| Mamba-2 | 0.51 | 1.02 | 2.02 | 4.02 | 16.22 |
| Mamba-3 (SISO) | 0.51 | 1.01 | 2.02 | 4.01 | 16.22 |
| Mamba-3 (MIMO R=4) | 0.60 | 1.21 | 2.42 | 4.76 | 19.44 |
프리필과 디코딩을 합한 지연시간
| 모델 | n=512 | 1024 | 2048 | 4096 | 16384 |
|---|---|---|---|---|---|
| vLLM (Llama-3.2-1B) | 4.45 | 9.60 | 20.37 | 58.64 | 976.50 |
| Gated DeltaNet | 4.56 | 9.11 | 18.22 | 36.41 | 145.87 |
| Mamba-2 | 4.66 | 9.32 | 18.62 | 37.22 | 149.02 |
| Mamba-3 (SISO) | 4.39 | 8.78 | 17.57 | 35.11 | 140.61 |
| Mamba-3 (MIMO R=4) | 4.74 | 9.48 | 18.96 | 37.85 | 151.81 |
1.5B 규모 모델을 비교하면 Mamba-3 SISO는 모든 시퀀스 길이에서 가장 빠른 프리필과 디코딩 합산 지연시간을 달성합니다. Mamba-2와 Gated DeltaNet은 물론 고도로 최적화된 vLLM 생태계의 트랜스포머보다 빠릅니다. 또한 Mamba-3 MIMO는 Mamba-2와 속도가 비슷하면서 성능은 훨씬 좋습니다.
Mamba-3 SISO의 Triton 기반 프리필은 Mamba-2와 거의 같은 성능을 유지합니다. 새로운 이산화와 데이터 의존적 RoPE 임베딩이 추가 오버헤드를 만들지 않는다는 뜻입니다. Mamba-3 MIMO도 효율적인 TileLang 구현 덕분에 프리필의 속도 저하가 크지 않습니다. 두 Mamba-3 변형의 높은 디코딩 성능은 일부 CuTe DSL 구현 덕분이며, Mamba-3 구성 요소가 단순하여 구현이 훨씬 쉬웠습니다.
설계 선택
사용하기 쉬우면서 가능한 한 빠른 커널을 만들기 위해 많은 시간을 들였습니다. 최종적으로 Triton, TileLang, CuTe DSL을 사용했습니다.
Triton은 비교적 쉬운 선택이었습니다. 아키텍처 개발에서 사실상 표준입니다. flash linear attention 저장소도 PyTorch와 Triton만 사용합니다. 플랫폼에 종속되지 않는 언어이면서 타일링과 커널 융합을 제어하여 일반 PyTorch보다 좋은 성능을 얻을 수 있기 때문입니다. GPU용 어셈블리 언어인 PTX 삽입과 Hopper GPU의 Tensor Memory Accelerator 지원도 있습니다. 이를 통해 전역 메모리에서 공유 메모리로 대량 데이터를 비동기 전송할 수 있습니다.
MIMO 프리필 커널은 TileLang으로 개발했습니다. 이 변형의 추가 투영은 GPU 메모리 계층을 전략적으로 조작하여 메모리 입출력을 줄일 기회를 줍니다. Triton은 원하는 수준의 세밀한 메모리 제어를 제공하지 않아 TileLang을 선택했습니다. 공유 메모리 타일을 명시적으로 선언하고 제어하며 레지스터 조각을 만들 수 있어 메모리를 효율적으로 재사용합니다. 동시에 충분히 고수준이어서 빠르게 커널을 개발할 수 있습니다.
추론과 디코딩의 중요성을 강조해 온 만큼 디코딩 커널에는 CuTe DSL을 선택했습니다. Python 인터페이스로 CUTLASS의 고수준 추상화를 사용하여 저수준 커널을 생성합니다. 사실상 CUDA 수준의 제어가 가능하므로 Hopper GPU라는 하드웨어 사양에 맞춘 고성능 커널을 개발할 수 있습니다. 텐서 레이아웃과 워프 특수화를 세밀하게 제어하여 GPU의 기능을 폭넓게 활용하는 커널을 만들었습니다.
서로 다른 GPU 추상화 수준에서 구현할 수 있는 이유는 Mamba-3가 단순하고 가벼운 요소를 추가하고 이를 효과적으로 구현하는 기저 알고리즘 설계 덕분입니다. 정확한 융합 구조와 커널 DSL 같은 세부 사항은 전체 공개 자료에서 더 깊이 다룹니다.
다음 내용
1부를 끝까지 읽어 주셔서 감사합니다. 이 글에서 다루지 못한 커널, 실험 결과, 절제 실험의 세부 사항은 논문에서 확인할 수 있습니다. 커널은 mamba-ssm에 오픈소스로 공개했습니다!
다음 두 번째이자 마지막 글에서는 Mamba-3의 세 가지 핵심 개선과 SSM 기반을 자세히 설명하고, 특히 관심을 두고 있는 연구 방향을 소개합니다.
각주
각주
-
SSM 용어로는 “BCNorm”입니다. ↩
-
Mamba: Linear-Time Sequence Modeling with Selective State Spaces. [PDF] Gu, A. and Dao, T., 2024. ↩
-
Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality. [PDF] Dao, T. and Gu, A., 2024. ↩
-
Gated Delta Networks: Improving Mamba2 with Delta Rule [PDF] ↩
-
Learning to (Learn at Test Time): RNNs with Expressive Hidden States [PDF] ↩
-
Hungry Hungry Hippos: Towards Language Modeling with State Space Models [PDF] ↩
-
In-context Learning and Induction Heads ↩
-
Test-time regression: a unifying framework for designing sequence models with associative memory [PDF] ↩