Questo post è ripubblicato da Goomba Lab, diretto da Albert Gu, Chief Scientist di Cartesia.
Dalla pubblicazione di Mamba-2 a metà 2024, la maggior parte delle architetture è passata da Mamba-1 a Mamba-2. Quest’ultimo puntava sull’efficienza dell’addestramento come maggiore collo di bottiglia degli SSM e semplificava il meccanismo sottostante per addestrare da 2 a 8 volte più velocemente del predecessore, favorendone l’adozione.
Da allora il settore degli LLM è cambiato. Il preaddestramento resta importante, ma cresce l’attenzione per post-addestramento e distribuzione, entrambi molto dipendenti dall’inferenza. Far crescere il post-addestramento, soprattutto l’apprendimento per rinforzo con ricompense verificabili, RLVR, per codice o matematica richiede enormi quantità di sequenze generate. Più di recente, flussi agentici come Codex, Claude Code e OpenClaw hanno fatto esplodere la domanda di inferenza.
Nonostante questa crescita, molte architetture lineari, Mamba-2 incluso, sono nate dando priorità all’addestramento. Per accelerare il preaddestramento, l’SSM è stato progressivamente semplificato: per esempio, la transizione diagonale è stata ridotta a uno scalare per l’identità. Questo ha velocizzato l’addestramento, ma reso il passo di inferenza troppo semplice e limitato dalla memoria: le GPU passano gran parte del tempo a spostare dati invece di calcolare.
In questa fase dell’inferenza vogliamo spingere la frontiera qualità-efficienza: modelli migliori che funzionino più velocemente.
La domanda naturale è:
Come sarebbe un SSM progettato pensando all’inferenza?
Il modello Mamba-3
Cosa manca? Il vantaggio dei modelli lineari è nel nome: il calcolo cresce linearmente con la sequenza grazie a uno stato fisso. Ma non si ottiene nulla gratis. La stessa dimensione fissa obbliga il modello a comprimere tutte le informazioni passate in una rappresentazione, all’opposto del Transformer che le conserva in uno stato crescente, la cache KV. Se non possiamo ampliare lo stato, come possiamo fargli fare più lavoro?
I progetti precedenti hanno semplificato ricorrenza e matrice di transizione per velocizzare l’addestramento. Questo ha ridotto la ricchezza delle dinamiche e lasciato la decodifica limitata dalla memoria: ogni aggiornamento di token esegue poco calcolo rispetto ai dati spostati. Abbiamo quindi tre possibilità: rendere la ricorrenza più espressiva, usare una transizione più ricca e aggiungere lavoro parallelo quasi gratuito dentro ogni aggiornamento.
Da queste osservazioni miglioriamo Mamba-2 in tre modi:
- Aumentiamo l’espressività dell’SSM con una ricorrenza più generale derivata dal nostro schema di discretizzazione esponenziale-trapezoidale.
- Ampliamo le capacità di tracciamento dello stato modellando un sistema SSM a valori complessi.
- Miglioriamo le prestazioni generali con poco effetto sulla latenza di decodifica usando SSM a più ingressi e uscite, MIMO, che modellano più SSM in parallelo, invece degli attuali SSM a ingresso e uscita singoli, SISO.
Con questi cambiamenti Mamba-3 spinge la frontiera delle prestazioni mantenendo una latenza di inferenza simile.
Tutti e tre i cambiamenti si ispirano alla letteratura più classica della teoria del controllo e dei modelli a spazio di stato.
Il nostro lavoro va in direzione diversa da molte architetture lineari moderne, che interpretano la ricorrenza come attenzione lineare o addestramento al momento del test, formulazioni che non catturano facilmente questi concetti.
Architettura
Cosa cambia nel livello Mamba-2? Oltre ai tre aggiornamenti metodologici al nucleo SSM, abbiamo rivisto l’architettura per avvicinarla ai modelli linguistici moderni convenzionali.
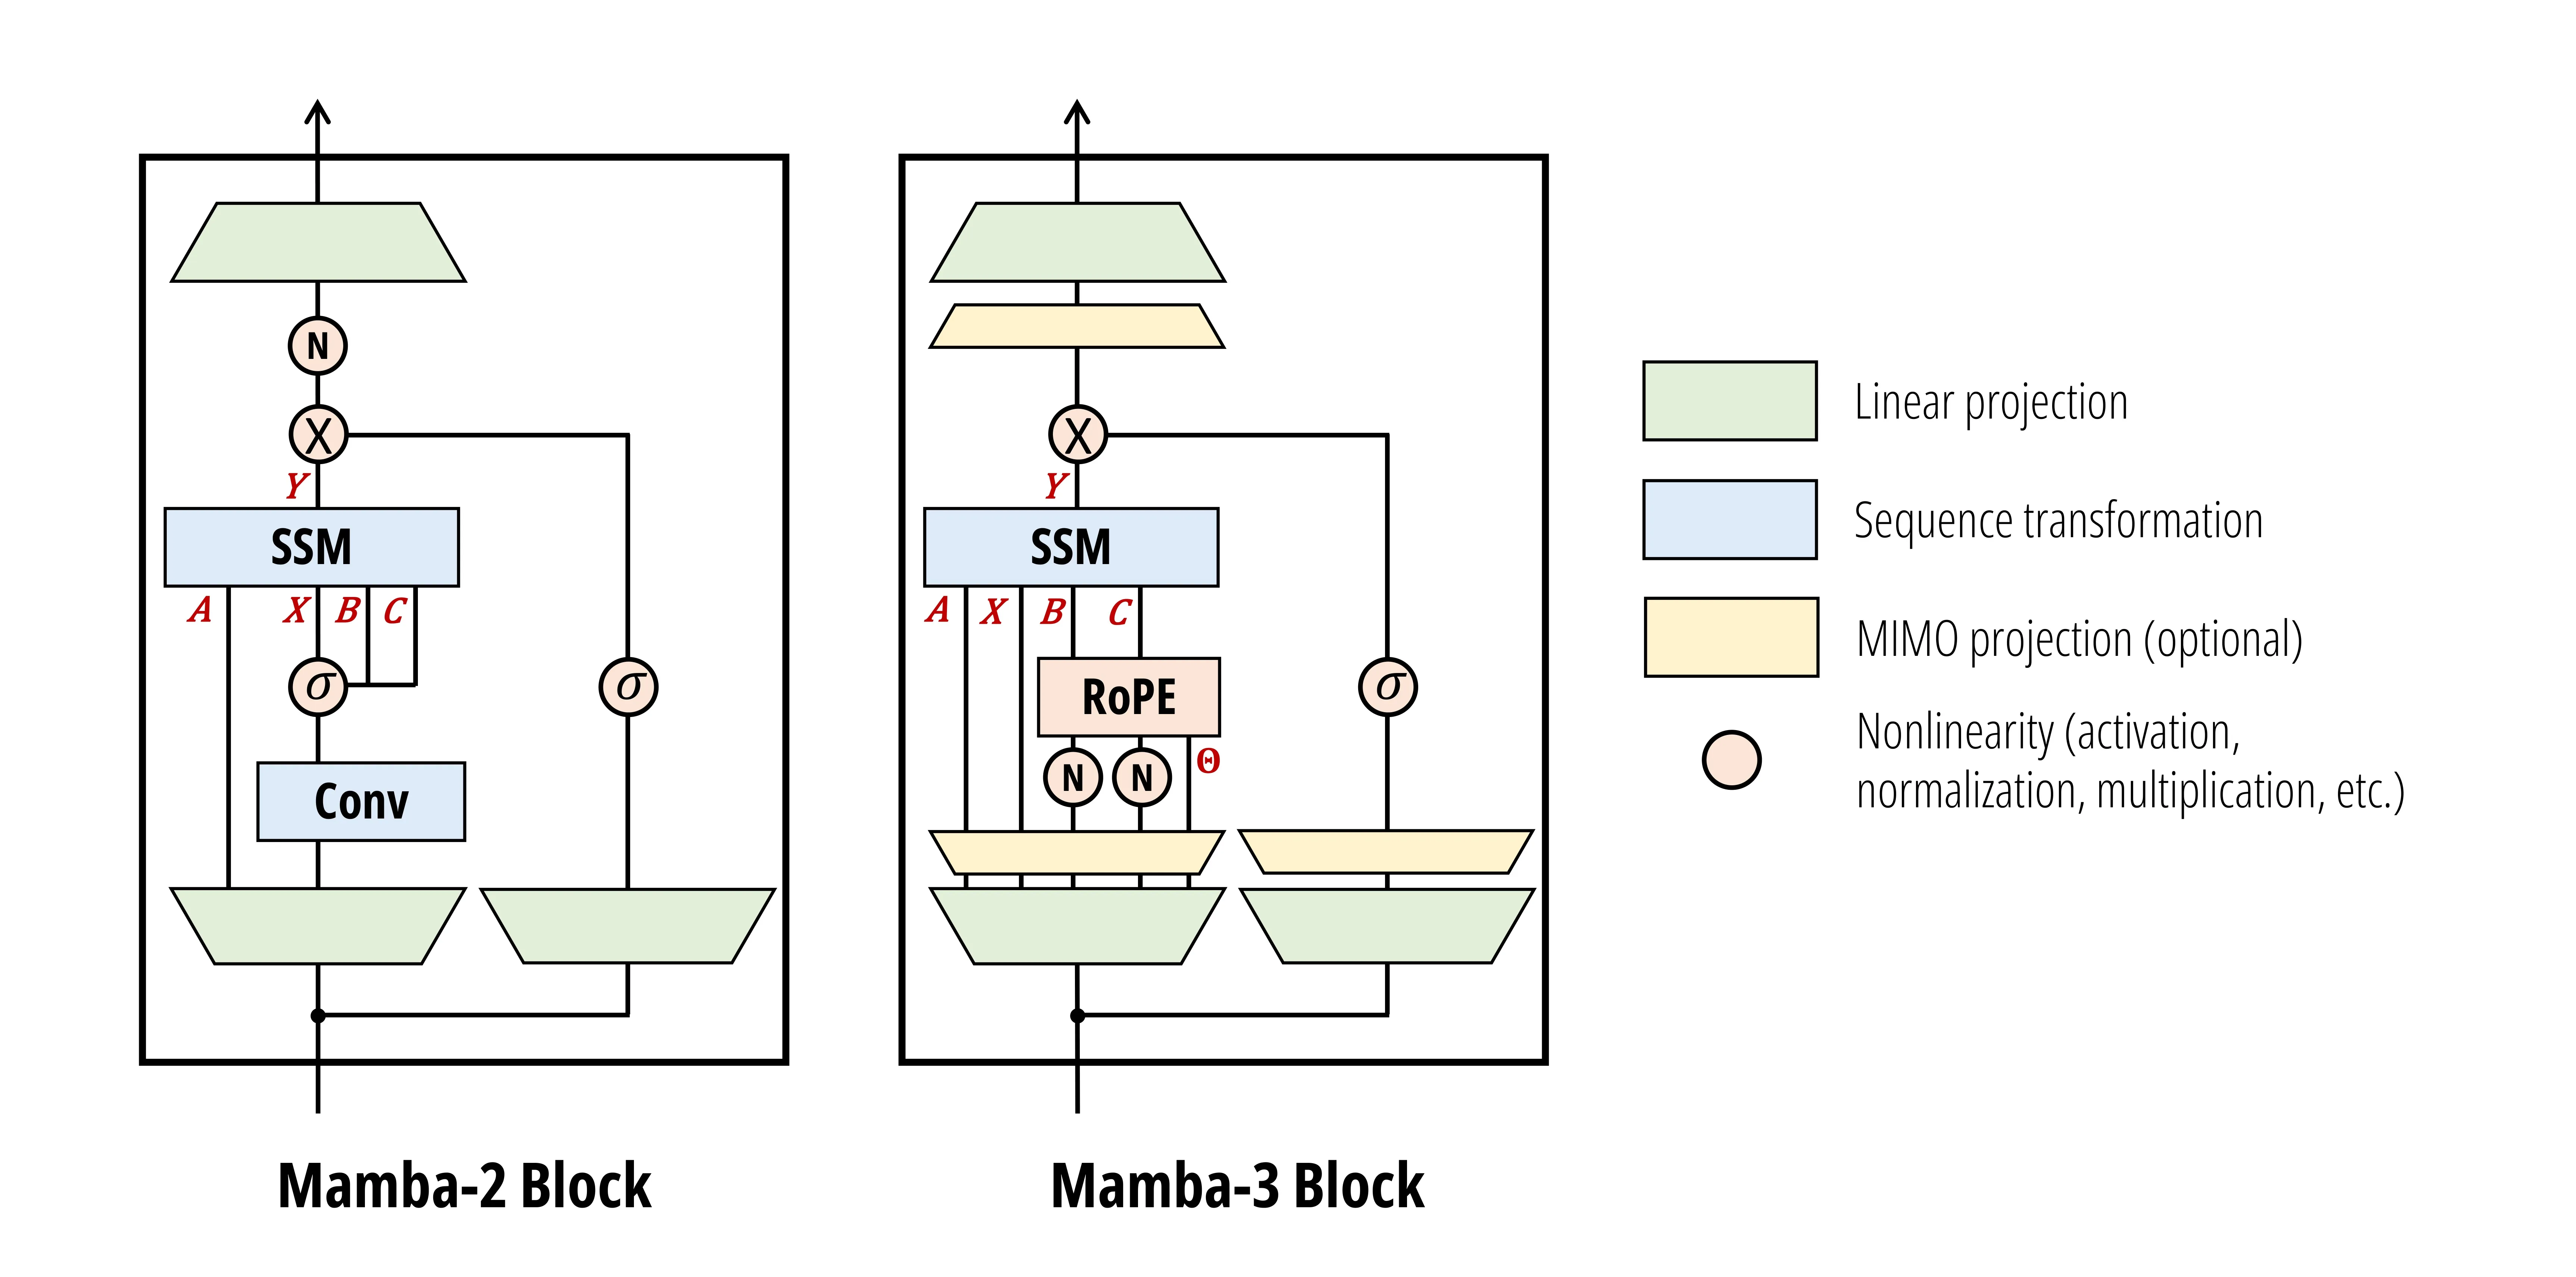
Il diagramma mostra alcuni cambiamenti principali.
Normalizzazioni. Abbiamo aggiunto QKNorm 1 1, che stabilizza empiricamente l’addestramento di Mamba-3 e lo allinea a Transformer e Gated DeltaNet, GDN, attuali. Con QKNorm, RMSNorm di Mamba-2 diventa facoltativa. Osserviamo però che può valere la pena mantenerla nei modelli ibridi perché aiuta a generalizzare a lunghezze maggiori. Ne parleremo più avanti.
Addio convoluzione corta. Abbiamo eliminato la convoluzione causale corta di Mamba-1/2 combinando semplici bias su B e C dopo BCNorm con la nuova ricorrenza basata sulla discretizzazione. Questa applica implicitamente una convoluzione all’input dello stato nascosto; lo mostriamo nella seconda parte del blog.
Si può davvero rimuovere la convoluzione corta?
Mamba-3 aggiunge componenti simili a convoluzioni dentro la ricorrenza SSM, ma non sono esattamente intercambiabili con la convoluzione corta standard posta all’esterno.
Quest’ultima può ancora essere usata con Mamba-3, ma la scelta di non farlo è empirica. Aggiungerla di nuovo:
- Non migliora le prestazioni, anzi le peggiora leggermente.
- Non degrada le capacità di recupero nei compiti più vicini al mondo reale, come NIAH. Senza convoluzione corta, addestrare su piccoli compiti sintetici come MQAR diventa però un po’ più difficile. Poiché il recupero reale non cambia, non consideriamo questa una limitazione importante.
Non abbiamo studiato i meccanismi teorici, ma nell’articolo ipotizziamo che il bias BC e la ricorrenza esponenziale-trapezoidale svolgano meccanismi simili a convoluzioni, che empiricamente hanno la stessa funzione della convoluzione corta esterna.
Breve storia della convoluzione corta
La convoluzione corta è oggi un componente centrale di molti modelli lineari efficaci 2 3 4 5. Versioni precedenti sono state usate in architetture ricorrenti da H3 6, sotto forma di “shift SSM” ispirato alle induction head “smeared” di Anthropic 7, e da RWKV-4 8, tramite il meccanismo di “token shift”, prima che Mamba-1 ne diffondesse la forma attuale.
È così comune perché lavori precedenti hanno mostrato ripetutamente che migliora le prestazioni empiriche e supporta teoricamente capacità di recupero basate sull’induzione 9.
Noterai anche RoPE e le proiezioni MIMO. Il modulo RoPE esprime SSM complessi interpretando le transizioni complesse come rotazioni, evitando una costosa riscrittura dei kernel. Le proiezioni MIMO ampliano le matrici B e C alla rappresentazione richiesta dagli SSM MIMO.
Nella seconda parte approfondiamo motivazioni e implementazione. Per ora considerali miglioramenti fondamentali indipendenti, ciascuno capace di aumentare prestazioni o capacità del modello.
Infine, l’architettura complessiva adotta livelli MLP intercalati, seguendo la convenzione dei Transformer e di altri modelli lineari.
Risultati empirici
Valutiamo il modello finale Mamba-3 rispetto ad alternative lineari diffuse e al Transformer di riferimento.
Modellazione del linguaggio
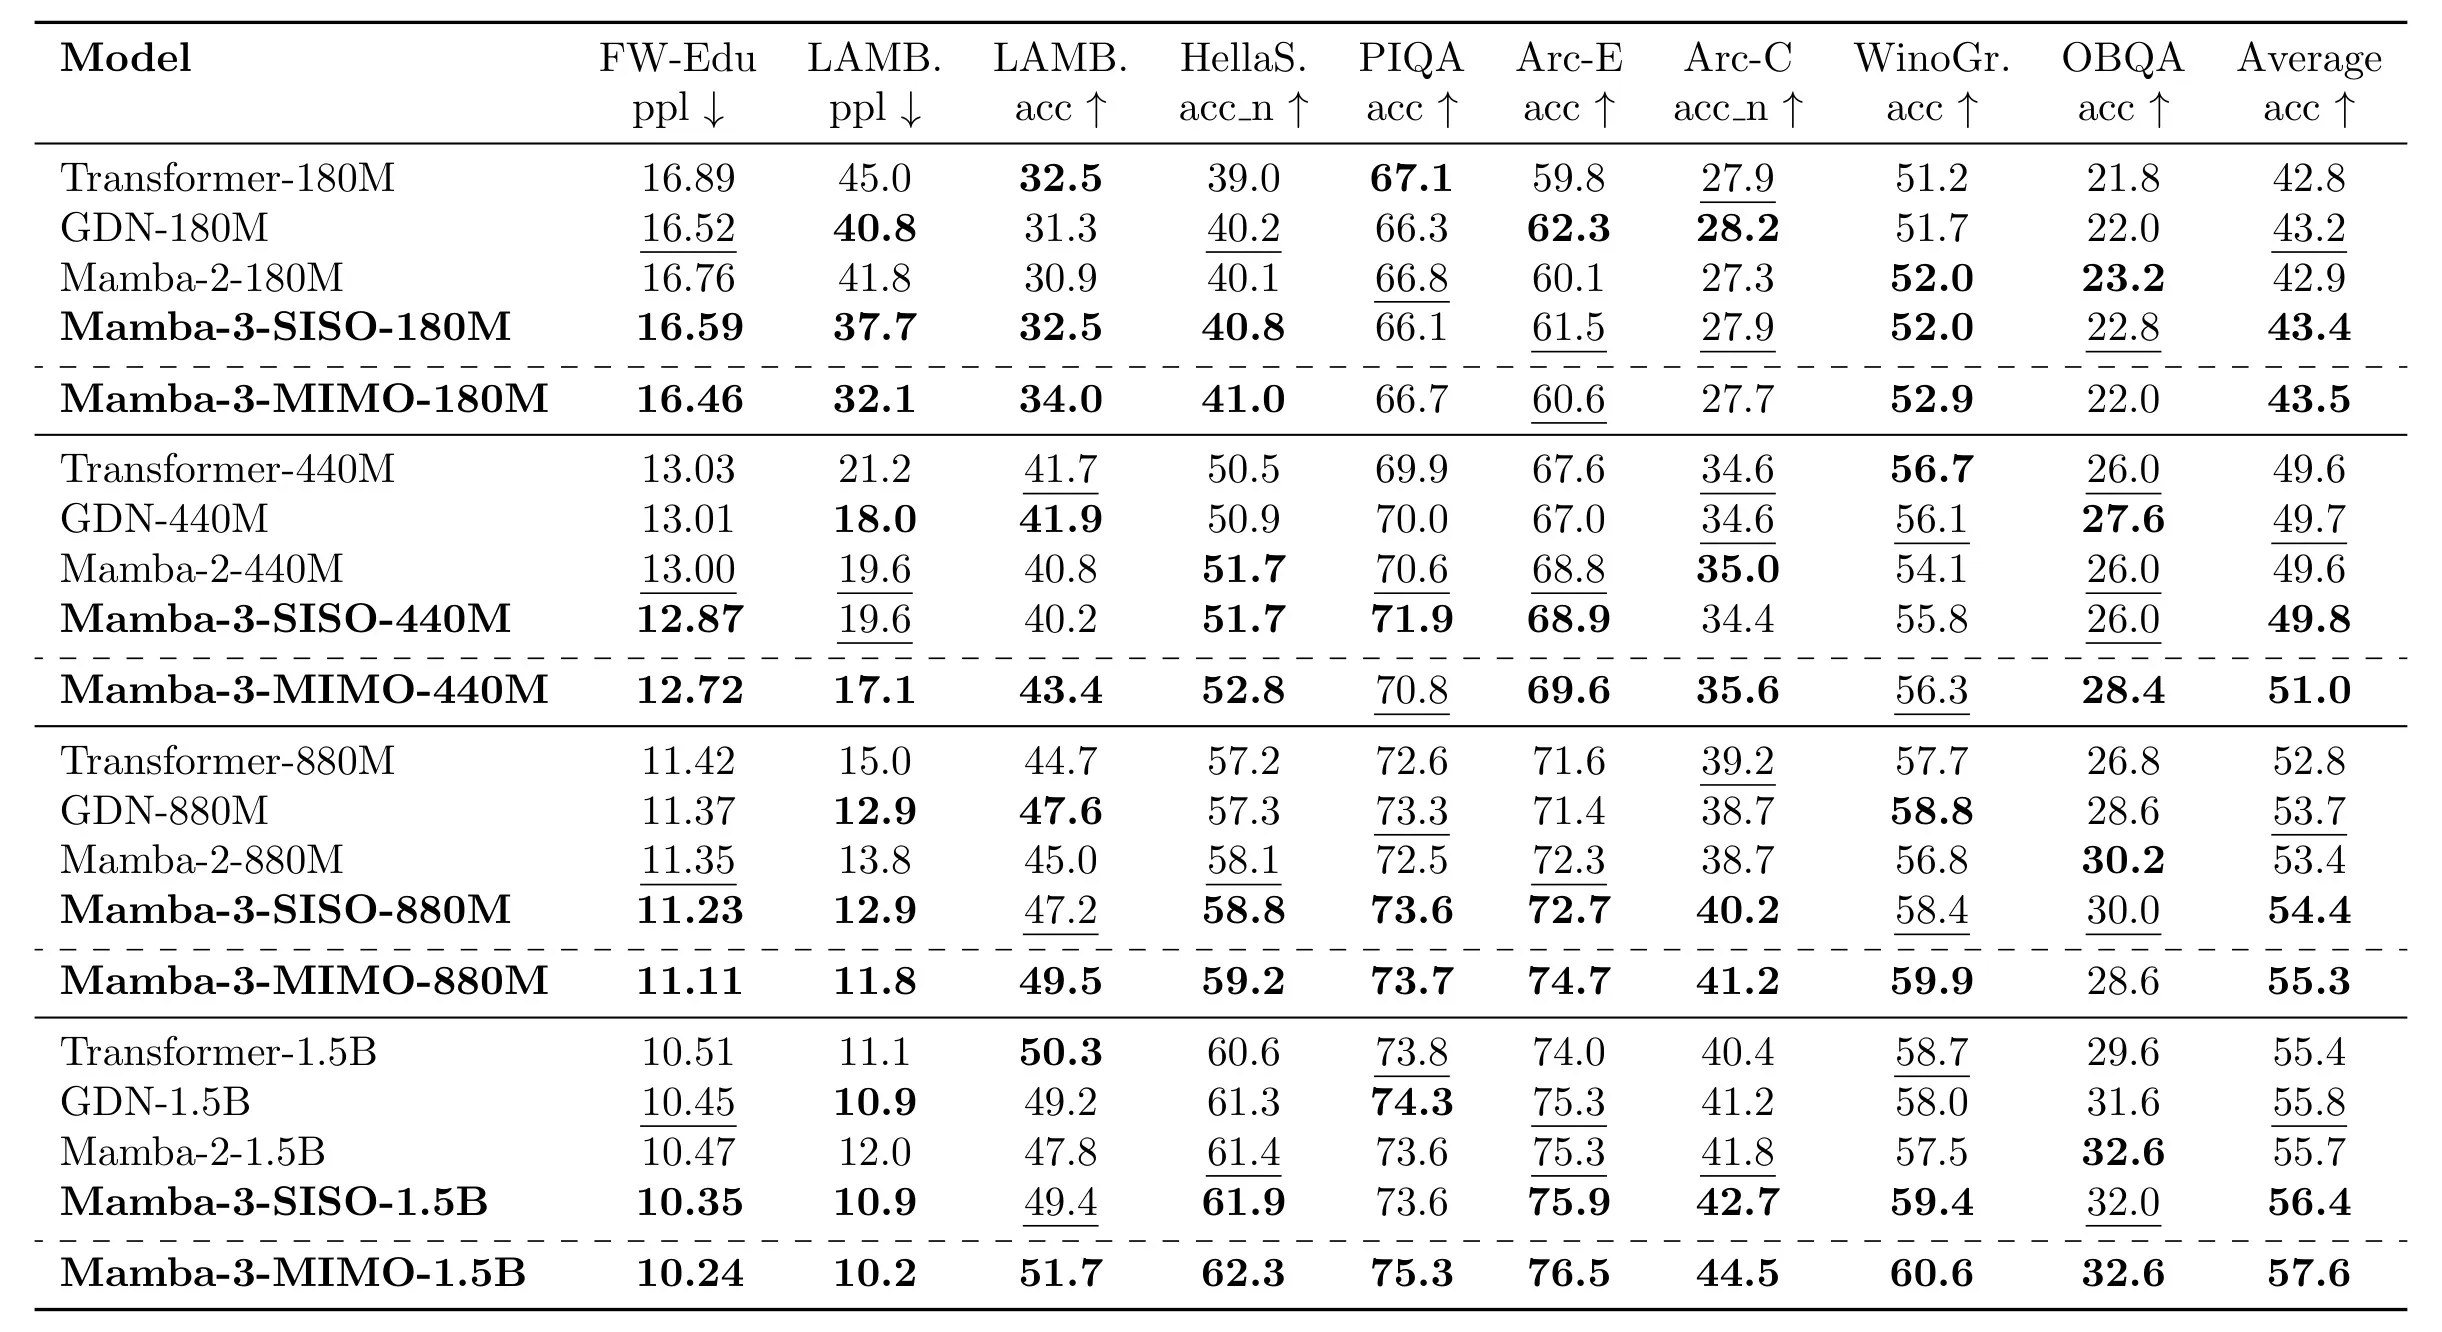
Mamba-3 supera Mamba-2 e alternative forti di attenzione lineare come GDN nella modellazione linguistica a diverse scale. Mamba-3-SISO è direttamente comparabile ai modelli lineari precedenti: ha per esempio le stesse dimensioni architetturali di Mamba-2, incluse dimensione del modello e dello stato, e tempi di addestramento comparabili. La variante MIMO migliora ulteriormente l’accuratezza di oltre 1 punto percentuale rispetto al normale Mamba-3 alla scala 1B, ma richiede addestramento più lungo, non maggiore latenza di decodifica.
Come possono crescere i costi di addestramento ma non quelli di inferenza?
La seconda parte approfondirà il tema. Ecco un’anticipazione.
La differenza deriva dal fatto che l’addestramento è limitato dal calcolo e l’inferenza dalla memoria. I modelli lineari attuali usano molti Tensor Core GPU, uno dei contributi principali di Mamba-2, per addestrare velocemente. Durante la decodifica, invece, ogni passo richiede così poco calcolo che gran parte dell’hardware resta inattiva.
Se aumentiamo solo i FLOP necessari a ogni passo, la latenza di inferenza rimane circa costante perché usiamo core prima inattivi. Questo non vale per l’addestramento.
Compiti di recupero
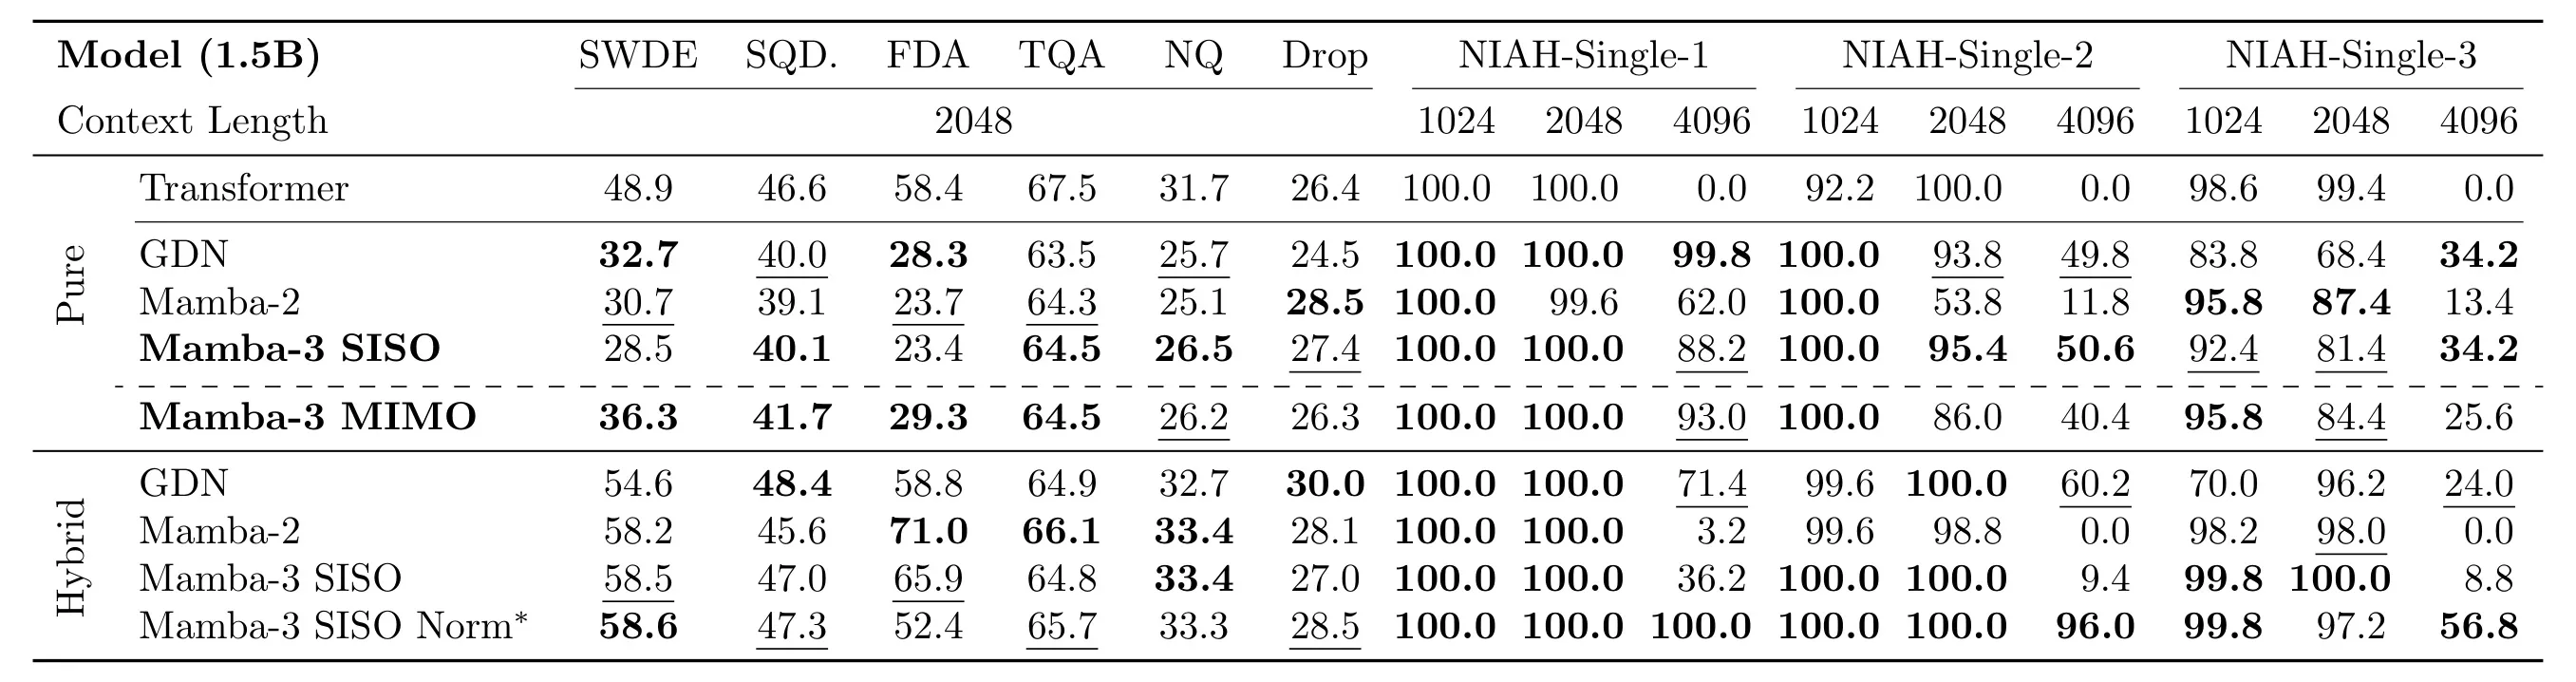
I modelli lineari, con stato fisso, sono naturalmente inferiori ai Transformer nei compiti di recupero. Come previsto, tra i modelli puri il Transformer è superiore, ma Mamba-3 funziona bene nella classe delle alternative subquadratiche. MIMO migliora ulteriormente il recupero senza aumentare lo stato.
Dato questo limite intrinseco, insieme alle buone prestazioni generali,
prevediamo che in futuro i livelli lineari saranno usati soprattutto insieme a livelli di self-attention globale.*
*Almeno per la modellazione del linguaggio.
I modelli ibridi combinano la memoria generale dei livelli lineari con l’archiviazione precisa, simile a un database, della cache KV. Empiricamente superano i modelli puri con importanti risparmi di memoria e calcolo 10. Anche qui troviamo che combinare livelli lineari e self-attention migliora il recupero rispetto a un Transformer standard.
Il modo esatto in cui interagiscono non è però pienamente compreso. Per esempio, la proiezione facoltativa prima dell’uscita di Mamba-3 migliora la generalizzazione della lunghezza nei compiti sintetici NIAH, con un piccolo costo nei compiti reali di recupero nel contesto. Anche posizione della normalizzazione, prima o dopo il gate, e tipo, a gruppi o normale, hanno effetti non trascurabili sull’accuratezza in dati semistrutturati e non strutturati come FDA e SWDE.
Kernel ovunque
Vogliamo vedere cosa costruirete con Mamba-3. Per aiutarvi pubblichiamo i kernel open source, veloci quanto i kernel Triton originali di Mamba-2.
Benchmark delle latenze
Latenza di prefill
| Modello | n=512 | 1024 | 2048 | 4096 | 16384 |
|---|---|---|---|---|---|
| vLLM (Llama-3.2-1B) | 0.26 | 0.52 | 1.08 | 2.08 | 12.17 |
| Gated DeltaNet | 0.51 | 1.01 | 2.01 | 4.00 | 16.21 |
| Mamba-2 | 0.51 | 1.02 | 2.02 | 4.02 | 16.22 |
| Mamba-3 (SISO) | 0.51 | 1.01 | 2.02 | 4.01 | 16.22 |
| Mamba-3 (MIMO R=4) | 0.60 | 1.21 | 2.42 | 4.76 | 19.44 |
Latenza di prefill e decodifica
| Modello | n=512 | 1024 | 2048 | 4096 | 16384 |
|---|---|---|---|---|---|
| vLLM (Llama-3.2-1B) | 4.45 | 9.60 | 20.37 | 58.64 | 976.50 |
| Gated DeltaNet | 4.56 | 9.11 | 18.22 | 36.41 | 145.87 |
| Mamba-2 | 4.66 | 9.32 | 18.62 | 37.22 | 149.02 |
| Mamba-3 (SISO) | 4.39 | 8.78 | 17.57 | 35.11 | 140.61 |
| Mamba-3 (MIMO R=4) | 4.74 | 9.48 | 18.96 | 37.85 | 151.81 |
Alla scala 1.5B, Mamba-3 SISO ottiene la latenza combinata di prefill e decodifica più bassa a tutte le lunghezze, superando Mamba-2, Gated DeltaNet e anche il Transformer con l’ecosistema vLLM molto ottimizzato. Mamba-3 MIMO ha inoltre velocità comparabile a Mamba-2 ma prestazioni molto migliori.
Il prefill Triton di Mamba-3 SISO mantiene prestazioni quasi identiche a Mamba-2: la nuova discretizzazione e gli embedding RoPE dipendenti dai dati non aggiungono costo. Mamba-3 MIMO rallenta moderatamente nel prefill grazie all’implementazione efficiente TileLang. La buona decodifica delle due varianti deriva in parte da CuTe DSL, la cui implementazione è stata molto facilitata dalla semplicità dei componenti Mamba-3.
Scelte progettuali
Abbiamo dedicato molto tempo a rendere i kernel veloci senza sacrificare la facilità d’uso. Abbiamo scelto Triton, TileLang e CuTe DSL.
Triton è stata una scelta semplice. È quasi uno standard per sviluppare architetture: il repository flash linear attention usa solo PyTorch e Triton. Permette prestazioni migliori del normale PyTorch con controllo della suddivisione in tile e fusione dei kernel, restando indipendente dalla piattaforma. Offre anche inserimento di PTX, linguaggio assembly per GPU, e supporto Tensor Memory Accelerator su Hopper per trasferimenti asincroni in blocco dalla memoria globale a quella condivisa.
Per il prefill MIMO abbiamo usato TileLang. Le proiezioni aggiuntive permettono di ridurre l’I/O manipolando strategicamente la gerarchia di memoria GPU. Triton non offriva la granularità di controllo desiderata. TileLang consente di dichiarare e controllare esplicitamente tile in memoria condivisa e creare frammenti nei registri, riusando meglio la memoria e restando abbastanza alto livello per sviluppare rapidamente.
Per i kernel di decodifica abbiamo scelto CuTe DSL. L’interfaccia Python genera kernel di basso livello con astrazioni di alto livello CUTLASS. Il controllo è quasi quello di CUDA e permette kernel molto efficienti adattati all’hardware, qui GPU Hopper. Controllando in dettaglio layout dei tensori e specializzazione dei warp, abbiamo sfruttato tutte le capacità della GPU.
Queste implementazioni a diversi livelli di astrazione sono possibili grazie al progetto algoritmico delle aggiunte semplici e leggere di Mamba-3. La pubblicazione completa approfondisce struttura della fusione e DSL dei kernel.
Prossimi passi
Sei arrivato alla fine della prima parte. Non abbiamo coperto tutti i dettagli di kernel, risultati e studi di ablazione, ma trovi tutto nel nostro articolo. I kernel sono open source su mamba-ssm.
La seconda e ultima parte approfondisce i tre miglioramenti principali di Mamba-3 e le basi SSM, e indica alcune direzioni che ci interessano particolarmente.
Note
Note a piè di pagina
-
oppure “BCNorm” nella terminologia SSM ↩
-
Mamba: Linear-Time Sequence Modeling with Selective State Spaces. [PDF] Gu, A. and Dao, T., 2024. ↩
-
Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality. [PDF] Dao, T. and Gu, A., 2024. ↩
-
Gated Delta Networks: Improving Mamba2 with Delta Rule [PDF] ↩
-
Learning to (Learn at Test Time): RNNs with Expressive Hidden States [PDF] ↩
-
Hungry Hungry Hippos: Towards Language Modeling with State Space Models [PDF] ↩
-
In-context Learning and Induction Heads ↩
-
Test-time regression: a unifying framework for designing sequence models with associative memory [PDF] ↩