Esta publicação foi reproduzida do Goomba Lab, liderado pelo cientista-chefe da Cartesia, Albert Gu.
Desde o lançamento do Mamba-2, em meados de 2024, a maioria das arquiteturas migrou do Mamba-1. O Mamba-2 apostou que a eficiência de treinamento era o maior gargalo dos modelos de espaço de estados, ou SSMs. Por isso, simplificou seu mecanismo para treinar de 2 a 8× mais rápido que o antecessor, ampliando a adoção.
Desde então, o cenário dos LLMs começou a mudar. O pré-treinamento continua muito importante, mas o pós-treinamento e a implantação recebem mais atenção, e ambos exigem muita inferência. Escalar métodos de pós-treinamento, especialmente aprendizado por reforço com recompensas verificáveis, ou RLVR, para código e matemática, exige gerar enormes quantidades de trajetórias. Mais recentemente, fluxos com agentes como Codex, Claude Code e OpenClaw fizeram a demanda por inferência disparar.
Apesar da importância crescente da inferência, muitas arquiteturas lineares, incluindo Mamba-2, foram desenvolvidas priorizando o treinamento. Para acelerar o pré-treinamento, o SSM foi simplificado progressivamente. Por exemplo, a transição diagonal foi reduzida a um escalar vezes a identidade. Isso acelerou o treinamento, mas deixou a etapa de inferência simples demais e limitada pela memória. As GPUs passam a maior parte do tempo movendo dados, em vez de calcular.
Nesta nova era da inferência, queremos ampliar a fronteira entre qualidade e eficiência. Queremos que modelos melhores rodem mais rápido.
Surge uma pergunta natural:
Como seria um SSM projetado pensando na inferência?
O modelo Mamba-3
O que falta? A principal vantagem dos modelos lineares está no nome. A computação cresce linearmente com o comprimento da sequência porque o estado tem tamanho fixo. Mas não existe almoço grátis. Esse mesmo estado de tamanho fixo obriga o modelo a comprimir todas as informações anteriores em uma representação. É o oposto de um Transformer, que armazena o passado em um estado que cresce continuamente, o cache KV. Se não podemos aumentar o estado, como fazê-lo trabalhar mais?
Projetos anteriores simplificaram a recorrência e a matriz de transição para acelerar o treinamento. Mas isso também reduziu a riqueza da dinâmica e deixou a decodificação limitada pela memória. Cada atualização de token faz pouco cálculo em relação à movimentação de dados. Temos, portanto, três caminhos. Tornar a recorrência mais expressiva, usar uma matriz de transição mais rica e adicionar mais trabalho paralelo, quase gratuito, a cada atualização.
Com base nessas ideias, melhoramos o Mamba-2 de três formas centrais:
- Aumentamos a expressividade do mecanismo SSM com uma recorrência mais geral, derivada do nosso esquema de discretização exponencial-trapezoidal.
- Ampliamos a capacidade de acompanhamento de estado modelando um sistema SSM com valores complexos.
- Melhoramos o desempenho geral com pouco impacto na latência de decodificação usando SSMs de múltiplas entradas e múltiplas saídas, ou MIMO, que modelam vários SSMs em paralelo, em vez dos atuais SSMs de uma entrada e uma saída, ou SISO.
Com essas mudanças, o Mamba-3 amplia a fronteira de desempenho e mantém latência de inferência semelhante.
As três mudanças se inspiram na literatura mais clássica de teoria de controle e modelos de espaço de estados.
Nosso trabalho segue uma direção diferente da de muitas arquiteturas lineares modernas. Elas usam interpretações alternativas da recorrência, como atenção linear ou treinamento durante o teste, que não representam esses conceitos com facilidade.
Arquitetura
O que mudou na camada Mamba-2? Além das três melhorias metodológicas no SSM, ajustamos a arquitetura para aproximá-la dos modelos de linguagem modernos convencionais.
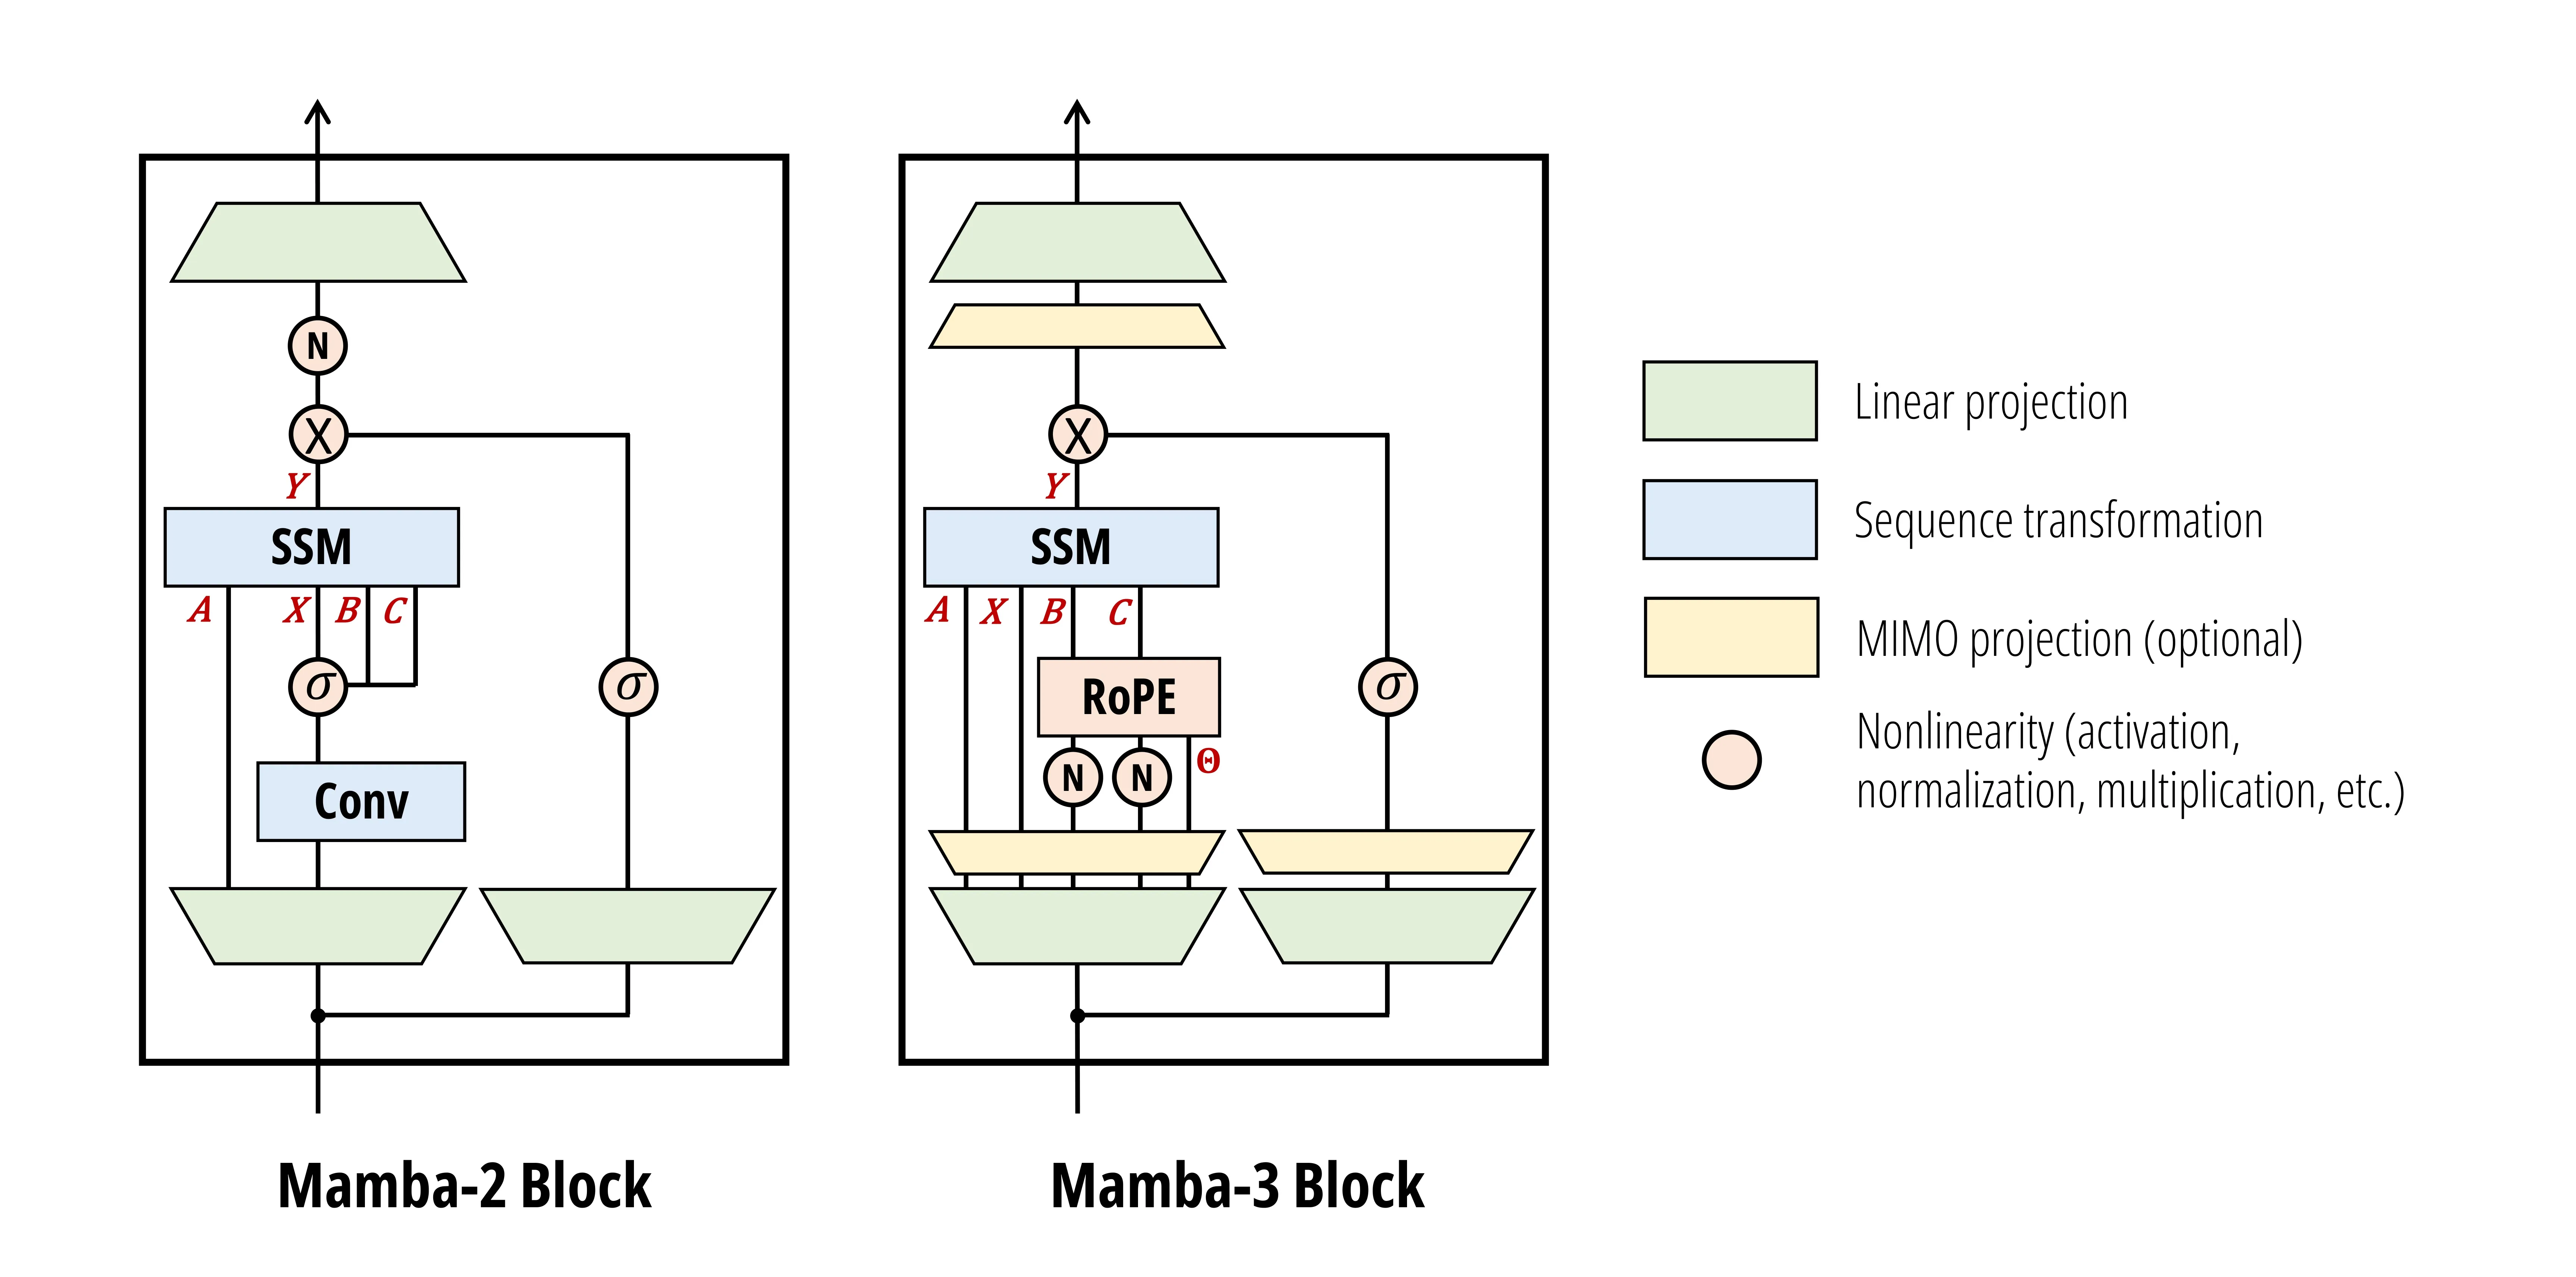
O diagrama mostra algumas mudanças. Em linhas gerais:
Normalizações. Adicionamos QKNorm 1 1, que estabiliza empiricamente o treinamento dos modelos Mamba-3. Isso aproxima o Mamba-3 dos Transformers e Gated DeltaNets, ou GDNs, atuais. Com QKNorm, a RMSNorm do Mamba-2 se torna opcional. Porém, os experimentos indicam que pode valer a pena mantê-la em modelos híbridos, pois ajuda a extrapolar para sequências mais longas. Voltaremos a isso adiante.
Adeus à convolução curta. Removemos a convolução causal curta do Mamba-1/2 combinando vieses simples em B e C após BCNorm com nossa nova recorrência baseada em discretização. Ela aplica implicitamente uma convolução à entrada do estado oculto. Mostramos como isso acontece na parte 2 desta série.
A convolução curta pode mesmo ser removida?
As mudanças do Mamba-3 adicionam componentes semelhantes a convoluções dentro da recorrência SSM, mas eles não são exatamente intercambiáveis com a convolução curta padrão colocada fora dela.
Essa convolução externa ainda pode ser usada com Mamba-3. A decisão de não usá-la veio de experimentos. Observamos que recolocá-la:
- Não melhora o desempenho. Na verdade, o piora ligeiramente.
- Não degrada a recuperação em tarefas mais próximas do mundo real, como NIAH. Ainda assim, sem uma convolução curta, treinar em pequenas tarefas sintéticas como MQAR fica um pouco mais difícil. Como a recuperação no mundo real não é afetada, não consideramos isso uma limitação importante.
Não estudamos os mecanismos teóricos por trás disso. No artigo, propomos que tanto o viés BC quanto a recorrência exponencial-trapezoidal realizam mecanismos semelhantes a convoluções, que empiricamente cumprem a mesma função da convolução curta externa.
Uma breve história da convolução curta
A convolução curta é hoje um componente central da maioria dos modelos lineares de melhor desempenho 2 3 4 5. Suas primeiras versões em arquiteturas recorrentes apareceram no H3 6, como um “shift SSM” inspirado no trabalho da Anthropic sobre cabeças de indução “smeared” 7, e no RWKV-4 8, com o mecanismo de deslocamento de tokens. Depois, o Mamba-1 popularizou sua forma atual.
Ela se tornou comum porque trabalhos anteriores mostraram repetidamente que convoluções curtas melhoram o desempenho empírico e dão suporte teórico a capacidades de recuperação por indução 9.
Você também verá novos componentes, RoPE e projeções MIMO. O módulo RoPE representa SSMs de valores complexos interpretando transições complexas como rotações, evitando a reimplementação cara dos kernels. As projeções MIMO expandem as matrizes B e C para a representação necessária aos SSMs MIMO.
A segunda parte da série detalha a motivação e a implementação desses dois componentes. Por enquanto, pense neles como melhorias fundamentais independentes, que contribuem individualmente para o desempenho e as capacidades do modelo.
Por fim, a arquitetura geral agora usa camadas MLP intercaladas, seguindo a convenção dos Transformers e de outros modelos lineares.
Resultados empíricos
Avaliamos o Mamba-3 final em comparação com alternativas lineares populares e com o Transformer de referência.
Modelagem de linguagem
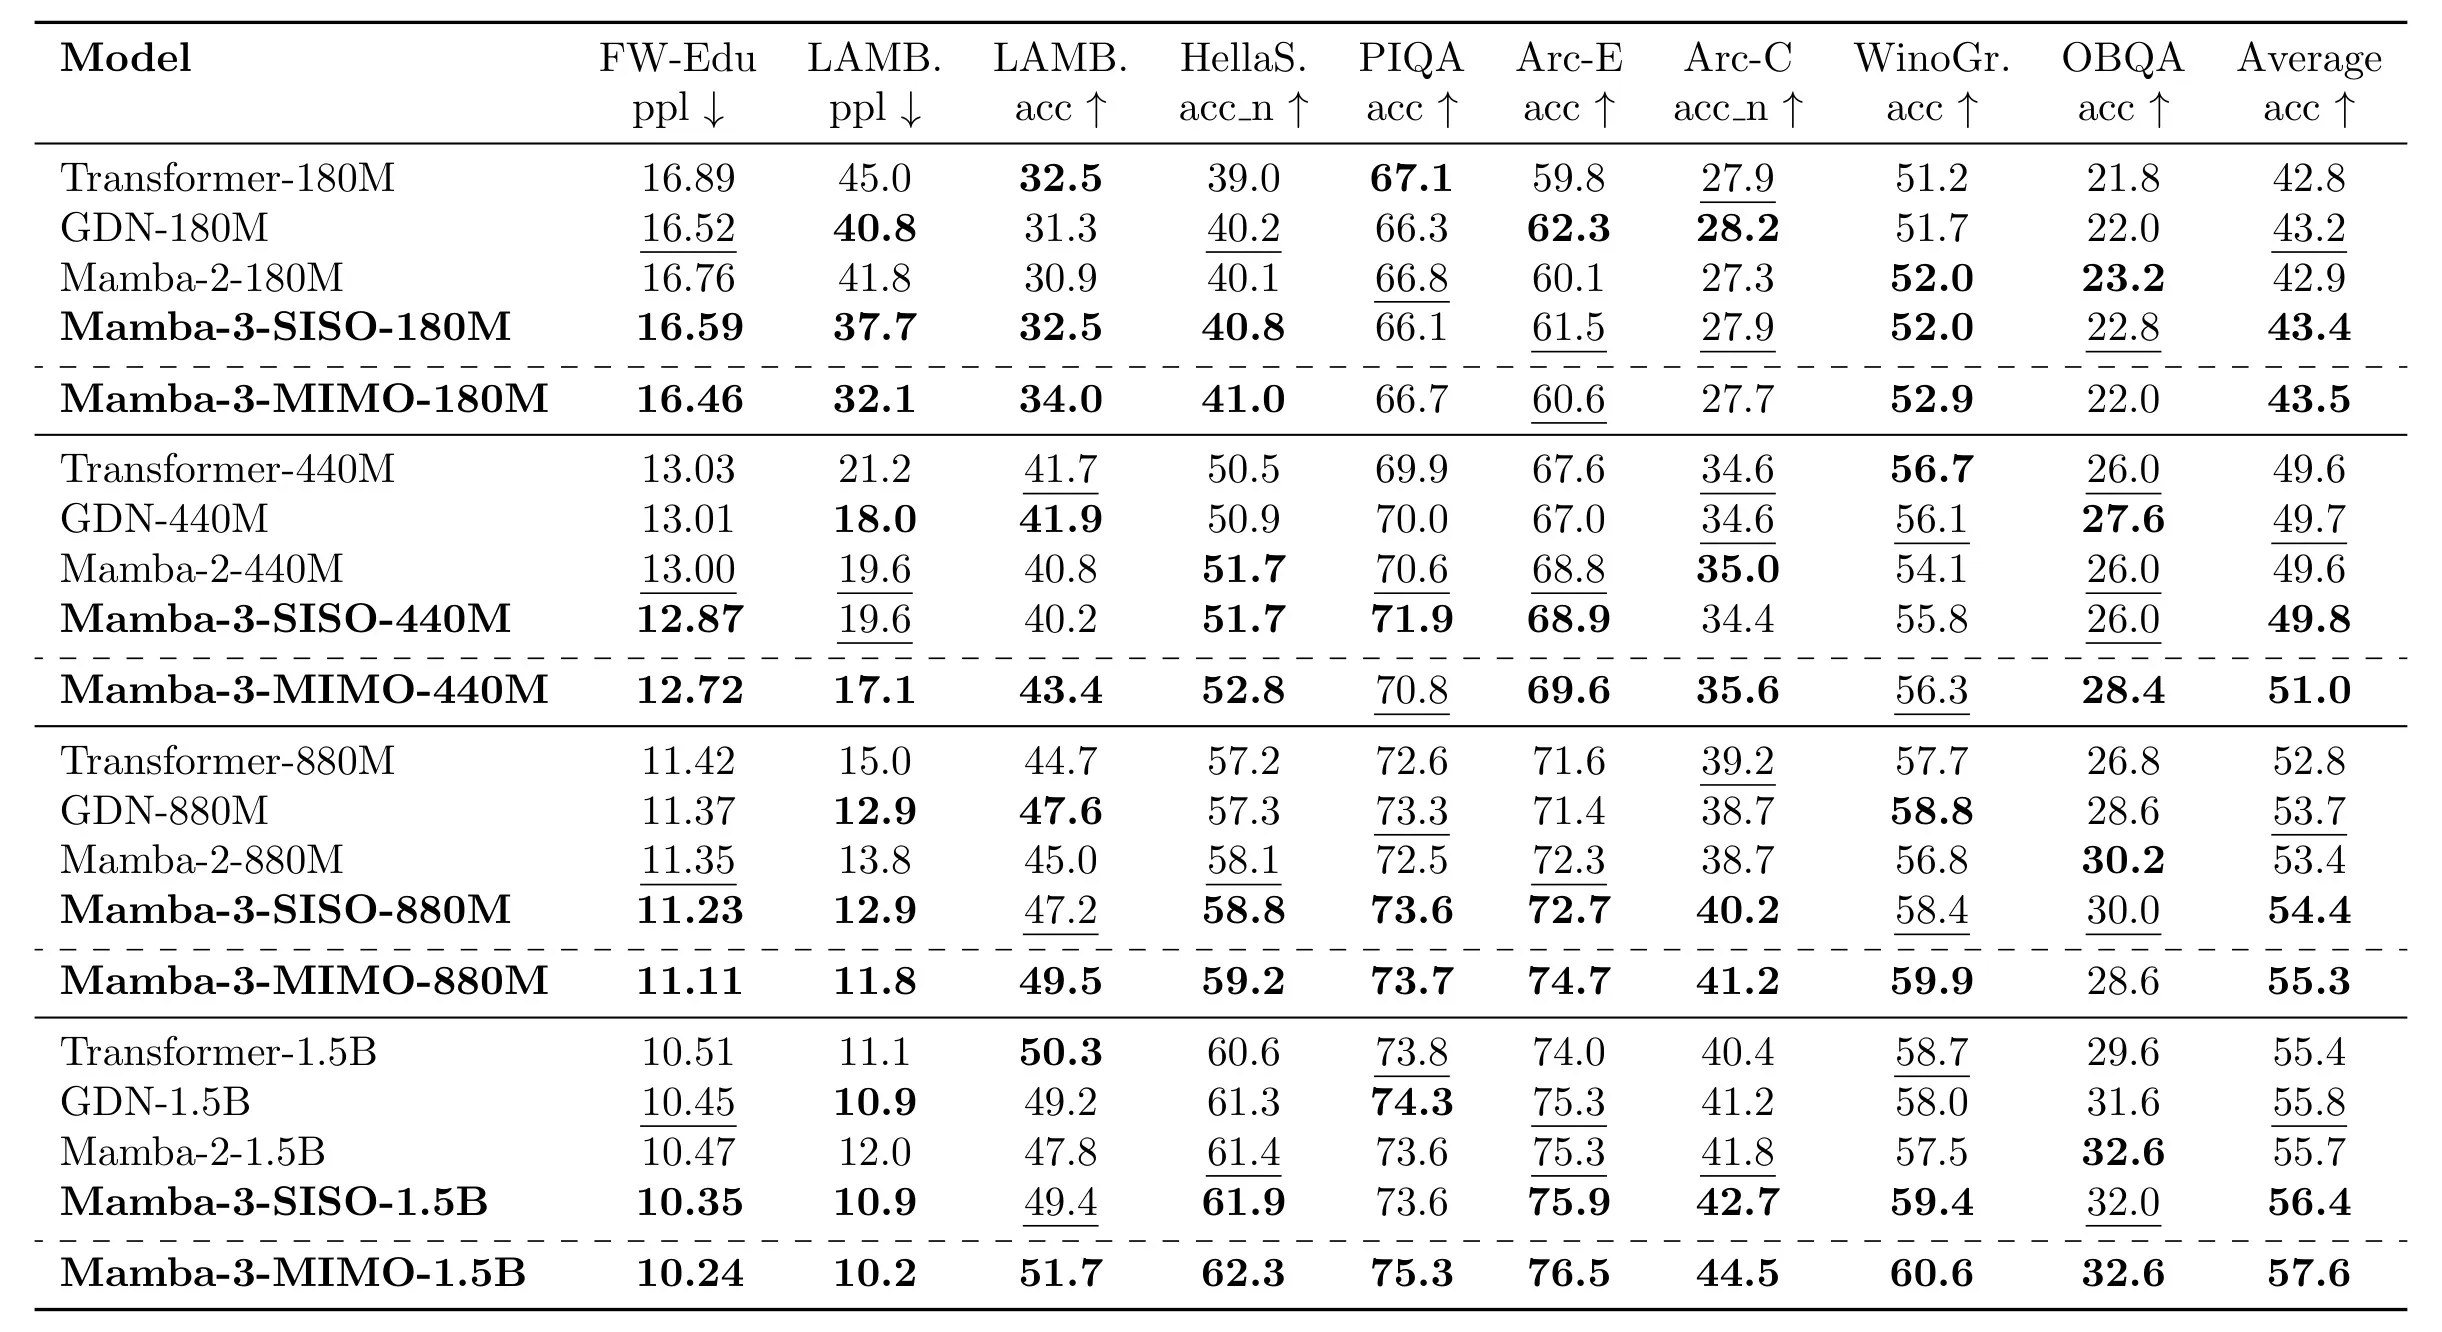
Nosso novo Mamba-3 supera o Mamba-2 e alternativas fortes de atenção linear, como GDN, na modelagem de linguagem em várias escalas de modelos pré-treinados. O Mamba-3-SISO é diretamente comparável aos modelos lineares anteriores. Ele corresponde exatamente ao Mamba-2 nas dimensões da arquitetura, como dimensões do modelo e tamanho de estado, e tem tempo de treinamento comparável. A variante MIMO melhora ainda mais a acurácia nas tarefas posteriores, em mais de 1 ponto percentual em relação ao Mamba-3 normal na escala de 1B. A ressalva é que o MIMO exige mais tempo de treinamento, mas não aumenta a latência de decodificação!
Como o custo de treinamento aumenta sem aumentar o de inferência?
Vamos detalhar isso na segunda parte, mas aqui está uma prévia:
A diferença vem de o treinamento ser limitado por computação e a inferência por memória. Os modelos lineares atuais foram projetados para usar muitos Tensor Cores da GPU, uma das principais contribuições do Mamba-2, e treinar rapidamente. Mas, durante a decodificação, cada passo exige tão pouco cálculo que o hardware fica ocioso por boa parte do tempo.
Assim, se projetamos arquiteturas que apenas aumentam os FLOPs de cada passo, a latência de inferência permanece quase constante, pois usamos núcleos antes ociosos. No treinamento, isso não acontece.
Tarefas de recuperação
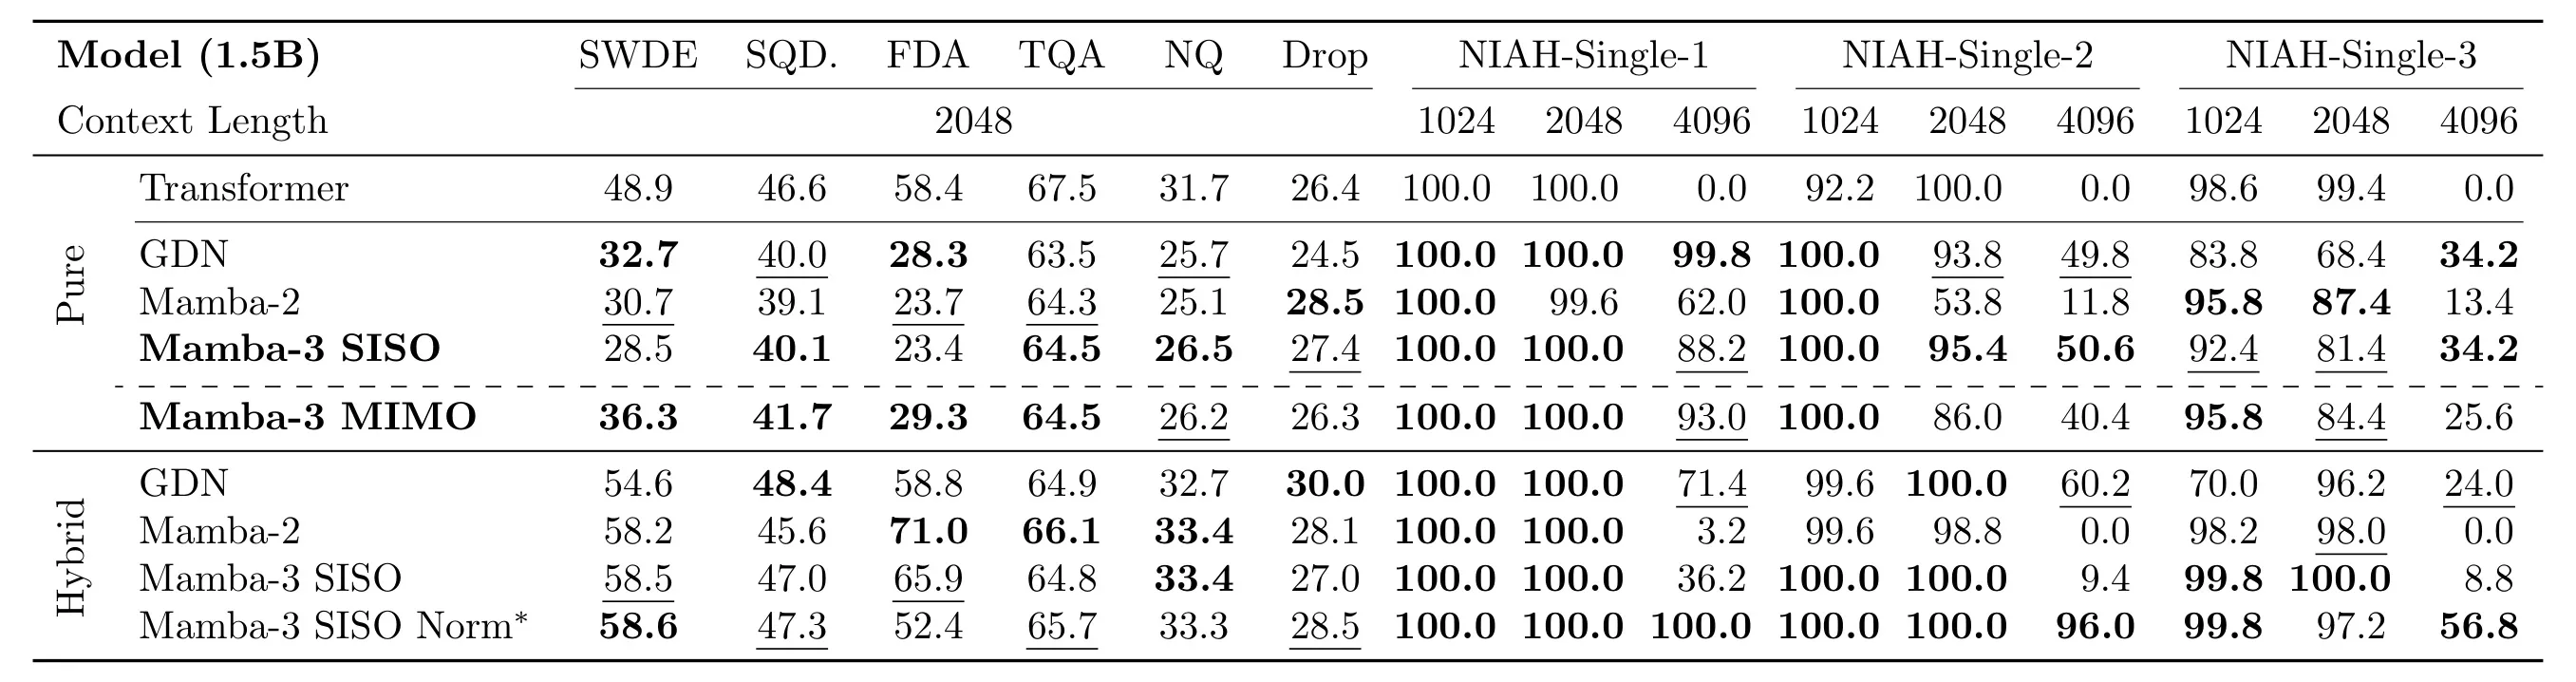
Modelos lineares, com estado de tamanho fixo, naturalmente ficam atrás dos Transformers em tarefas de recuperação. Como esperado, entre modelos puros, o Transformer é superior nessas tarefas. Ainda assim, o Mamba-3 tem bom desempenho entre alternativas subquadráticas. A adição de MIMO melhora ainda mais a recuperação sem aumentar o tamanho do estado.
Diante dessa limitação inerente e do bom desempenho geral de modelagem,
prevemos que, no futuro, as camadas lineares serão usadas principalmente em conjunto com camadas globais de autoatenção.*
*pelo menos na modelagem de linguagem
Modelos híbridos combinam a natureza geral de memória das camadas lineares com o armazenamento exato, semelhante a um banco de dados, do cache KV da autoatenção. Experimentos mostram que eles superam modelos puros e economizam memória e computação 10. Aqui, também observamos que combinar camadas lineares e autoatenção melhora a recuperação em relação a um Transformer convencional.
Porém, a forma exata como esses modelos interagem com a autoatenção ainda não é totalmente compreendida. Por exemplo, a projeção opcional antes da saída do Mamba-3 melhora a generalização para comprimentos maiores nas tarefas sintéticas NIAH, com um pequeno custo nas tarefas reais de recuperação em contexto. Mesmo detalhes da normalização reintroduzida, como posição antes ou depois da porta e tipo agrupado ou normal, afetam de forma relevante a acurácia em tarefas com dados semiestruturados e não estruturados, como FDA e SWDE.
Kernels por toda parte
Queremos ver o que as pessoas vão construir com Mamba-3. Para ajudar, estamos abrindo o código dos nossos kernels, que igualam a velocidade dos kernels Triton originais do Mamba-2.
Benchmarks de latência
Latência de prefill
| Modelo | n=512 | 1024 | 2048 | 4096 | 16384 |
|---|---|---|---|---|---|
| vLLM (Llama-3.2-1B) | 0.26 | 0.52 | 1.08 | 2.08 | 12.17 |
| Gated DeltaNet | 0.51 | 1.01 | 2.01 | 4.00 | 16.21 |
| Mamba-2 | 0.51 | 1.02 | 2.02 | 4.02 | 16.22 |
| Mamba-3 (SISO) | 0.51 | 1.01 | 2.02 | 4.01 | 16.22 |
| Mamba-3 (MIMO R=4) | 0.60 | 1.21 | 2.42 | 4.76 | 19.44 |
Latência de prefill e decodificação
| Modelo | n=512 | 1024 | 2048 | 4096 | 16384 |
|---|---|---|---|---|---|
| vLLM (Llama-3.2-1B) | 4.45 | 9.60 | 20.37 | 58.64 | 976.50 |
| Gated DeltaNet | 4.56 | 9.11 | 18.22 | 36.41 | 145.87 |
| Mamba-2 | 4.66 | 9.32 | 18.62 | 37.22 | 149.02 |
| Mamba-3 (SISO) | 4.39 | 8.78 | 17.57 | 35.11 | 140.61 |
| Mamba-3 (MIMO R=4) | 4.74 | 9.48 | 18.96 | 37.85 | 151.81 |
Na comparação de modelos de 1.5B parâmetros, a variante SISO do Mamba-3 alcança a menor latência de prefill e decodificação em todos os comprimentos de sequência. Ela supera Mamba-2, Gated DeltaNet e até o Transformer com seu ecossistema vLLM altamente otimizado. Além disso, o Mamba-3 MIMO tem velocidade comparável à do Mamba-2, com desempenho de modelagem muito melhor.
O prefill do Mamba-3 SISO em Triton mantém desempenho quase idêntico ao do Mamba-2. Isso mostra que a nova discretização e os embeddings RoPE dependentes dos dados não acrescentam custo. O Mamba-3 MIMO tem apenas uma desaceleração moderada no prefill, graças à implementação eficiente em TileLang. O bom desempenho de decodificação das duas variantes vem em parte da implementação em CuTe DSL, muito facilitada pela simplicidade dos componentes do Mamba-3.
Escolhas de projeto
Pensamos bastante em como tornar os kernels tão rápidos quanto possível sem comprometer a facilidade de uso. Escolhemos Triton, TileLang e CuTe DSL.
Escolher Triton foi fácil. Ele é praticamente padrão no desenvolvimento de arquiteturas, e o excelente repositório flash linear attention usa apenas PyTorch e Triton. Há bons motivos. Triton supera o PyTorch padrão ao permitir blocagem controlada e fusão de kernels, sem depender de uma plataforma. Também oferece injeção de PTX, uma linguagem assembly para GPU, e suporte ao Tensor Memory Accelerator nas GPUs Hopper, para transferências assíncronas em bloco da memória global para a compartilhada.
Já nossos kernels de prefill MIMO usam TileLang. As projeções adicionais dessa variante permitem reduzir entrada e saída de memória manipulando estrategicamente a hierarquia de memória da GPU. Triton não oferecia o controle granular que queríamos. TileLang permite declarar e controlar explicitamente blocos de memória compartilhada e criar fragmentos de registradores, reutilizando memória com mais eficiência. Ao mesmo tempo, é de alto nível o suficiente para desenvolver os kernels rapidamente.
Como insistimos na importância da inferência e da decodificação, escolhemos CuTe DSL para os kernels de decodificação. Sua interface Python permite gerar kernels de baixo nível com abstrações de alto nível do CUTLASS. Temos praticamente o controle do CUDA, permitindo kernels de alto desempenho adaptados ao hardware, neste caso GPUs Hopper. Com controle detalhado do layout dos tensores e da especialização de warps, construímos um kernel que aproveita os recursos da GPU.
Essas implementações em diferentes níveis de abstração são possíveis pelo projeto algorítmico das adições simples e leves do Mamba-3 e pela forma como são implementadas. Nossa publicação completa detalha a estrutura exata de fusão e as linguagens dos kernels.
A seguir
Você chegou ao fim da parte 1! Não conseguimos cobrir todos os detalhes dos kernels, resultados experimentais e estudos de ablação aqui. Tudo está no artigo, e o código dos kernels está disponível em mamba-ssm!
A segunda e última parte detalha as três melhorias centrais do Mamba-3, seus fundamentos em SSMs e algumas direções que nos interessam especialmente.
Notas
Notas de rodapé
-
ou “BCNorm” na terminologia de SSMs ↩
-
Mamba: Linear-Time Sequence Modeling with Selective State Spaces. [PDF] Gu, A. and Dao, T., 2024. ↩
-
Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality. [PDF] Dao, T. and Gu, A., 2024. ↩
-
Gated Delta Networks: Improving Mamba2 with Delta Rule [PDF] ↩
-
Learning to (Learn at Test Time): RNNs with Expressive Hidden States [PDF] ↩
-
Hungry Hungry Hippos: Towards Language Modeling with State Space Models [PDF] ↩
-
In-context Learning and Induction Heads ↩
-
Test-time regression: a unifying framework for designing sequence models with associative memory [PDF] ↩