Este artículo también se publica en Goomba Lab, dirigido por Albert Gu, director científico de Cartesia.
Desde el lanzamiento de Mamba-2 a mediados de 2024, muchas arquitecturas han abandonado Mamba-1. Mamba-2 apostó por que la eficiencia de entrenamiento era el principal cuello de botella de los SSM. Simplificó el mecanismo subyacente y logró entrenar entre 2 y 8 veces más rápido, lo que facilitó su adopción.
Desde entonces, los LLM han cambiado. El preentrenamiento sigue importando, pero el entrenamiento posterior y el despliegue reciben más atención, y ambos necesitan muchísima inferencia. Ampliar métodos como el aprendizaje por refuerzo con recompensas verificables, RLVR, para código o matemáticas exige generar grandes cantidades de trayectorias. Más recientemente, los procesos con agentes como Codex, Claude Code u OpenClaw han disparado la demanda de inferencia.
Pese a ello, muchas arquitecturas lineales, incluida Mamba-2, se diseñaron priorizando el entrenamiento. Para acelerarlo, se simplificó progresivamente el SSM; por ejemplo, la transición diagonal pasó a ser un escalar por la identidad. Esto dejó la inferencia demasiado simple y limitada por la memoria: las GPU pasan buena parte del tiempo moviendo datos en vez de calcular.
En esta etapa queremos ampliar la frontera entre calidad y eficiencia: que los modelos mejores funcionen más rápido.
Surge una pregunta:
¿Cómo sería un SSM diseñado pensando en la inferencia?
El modelo Mamba-3
¿Qué falta? El atractivo de los modelos lineales está en su nombre: el cómputo crece linealmente con la secuencia gracias a un estado de tamaño fijo. Pero nada sale gratis. Ese estado fijo obliga a comprimir toda la información pasada en una representación. Un Transformer, en cambio, la conserva en un estado que crece continuamente, la caché KV. Si no podemos ampliar el estado, ¿cómo hacemos que trabaje más?
Los diseños anteriores simplificaron la recurrencia y la matriz de transición para acelerar el entrenamiento. También redujeron la riqueza de la dinámica y dejaron la decodificación limitada por la memoria: cada actualización calcula poco respecto a los datos que mueve. Esto ofrece tres vías: hacer más expresiva la recurrencia, enriquecer la matriz de transición y añadir más trabajo paralelo, casi gratuito, en cada actualización.
Mejoramos Mamba-2 de tres formas:
- Aumentamos la expresividad del mecanismo SSM mediante una recurrencia más general derivada de nuestro esquema de discretización exponencial-trapezoidal.
- Ampliamos el seguimiento del estado mediante un sistema SSM de valores complejos.
- Mejoramos el rendimiento con poco efecto sobre la latencia de decodificación mediante SSM de múltiples entradas y salidas, MIMO, que modelan varios SSM en paralelo, frente a los actuales de una sola entrada y salida, SISO.
Con estos cambios, Mamba-3 mejora el rendimiento manteniendo una latencia de inferencia similar.
Los tres cambios se inspiran en la literatura clásica de teoría de control y modelos de espacio de estados.
Nuestro trabajo se aparta de muchas arquitecturas lineales modernas que interpretan la recurrencia como atención lineal o entrenamiento en tiempo de prueba, enfoques que no recogen fácilmente estos conceptos.
Arquitectura
Además de mejorar el SSM, hemos ajustado la capa Mamba-2 para acercarla a los modelos de lenguaje modernos habituales.
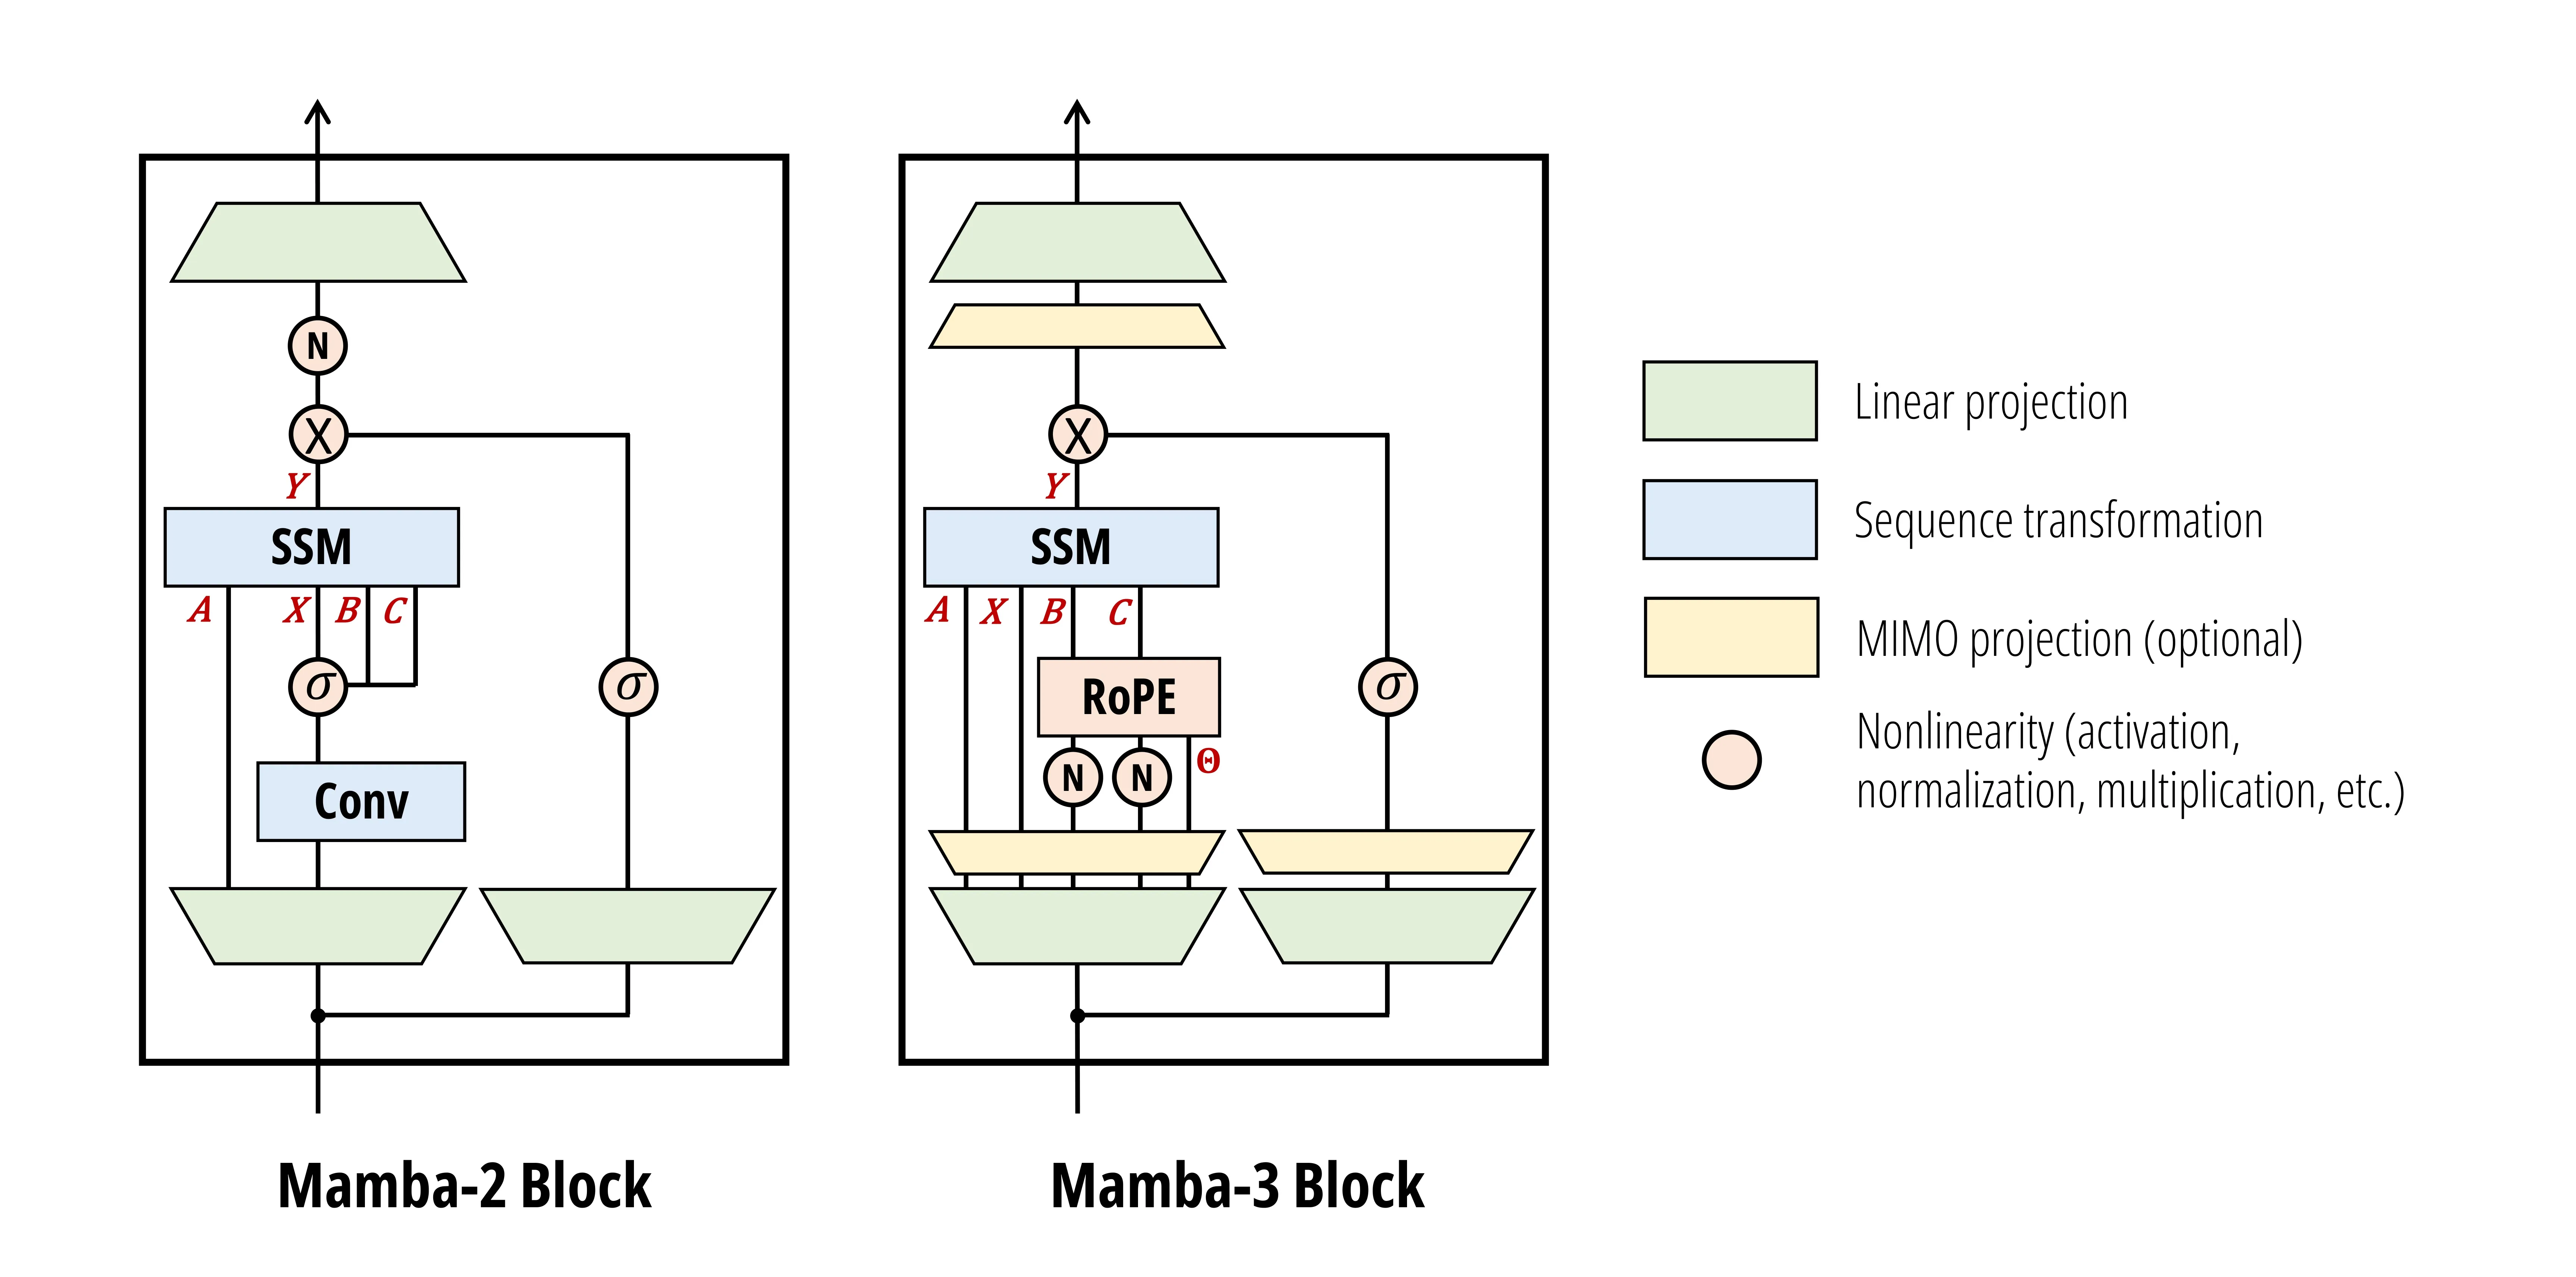
El diagrama muestra varios cambios.
Normalizaciones. Añadimos QKNorm 1 1, que estabiliza el entrenamiento en nuestros experimentos y acerca Mamba-3 a Transformers y Gated DeltaNet, GDN. Con QKNorm, RMSNorm de Mamba-2 es opcional. Aun así, observamos que puede convenir conservarla en modelos híbridos porque ayuda a extrapolar longitudes. Volveremos sobre ello.
Adiós a la convolución corta. Eliminamos la convolución causal corta de Mamba-1/2 combinando sesgos sencillos en B y C después de BCNorm con la nueva recurrencia basada en discretización. Esta aplica implícitamente una convolución a la entrada del estado oculto, como explicamos en la segunda parte.
¿Se puede eliminar realmente la convolución corta?
Mamba-3 incorpora componentes similares a convoluciones dentro de la recurrencia SSM, pero no son exactamente intercambiables con la convolución corta estándar externa.
Esta última sigue siendo compatible, aunque decidimos no usarla por los resultados experimentales. Al añadirla de nuevo:
- El rendimiento no mejora; empeora ligeramente.
- Las capacidades de recuperación en tareas más reales, como NIAH, no se degradan. Sin una convolución corta, entrenar tareas sintéticas pequeñas como MQAR se vuelve algo más difícil. Como la recuperación real no cambia, no lo consideramos una gran limitación.
No estudiamos el mecanismo teórico, pero en el artículo planteamos que el sesgo BC y la recurrencia exponencial-trapezoidal realizan operaciones parecidas a convoluciones que cumplen empíricamente la misma función.
Breve historia de la convolución corta
Hoy es un componente básico de muchos modelos lineales de alto rendimiento 2 3 4 5. H3 6 la introdujo en arquitecturas recurrentes mediante un “shift SSM”, inspirado en las cabezas de inducción difuminadas de Anthropic 7. RWKV-4 8 utilizó su mecanismo de desplazamiento de tokens. Después, Mamba-1 popularizó su forma actual.
Se utiliza tanto porque trabajos anteriores mostraron repetidamente mejoras empíricas y apoyo teórico a la recuperación basada en inducción 9.
También aparecen RoPE y las proyecciones MIMO. RoPE expresa SSM de valores complejos interpretando las transiciones complejas como rotaciones, sin reimplementar kernels de forma costosa. Las proyecciones amplían B y C a la representación necesaria para MIMO.
La segunda parte detalla su motivación e implementación. Por ahora, pueden entenderse como mejoras independientes que aumentan el rendimiento o las capacidades.
La arquitectura completa también adopta capas MLP intercaladas, siguiendo la convención de Transformers y otros modelos lineales.
Resultados experimentales
Evaluamos Mamba-3 frente a alternativas lineales populares y un Transformer de referencia.
Modelado del lenguaje
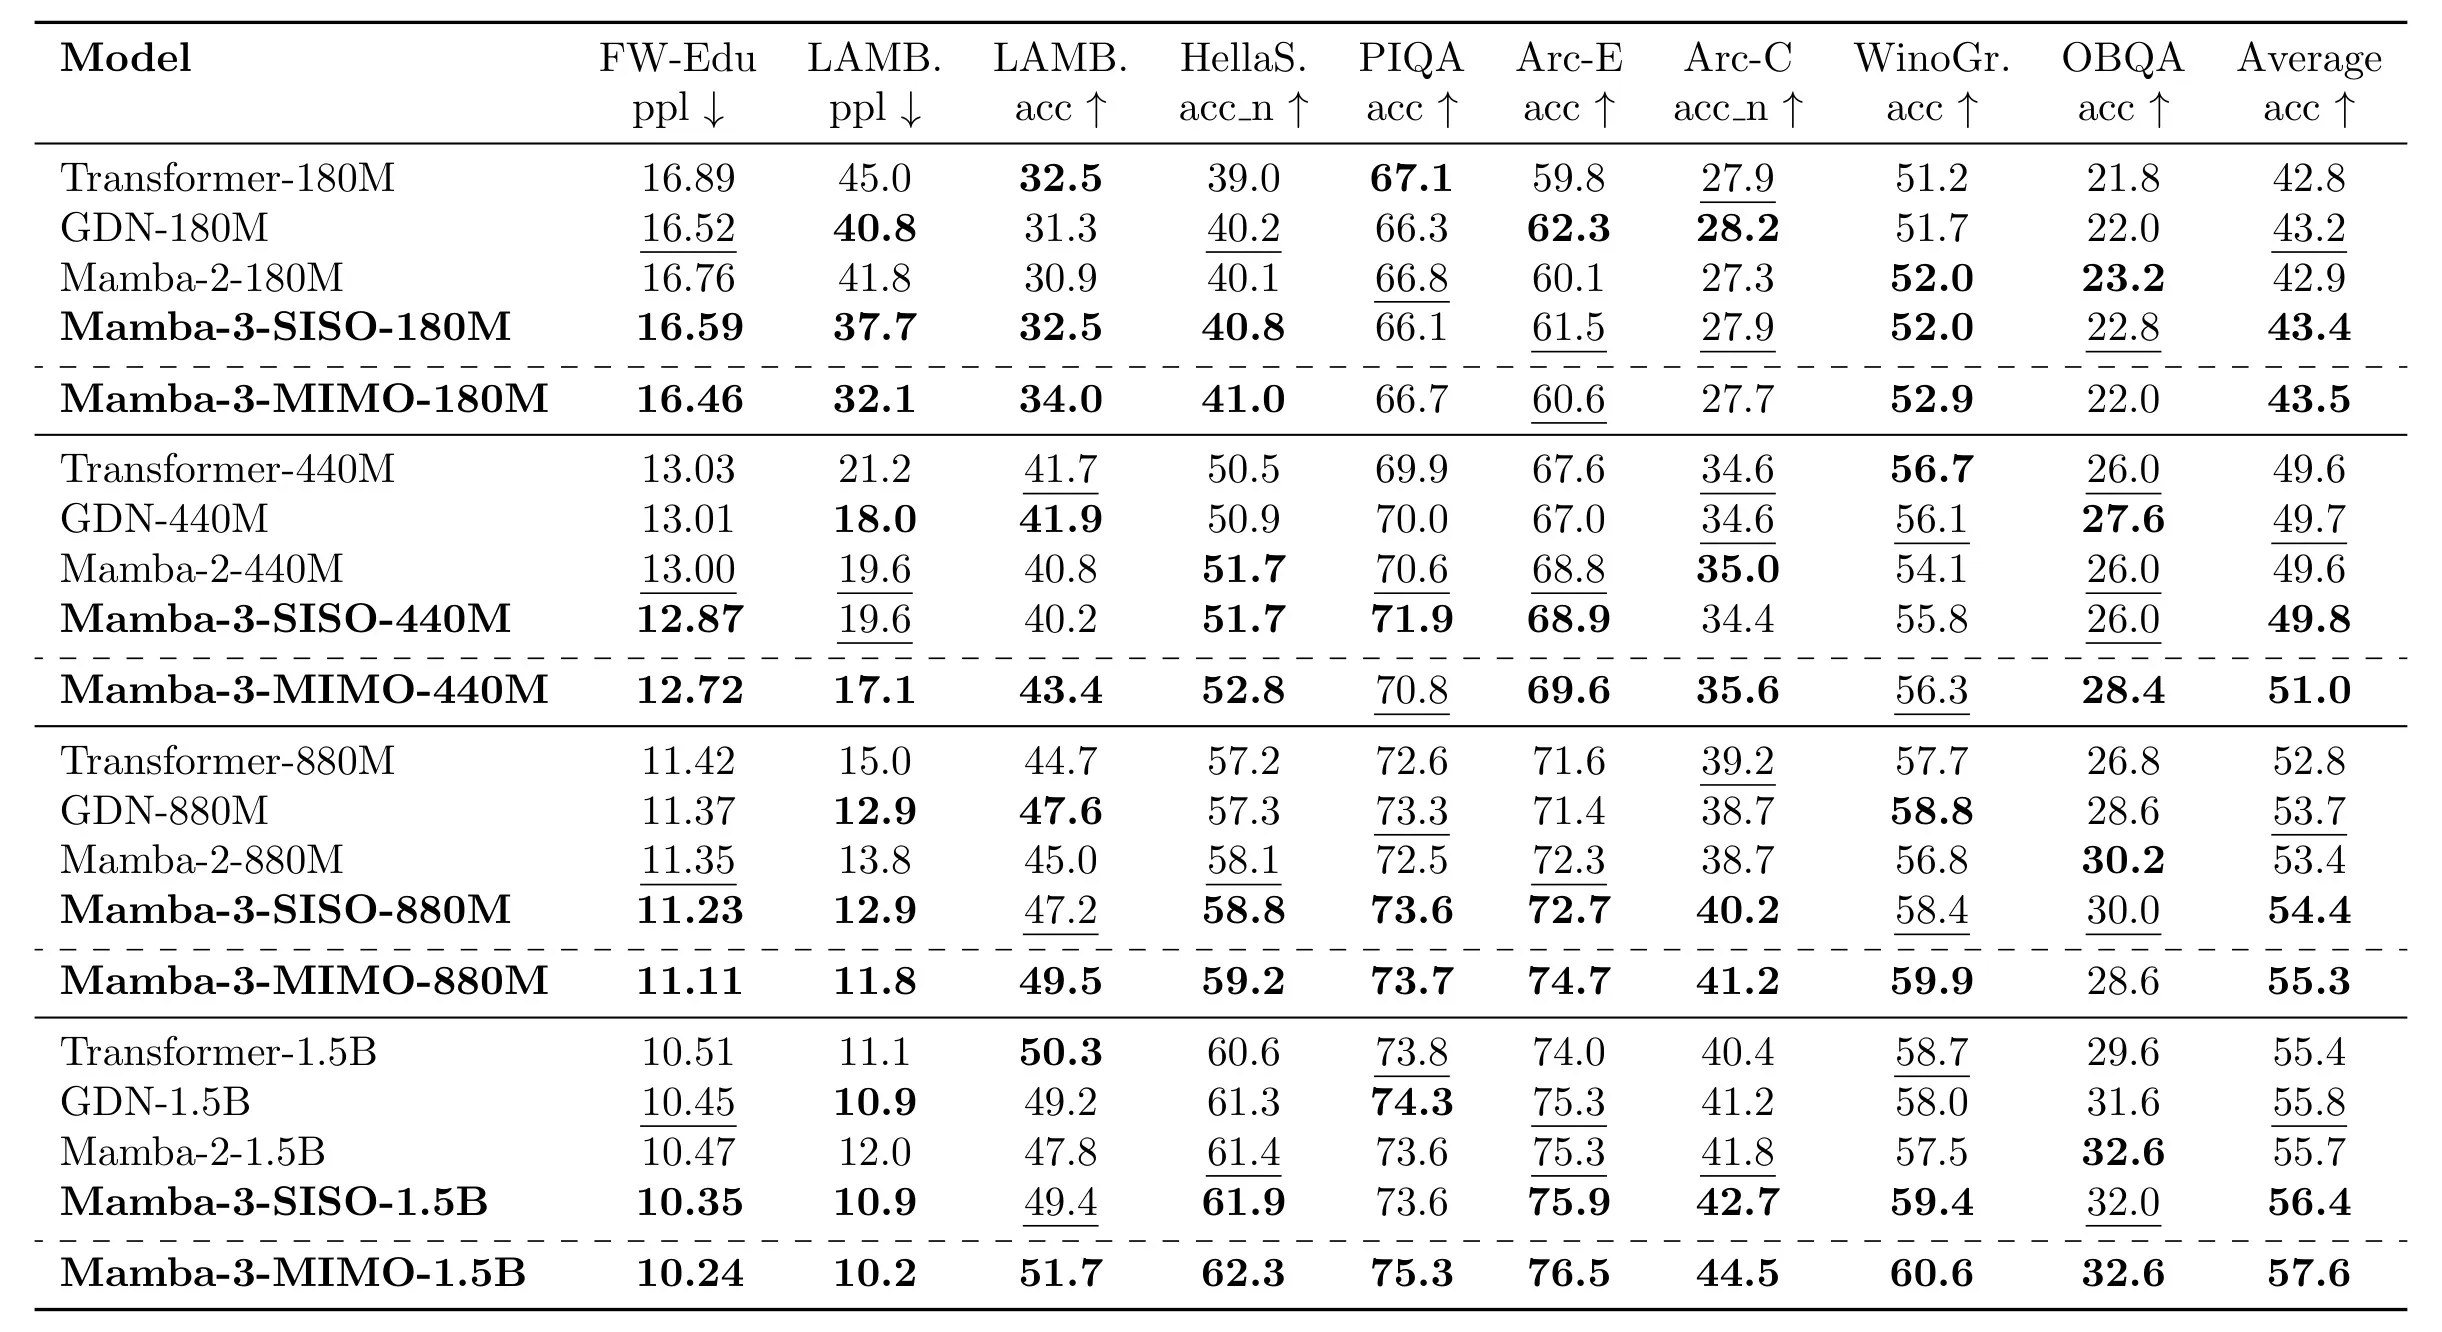
Mamba-3 supera a Mamba-2 y a alternativas potentes de atención lineal, como GDN, en distintas escalas de modelos preentrenados. Mamba-3-SISO es directamente comparable: coincide con Mamba-2 en dimensiones, tamaño del estado y otras formas arquitectónicas, con tiempo de entrenamiento similar. La variante MIMO mejora la exactitud en más de un punto porcentual a escala de 1.000 millones de parámetros respecto a Mamba-3 normal. Necesita entrenar más tiempo, pero no aumenta la latencia de decodificación.
¿Cómo puede aumentar el coste de entrenamiento sin aumentar el de inferencia?
La segunda parte lo explica en detalle. La diferencia se debe a que el entrenamiento está limitado por cómputo y la inferencia por memoria. Los modelos lineales actuales usan intensivamente los Tensor Cores para entrenar rápido, una de las principales aportaciones de Mamba-2. Al decodificar, cada paso calcula tan poco que gran parte del hardware queda ocioso.
Si aumentamos los FLOPs por paso, la latencia de inferencia apenas cambia porque podemos usar esos núcleos libres. En entrenamiento no ocurre lo mismo.
Tareas de recuperación
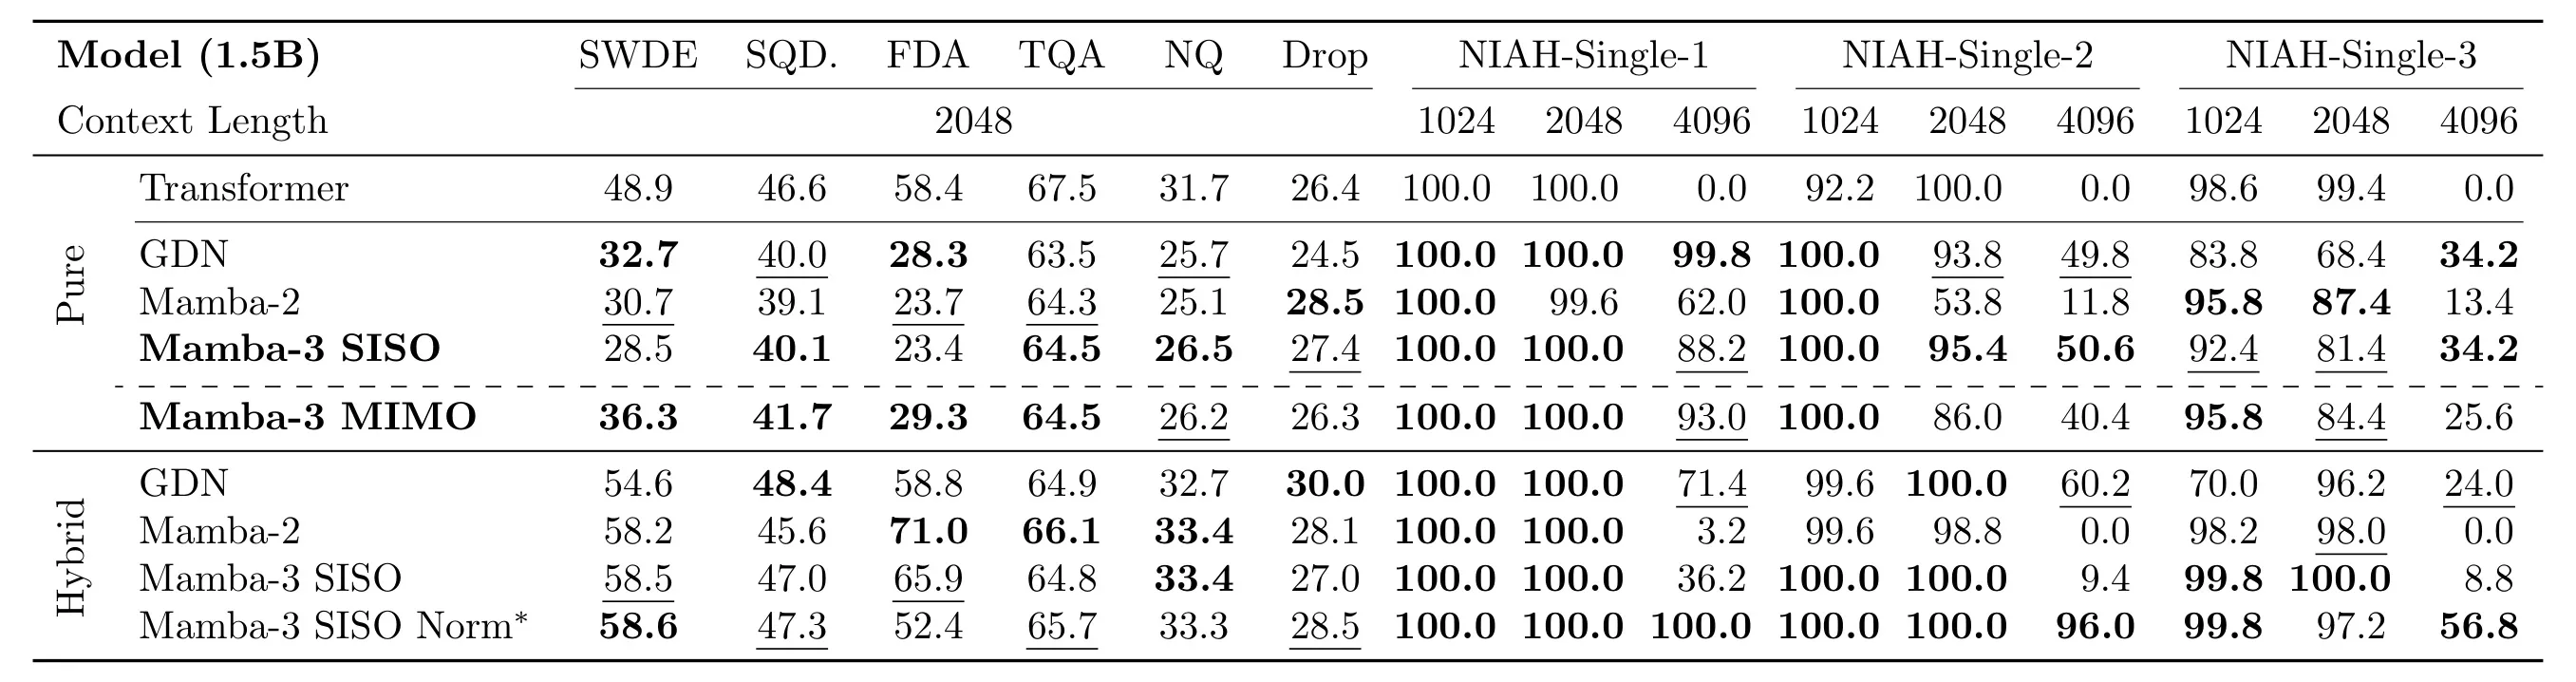
Los modelos lineales, con estado fijo, rinden naturalmente peor que los Transformers en recuperación. Entre modelos puros, el Transformer es superior, pero Mamba-3 funciona bien entre alternativas subcuadráticas. MIMO mejora aún más la recuperación sin aumentar el tamaño del estado.
Dada esta carencia inherente y su buen rendimiento general:
Prevemos que las capas lineales se usarán principalmente junto con capas de autoatención global.*
*Al menos en modelado del lenguaje.
Los modelos híbridos combinan la memoria general de las capas lineales con el almacenamiento exacto, parecido a una base de datos, de la caché KV. Han superado empíricamente a los modelos puros y ahorran memoria y cómputo 10. Aquí también observamos que combinar capas lineales y autoatención mejora la recuperación frente a un Transformer estándar.
Sin embargo, todavía no comprendemos por completo cómo interactúan. Por ejemplo, la proyección opcional previa a la salida de Mamba-3 mejora la generalización de longitud en NIAH sintético a costa de una pequeña pérdida en recuperación real en contexto. Incluso la posición de la normalización, antes o después de la compuerta, y su tipo, agrupada o normal, afectan a tareas de datos semiestructurados y no estructurados como FDA y SWDE.
Kernels por todas partes
Queremos ver lo que se crea con Mamba-3. Para facilitarlo, publicamos nuestros kernels, con una velocidad a la altura de los kernels Triton originales de Mamba-2.
Comparación de latencias
Latencia de prefill
| Modelo | n=512 | 1024 | 2048 | 4096 | 16384 |
|---|---|---|---|---|---|
| vLLM (Llama-3.2-1B) | 0.26 | 0.52 | 1.08 | 2.08 | 12.17 |
| Gated DeltaNet | 0.51 | 1.01 | 2.01 | 4.00 | 16.21 |
| Mamba-2 | 0.51 | 1.02 | 2.02 | 4.02 | 16.22 |
| Mamba-3 (SISO) | 0.51 | 1.01 | 2.02 | 4.01 | 16.22 |
| Mamba-3 (MIMO R=4) | 0.60 | 1.21 | 2.42 | 4.76 | 19.44 |
Latencia de prefill y decodificación
| Modelo | n=512 | 1024 | 2048 | 4096 | 16384 |
|---|---|---|---|---|---|
| vLLM (Llama-3.2-1B) | 4.45 | 9.60 | 20.37 | 58.64 | 976.50 |
| Gated DeltaNet | 4.56 | 9.11 | 18.22 | 36.41 | 145.87 |
| Mamba-2 | 4.66 | 9.32 | 18.62 | 37.22 | 149.02 |
| Mamba-3 (SISO) | 4.39 | 8.78 | 17.57 | 35.11 | 140.61 |
| Mamba-3 (MIMO R=4) | 4.74 | 9.48 | 18.96 | 37.85 | 151.81 |
A escala de 1.500 millones de parámetros, Mamba-3 SISO obtiene la menor latencia conjunta en todas las longitudes de secuencia, por delante de Mamba-2, Gated DeltaNet y el Transformer con vLLM optimizado. Mamba-3 MIMO tiene velocidad comparable a Mamba-2 y un rendimiento mucho mejor.
El prefill Triton de SISO mantiene casi el mismo rendimiento que Mamba-2. La nueva discretización y RoPE dependiente de los datos no añaden sobrecarga. MIMO solo introduce una ralentización moderada de prefill gracias a TileLang. La buena decodificación de ambas variantes se debe en parte a CuTe DSL, cuya implementación facilitó la sencillez de Mamba-3.
Decisiones de diseño
Dedicamos mucho tiempo a acelerar los kernels sin complicar su uso. Elegimos Triton, TileLang y CuTe DSL.
Triton fue una elección sencilla. Es habitual en desarrollo de arquitecturas; el repositorio flash linear attention está íntegramente en PyTorch y Triton. Permite controlar la división en bloques y la fusión de kernels para superar a PyTorch estándar sin depender de una plataforma. También admite inyección PTX y Tensor Memory Accelerator en GPU Hopper para transferencias masivas asíncronas de memoria global a compartida.
Para prefill MIMO usamos TileLang. Las proyecciones adicionales permiten reducir operaciones de memoria mediante control de la jerarquía de la GPU. Triton no ofrecía el detalle de control que necesitábamos. TileLang permite declarar y controlar bloques de memoria compartida y fragmentos de registros para reutilizar memoria, manteniendo suficiente abstracción para desarrollar rápido.
Para los kernels de decodificación elegimos CuTe DSL. Su interfaz Python genera kernels de bajo nivel con abstracciones de CUTLASS. Ofrece control casi al nivel de CUDA para adaptarse al hardware, en este caso Hopper. Con control de disposición de tensores y especialización de warps, creamos un kernel que aprovecha las capacidades de la GPU.
Estas implementaciones a distintos niveles de abstracción son posibles por el diseño algorítmico de las incorporaciones sencillas y ligeras de Mamba-3. La publicación completa detalla la estructura de fusión y los lenguajes de kernels.
Próximos pasos
Has llegado al final de la primera parte. Quedan detalles de kernels, resultados y ablaciones que no cabían aquí. Están en nuestro artículo, y los kernels son abiertos en mamba-ssm.
La segunda y última parte profundiza en las tres mejoras principales, sus fundamentos SSM y las direcciones que más nos interesan.
Notas
Notas al pie
-
o “BCNorm” en terminología SSM ↩
-
Mamba: Linear-Time Sequence Modeling with Selective State Spaces. [PDF] Gu, A. and Dao, T., 2024. ↩
-
Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality. [PDF] Dao, T. and Gu, A., 2024. ↩
-
Gated Delta Networks: Improving Mamba2 with Delta Rule [PDF] ↩
-
Learning to (Learn at Test Time): RNNs with Expressive Hidden States [PDF] ↩
-
Hungry Hungry Hippos: Towards Language Modeling with State Space Models [PDF] ↩
-
In-context Learning and Induction Heads ↩
-
Test-time regression: a unifying framework for designing sequence models with associative memory [PDF] ↩