この記事は、CartesiaのChief Scientist Albert Guが率いるGoomba Labからの転載です。
2024年半ばのMamba-2公開以降、多くのアーキテクチャはMamba-1から移行しました。Mamba-2は、状態空間モデル、SSMの最大のボトルネックを学習効率と捉え、基礎となるSSMの仕組みを単純化しました。その結果、前世代より2〜8倍高速な学習を実現し、採用が広がりました。
その後、LLMの状況は変わり始めました。事前学習は引き続き重要ですが、注目は事後学習と導入にも移っています。どちらも推論の比重が非常に大きい処理です。特に、コードや数学の検証可能な報酬による強化学習、RLVRを拡大するには、大量のロールアウトの生成が必要です。最近ではCodex、Claude Code、OpenClawなどのエージェントの処理が、推論の需要を急増させています。
推論の重要性が高まる一方、Mamba-2を含む多くの線形アーキテクチャは、学習を最優先に開発されました。事前学習を速くするため、SSMは段階的に単純化されました。たとえば対角遷移は、単位行列にスカラーを掛ける形に縮小されました。学習は速くなりましたが、推論の各ステップは単純すぎるものとなり、メモリ帯域に制約されます。GPUは計算よりもデータ移動に時間を使うのです。
推論の時代には、品質と効率の両立をさらに進めたいと考えています。よいモデルを速く動かしたいのです。
そこで次の問いが生まれます。
推論を念頭に設計したSSMは、どのようなものになるでしょうか。
Mamba-3モデル
何が足りないのでしょうか。 線形モデルの魅力は名前のとおりです。固定サイズの状態を使うので、計算量は系列長に対して線形に増えます。しかし、ただで得られるものはありません。効率的な計算を可能にする固定の状態サイズは、過去のすべての情報を一つの表現に圧縮することを強制します。状態であるKVキャッシュを増やし続け、過去の情報をすべて保存するTransformerとは根本的に異なります。状態を増やせないなら、同じ状態にどうすればもっと仕事をさせられるでしょうか。
以前の設計では、学習を速くするため再帰処理と遷移行列を単純化しました。しかし動的な振る舞いの豊かさも減り、デコードはメモリ帯域に制約されました。各トークンの更新は、メモリ移動に対して計算が少なすぎます。ここから三つの改善策が見えます。再帰そのものの表現力を高めること、遷移行列を豊かにすること、各更新に並列でほぼ費用なく実行できる仕事を増やすことです。
この考えから、Mamba-2を三つの点で改良しました。
- 指数台形離散化法から導く、より一般的な再帰式でSSMの表現力を高める。
- 複素数値のSSMシステムをモデル化し、状態追跡の能力を広げる。
- 現在の単入力単出力、SISOに代わり、複数のSSMを並列に扱う多入力多出力、MIMOのSSMで、デコードのレイテンシをほとんど増やさず全般的な性能を高める。
これにより、Mamba-3は同程度の推論レイテンシを保ちながら、性能の限界を押し広げます。
三つの変更はいずれも、より古典的な制御理論と状態空間モデルの研究に着想を得ています。
線形注意やテスト時学習など、これらの概念を容易には捉えられない再帰の別の解釈を用いる、最近の多くの線形アーキテクチャとは異なる方向です。
アーキテクチャ
Mamba-2の層から何が変わったのでしょうか。SSMの中核に対する三つの改良に加え、現代の一般的な言語モデルに近づけるため、全体の構成も見直しました。
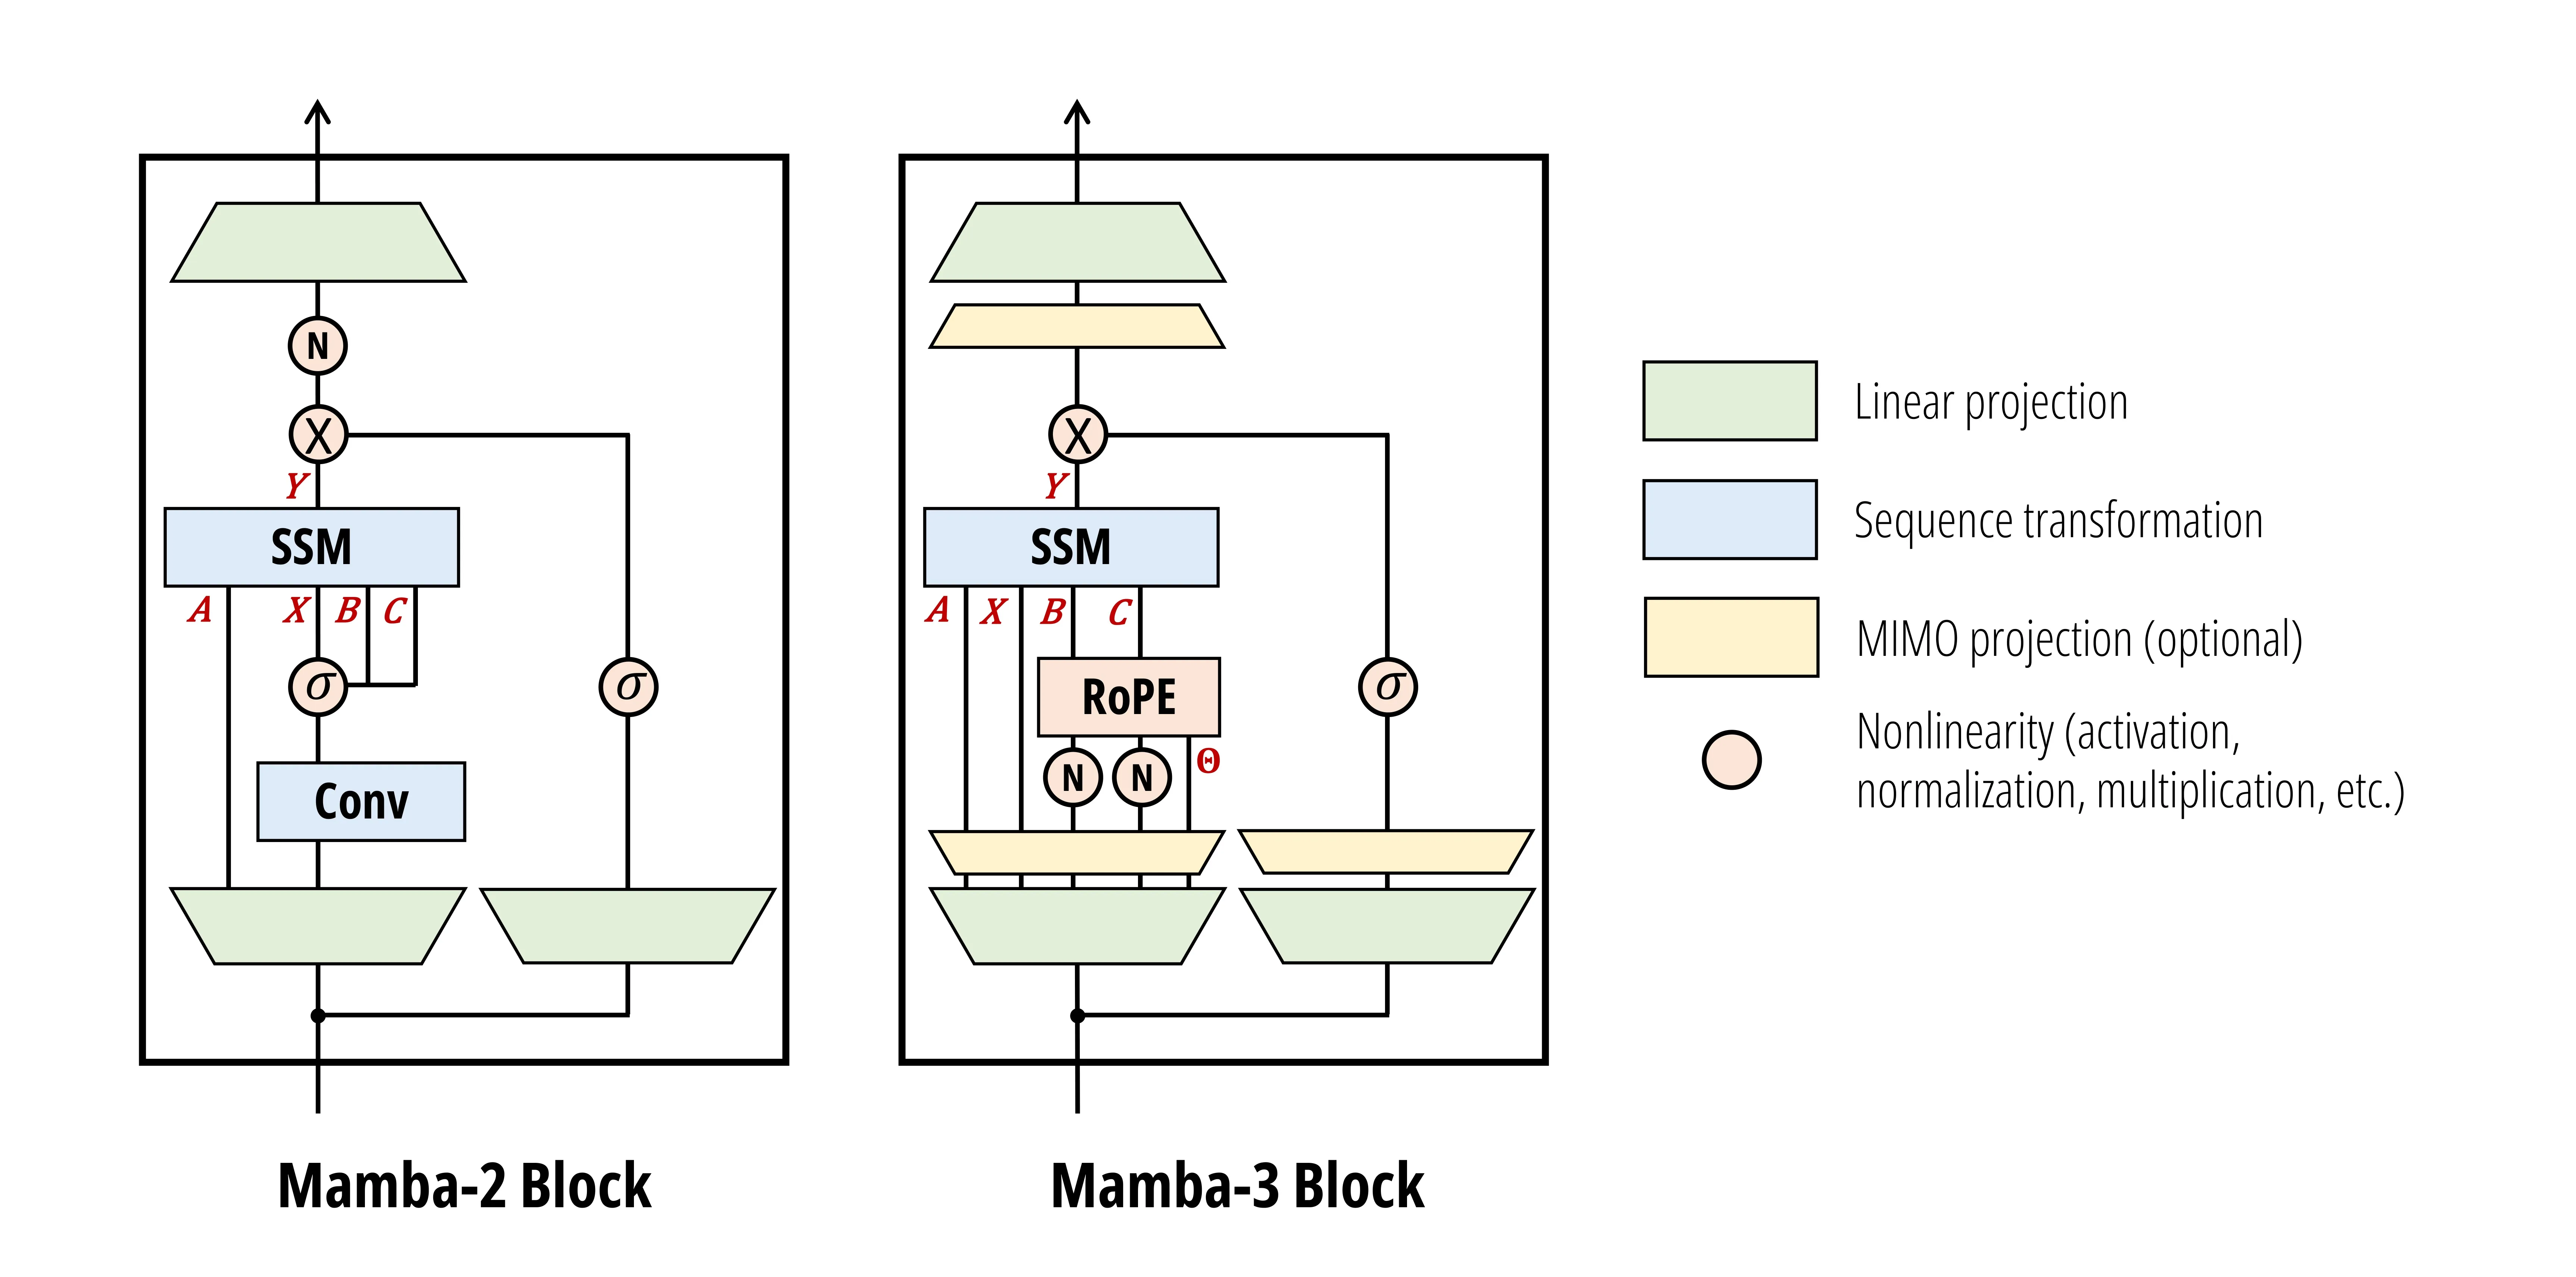
主な変更点は次のとおりです。
正規化。QKNorm 1 1を追加し、Mamba-3の学習が安定することを実験で確認しました。これによって現代のTransformerやGated DeltaNet、GDNに近い構成になります。QKNormがあればMamba-2のRMSNormは任意になります。ただしハイブリッドモデルでは、長さの外挿に役立つため、残す価値があることもわかりました。後ほど触れます。
短い畳み込みを除く。BCNormの後のBとCへの単純なバイアスと、離散化に基づく新しい再帰式を組み合わせ、Mamba-1/2にあった短い因果畳み込みを取り除けました。新しい再帰式は、隠れ状態への入力に暗黙的な畳み込みを適用します。仕組みはブログの第2部で説明します。
本当に短い畳み込みを取り除けるのでしょうか
Mamba-3の変更は、SSMの再帰の内部に畳み込みに似た要素を加えますが、再帰の外側に置く標準的な短い畳み込みと完全に交換できるわけではありません。
標準の短い畳み込みをMamba-3と併用することもできます。採用しない判断は実験に基づいています。調べた結果は次のとおりです。
- 標準の短い畳み込みを戻しても性能は改善せず、むしろわずかに悪化します。
- 短い畳み込みを除いても、NIAHなど、より現実的なタスクの検索能力は低下しません。ただしMQARのような小規模な合成タスクでは学習がやや難しくなります。実世界の検索動作には影響しないため、大きな制限とは考えていません。
理論的な仕組みは調査していませんが、論文では、BCのバイアスと指数台形の再帰がともに畳み込みに似た処理を行い、実験上、外部の短い畳み込みと同じ役割を果たすのではないかと考察しています。
短い畳み込みの歴史
RoPEとMIMOの射影も新しい要素です。RoPEは複素数の遷移を回転として解釈し、カーネルの高価な再実装をせずに複素数値のSSMを表現します。MIMOの射影は、BとCの行列をMIMO SSMに必要な表現へ拡張します。
この二つの動機と実装は第2部で詳しく扱います。ここでは、それぞれがモデルの性能や能力を高める独立した基本的な改善と捉えてください。
全体のアーキテクチャも、Transformerや他の線形モデルの標準に従い、MLP層を交互に挟む構成になりました。
実験結果
最終的なMamba-3を、他の一般的な線形モデルとTransformerのベースラインと比較します。
言語モデリング
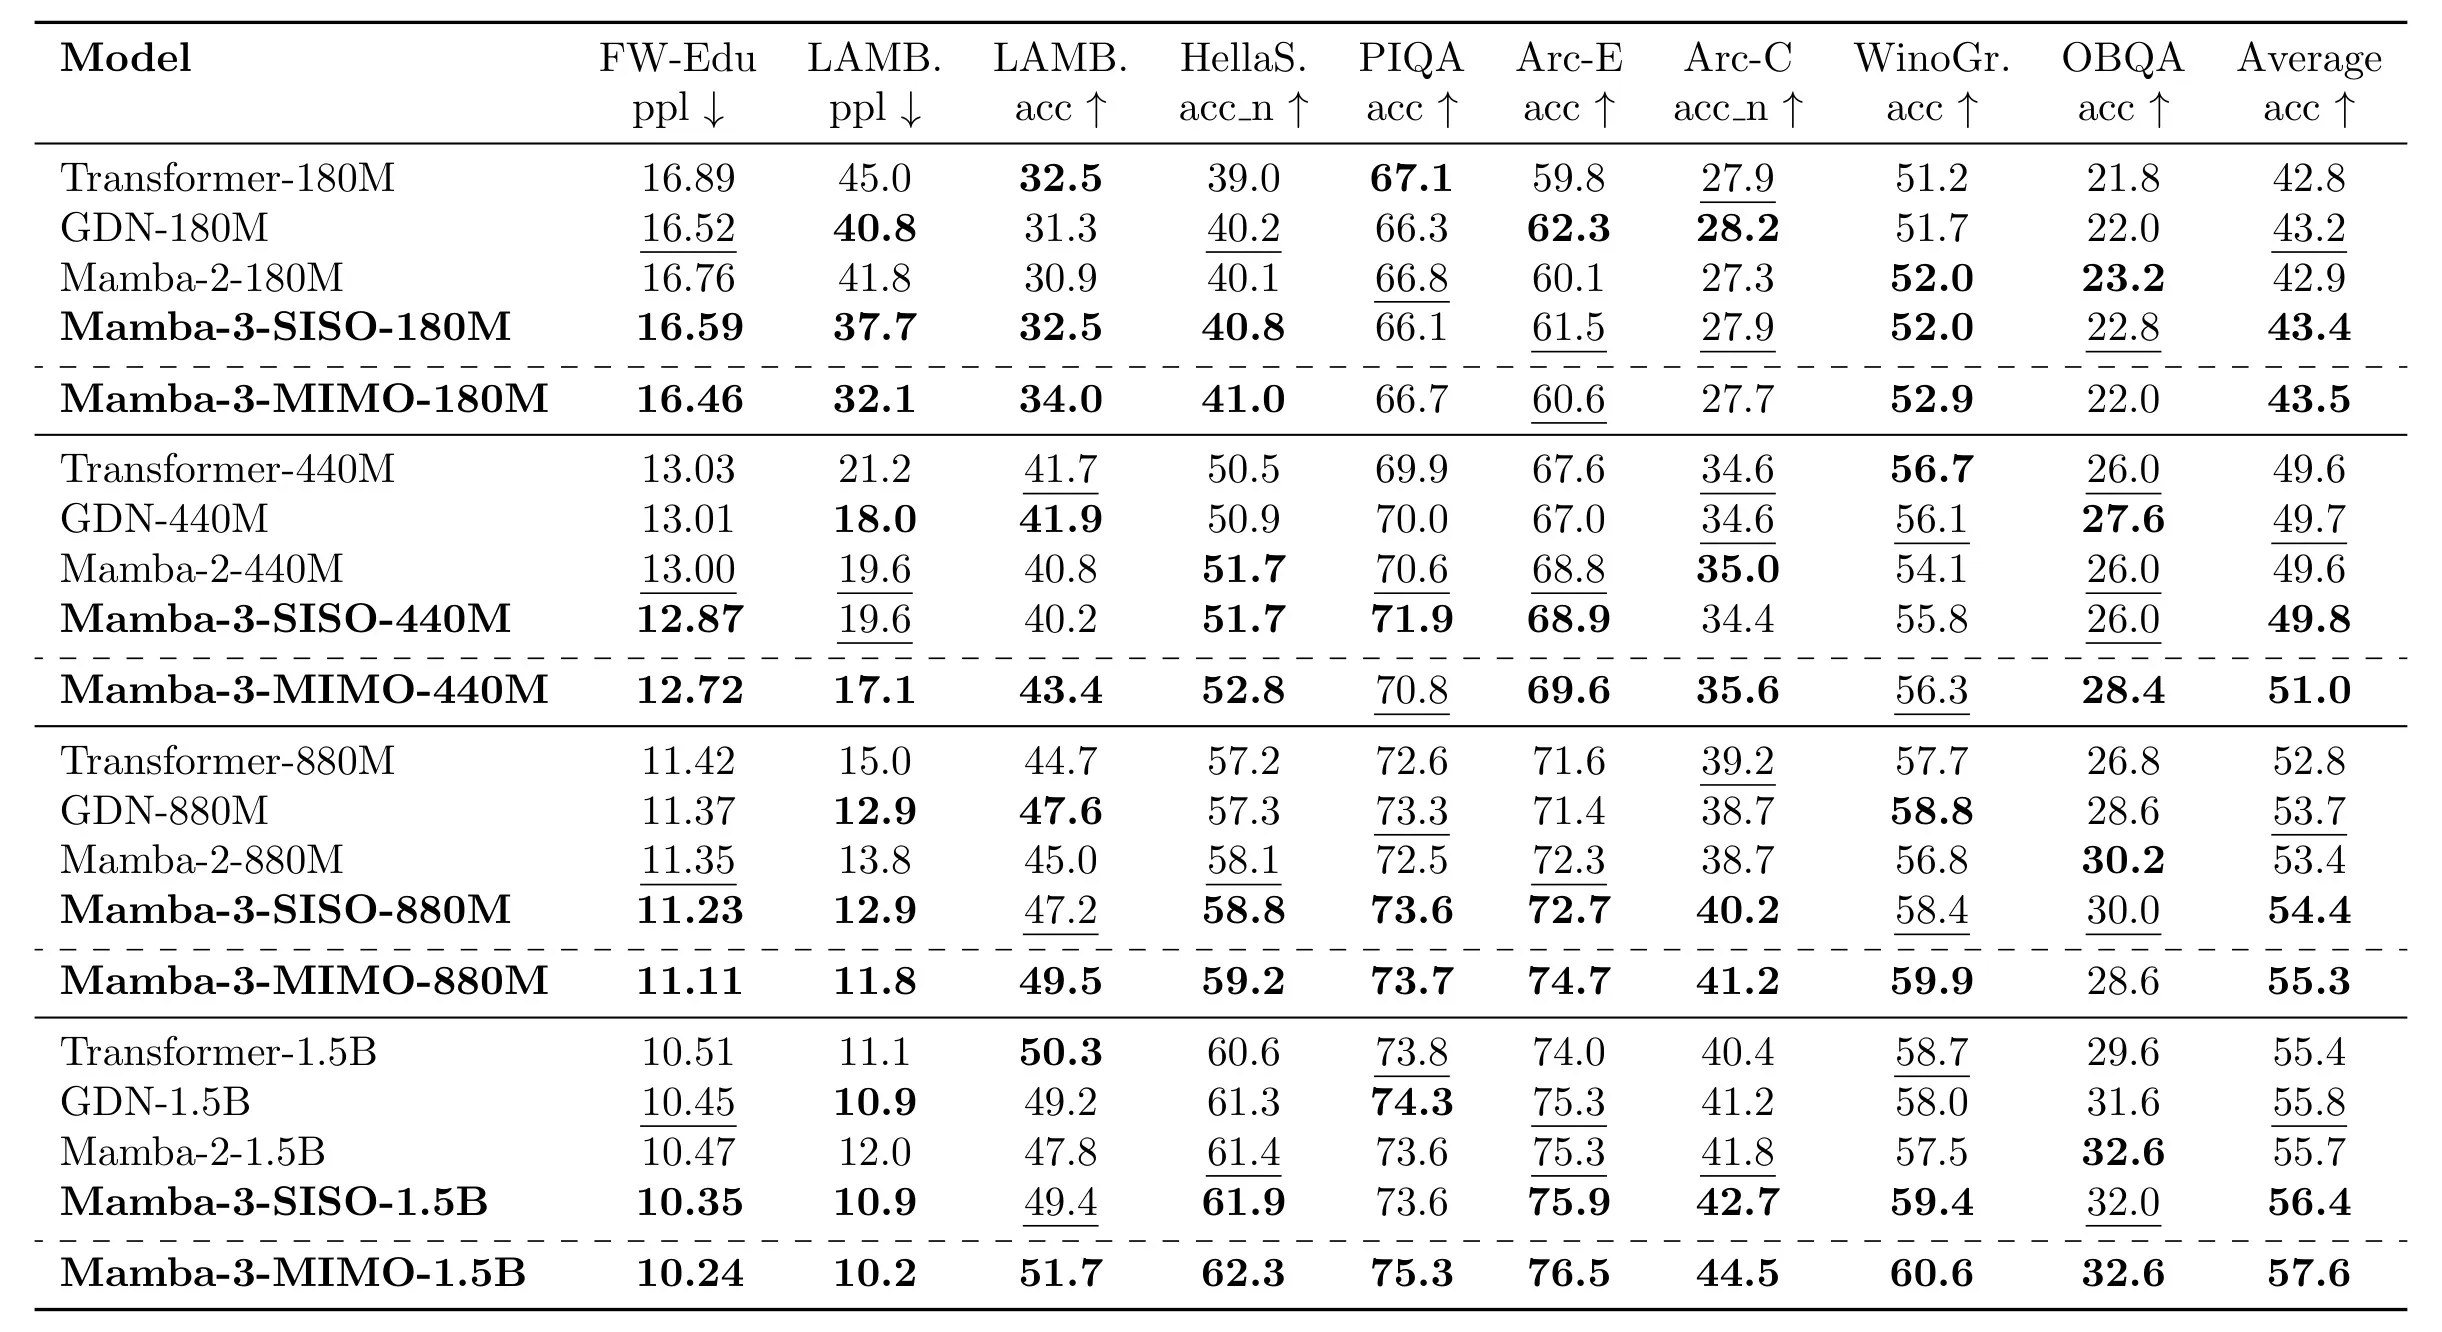
さまざまな規模の事前学習済みモデルで、Mamba-3は従来のMamba-2やGDNなどの有力な線形注意を上回ります。Mamba-3-SISOは従来モデルと直接比較でき、たとえばモデルの次元や状態サイズなどの形状はMamba-2と完全に同じで、学習時間も同程度です。MIMO版は1B規模で、通常のMamba-3より下流タスクの正解率をさらに1ポイント以上高めます。学習時間は長くなりますが、デコードのレイテンシは増えません。
学習費用は増えても、推論は増えないのはなぜでしょうか
詳細は第2部で説明しますが、概要を紹介します。
学習は計算能力、推論はメモリ帯域に制約されるという違いが原因です。現在の線形モデルは、Mamba-2の主要な成果の一つでもあるように、GPUのTensor Coreを多く使って高速に学習するよう設計されています。しかしデコード時は各ステップの計算量が少なく、ハードウェアは多くの時間を遊ばせています。
各ステップのFLOPsを増やす設計なら、推論では空いているコアを使えるため、レイテンシはほぼ変わりません。学習ではそうはいきません。
検索タスク
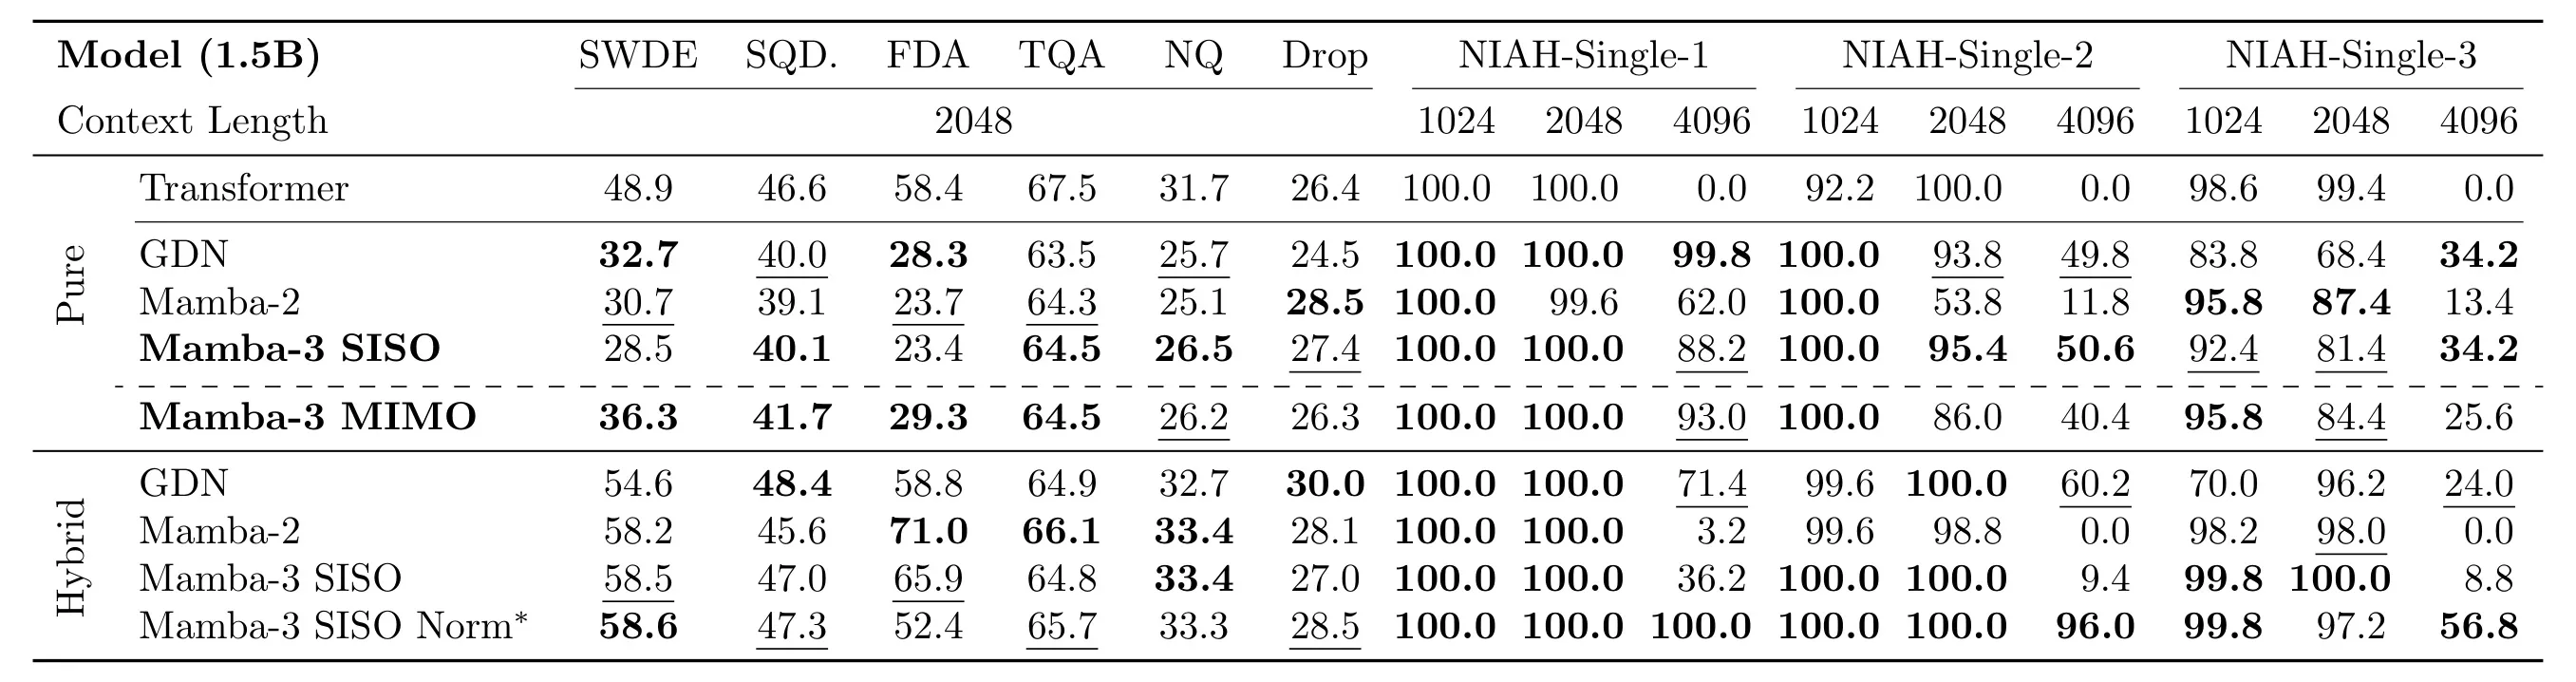
固定サイズの状態を持つ線形モデルは、検索型タスクではTransformerより本質的に不利です。予想どおり、単一の方式だけのモデルではTransformerが優れていますが、Mamba-3は準二次の代替方式の中でよい性能を示します。MIMOを加えると、状態サイズを増やさずに検索性能がさらに向上します。
この本質的な弱点と、全般的なモデリング能力の高さを考えると、
将来の線形層は、主に大域的な自己注意層と組み合わせて使われると予想します。*
*少なくとも言語モデリングでは
線形層の全般的な記憶に近い性質と、自己注意のKVキャッシュの正確なデータベースに近い保存を組み合わせるハイブリッドモデルは、純粋なモデルを上回り、メモリと計算量を大きく減らすことが実験で示されています10。今回も、線形層と自己注意を組み合わせることで、通常のTransformerより検索が改善しました。
ただし、線形モデルと自己注意がどう相互作用するかは、完全には理解されていません。たとえばMamba-3で任意の出力前射影を使うと、合成NIAHタスクで長さへの汎化は改善する一方、実世界の文脈内検索がわずかに低下します。正規化の位置がゲートの前か後か、種類がグループ型か通常型かといった細部でも、FDAやSWDEなど、半構造化データと非構造化データのタスクの正解率に無視できない影響があります。
さまざまなカーネル
Mamba-3でどんなものがつくられるか楽しみにしています。開発を支えるため、元のMamba-2のTritonカーネルと同程度の速度を持つカーネルをオープンソースで公開します。
レイテンシの測定
prefillのレイテンシ
| モデル | n=512 | 1024 | 2048 | 4096 | 16384 |
|---|---|---|---|---|---|
| vLLM (Llama-3.2-1B) | 0.26 | 0.52 | 1.08 | 2.08 | 12.17 |
| Gated DeltaNet | 0.51 | 1.01 | 2.01 | 4.00 | 16.21 |
| Mamba-2 | 0.51 | 1.02 | 2.02 | 4.02 | 16.22 |
| Mamba-3 (SISO) | 0.51 | 1.01 | 2.02 | 4.01 | 16.22 |
| Mamba-3 (MIMO R=4) | 0.60 | 1.21 | 2.42 | 4.76 | 19.44 |
prefillとdecodeを合わせたレイテンシ
| モデル | n=512 | 1024 | 2048 | 4096 | 16384 |
|---|---|---|---|---|---|
| vLLM (Llama-3.2-1B) | 4.45 | 9.60 | 20.37 | 58.64 | 976.50 |
| Gated DeltaNet | 4.56 | 9.11 | 18.22 | 36.41 | 145.87 |
| Mamba-2 | 4.66 | 9.32 | 18.62 | 37.22 | 149.02 |
| Mamba-3 (SISO) | 4.39 | 8.78 | 17.57 | 35.11 | 140.61 |
| Mamba-3 (MIMO R=4) | 4.74 | 9.48 | 18.96 | 37.85 | 151.81 |
1.5B規模の比較では、Mamba-3のSISO版がすべての系列長でprefillとdecodeの合計レイテンシが最短となり、Mamba-2、Gated DeltaNet、さらに高度に最適化されたvLLMを使うTransformerも上回りました。Mamba-3 MIMOも、Mamba-2と同程度の速度で、はるかに高い性能を示します。
Mamba-3 SISOのTritonベースのprefillは、Mamba-2とほぼ同じ性能を保ちます。新しい離散化とデータ依存のRoPE埋め込みは、追加の負担を生んでいません。Mamba-3 MIMOのprefillも、効率的なTileLang実装により、速度の低下は小さく収まります。両方式の優れたdecode性能の一部はCuTe DSLによるもので、Mamba-3の構成要素の単純さによって実装が大幅に容易になりました。
設計上の選択
使いやすさを損なわず、カーネルを最速にする方法を時間をかけて検討し、Triton、TileLang、CuTe DSLを採用しました。
Tritonは選びやすい選択でした。優れたflash linear attentionリポジトリもPyTorchとTritonだけで実装されているように、アーキテクチャ開発のほぼ標準です。プラットフォームに依存しない言語でありながら、タイル分割とカーネル融合を制御して、標準のPyTorchより高い性能を出せます。GPU向けアセンブリー言語PTXの埋め込みや、Hopper GPUのTensor Memory Acceleratorでグローバルから共有メモリへ大きなデータを非同期転送する機能もあります。
MIMOのprefillにはTileLangを使いました。追加の射影では、GPUのメモリ階層を戦略的に操作してI/Oを減らせます。しかしTritonでは必要な粒度でメモリを制御できなかったため、共有メモリのタイルを明示的に宣言、制御し、レジスターフラグメントを作れるTileLangを選びました。メモリを効率よく再利用しながら、短期間で開発できる十分に高水準な言語です。
推論とdecodeを重視するため、decodeカーネルにはCuTe DSLを選びました。PythonからCUTLASSの高水準の抽象化を使い、低水準のカーネルを生成できます。実質的にCUDA並みの制御が可能で、今回のHopper GPUの仕様に合わせて高性能なカーネルを開発できます。テンソルの配置とwarp specializationを細かく制御し、GPUの機能を活用しました。
異なる抽象度でのGPU実装を可能にしているのは、Mamba-3の単純で軽量な追加要素と、その具体化というアルゴリズムの設計です。正確な融合の構造やカーネルDSLなどの詳細は、完全版でさらに説明します。
次回
第1部をお読みいただき、ありがとうございます。カーネル、実験結果、アブレーションなど、ここで紹介しきれなかった詳細は論文にあります。カーネルはmamba-ssmで公開しています。
次の第2部、最終回では、Mamba-3の三つの主要な改良とSSMの基礎を掘り下げ、特に関心のある今後の方向性を紹介します。
脚注
脚注
-
SSMの用語では「BCNorm」とも呼びます。 ↩
-
Mamba: Linear-Time Sequence Modeling with Selective State Spaces. [PDF] Gu, A. and Dao, T., 2024. ↩
-
Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality. [PDF] Dao, T. and Gu, A., 2024. ↩
-
Gated Delta Networks: Improving Mamba2 with Delta Rule [PDF] ↩
-
Learning to (Learn at Test Time): RNNs with Expressive Hidden States [PDF] ↩
-
Hungry Hungry Hippos: Towards Language Modeling with State Space Models [PDF] ↩
-
In-context Learning and Induction Heads ↩
-
Test-time regression: a unifying framework for designing sequence models with associative memory [PDF] ↩