Cet article est repris de Goomba Lab, dirigé par Albert Gu, responsable scientifique de Cartesia.
Depuis la sortie de Mamba-2 à la mi-2024, la plupart des architectures ont abandonné Mamba-1. Pourquoi ? Mamba-2 faisait le pari que l’efficacité de l’entraînement était le principal frein des modèles à espace d’états, ou SSM. Il a donc simplifié leur mécanisme pour entraîner deux à huit fois plus vite que son prédécesseur, favorisant une adoption plus large.
Depuis, le monde des LLM évolue. Le préentraînement reste très important, mais l’attention se porte davantage sur le post-entraînement et le déploiement, tous deux très gourmands en inférence. Le développement des méthodes de post-entraînement, notamment l’apprentissage par renforcement avec récompenses vérifiables, ou RLVR, pour le code et les mathématiques, exige de générer énormément de trajectoires. Plus récemment, les processus agentiques comme Codex, Claude Code ou OpenClaw ont fait exploser la demande d’inférence.
Malgré cette importance croissante, de nombreuses architectures linéaires, dont Mamba-2, ont été conçues d’abord pour l’entraînement. Pour accélérer le préentraînement, le SSM a été progressivement simplifié, par exemple en réduisant la transition diagonale à un scalaire multiplié par l’identité. L’entraînement y a gagné en vitesse, mais l’étape d’inférence est devenue trop simple et limitée par la mémoire. Les GPU passent surtout leur temps à déplacer des données plutôt qu’à calculer.
À cette nouvelle époque de l’inférence, nous voulons repousser la frontière entre qualité et efficacité : faire fonctionner les meilleurs modèles plus vite.
Une question se pose naturellement :
À quoi ressemblerait un SSM conçu pour l’inférence ?
Le modèle Mamba-3
Que manque-t-il ? L’intérêt des modèles linéaires est dans leur nom : le calcul augmente linéairement avec la longueur des séquences grâce à un état fixe. Mais ce gain a une contrepartie. La taille d’état fixe impose de compresser toute l’information passée en une représentation, à l’opposé d’un Transformer qui la conserve dans un état croissant, le cache KV. Si l’on ne peut pas agrandir l’état, comment lui faire faire davantage de travail ?
Les conceptions précédentes simplifiaient la récurrence et la matrice de transition pour accélérer l’entraînement. Cela réduisait aussi la richesse de la dynamique et laissait le décodage limité par la mémoire : chaque token exigeait peu de calcul par rapport aux données déplacées. Nous pouvons donc agir de trois façons : rendre la récurrence plus expressive, utiliser une matrice de transition plus riche et ajouter du travail parallèle presque gratuit à chaque mise à jour.
À partir de ces observations, nous améliorons Mamba-2 de trois façons :
- Nous augmentons l’expressivité du mécanisme SSM avec une récurrence plus générale issue de notre schéma de discrétisation exponentiel-trapézoïdal.
- Nous étendons les capacités de suivi d’état en modélisant un système SSM à valeurs complexes.
- Nous améliorons les performances générales avec peu d’effet sur la latence de décodage grâce aux SSM à entrées et sorties multiples, ou MIMO, qui modélisent plusieurs SSM en parallèle au lieu des SSM actuels à entrée et sortie uniques, ou SISO.
Grâce à ces changements, Mamba-3 repousse les performances tout en conservant une latence d’inférence similaire.
Ces trois changements s’inspirent de la littérature plus classique sur la théorie du contrôle et les modèles à espace d’états.
Nos travaux vont à contre-courant de nombreuses architectures linéaires modernes qui utilisent d’autres interprétations de la récurrence, comme l’attention linéaire ou l’entraînement au moment du test, qui représentent difficilement ces concepts.
Architecture
Qu’est-ce qui change dans la couche Mamba-2 ? Outre les trois améliorations du SSM décrites ci-dessus, nous avons remanié l’architecture pour la rapprocher des modèles de langage modernes habituels.
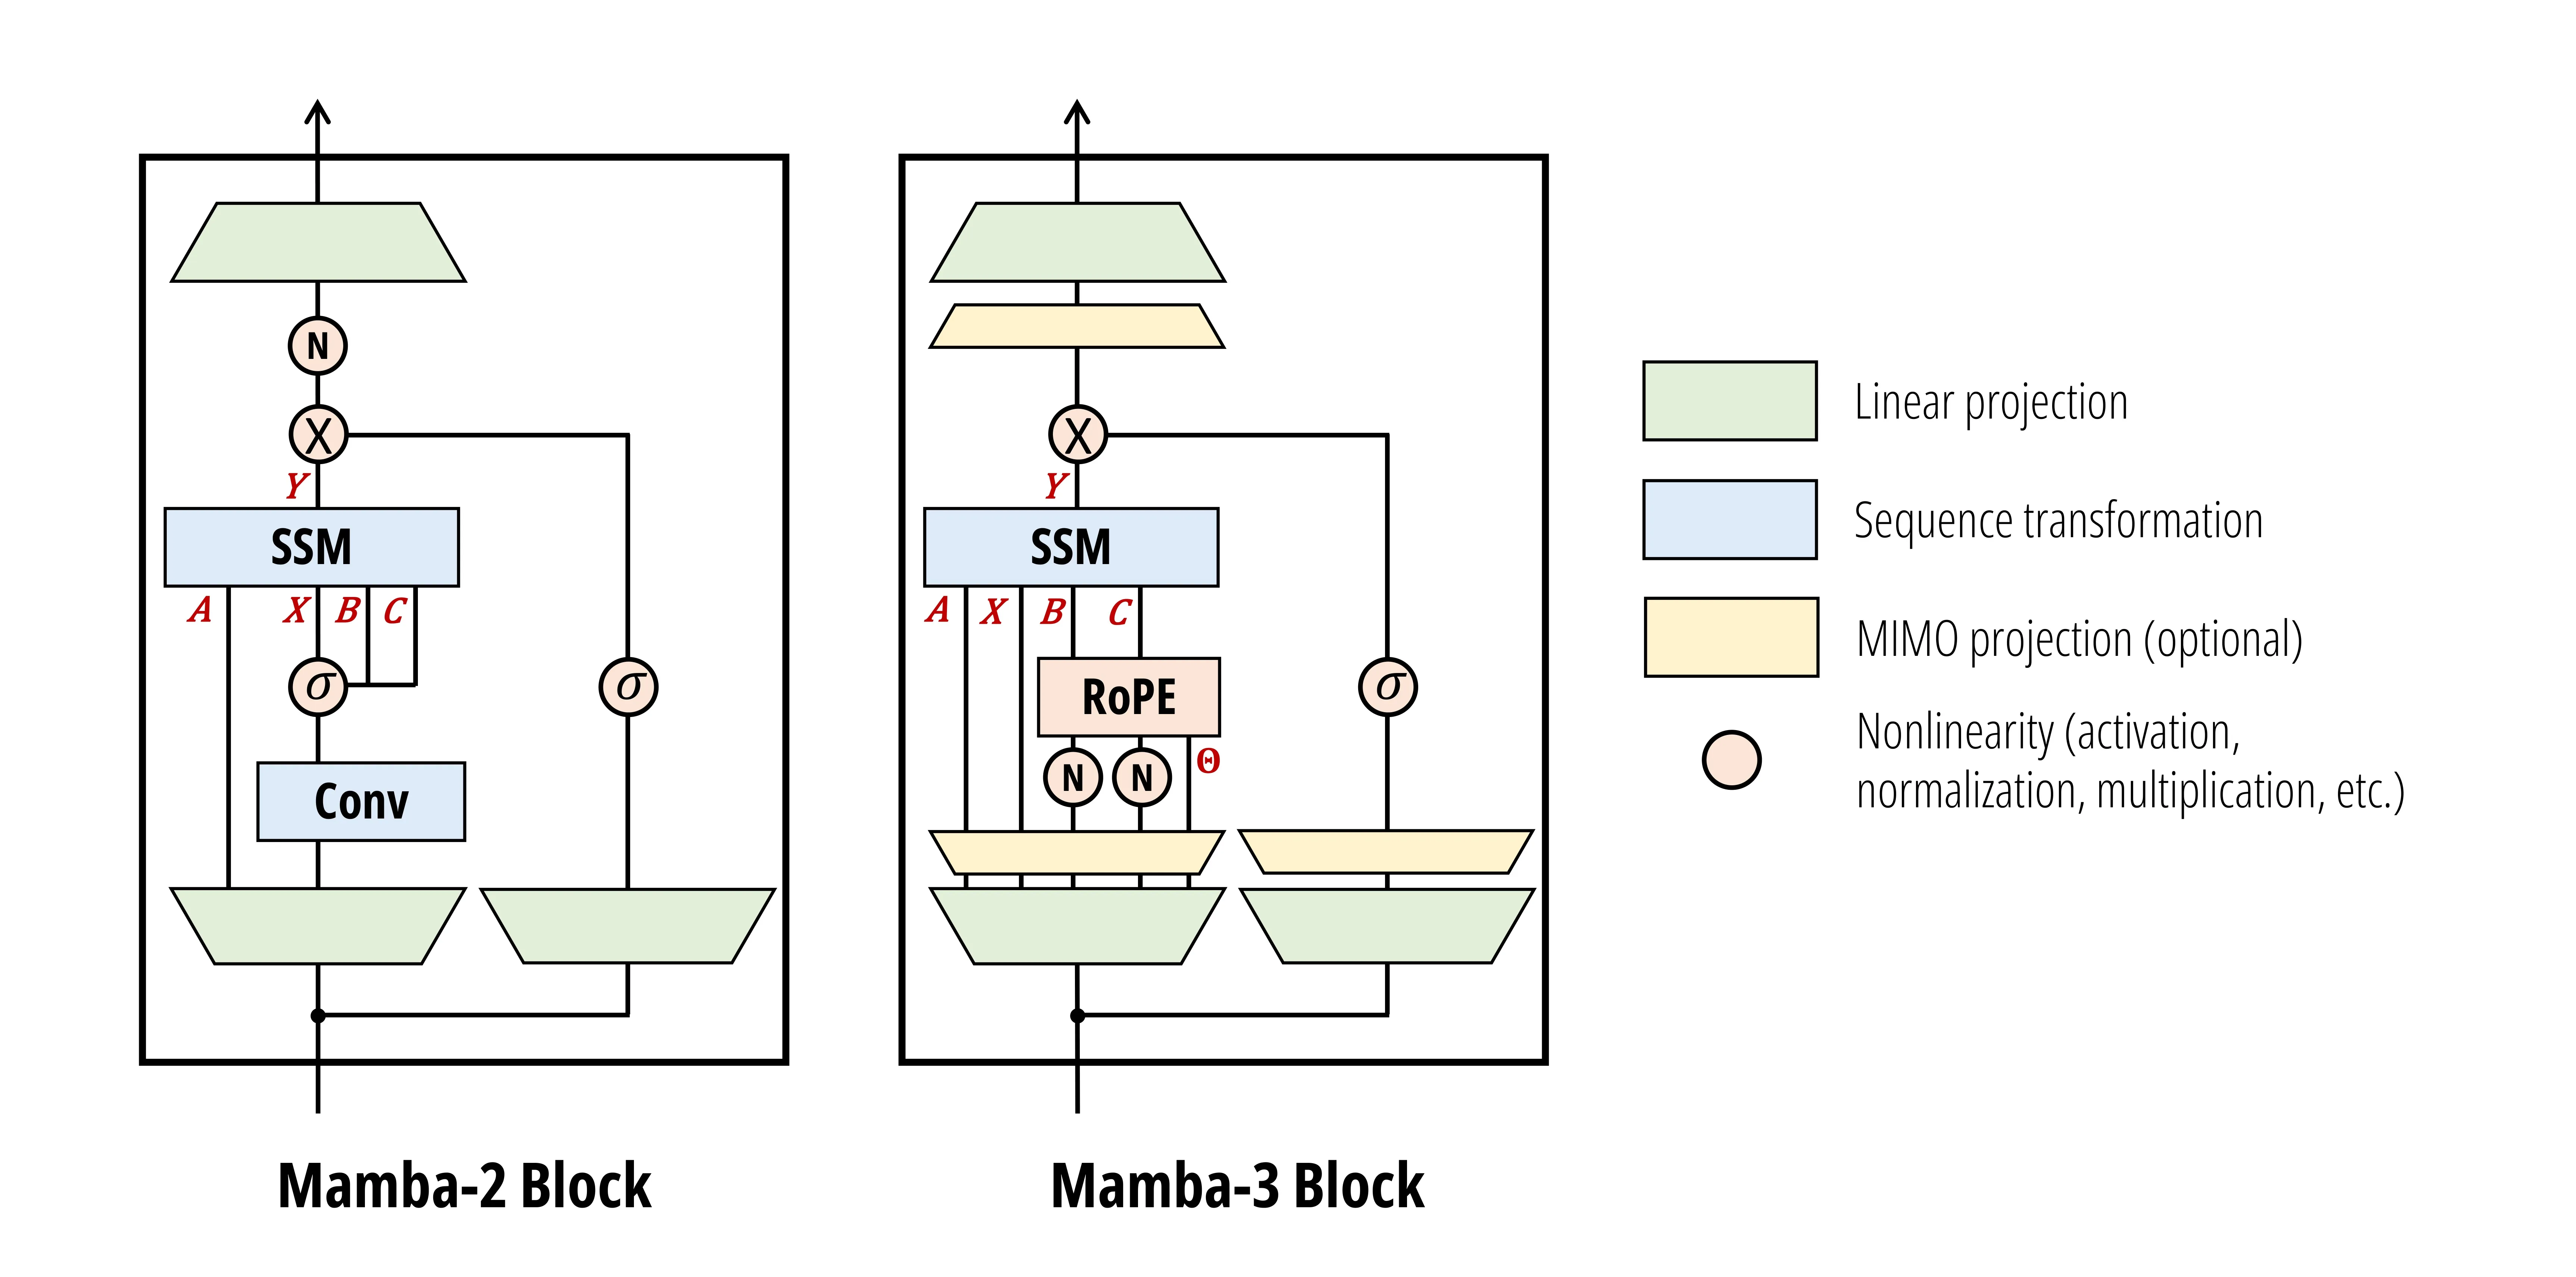
Le schéma montre plusieurs changements. Voici les principaux.
Normalisations. Nous avons ajouté QKNorm 1 1, qui stabilise empiriquement l’entraînement de Mamba-3. Cela le rapproche des Transformers contemporains et de Gated DeltaNet, ou GDN. Avec QKNorm, le RMSNorm de Mamba-2 devient facultatif. Nos expériences montrent néanmoins qu’il peut rester utile dans les modèles hybrides en aidant l’extrapolation en longueur. Nous y reviendrons.
Adieu à la convolution courte. Nous avons supprimé la courte convolution causale de Mamba-1/2 en combinant des biais simples sur B et C après BCNorm avec notre nouvelle récurrence issue de la discrétisation. Cette récurrence applique implicitement une convolution à l’entrée de l’état caché. La deuxième partie explique comment.
Peut-on vraiment supprimer la convolution courte ?
Les changements de Mamba-3 ajoutent des composants de type convolution dans la récurrence SSM, mais ils ne sont pas exactement interchangeables avec la convolution courte standard placée à l’extérieur.
Cette dernière peut encore être utilisée avec Mamba-3, mais notre décision de l’omettre est empirique. Nous observons que son rétablissement :
- n’améliore pas les performances et les dégrade légèrement ;
- ne dégrade pas les capacités de récupération sur des tâches plus réalistes, comme NIAH. Sans convolution courte, l’entraînement sur de petites tâches synthétiques comme MQAR devient toutefois un peu plus difficile. Le comportement de récupération réel restant inchangé, nous ne considérons pas cela comme une limite majeure.
Pourquoi ? Nous n’avons pas étudié les mécanismes théoriques. Dans l’article, nous proposons toutefois que le biais BC et la récurrence exponentielle-trapézoïdale mettent en œuvre des mécanismes de type convolution qui remplissent empiriquement la même fonction que la convolution courte externe.
Bref historique de la convolution courte
La convolution courte est désormais un composant central de la plupart des modèles linéaires performants 2 3 4 5. Ses premières variantes ont été utilisées dans les architectures récurrentes par H3 6, sous forme d’un “shift SSM” inspiré des travaux d’Anthropic sur les têtes d’induction “smeared” 7, et par RWKV-4 8 avec son mécanisme de décalage de tokens. Mamba-1 l’a ensuite popularisée sous sa forme actuelle.
Elle est si répandue parce que les travaux précédents ont montré à plusieurs reprises qu’elle améliore les performances empiriques et soutient théoriquement la récupération par induction 9.
Deux nouveaux composants apparaissent aussi : RoPE et les projections MIMO. RoPE exprime les SSM complexes en interprétant les transitions complexes comme des rotations, évitant une réimplémentation coûteuse des noyaux. Les projections MIMO étendent les matrices B et C à la représentation nécessaire aux SSM MIMO.
La deuxième partie détaille les raisons et l’implémentation de ces deux composants. Pour l’instant, voyez-les comme des améliorations fondamentales indépendantes qui contribuent chacune aux performances ou aux capacités du modèle.
Enfin, notre architecture adopte des couches MLP intercalées, selon la convention des Transformers et d’autres modèles linéaires.
Résultats empiriques
Nous évaluons notre modèle Mamba-3 final face à d’autres architectures linéaires courantes et à un Transformer de référence.
Modélisation du langage
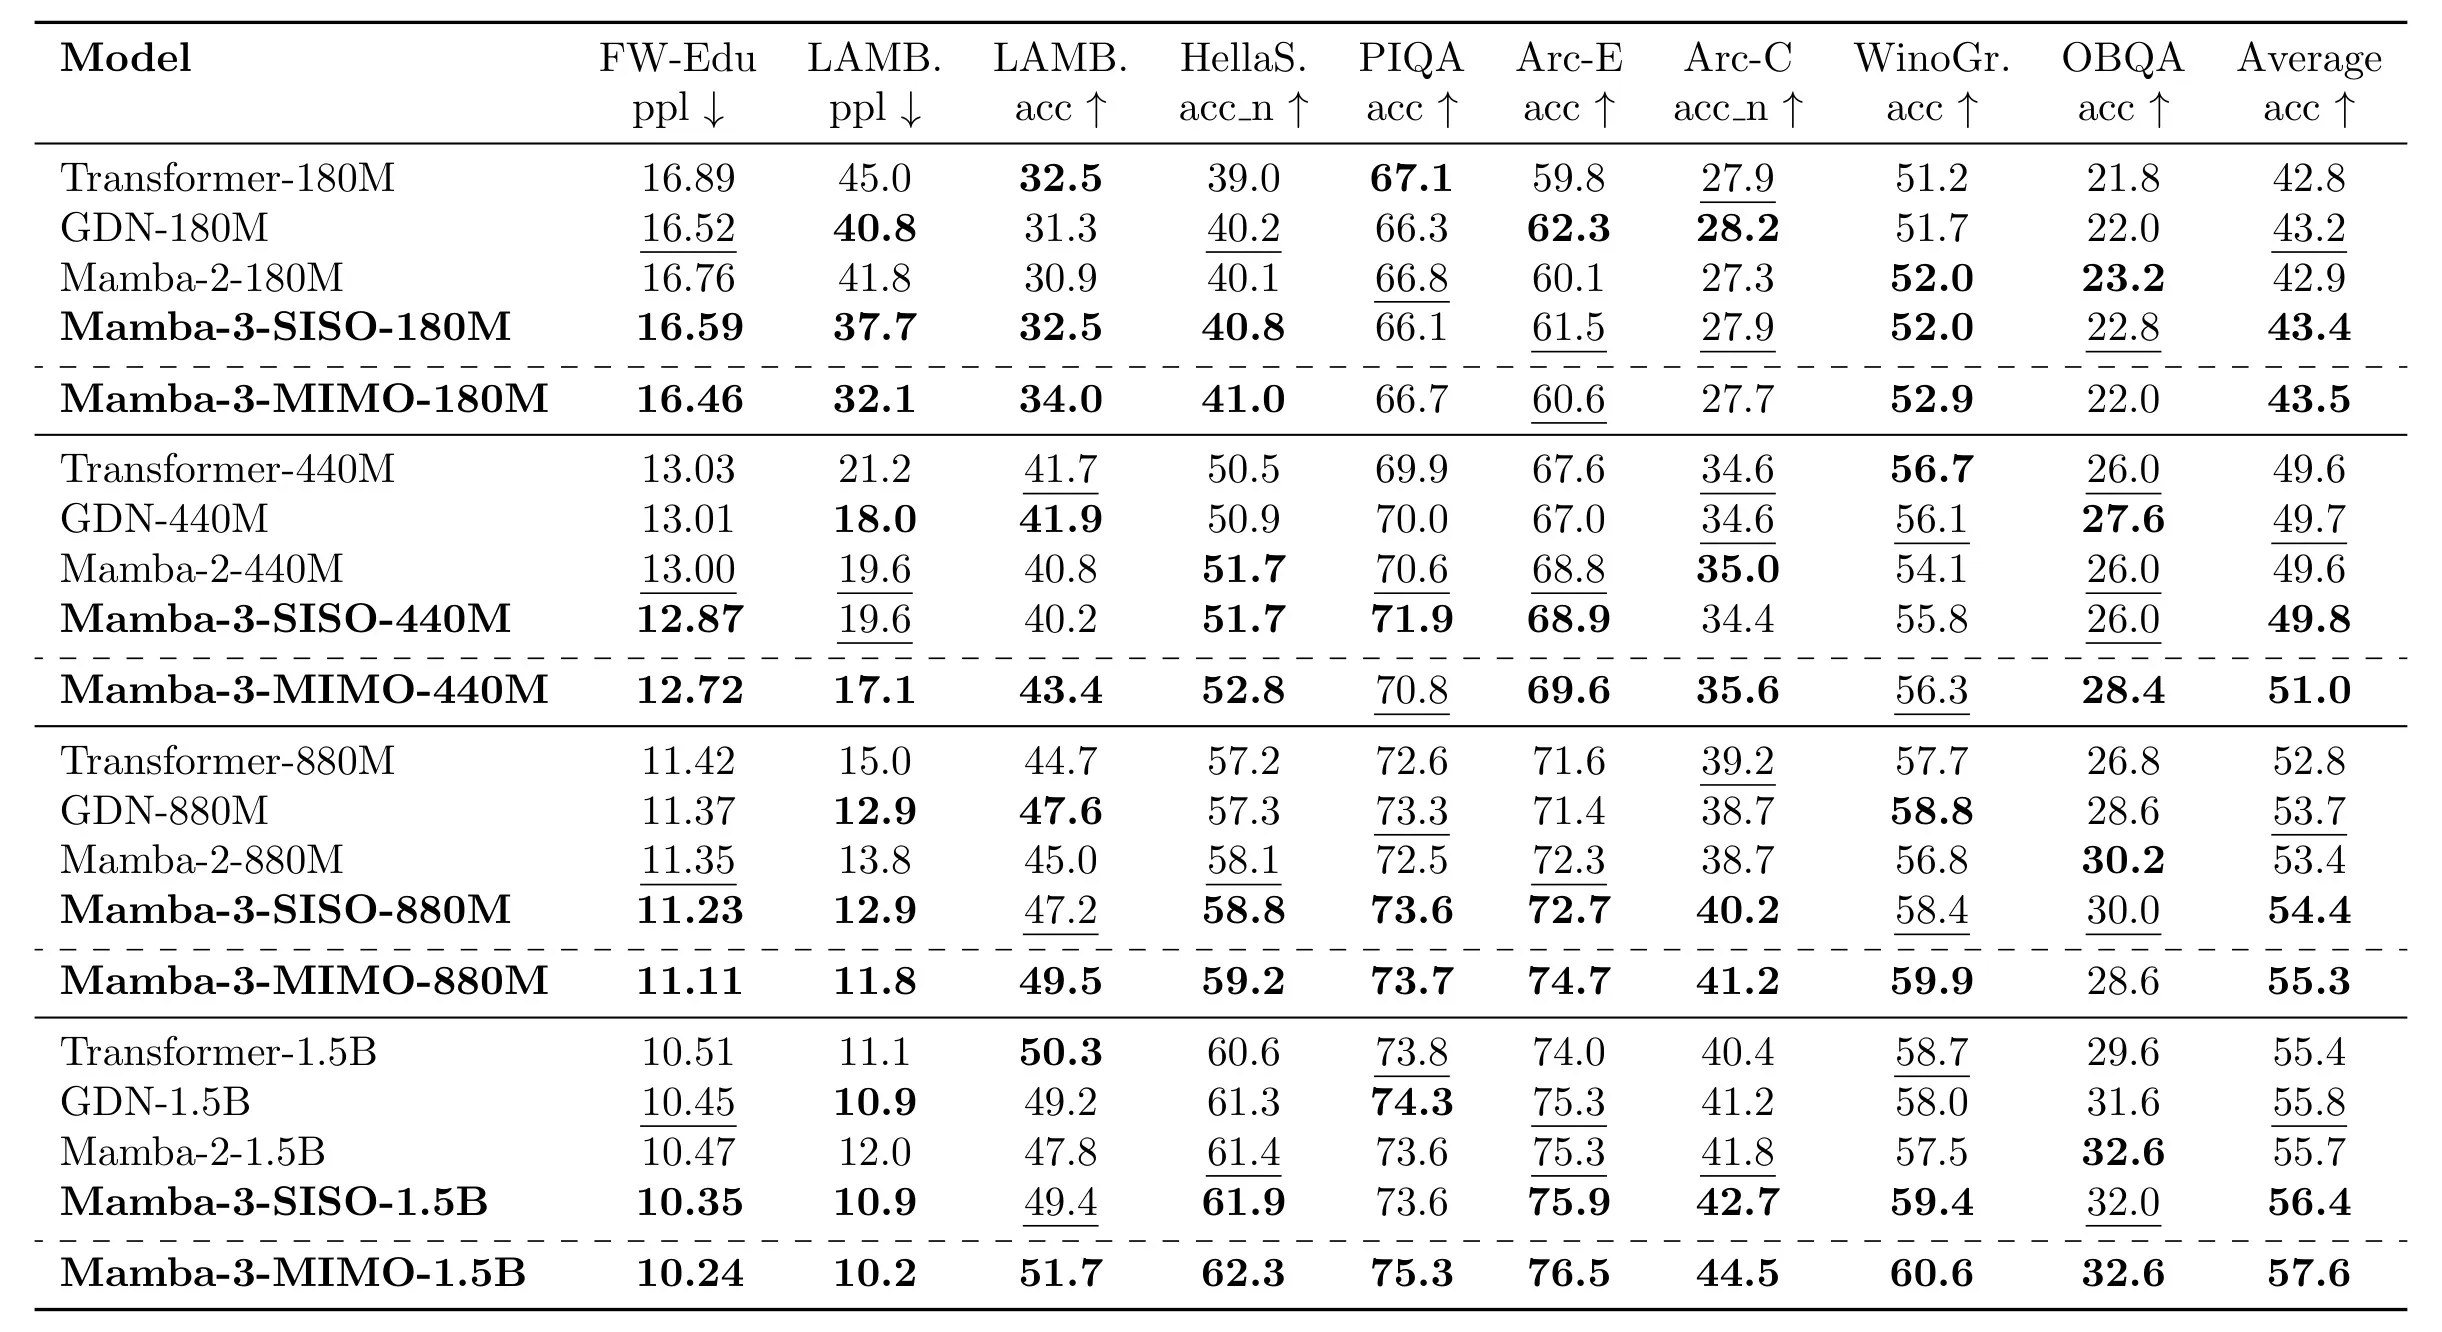
Mamba-3 dépasse Mamba-2 et des alternatives performantes d’attention linéaire comme GDN en modélisation du langage, à différentes tailles de modèles préentraînés. Mamba-3-SISO est directement comparable aux modèles linéaires précédents. Il a notamment exactement les mêmes dimensions architecturales que Mamba-2, taille du modèle, de l’état, etc., et un temps d’entraînement comparable. Notre variante MIMO améliore encore l’exactitude de plus d’un point de pourcentage sur les tâches en aval à l’échelle d’un milliard de paramètres. Elle exige toutefois un entraînement plus long, mais pas une latence de décodage plus élevée.
Comment l'entraînement peut-il coûter plus cher sans alourdir l'inférence ?
Nous détaillerons ce point dans la deuxième partie. En voici un aperçu.
Cette différence vient du fait que l’entraînement est limité par le calcul tandis que l’inférence l’est par la mémoire. Les modèles linéaires actuels utilisent de nombreux Tensor Cores GPU, l’un des principaux apports de Mamba-2, pour un entraînement rapide. Mais au décodage, chaque pas demande si peu de calcul que le matériel reste largement inutilisé.
Si une architecture augmente simplement le nombre de FLOP par pas, la latence d’inférence reste donc à peu près constante grâce aux cœurs inactifs disponibles. Ce n’est pas le cas de l’entraînement.
Tâches de récupération
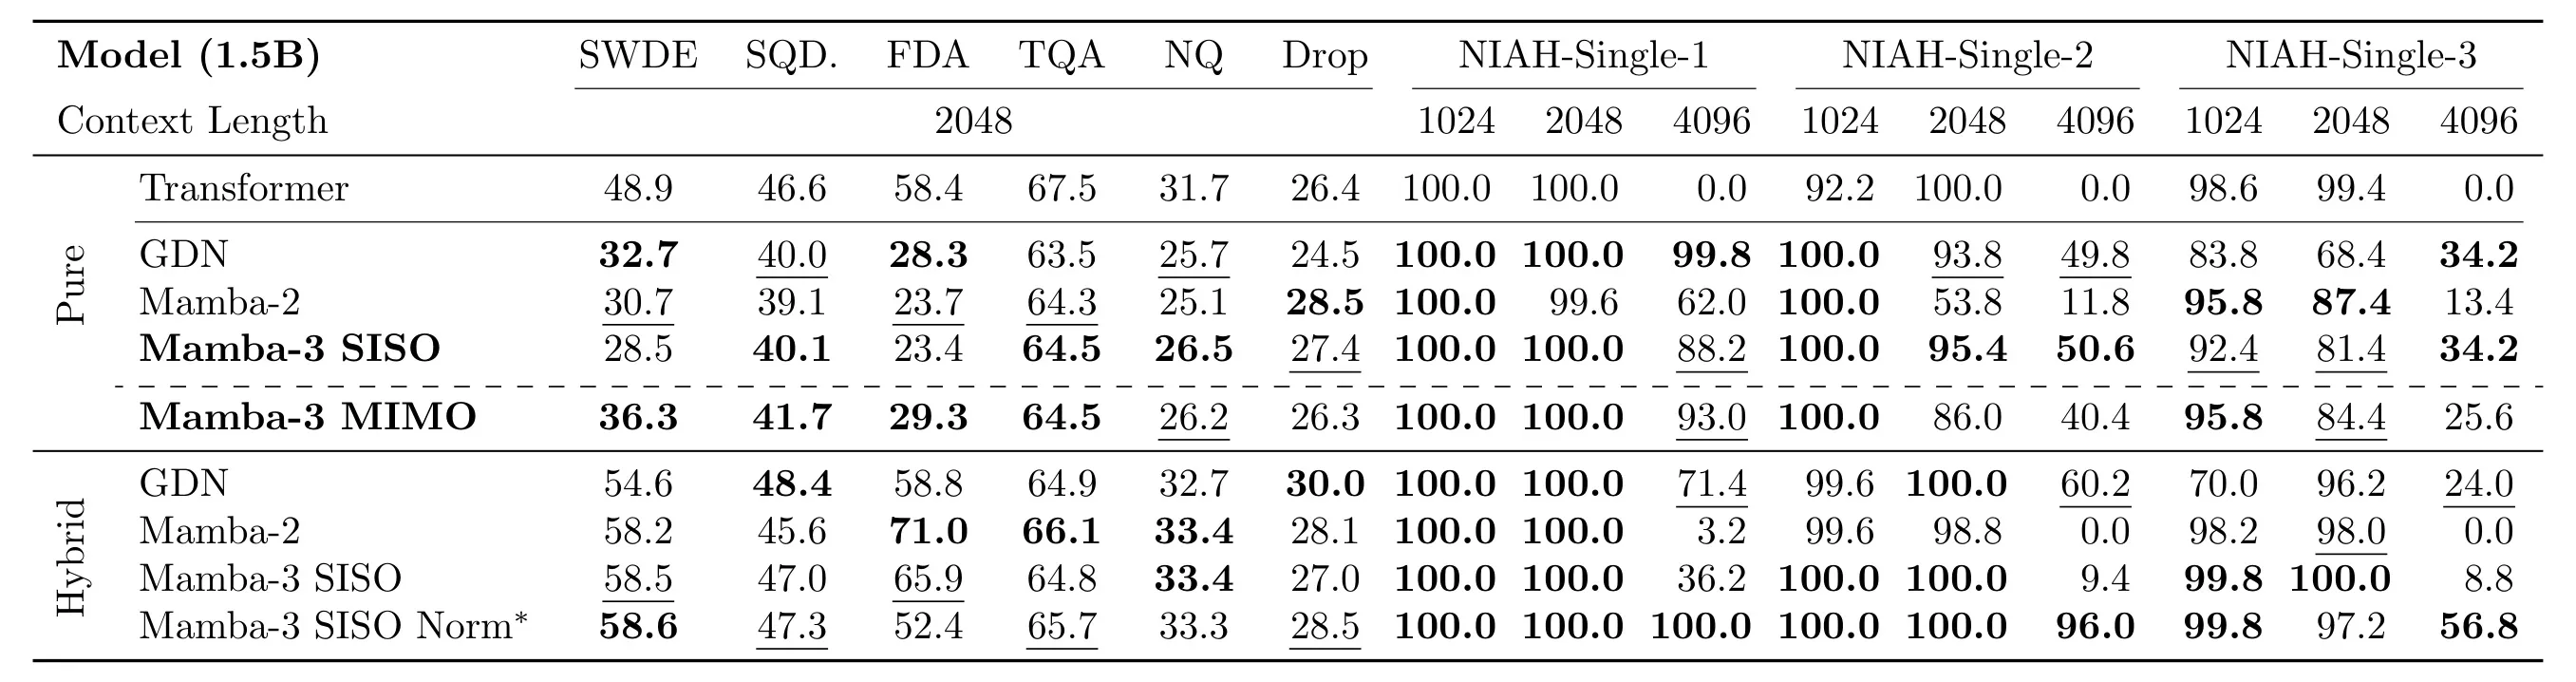
Avec leur état fixe, les modèles linéaires sont naturellement moins performants que les Transformers sur les tâches de récupération. Comme prévu, parmi les modèles purs, le Transformer domine ces tâches, mais Mamba-3 se comporte bien parmi les alternatives sous-quadratiques. L’ajout de MIMO améliore encore la récupération sans augmenter la taille de l’état.
Compte tenu de cette faiblesse intrinsèque, mais de bonnes performances générales de modélisation,
nous prévoyons que les couches linéaires seront surtout utilisées avec des couches d’auto-attention globale à l’avenir.*
*au moins pour la modélisation du langage
Les modèles hybrides combinent le fonctionnement général proche d’une mémoire des couches linéaires avec le stockage exact, proche d’une base de données, du cache KV de l’auto-attention. Ils dépassent empiriquement les modèles purs tout en économisant fortement mémoire et calcul 10. Ici aussi, la combinaison de couches linéaires et d’auto-attention améliore la récupération par rapport à un Transformer classique.
Cependant, l’interaction exacte entre ces modèles linéaires et l’auto-attention n’est pas entièrement comprise. La projection facultative avant sortie de Mamba-3 améliore, par exemple, la généralisation en longueur sur les tâches synthétiques NIAH, au prix d’une légère baisse sur les tâches réelles de récupération en contexte. Même les détails de la normalisation réintroduite, sa position avant ou après la porte et son type groupé ou classique, influencent sensiblement l’exactitude sur des données semi-structurées et non structurées comme FDA et SWDE.
Des noyaux partout
Nous avons hâte de voir ce que vous construirez avec Mamba-3. Pour vous y aider, nous publions nos noyaux en open source. Ils sont aussi rapides que les noyaux Triton originaux de Mamba-2.
Mesurer les latences
Latence de préremplissage
| Modèle | n=512 | 1024 | 2048 | 4096 | 16384 |
|---|---|---|---|---|---|
| vLLM (Llama-3.2-1B) | 0.26 | 0.52 | 1.08 | 2.08 | 12.17 |
| Gated DeltaNet | 0.51 | 1.01 | 2.01 | 4.00 | 16.21 |
| Mamba-2 | 0.51 | 1.02 | 2.02 | 4.02 | 16.22 |
| Mamba-3 (SISO) | 0.51 | 1.01 | 2.02 | 4.01 | 16.22 |
| Mamba-3 (MIMO R=4) | 0.60 | 1.21 | 2.42 | 4.76 | 19.44 |
Latence de préremplissage et décodage
| Modèle | n=512 | 1024 | 2048 | 4096 | 16384 |
|---|---|---|---|---|---|
| vLLM (Llama-3.2-1B) | 4.45 | 9.60 | 20.37 | 58.64 | 976.50 |
| Gated DeltaNet | 4.56 | 9.11 | 18.22 | 36.41 | 145.87 |
| Mamba-2 | 4.66 | 9.32 | 18.62 | 37.22 | 149.02 |
| Mamba-3 (SISO) | 4.39 | 8.78 | 17.57 | 35.11 | 140.61 |
| Mamba-3 (MIMO R=4) | 4.74 | 9.48 | 18.96 | 37.85 | 151.81 |
À l’échelle de 1,5 milliard de paramètres, Mamba-3 SISO atteint la plus faible latence cumulée de préremplissage et de décodage pour toutes les longueurs de séquence. Il dépasse Mamba-2, Gated DeltaNet et même le Transformer avec son écosystème vLLM très optimisé. Mamba-3 MIMO a une vitesse comparable à Mamba-2, avec des performances nettement supérieures.
Le préremplissage Triton de Mamba-3 SISO conserve des performances presque identiques à Mamba-2. La nouvelle discrétisation et les plongements RoPE dépendant des données n’ajoutent donc pas de surcoût. Mamba-3 MIMO ne subit qu’un ralentissement modéré du préremplissage grâce à son implémentation TileLang efficace. Les bons résultats de décodage des deux variantes viennent en partie de l’implémentation CuTe DSL, facilitée par la simplicité des composants de Mamba-3.
Choix de conception
Nous avons beaucoup réfléchi à la façon d’accélérer au maximum les noyaux sans compliquer leur utilisation. Nous avons retenu Triton, TileLang et CuTe DSL.
Le choix de Triton était assez simple. Il est presque standard pour développer des architectures, comme le montre le dépôt flash linear attention entièrement en PyTorch et Triton. Il dépasse PyTorch standard grâce au contrôle du découpage en tuiles et à la fusion de noyaux, tout en restant indépendant de la plateforme. Il offre aussi l’injection de PTX, un langage assembleur pour GPU, et le Tensor Memory Accelerator des GPU Hopper pour des transferts asynchrones massifs de la mémoire globale vers la mémoire partagée.
Nous avons développé les noyaux de préremplissage MIMO avec TileLang. Les projections supplémentaires permettent de réduire les entrées-sorties mémoire en exploitant la hiérarchie mémoire du GPU. Triton n’offrait pas le contrôle fin souhaité. TileLang permet de déclarer et de contrôler explicitement les tuiles en mémoire partagée et de créer des fragments de registres. Nous réutilisons ainsi mieux la mémoire tout en gardant un niveau d’abstraction assez élevé pour développer rapidement.
Étant donné l’importance de l’inférence et du décodage, nous avons choisi CuTe DSL pour nos noyaux de décodage. Son interface Python génère des noyaux bas niveau à partir des abstractions de CUTLASS. Nous disposons pratiquement du contrôle de CUDA pour créer des noyaux performants adaptés à notre matériel, ici les GPU Hopper. Le contrôle fin de l’organisation des tenseurs et de la spécialisation des warps nous permet d’exploiter toutes les capacités du GPU.
Ces implémentations à différents niveaux d’abstraction GPU sont rendues possibles par la conception algorithmique des ajouts simples et légers de Mamba-3 et par leur mise en œuvre. Notre publication complète détaille notamment la structure de fusion et le langage spécialisé des noyaux.
La suite
Merci d’avoir lu cette première partie ! Nous n’avons pas pu couvrir tous les détails des noyaux, résultats expérimentaux et études d’ablation. Vous les trouverez dans notre article, et les noyaux sont publiés dans mamba-ssm.
La deuxième et dernière partie examine les trois améliorations centrales de Mamba-3, leurs fondements SSM et quelques pistes qui nous intéressent particulièrement.
Notes
Notes de bas de page
-
ou “BCNorm” dans la terminologie SSM ↩
-
Mamba: Linear-Time Sequence Modeling with Selective State Spaces. [PDF] Gu, A. and Dao, T., 2024. ↩
-
Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality. [PDF] Dao, T. and Gu, A., 2024. ↩
-
Gated Delta Networks: Improving Mamba2 with Delta Rule [PDF] ↩
-
Learning to (Learn at Test Time): RNNs with Expressive Hidden States [PDF] ↩
-
Hungry Hungry Hippos: Towards Language Modeling with State Space Models [PDF] ↩
-
In-context Learning and Induction Heads ↩
-
Test-time regression: a unifying framework for designing sequence models with associative memory [PDF] ↩