

Cartesia 및 Together와 함께 지금까지 가장 강력한 Mamba 언어 모델 Mamba-3B-SlimPJ를 Apache 2.0 라이선스로 공개합니다. 600B 토큰으로 학습한 Mamba-3B-SlimPJ는 학습 FLOP을 17% 적게 쓰면서 비교 가능한 최고 수준의 3B Transformer와 동등한 성능을 냅니다. arXiv에서 Mamba를 자세히 읽고 GitHub에서 사용 가능한 오픈소스 코드를 찾을 수 있습니다.
가중치는 HuggingFace에서 받으세요.
소개
Mamba 아키텍처는 S4 같은 상태 공간 모델과 FlashAttention 같은 하드웨어 효율적 알고리즘의 오랜 연구를 바탕으로 합니다. 시퀀스 길이에 따라 선형으로 확장하고 빠르게 추론하면서 Transformer의 강력한 대안으로 떠올랐습니다. Cartesia와 Together의 협력으로 SlimPajama 데이터셋의 600B 토큰에서 학습한 2.8B 파라미터 Mamba 모델을 Apache 2.0 라이선스로 공개합니다.
600B 토큰으로 학습한 Mamba-3B-SlimPJ는 FLOP을 17% 적게 사용하면서 BTLM-3B-8K 같은 최고 수준의 3B Transformer와 비슷한 품질을 냅니다. BTLM-3B-8K도 600B 토큰으로 학습했습니다. 고급 학습 기법을 사용하는 강력한 Transformer 아키텍처로, 일부 7B Transformer까지 앞섭니다. 이는 Mamba가 파운데이션 모델을 만드는 데 유망한 아키텍처임을 뒷받침합니다.
학습 세부 사항
Mamba-3B-SlimPJ를 문맥 길이 2048, 총 600B 토큰으로 학습했습니다. Pile 300B 토큰에서 학습한 Mamba-3B와 같은 하이퍼파라미터를 사용하되, 더 많은 토큰에 맞춰 학습률 감쇠 기간을 늘렸습니다. SlimPajama 데이터셋과 GPT-NeoX 토크나이저를 사용합니다. SlimPajama는 RedPajama를 정제하고 중복을 제거한 데이터셋입니다. 서로 다른 그룹이 데이터와 모델 작업을 이어받아 발전시키는 것, 이것이 우리가 좋아하는 오픈소스 AI의 모습입니다.
평가
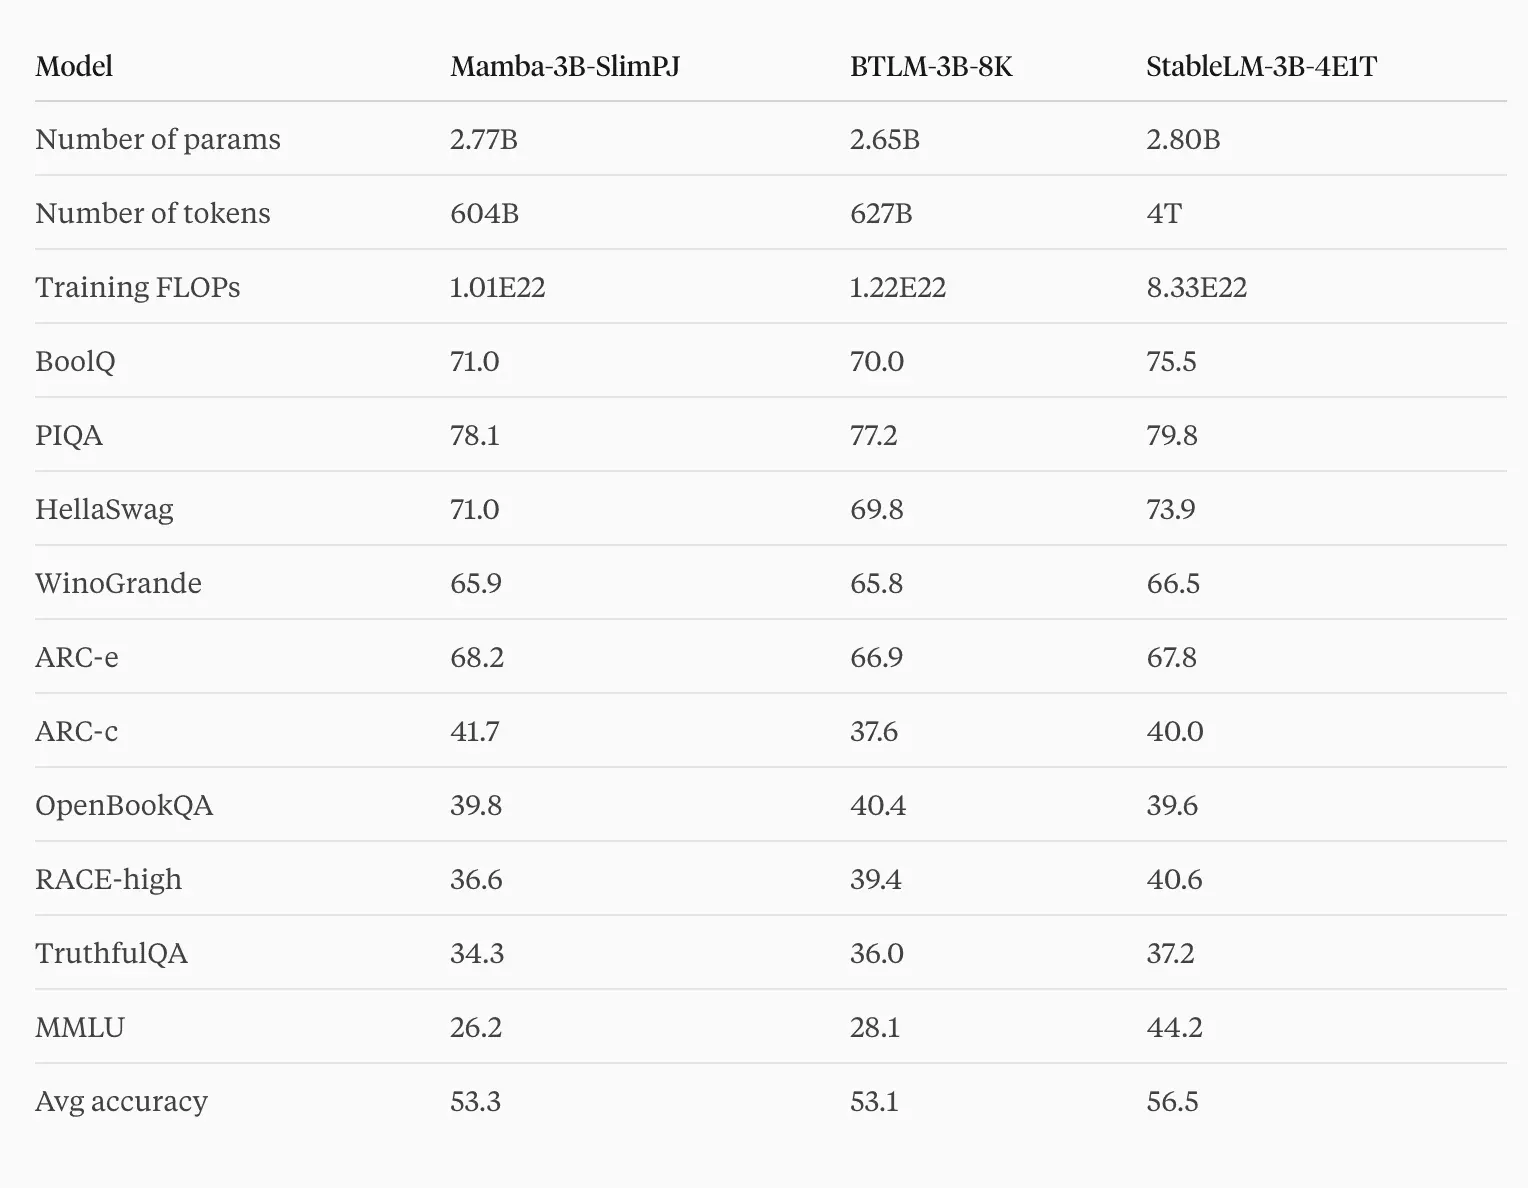
Mamba-3B-SlimPJ는 학습 FLOP을 17% 적게 사용하면서 매우 강력한 Transformer인 BTLM-3B-8K와 비슷한 품질을 냅니다. 일반적으로 데이터와 연산을 늘리면 더 좋은 모델이 됩니다. 예를 들어 크기가 비슷하지만 토큰을 7배 더 학습한 StableLM-3B-4E1T는 Mamba-3B-SlimPJ나 BTLM-3B-8K보다 여전히 성능이 좋습니다.
BTLM-3B-8K의 절차를 따라 BoolQ, PIQA, HellaSwag, WinoGrande, ARC easy, ARC challenge, OpenBookQA, RACE-high, TruthfulQA, MMLU 등 10개 작업에서 Mamba-3B-SlimPJ를 평가했습니다. BTLM-3B-8K에서 평가한 SIQA와 RACE-middle은 아직 lm-evaluation-harness에 없습니다. MMLU는 5-shot, 나머지는 모두 zero-shot으로 평가합니다. PIQA, HellaSwag, ARC-e, ARC-c, OpenBookQA, MMLU는 정규화 정확도를, BoolQ, WinoGrande, RACE-high, TruthfulQA는 정확도를 보고합니다. TruthfulQA는 MC2 점수입니다.
앞으로의 연구
BTLM-3B-8K 같은 Transformer는 가변 길이 학습이나 maximal update parameterization 같은 고급 기법을 사용할 수 있습니다. 앞으로 Mamba 학습에서도 이 기법들을 살펴보고자 합니다.
SSM과 Transformer를 넘어선 아키텍처, 특히 Mamba에 대한 관심이 커지는 모습을 기쁘게 보고 있습니다. 이번 공개의 목적 중 하나는 실험과 이해, 그리고 채팅·지시 튜닝 모델을 위한 더 강력한 기본 모델을 제공하는 것입니다. Mamba가 언어, 오디오, 영상 등 여러 모달리티의 파운데이션 모델에 강력한 아키텍처가 될 수 있다고 믿습니다.
Cartesia 소개
Cartesia는 상태 공간 모델 같은 차세대 아키텍처로 새로운 역량의 파운데이션 모델을 만들고 있습니다. 수석 과학자 Albert가 이 작업을 이끌고 있습니다. 여기에서 작업 소식을 보고 얼리 액세스에 등록할 수 있습니다.
이 모델들을 AI의 최전선으로 가져오는 일에 함께하고 싶다면 지원해 주세요. 이력서와 자신의 가장 뛰어난 성과를 보여주는 한 문단을 join@cartesia.ai로 보내주세요. 다양한 배경과 경험을 가진 지원자를 환영합니다.
감사의 말
SlimPajama 데이터셋을 제공한 Cerebras, BTLM-3B-8K 모델을 제공한 Cerebras와 OpenTensor에 감사드립니다. EleutherAI에도 Pile 데이터셋과 lm-evaluation-harness에 감사드립니다.