

Publicamos Mamba-3B-SlimPJ, el modelo de lenguaje Mamba más potente hasta la fecha, en colaboración con Cartesia y Together, bajo la licencia Apache 2.0. Entrenado con 600.000 millones de tokens, Mamba-3B-SlimPJ iguala el rendimiento de los modelos Transformer comparables de 3.000 millones de parámetros más potentes, con un 17 % menos de FLOPs de entrenamiento. Puedes leer más sobre Mamba en arXiv y encontrar código abierto para utilizarlo en GitHub.
Descarga los pesos en HuggingFace.
Introducción
La arquitectura Mamba se basa en una larga trayectoria de investigación sobre modelos de espacio de estados, como S4, y algoritmos eficientes para el hardware, como FlashAttention. Ha surgido como una alternativa competitiva a los Transformers, con escalado lineal respecto a la longitud de la secuencia e inferencia rápida. En colaboración con Cartesia y Together, publicamos un modelo Mamba de 2.800 millones de parámetros entrenado con 600.000 millones de tokens del conjunto de datos SlimPajama, bajo la licencia Apache 2.0.
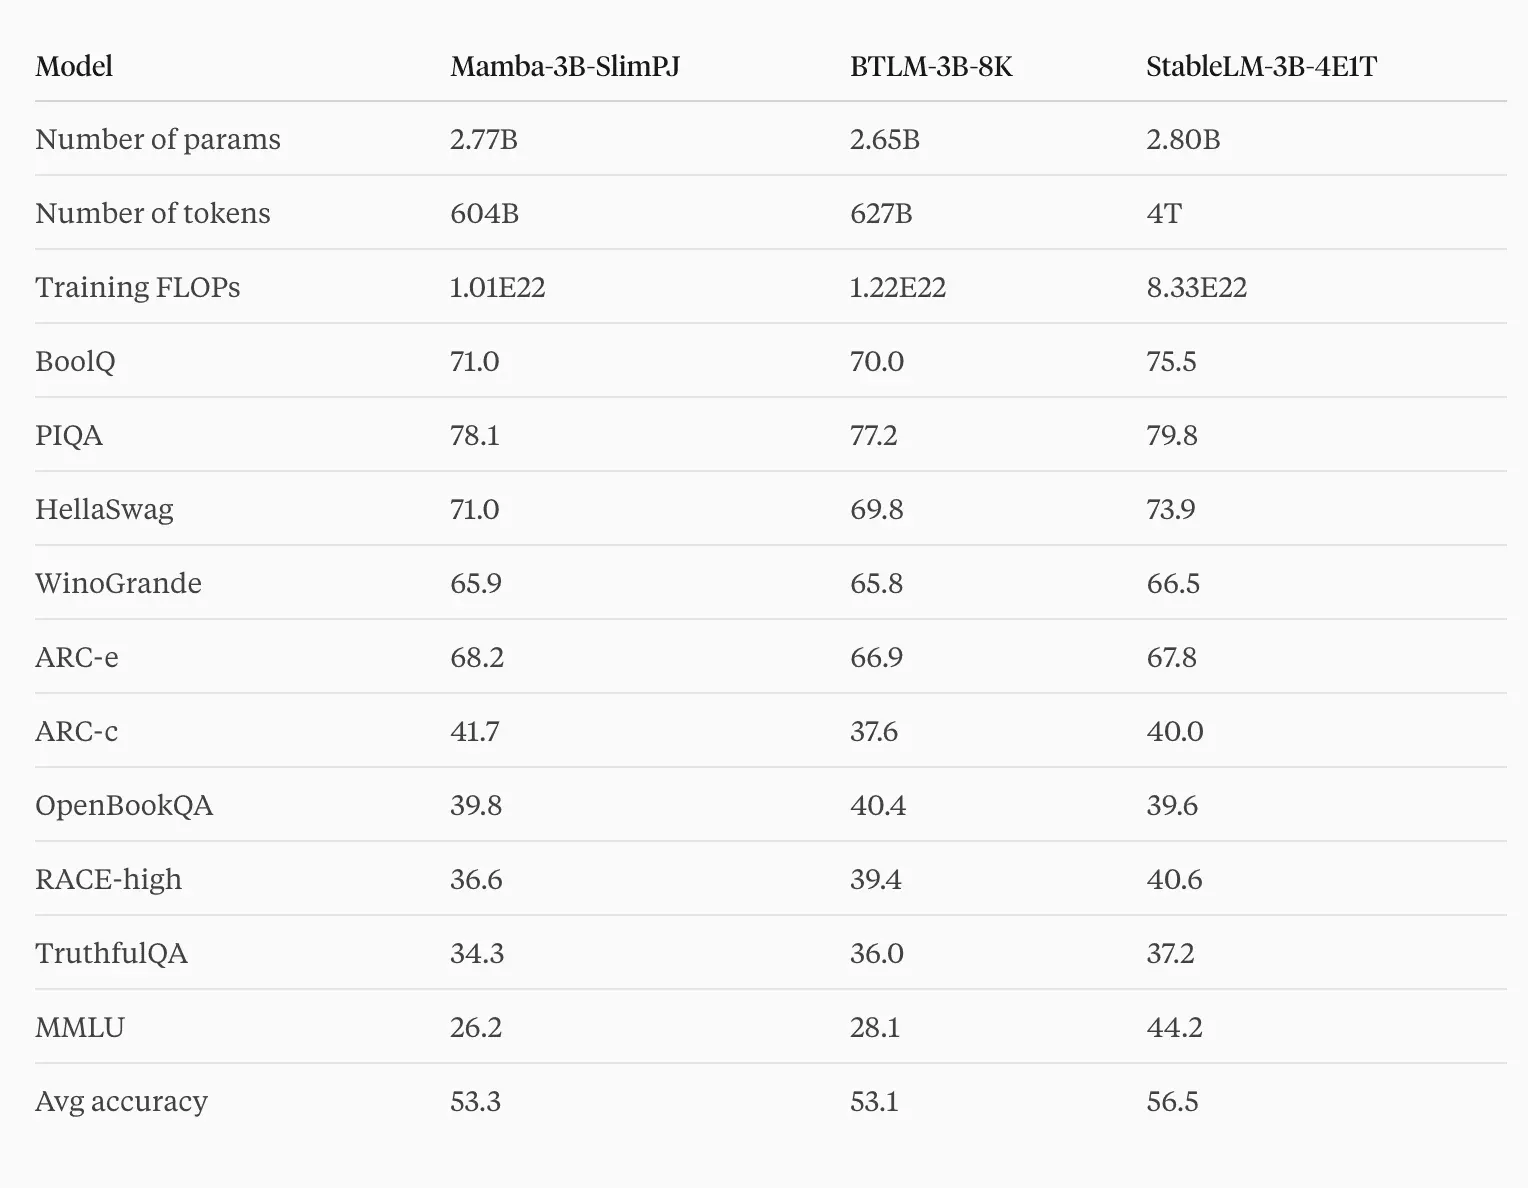
Entrenado con 600.000 millones de tokens, Mamba-3B-SlimPJ iguala la calidad de algunos de los mejores Transformers de 3.000 millones de parámetros, como BTLM-3B-8K, también entrenado con 600.000 millones de tokens, con un 17 % menos de FLOPs. BTLM-3B-8K utiliza una arquitectura Transformer potente y técnicas de entrenamiento avanzadas que incluso superan a algunos Transformers de 7.000 millones de parámetros. Esto refuerza la evidencia de que Mamba es una arquitectura prometedora para crear modelos fundacionales.
Detalles del entrenamiento
Entrenamos Mamba-3B-SlimPJ con 600.000 millones de tokens y una longitud de contexto de 2048, usando los mismos hiperparámetros que Mamba-3B sobre Pile, de 300.000 millones de tokens. La única excepción fue un descenso de la tasa de aprendizaje más largo para acomodar más tokens. Usamos el conjunto de datos SlimPajama con el tokenizador GPT-NeoX. SlimPajama es una versión depurada y sin duplicados de RedPajama. Esto es lo que nos gusta de la IA de código abierto: distintos grupos construyen a partir del trabajo de otros sobre datos y modelos.
Evaluación
Mamba-3B-SlimPJ iguala la calidad de Transformers muy potentes como BTLM-3B-8K, con un 17 % menos de FLOPs de entrenamiento. En general, más datos y capacidad de cómputo producen mejores modelos. Por ejemplo, StableLM-3B-4E1T, de tamaño similar y entrenado con siete veces más tokens, sigue rindiendo mejor que Mamba-3B-SlimPJ o BTLM-3B-8K.
Evaluamos Mamba-3B-SlimPJ en 10 tareas siguiendo el procedimiento de BTLM-3B-8K: BoolQ, PIQA, HellaSwag, WinoGrande, ARC easy, ARC challenge, OpenBookQA, RACE-high, TruthfulQA y MMLU. SIQA y RACE-middle, evaluadas en BTLM-3B-8K, todavía no están disponibles en lm-evaluation-harness. Todas las evaluaciones son zero-shot, salvo MMLU, que utiliza 5 ejemplos. Presentamos la exactitud normalizada para PIQA, HellaSwag, ARC-e, ARC-c, OpenBookQA y MMLU, y la exactitud para BoolQ, WinoGrande, RACE-high y TruthfulQA, con la puntuación MC2 en esta última.
Próximos pasos
Transformers como BTLM-3B-8K pueden utilizar técnicas más avanzadas, como el entrenamiento con longitud variable y la parametrización de actualización máxima. Queremos explorar estas técnicas para entrenar Mamba en el futuro.
Nos alegra ver el interés por los SSM y las arquitecturas más allá de los Transformers, y por Mamba en particular. Parte de la motivación de esta publicación es ofrecer un modelo base más potente para experimentar y comprender mejor estas arquitecturas, así como para crear modelos de chat y ajustados a instrucciones. Creemos que Mamba puede ser una arquitectura sólida para modelos fundacionales en modalidades como lenguaje, audio y vídeo.
Acerca de Cartesia
En Cartesia estamos creando modelos fundacionales con nuevas capacidades sobre arquitecturas de nueva generación, como los modelos de espacio de estados. Nos alegra contar con Albert como director científico al frente de este trabajo. Puedes seguir nuestros avances y registrarte para obtener acceso anticipado aquí.
Si quieres participar en el desarrollo de estos modelos en la vanguardia de la IA, ¡únete al equipo! Escríbenos a join@cartesia.ai con tu currículum y un párrafo que describa uno de tus logros más destacados. Animamos a presentar su candidatura a personas con distintos perfiles y experiencias.
Agradecimientos
Gracias a Cerebras por el conjunto de datos SlimPajama, y a Cerebras y OpenTensor por el modelo BTLM-3B-8K. También agradecemos a EleutherAI el conjunto de datos Pile y lm-evaluation-harness.