

Pubblichiamo il modello linguistico Mamba più potente finora, Mamba-3B-SlimPJ, in collaborazione con Cartesia e Together, con licenza Apache 2.0. Addestrato su 600B token, Mamba-3B-SlimPJ raggiunge le prestazioni dei migliori modelli Transformer 3B comparabili con il 17% di FLOP di addestramento in meno. Puoi leggere di più su Mamba su arXiv e trovare il codice open source per usarlo su GitHub.
Scarica i pesi su HuggingFace.
Introduzione
L’architettura Mamba, basata su una lunga serie di lavori sui modelli a spazio di stato, come S4, e sugli algoritmi efficienti per l’hardware, come FlashAttention, si è affermata come alternativa competitiva ai Transformer, con crescita lineare rispetto alla lunghezza della sequenza e inferenza veloce. Nell’ambito di una collaborazione con Cartesia e Together, pubblichiamo un modello Mamba da 2.8B parametri addestrato su 600B token del dataset SlimPajama, con licenza Apache 2.0.
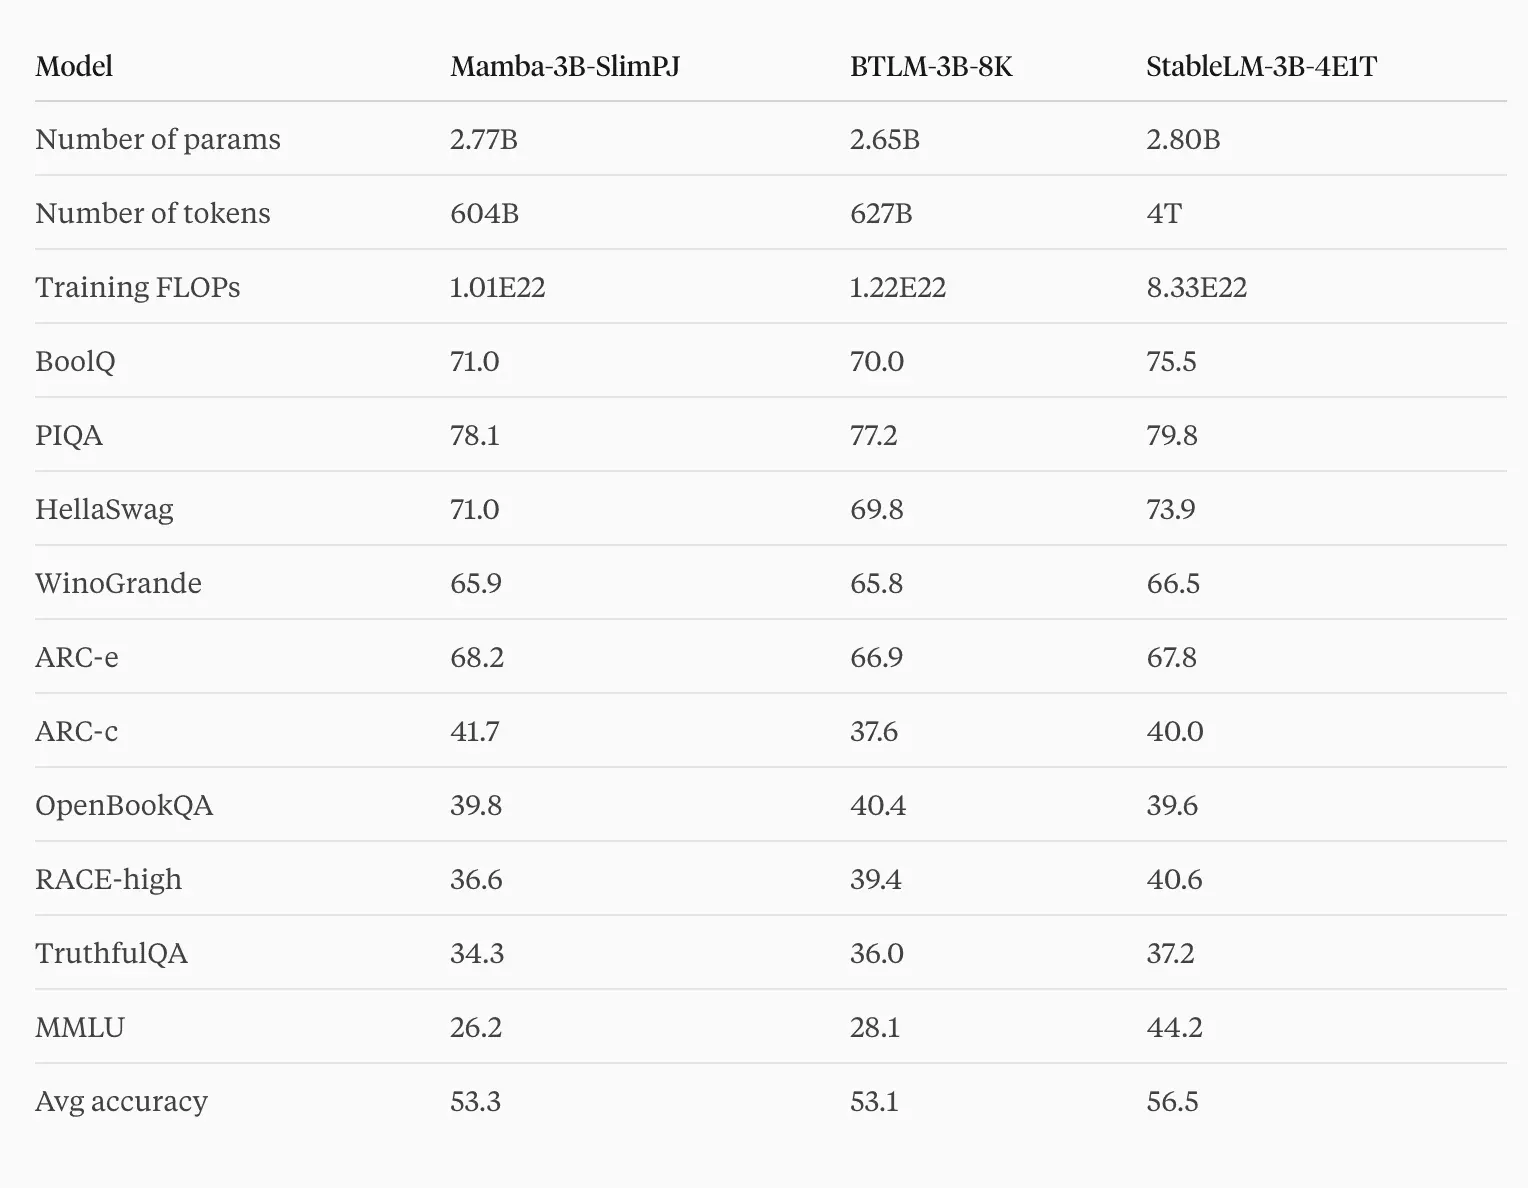
Addestrato su 600B token, Mamba-3B-SlimPJ raggiunge la qualità di alcuni dei migliori Transformer 3B, come BTLM-3B-8K, anch’esso addestrato su 600B token, con il 17% di FLOP in meno. BTLM-3B-8K usa un’architettura Transformer efficace con tecniche di addestramento avanzate che supera persino alcuni Transformer 7B. Questo conferma ulteriormente il potenziale di Mamba per costruire modelli di base.
Dettagli dell’addestramento
Abbiamo addestrato Mamba-3B-SlimPJ su 600B token, con lunghezza del contesto 2048, usando gli stessi iperparametri di Mamba-3B su Pile, 300B token, salvo un decadimento più lungo del tasso di apprendimento per accogliere più token. Usiamo il dataset SlimPajama con il tokenizer GPT-NeoX. SlimPajama è una versione ripulita e deduplicata di RedPajama. È ciò che apprezziamo dell’IA open source: gruppi diversi che costruiscono sul lavoro reciproco, nei dati e nei modelli.
Valutazione
Mamba-3B-SlimPJ raggiunge la qualità di Transformer molto forti, BTLM-3B-8K, con il 17% di FLOP di addestramento in meno. In generale, più dati e calcolo producono modelli migliori: per esempio, StableLM-3B-4E1T, di dimensioni simili e addestrato su 7 volte più token, ottiene ancora risultati migliori di Mamba-3B-SlimPJ o BTLM-3B-8K.
Valutiamo Mamba-3B-SlimPJ su 10 compiti seguendo la procedura di BTLM-3B-8K: BoolQ, PIQA, HellaSwag, WinoGrande, ARC easy, ARC challenge, OpenBookQA, RACE-high, TruthfulQA e MMLU. SIQA e RACE-middle, usati nella valutazione di BTLM-3B-8K, non sono ancora disponibili in lm-evaluation-harness. Tutte le valutazioni sono zero-shot, tranne MMLU, che usa 5 esempi. Riportiamo accuratezze normalizzate per PIQA, HellaSwag, ARC-e, ARC-c, OpenBookQA e MMLU, e accuratezze per BoolQ, WinoGrande, RACE-high e TruthfulQA, con punteggio MC2.
I prossimi passi
Transformer come BTLM-3B-8K possono usare tecniche più avanzate, come l’addestramento a lunghezza variabile e la parametrizzazione dell’aggiornamento massimo. Vogliamo esplorare queste tecniche per l’addestramento di Mamba in futuro.
Siamo felici dell’interesse per gli SSM e, più in generale, per le architetture oltre i Transformer, in particolare Mamba. Uno dei motivi di questa pubblicazione è fornire un modello di base più forte per sperimentare e comprendere queste architetture, oltre che per modelli di chat e adattati alle istruzioni. Crediamo che Mamba possa essere una valida architettura per modelli di base in modalità come linguaggio, audio e video.
Informazioni su Cartesia
In Cartesia costruiamo modelli di base con nuove capacità su architetture di nuova generazione, come i modelli a spazio di stato, e siamo felici che Albert guidi questo lavoro come Chief Scientist. Puoi seguire il nostro lavoro e registrarti per l’accesso anticipato qui.
Se vuoi contribuire a portare questi modelli in prima linea nell’IA, vieni a lavorare con noi. Scrivi a join@cartesia.ai con un curriculum e un paragrafo che descriva un esempio del tuo risultato più eccezionale. Accogliamo candidature da persone con esperienze e percorsi diversi.
Ringraziamenti
Grazie a Cerebras per il dataset SlimPajama, e a Cerebras e OpenTensor per il modello BTLM-3B-8K. Ringraziamo anche EleutherAI per il dataset Pile e lm-evaluation-harness.