

CartesiaとTogetherの協力により、これまでで最も高性能なMamba言語モデル、Mamba-3B-SlimPJをApache 2.0ライセンスで公開します。600Bトークンで学習したMamba-3B-SlimPJは、学習FLOPsを17%抑えながら、同規模の有力な3B Transformerモデルと同等の性能を達成します。Mambaの詳細はarXiv、利用できるオープンソースのコードはGitHubをご覧ください。
重みはHuggingFaceから取得できます。
はじめに
Mambaは、S4などの状態空間モデルと、FlashAttentionなどのハードウェア効率を高めるアルゴリズムに関する長年の研究を基盤にしています。Transformerの有力な代替候補であり、系列長に対して線形にスケールし、高速に推論できます。CartesiaとTogetherの共同研究の一環として、SlimPajamaデータセットの600Bトークンで学習した28億パラメーターのMambaモデルを、Apache 2.0ライセンスで公開します。
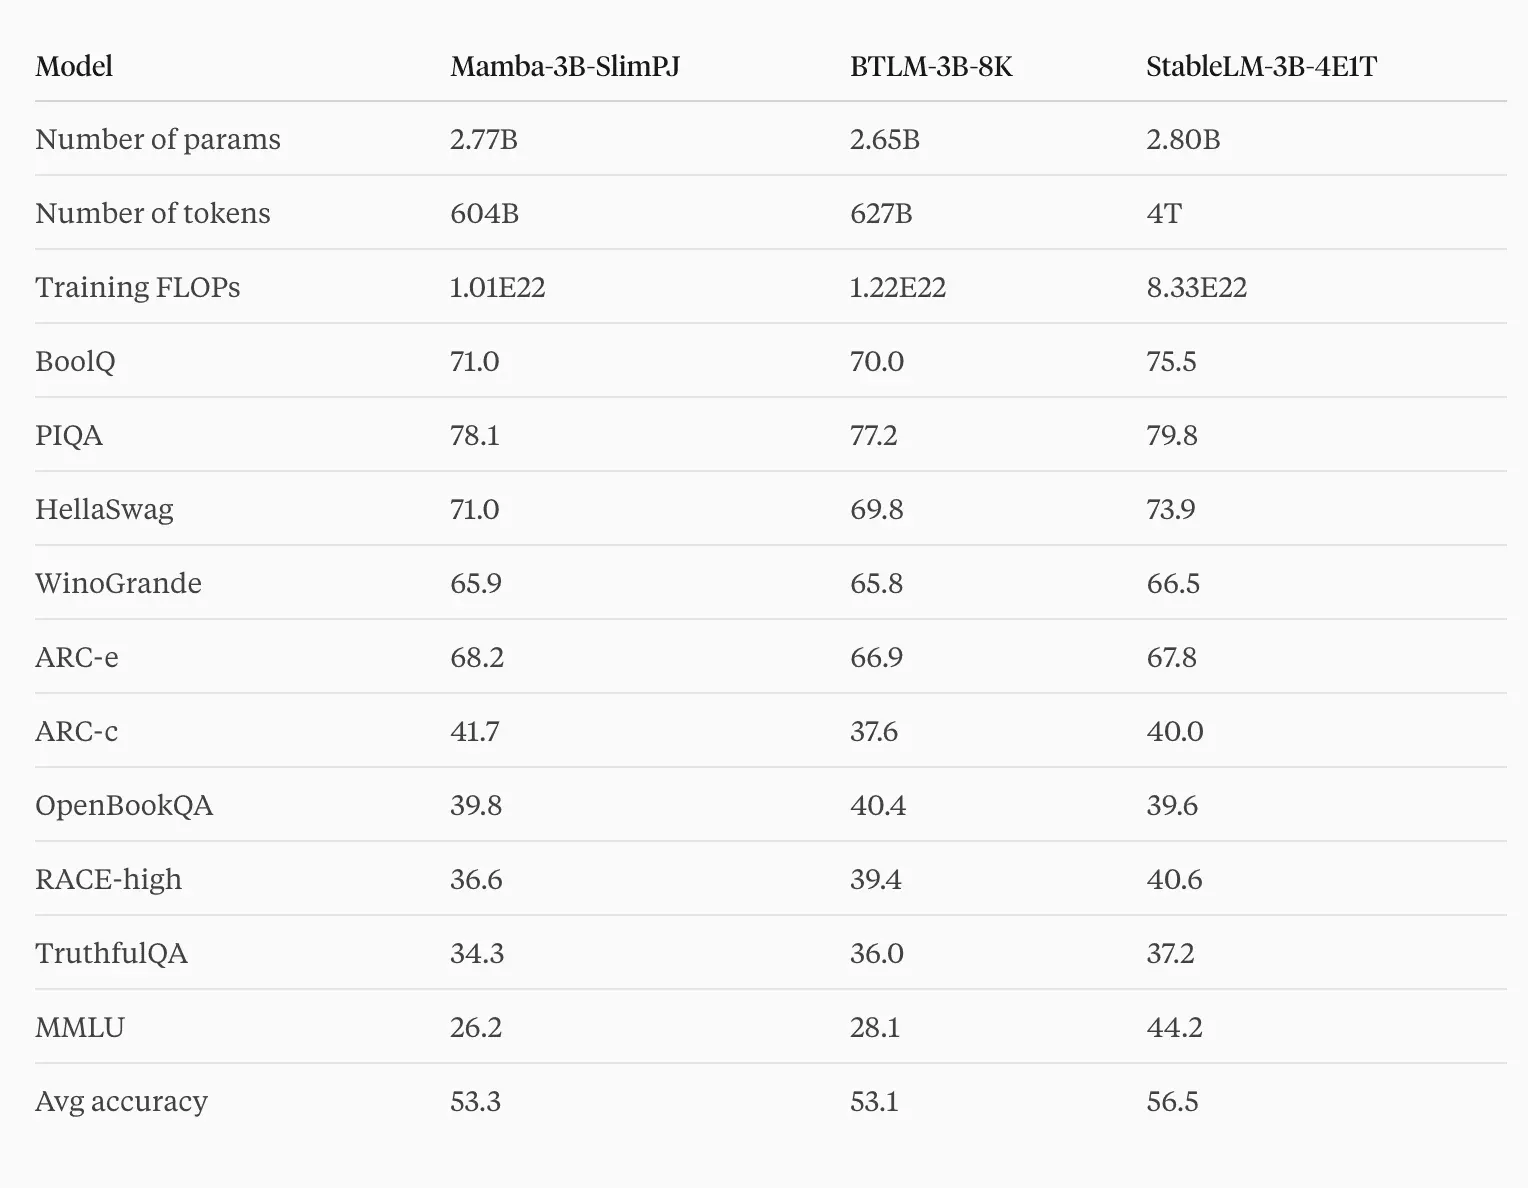
Mamba-3B-SlimPJは、600Bトークンで学習し、同じく600Bトークンで学習したBTLM-3B-8Kなど、有力な3B Transformerに匹敵する品質を、17%少ないFLOPsで達成します。BTLM-3B-8Kは、高度な学習手法を採用した強力なTransformerで、一部の7B Transformerを上回ります。この結果は、Mambaが基盤モデルの構築に有望なアーキテクチャであることを、さらに裏付けています。
学習の詳細
Mamba-3B-SlimPJは、コンテキスト長2048で600Bトークンを学習しました。300BトークンのPileで学習したMamba-3Bと同じハイパーパラメーターを使い、トークン数の増加に合わせて学習率の減衰期間だけを延長しました。データセットはSlimPajama、トークナイザーはGPT-NeoXです。SlimPajamaは、RedPajamaをクリーニングし、重複を除いたデータセットです。異なるチームがデータやモデルの成果を積み重ねていけることこそ、オープンソースAIのよさだと考えています。
評価
Mamba-3B-SlimPJは、17%少ない学習FLOPsで、BTLM-3B-8Kのような高性能なTransformerと同等の品質を達成します。一般に、データと計算量を増やすとモデルの性能は向上します。たとえば、同程度の規模で7倍のトークンを学習したStableLM-3B-4E1Tは、Mamba-3B-SlimPJやBTLM-3B-8Kを上回っています。
BTLM-3B-8Kの手順に沿って、BoolQ、PIQA、HellaSwag、WinoGrande、ARC easy、ARC challenge、OpenBookQA、RACE-high、TruthfulQA、MMLUの10タスクで評価しました。BTLM-3B-8Kが評価したSIQAとRACE-middleは、まだlm-evaluation-harnessで利用できません。MMLUのみ5-shotで、ほかはすべてzero-shotです。PIQA、HellaSwag、ARC-e、ARC-c、OpenBookQA、MMLUは正規化した正解率、BoolQ、WinoGrande、RACE-highは正解率、TruthfulQAはMC2スコアを報告します。
今後について
BTLM-3B-8KのようなTransformerでは、可変長学習やmaximal update parameterizationなど、より高度な手法を利用できます。今後、Mambaの学習でもこれらの手法を検討したいと考えています。
SSMやTransformer以外のアーキテクチャ、特にMambaへの関心が高まっていることをうれしく思います。今回の公開には、実験や理解を深めるため、またチャットモデルや指示学習モデルを構築するために、より強い基盤モデルを提供する目的があります。Mambaは、言語、音声、動画など、多様なモダリティの基盤モデルに適したアーキテクチャになり得ると考えています。
Cartesiaについて
Cartesiaでは、状態空間モデルなどの次世代アーキテクチャを使い、新しい能力を持つ基盤モデルを開発しています。AlbertがChief Scientistとして取り組みを率いています。最新の活動の確認と早期アクセスへの登録は、こちらからどうぞ。
これらのモデルをAIの最前線に届ける仕事に加わりたい方は、ぜひ一緒に働きましょう。履歴書と、ご自身の特に優れた成果の例を1段落にまとめた文章を、join@cartesia.aiへお送りください。さまざまな背景や経験を持つ方からの応募を歓迎します。
謝辞
SlimPajamaデータセットを提供したCerebras、BTLM-3B-8Kモデルを提供したCerebrasとOpenTensorに感謝します。Pileデータセットとlm-evaluation-harnessを提供するEleutherAIにも感謝します。