

Nous publions Mamba-3B-SlimPJ, le modèle de langage Mamba le plus performant à ce jour, en partenariat avec Cartesia et Together, sous licence Apache 2.0. Entraîné sur 600 milliards de tokens, Mamba-3B-SlimPJ égale les meilleurs modèles Transformer comparables à 3 milliards de paramètres, avec 17 % de FLOP d’entraînement en moins. Vous pouvez en savoir plus sur Mamba sur arXiv et trouver le code open source pour l’utiliser sur GitHub.
Téléchargez les poids sur HuggingFace.
Introduction
L’architecture Mamba s’appuie sur une longue série de travaux sur les modèles à espace d’états, comme S4, et les algorithmes efficaces sur le matériel, comme FlashAttention. Elle s’est imposée comme une concurrente sérieuse des Transformers, avec une croissance linéaire selon la longueur des séquences et une inférence rapide. Dans le cadre d’une collaboration avec Cartesia et Together, nous publions sous licence Apache 2.0 un modèle Mamba de 2,8 milliards de paramètres, entraîné sur 600 milliards de tokens du jeu SlimPajama.
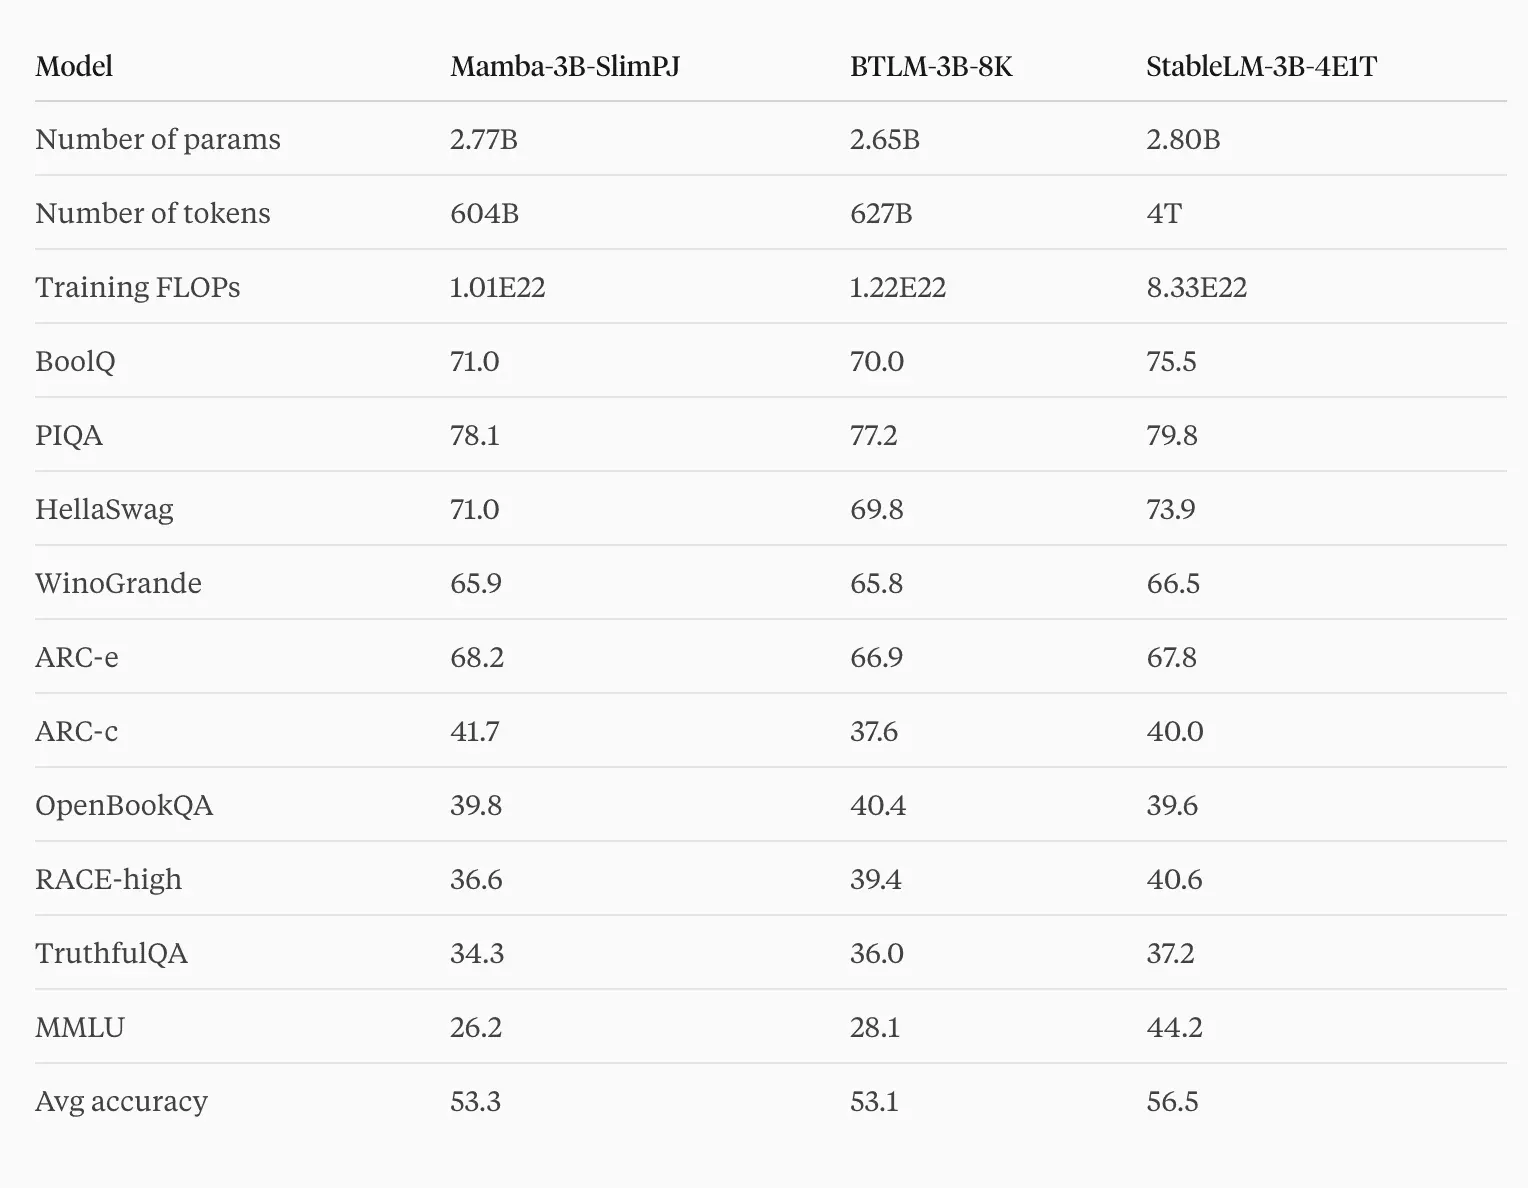
Entraîné sur 600 milliards de tokens, Mamba-3B-SlimPJ égale la qualité de certains des meilleurs Transformers à 3 milliards de paramètres, comme BTLM-3B-8K, lui aussi entraîné sur 600 milliards de tokens, avec 17 % de FLOP en moins. BTLM-3B-8K utilise une architecture Transformer performante et des techniques d’entraînement avancées qui dépassent même certains Transformers à 7 milliards de paramètres. Cela confirme le potentiel de Mamba pour construire des modèles de fondation.
Détails de l’entraînement
Nous avons entraîné Mamba-3B-SlimPJ sur 600 milliards de tokens, avec une longueur de contexte de 2048 et les mêmes hyperparamètres que Mamba-3B sur Pile, qui compte 300 milliards de tokens. Seule la décroissance du taux d’apprentissage a été prolongée pour traiter davantage de tokens. Nous utilisons le jeu SlimPajama avec le tokenizer GPT-NeoX. SlimPajama est une version nettoyée et dédupliquée de RedPajama. C’est ce que nous aimons dans l’IA open source : différents groupes s’appuient sur les travaux des autres en matière de données et de modèles.
Évaluation
Mamba-3B-SlimPJ égale la qualité de Transformers très performants comme BTLM-3B-8K avec 17 % de FLOP d’entraînement en moins. En général, davantage de données et de calcul donnent de meilleurs modèles. Par exemple, StableLM-3B-4E1T, de taille similaire mais entraîné sur sept fois plus de tokens, reste plus performant que Mamba-3B-SlimPJ ou BTLM-3B-8K.
Nous évaluons Mamba-3B-SlimPJ sur 10 tâches en suivant la procédure de BTLM-3B-8K : BoolQ, PIQA, HellaSwag, WinoGrande, ARC easy, ARC challenge, OpenBookQA, RACE-high, TruthfulQA et MMLU. SIQA et RACE-middle, évalués dans BTLM-3B-8K, ne sont pas encore disponibles dans lm-evaluation-harness. Toutes les évaluations se font sans exemple, sauf MMLU qui en utilise cinq. Nous rapportons les précisions normalisées pour PIQA, HellaSwag, ARC-e, ARC-c, OpenBookQA et MMLU, ainsi que les précisions pour BoolQ, WinoGrande, RACE-high et TruthfulQA avec le score MC2.
Perspectives
Des Transformers comme BTLM-3B-8K peuvent utiliser des techniques plus avancées, comme l’entraînement à longueur variable et la paramétrisation à mise à jour maximale. Nous souhaitons explorer ces techniques pour l’entraînement de Mamba.
Nous nous réjouissons de l’intérêt pour les SSM et les architectures au-delà des Transformers en général, et pour Mamba en particulier. Cette publication vise notamment à fournir un meilleur modèle de base pour l’expérimentation et la compréhension, ainsi que pour les modèles conversationnels et ajustés aux instructions. Nous pensons que Mamba peut être une architecture performante pour les modèles de fondation dans des modalités comme le langage, l’audio et la vidéo.
À propos de Cartesia
Chez Cartesia, nous construisons des modèles de fondation dotés de nouvelles capacités sur des architectures de nouvelle génération comme les modèles à espace d’états. Albert dirige ces efforts en tant que responsable scientifique. Vous pouvez suivre nos travaux et vous inscrire pour un accès anticipé ici.
Si vous souhaitez contribuer à placer ces modèles à l’avant-garde de l’IA, rejoignez-nous ! Envoyez à join@cartesia.ai un CV et un paragraphe décrivant un exemple de votre réalisation la plus exceptionnelle. Nous encourageons les candidatures de tous horizons et de toutes expériences.
Remerciements
Merci à Cerebras pour le jeu SlimPajama, et à Cerebras et OpenTensor pour le modèle BTLM-3B-8K. Nous remercions aussi EleutherAI pour le jeu Pile et lm-evaluation-harness.