

Lançamos Mamba-3B-SlimPJ, o modelo de linguagem Mamba mais forte até agora, em parceria com Cartesia e Together sob a licença Apache 2.0. Treinado em 600 bilhões de tokens, ele iguala o desempenho dos melhores Transformers comparáveis de 3 bilhões de parâmetros com 17% menos FLOPs de treinamento. Saiba mais sobre Mamba no arXiv e encontre o código aberto no GitHub.
Baixe os pesos no HuggingFace.
Introdução
A arquitetura Mamba, baseada em uma longa linha de pesquisa sobre modelos de espaço de estados, como S4, e algoritmos eficientes no hardware, como FlashAttention, surgiu como uma forte alternativa aos Transformers, com escala linear no comprimento da sequência e inferência rápida. Em colaboração com Cartesia e Together, lançamos um modelo Mamba de 2,8 bilhões de parâmetros treinado em 600 bilhões de tokens do SlimPajama, sob Apache 2.0.
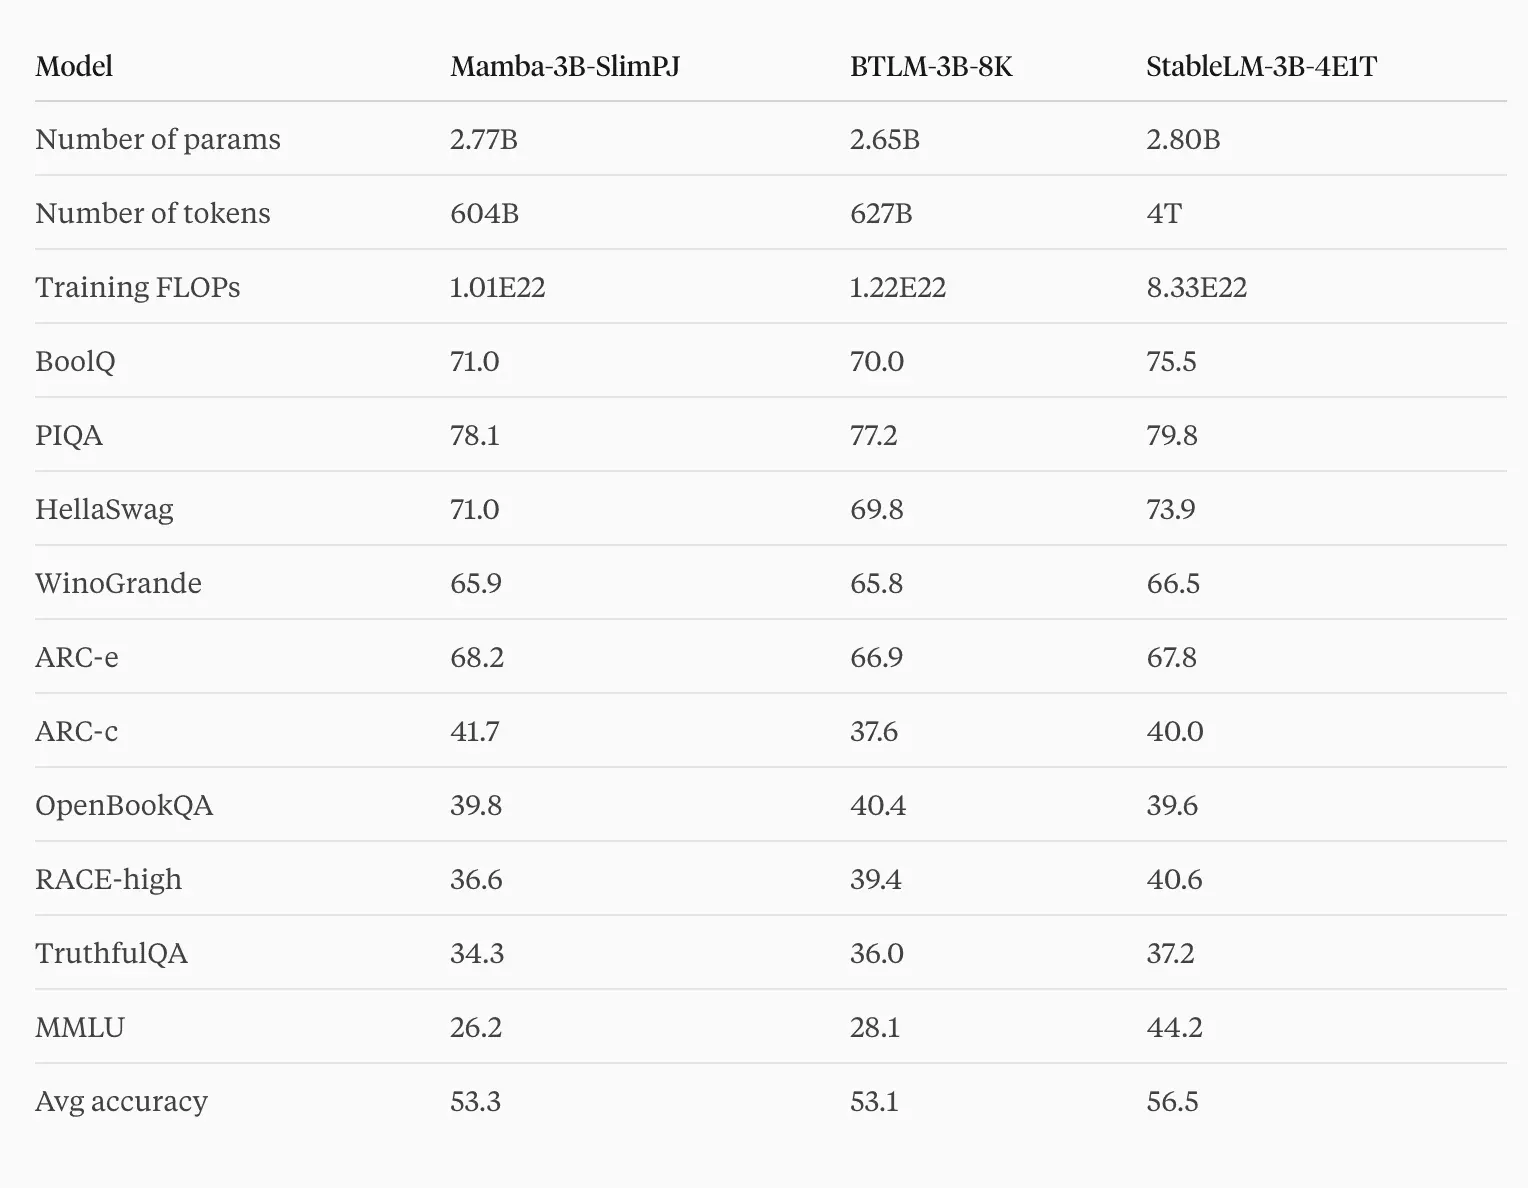
Com 600 bilhões de tokens, Mamba-3B-SlimPJ iguala alguns dos melhores Transformers de 3 bilhões de parâmetros, como BTLM-3B-8K, também treinado em 600 bilhões de tokens, com 17% menos FLOPs. BTLM-3B-8K usa uma arquitetura Transformer forte com técnicas avançadas e chega a superar alguns Transformers de 7 bilhões. Isso reforça o potencial de Mamba para modelos fundacionais.
Detalhes do treinamento
Treinamos Mamba-3B-SlimPJ em 600 bilhões de tokens, com contexto de 2048, usando os mesmos hiperparâmetros do Mamba-3B no Pile de 300 bilhões de tokens, mas com decaimento mais longo da taxa de aprendizado. Usamos SlimPajama e o tokenizador GPT-NeoX. SlimPajama é uma versão limpa e deduplicada do RedPajama. É isso que valorizamos na IA aberta: grupos construindo sobre o trabalho uns dos outros em dados e modelos.
Avaliação
Mamba-3B-SlimPJ iguala Transformers fortes como BTLM-3B-8K com 17% menos FLOPs. Em geral, mais dados e computação melhoram os modelos. Por exemplo, StableLM-3B-4E1T, de tamanho semelhante e treinado em sete vezes mais tokens, ainda supera Mamba-3B-SlimPJ e BTLM-3B-8K.
Seguimos o procedimento do BTLM-3B-8K em dez tarefas: BoolQ, PIQA, HellaSwag, WinoGrande, ARC easy, ARC challenge, OpenBookQA, RACE-high, TruthfulQA e MMLU. SIQA e RACE-middle, usadas no BTLM-3B-8K, ainda não estão no lm-evaluation-harness. Todas as avaliações são zero-shot, exceto MMLU com cinco exemplos. Informamos acurácias normalizadas para PIQA, HellaSwag, ARC-e, ARC-c, OpenBookQA e MMLU; e acurácias para BoolQ, WinoGrande, RACE-high e TruthfulQA, nesta última com o escore MC2.
Próximos passos
Transformers como BTLM-3B-8K usam técnicas avançadas, como treinamento com comprimento variável e parametrização de atualização máxima. Queremos explorá-las no treinamento de Mamba.
Ficamos felizes com o interesse em SSMs e arquiteturas além dos Transformers, especialmente Mamba. Este lançamento oferece uma base mais forte para experimentação e compreensão, além de modelos de chat e ajustados por instruções. Acreditamos que Mamba pode ser uma arquitetura forte para modelos fundacionais em linguagem, áudio e vídeo.
Sobre a Cartesia
Na Cartesia, construímos modelos fundacionais com novas capacidades em arquiteturas como SSMs. Albert lidera esse trabalho como cientista-chefe. Acompanhe e cadastre-se para acesso antecipado aqui.
Quer ajudar a levar esses modelos à linha de frente da IA? Trabalhe conosco. Envie currículo e um parágrafo sobre uma realização excepcional para join@cartesia.ai. Aceitamos candidaturas de diferentes formações e experiências.
Agradecimentos
Agradecemos à Cerebras pelo SlimPajama e à Cerebras e à OpenTensor pelo BTLM-3B-8K. Também à EleutherAI pelo Pile e pelo lm-evaluation-harness.