
올해 Cartesia는 음성 애플리케이션의 미래를 만드는 수백 명의 창업자, 제품 리더, 엔지니어와 함께했습니다. 첫 2024 State of Voice 보고서에서 산업을 발전시키는 인프라의 변화와 새 사용 사례를 살펴보고 2025년을 전망합니다.
2024년의 주요 흐름
1. 음성 상호작용을 위한 새 아키텍처 등장
2024년에는 STT → LLM → TTS 모델을 결합해 대화를 듣고 추론하고 응답하는 오케스트레이션 음성 시스템이 등장하며 대화형 음성 AI가 발전했습니다.
ChatGPT의 OpenAI Voice 모드로 음성 대 음성 기술이 현실이 되었습니다. 오디오와 텍스트로 처음부터 끝까지 사전 학습해 텍스트 토큰과 함께 오디오를 직접 이해하고 생성하는 모델입니다. 데모에서 끼어들기 처리에 어려움이 있었듯 Realtime API 구현이 아직 완전한 엔드투엔드는 아닐 수 있지만, 하나의 통합 모델로 음성 상호작용을 처리하는 중요한 단계입니다.
Kyutai의 Moshi 같은 출시로 완전한 양방향 음성 대 음성 시스템이 연구 결과물로 등장했습니다. 이 모델들은 항상 작동합니다. OpenAI 시스템과 달리 모델이 말하면서도 사용자를 들을 수 있기 때문입니다. 사용자의 오디오를 늘 스트리밍으로 받는 멀티모달 음성의 미래를 보여줍니다.
새 음성 모델 아키텍처도 실용화되었습니다. Cartesia는 자기회귀 방식으로 학습하는 새 상태 공간 모델, SSM 기반 Sonic TTS를 출시했습니다. 최근 몇 년간 널리 쓰인 어텐션 기반 Transformer와 달리 배포 환경의 유연성이 높습니다. 품질과 지연 시간 개선에 더해 메모리를 효율적으로 쓰는 온디바이스 배포가 가능해졌습니다.
2. 자연스러운 대화를 기업 규모로 제공하는 음성 AI API의 발전
2024년에는 현대 음성 에이전트 아키텍처의 세 핵심 구성 요소가 개선되면서 “영어는 1번” 같은 경직된 전화 메뉴를 자연스러운 대화로 바꿀 수 있게 되었습니다.
- 음성 인식 STT: 전사 품질이 충분히 높아져 오디오 중심 애플리케이션 설계의 표준 도구가 되었습니다. 하지만 전문 용어와 원거리 전사는 여전히 어렵습니다. 2022년 OpenAI Whisper는 다국어 오디오 680,000시간으로 학습한 오픈소스 모델로 기반을 마련했습니다. 이후 Deepgram Nova-2는 단어 오류율 WER을 30% 줄이며 2024년 상용 애플리케이션의 기준을 높였습니다.
- 대규모 언어 모델 LLM: 2024년 GPT-4o, Llama 3.2, Claude 3.5 Sonnet, Gemini 2.0 출시로 추론과 효율성이 크게 좋아졌습니다. LLM 비용은 GPT-4의 백만 토큰당 $45에서 Together AI의 Llama 3.1 70B 기준 $2.75로 크게 떨어졌습니다. 음성 모델은 이제 입력 스트리밍을 지원해 LLM의 입력을 받는 즉시 음성을 생성하면서 구간 사이 운율을 일관되게 유지합니다.
- 음성 합성 TTS: 모델이 프로덕션 수준으로 성숙하며 지연 시간이 줄고 자연스러움과 약어·숫자 같은 복잡한 내용의 정확도가 높아졌습니다. 주요 TTS 엔진은 기계적인 합성 음성을 사람 같은 발화로 바꿨습니다. SSM, Transformer, 확산 모델 같은 신경망 아키텍처, 학습 데이터의 품질과 다양성, 스트리밍·저장을 위한 디지털 오디오 인코딩과 디코딩에 필수인 오디오 코덱 최적화가 이 발전을 이끌었습니다.
음성 AI 제공업체는 초기 프로슈머와 음성 중심 스타트업을 넘어 기업의 요구에 대응했습니다. 전통적인 비동기 애플리케이션보다 엄격한 실시간 상호작용 기준을 충족하려면 시스템을 근본적으로 다시 설계해야 했습니다. 실시간 대화는 편집하거나 다시 생성할 수 없으므로 가동 시간 보장, 정확한 동시 통화 처리, 안정성이 필요합니다. 제공업체는 맞춤 SLA, 최대 부하에 맞춘 동적 확장, 보안 인증, 규제가 강한 산업용 자체 호스팅 옵션을 추가했습니다. 초기에는 드물었던 기능들이 기술의 성숙과 함께 표준이 되었습니다.
3. 맞춤 음성 에이전트를 만들고 테스트하고 프로덕션에 배포하기 쉬워진 플랫폼
오늘날 대부분의 음성 에이전트는 STT, LLM 추론, TTS로 이루어진 대화 파이프라인을 사용합니다.
이 파이프라인은 자연스러운 대화를 만들지만 직접 구축하기는 어렵습니다. 실시간 오디오 스트림, 모델 지연 시간, 발화 순서, 자연스러운 전환을 관리해야 합니다. 엔지니어링 팀이 보통 6~12개월 걸려 만드는 것을 음성 오케스트레이션 플랫폼으로는 몇 주 안에 구현할 수 있습니다. 플랫폼이 복잡한 부분을 추상화하므로 개발자는 좋은 구성 요소를 조합하며 사용자 경험에 집중할 수 있습니다.
LiveKit과 Daily는 WebRTC 스택으로 실시간 AI 모델을 낮은 지연 시간으로 연결하는 오픈소스 구성 요소를 개발했습니다. 전 세계에서 안정적으로 작동하면서 개발자가 전체 스택을 맞춤화할 수 있는 인프라입니다.
Vapi, Retell, Bland, Thoughtly 같은 음성 에이전트 오케스트레이션 플랫폼은 RAG 기반 지식 베이스와 도구 호출 등 고급 기능을 갖춘 맞춤 에이전트를 빠르게 배포하게 합니다. 발화자 전환을 제어하는 VAD, 감정 인식, 끼어들기 처리, 소음 필터링 모델로 자연스러운 대화를 지원합니다.
Hamming, Coval, Vocera, Canonical 같은 새 관측 플랫폼은 음성 에이전트의 품질을 대규모로 시뮬레이션하고 측정하는 평가 도구를 만들었습니다.
4. 모든 산업에 등장한 음성 에이전트
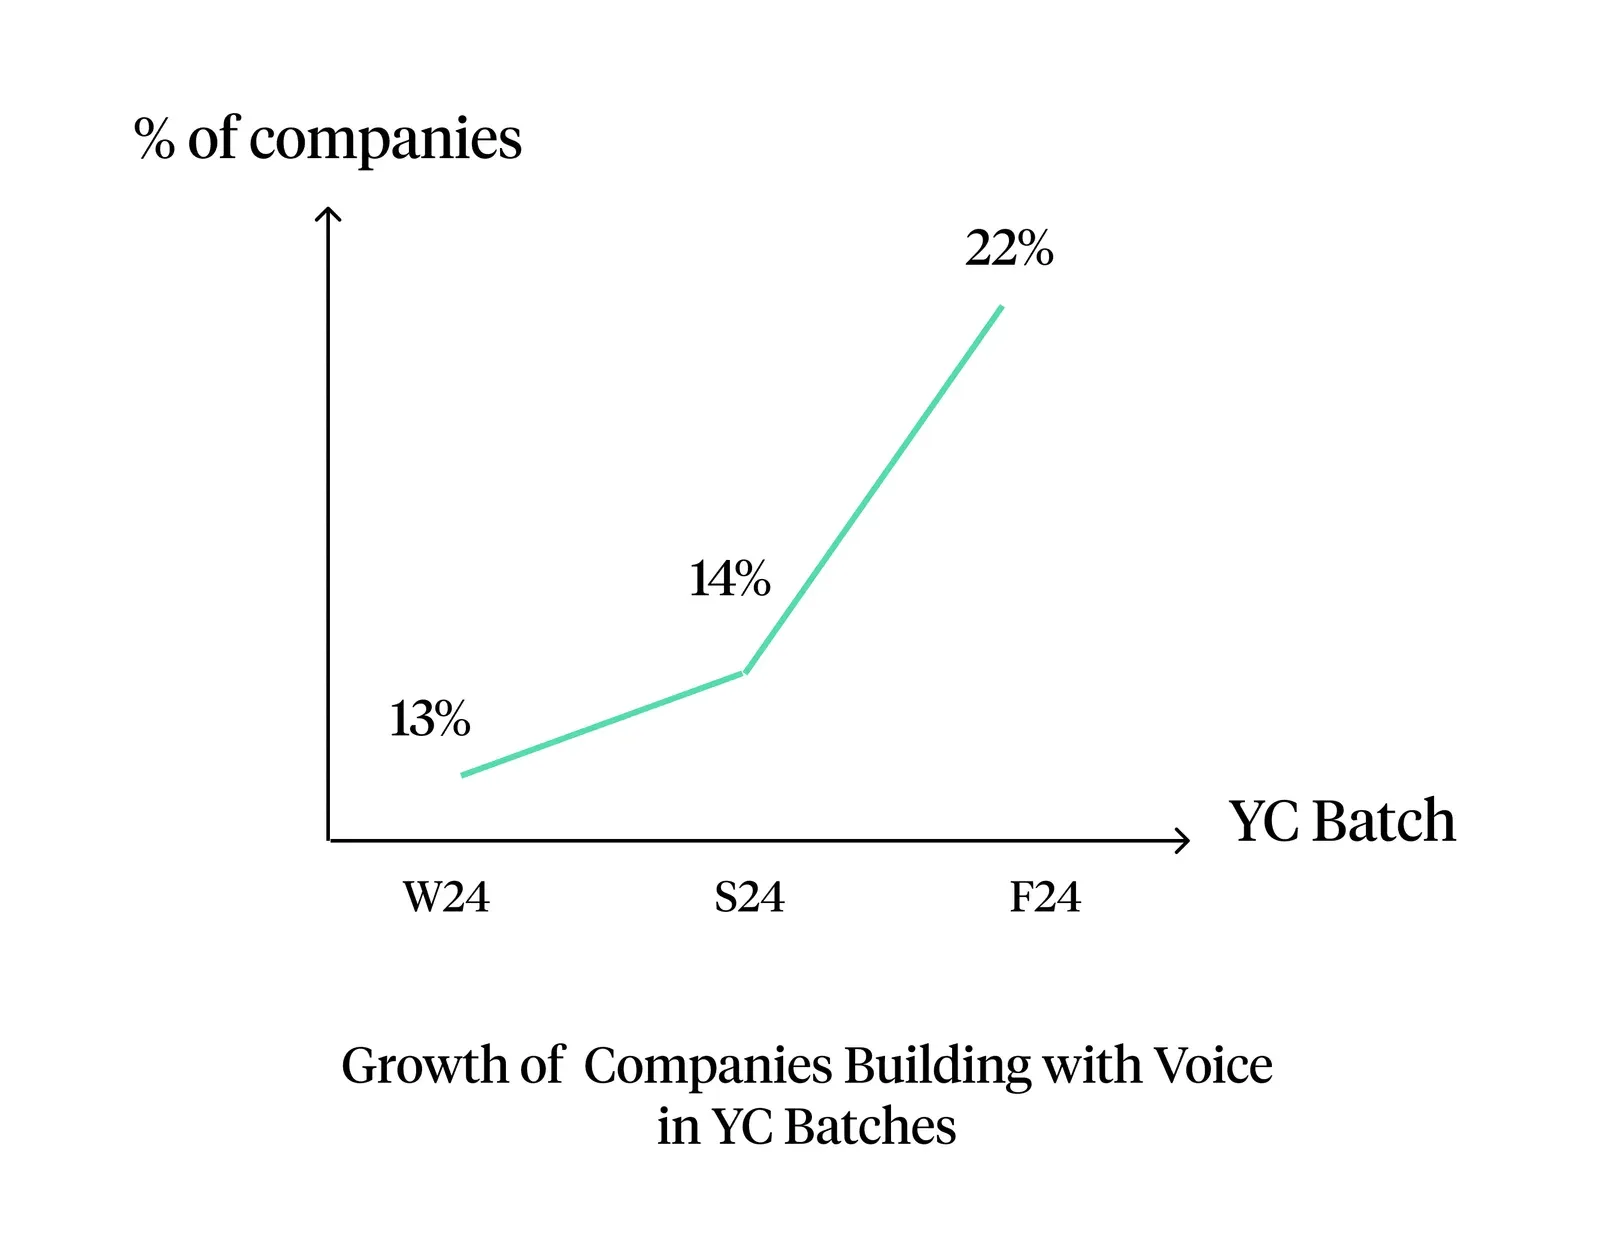
산업별 음성 에이전트 스타트업이 빠르게 성장했습니다. Y Combinator에서도 겨울 기수와 가을 기수 사이 음성 중심 기업 수가 70% 늘었습니다. 초기 도입은 24시간 고객 운영이나 계절성 수요 급증처럼 인력이 부족했던 서비스의 처리 용량을 늘리는 데 집중했습니다.
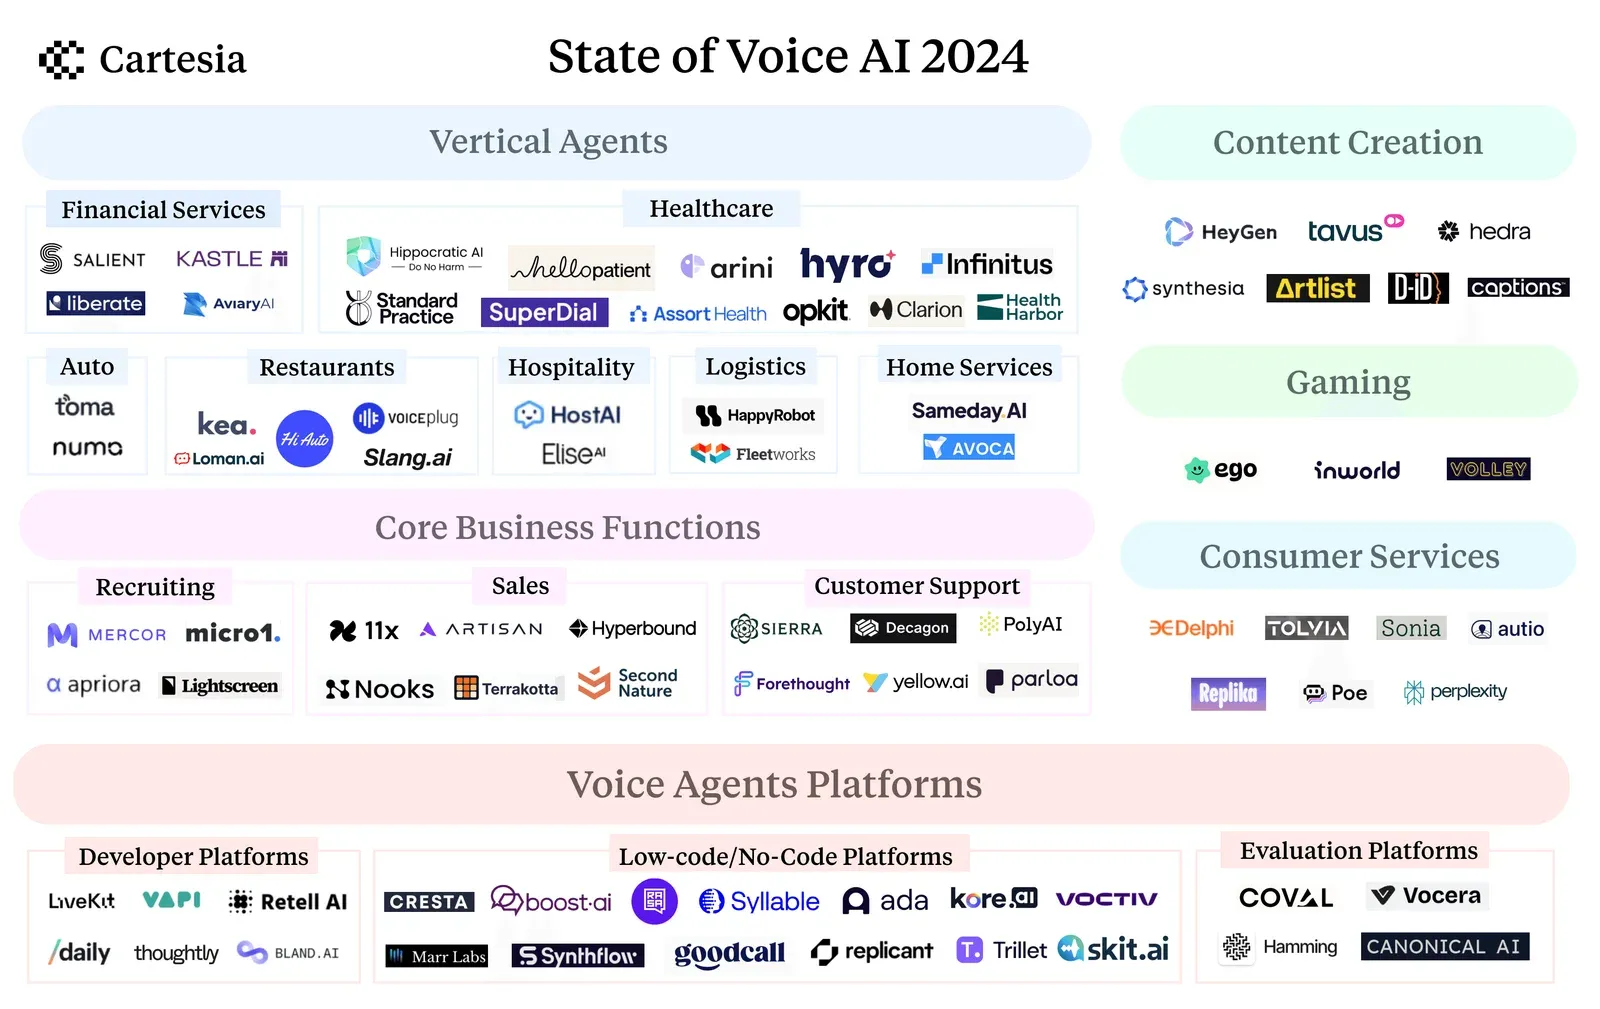
- 대출 관리: Salient와 Kastle의 에이전트는 대출 관리, 상환, 휴면 계정 재활성화, 금융 상품 교차 판매를 지원하며 PII 같은 민감한 데이터를 높은 규정 준수 기준으로 처리합니다.
- 보험: Liberate와 Skit의 에이전트는 24시간 청구 처리, 보험 갱신, 보장 옵션 설명을 담당합니다.
- 의료: Abridge는 의료 기록 보조 인력 수요에 대응해 2019년 의료 전사를 도입했습니다. 이제 Hello Patient, Hippocratic, Assort Health, Superdial 덕분에 세계 각지 병원이 환자 정보를 보호하면서 예약, 복약 알림, 청구 문의를 위한 AI 비서를 도입합니다.
- 물류: 화물 중개업체, 제3자 물류업체 3PL, 운송사는 Happy Robot과 Fleetworks로 확인 전화, 화물 업데이트, 결제 상태, 예약을 관리합니다.
- 서비스업: 호텔용 Host AI의 옴니채널 AI 비서부터 Nowadays의 AI 행사 기획자까지 사용 사례가 다양합니다. Elise AI의 비서와 CRM은 임대 문의, 유지보수, 갱신을 함께 처리합니다.
- 중소기업: 운영 여력 때문에 전화의 60%를 놓치는 소규모 프랜차이즈도 Goodcall로 인바운드 전화용 AI 에이전트를 쉽게 설정합니다. Slang은 식당용 솔루션을 제공하고, Numa는 자동차 판매점 CRM과 연결해 과거 상호작용 데이터로 고객 유지를 돕습니다. Avoca는 HVAC, 배관 등 현장 서비스에 24시간 AI 콜센터를 제공합니다.
5. 핵심 업무를 돕는 음성 에이전트
표준화된 업무 프로세스에도 음성 에이전트가 등장했고 다음 세 분야에서 많이 도입되었습니다.
- 채용: Mercor와 Micro1 같은 AI 면접관은 전화·영상 면접을 진행하며 지원자 배경에 맞는 질문으로 기존 지원서 검토보다 깊이 있는 정보를 제공합니다.
- 영업: 이메일 효과가 줄어들면서 11x, Artisan, Nooks는 잠재 고객 발굴과 선별을 위한 AI SDR로 전화 영업을 활성화합니다. Hyperbound 같은 플랫폼은 AI 역할극으로 영업 상황을 재현해 담당자의 역량을 높입니다.
- 고객 지원: Sierra, Decagon, Forethought, Parloa, Poly 같은 AI 고객 경험 플랫폼은 여전히 전화로 이루어지는 많은 고객 지원 상호작용을 위해 음성 기능을 추가합니다.
6. 상호작용하는 캐릭터로 풍부해진 엔터테인먼트와 미디어
- 콘텐츠 제작: Heygen, Tavus, D-ID, Synthesia, Hedra 같은 AI 아바타 플랫폼은 하나의 디지털 복제로 내레이션 영상을 무제한 생성해 마케팅, 교육, 훈련 콘텐츠 제작을 바꿉니다. Capcut, Canva, Adobe, Captions는 AI 음성을 직접 통합하고, Time과 The New York Times는 기사에 AI 내레이션을 도입해 전문가 수준의 제작을 더 쉽게 만듭니다.
- 게임: 스튜디오는 플레이어의 행동에 실시간으로 반응하는 NPC로 몰입감을 높입니다. Ego와 Inworld는 AI 캐릭터가 자연스럽게 대화하는 3D 세계를 만들게 하며, 실시간 음성 변환기는 플레이어 목소리를 게임 캐릭터에 맞춥니다.
- 소비자 서비스: 인플루언서와 유명인은 Delphi로 수천 명의 팬과 동시에 소통하고, 코치와 치료사는 Sonia 같은 플랫폼으로 24시간 맞춤 안내를 제공합니다. Duolingo와 Khan Academy는 AI 음성 튜터로 범위를 넓히고, Google NotebookLM은 누구나 기사와 책의 오디오 요약을 만들게 합니다. Replika와 Character AI는 다양한 사용자에게 항상 함께할 수 있는 동반자를 제공하며, Tolvia는 고령층에 집중합니다. Quora의 Poe와 Perplexity의 음성 대 음성 기능으로 LLM 콘텐츠도 음성으로 널리 이용할 수 있습니다.
2025년 전망
1. 음성 대 음성 모델의 대중화
음성 대 음성 S2S 모델은 텍스트 표현을 거치지 않고 음성 입력을 바로 음성 출력으로 바꿉니다. 2024년에 여러 모델이 등장했지만 2025년에는 기존 STT→LLM→TTS 파이프라인이 어려워하던 세 분야의 역량으로 본격적으로 확산될 것으로 예상합니다.
- 지연 시간: 현재 최고 수준의 음성 에이전트는 Deepgram STT 100ms, GPT-4 320ms, Cartesia TTS 90ms를 합친 약 510ms로, 사람 대화의 약 230ms와 차이가 큽니다. 올해 나온 Moshi 같은 초기 S2S 모델은 단일 단계 처리로 160ms 가능성을 보여주지만, 사용자가 말을 끝내기 전에 응답하지 않도록 하는 장치가 더 필요합니다.
- 문맥 이해: S2S는 같은 모델이 음성을 직접 처리하고 이해하고 생성합니다. 텍스트 변환에서 보통 사라지는 감정, 어조, 운율 같은 비언어적 요소를 유지합니다. 기존 시스템은 이런 정보를 구성 요소 간 메타데이터로 전달하려 하지만 통합 S2S가 대화의 뉘앙스를 더 잘 담을 것입니다. 주요 장벽인 연산 비용을 해결하면 성능과 효율성 모두 개선될 것입니다.
- 끼어들기 처리: S2S는 엄격한 발화 순서 대신 겹치는 음성 스트림을 병렬 처리할 수 있습니다. 하지만 현재 시스템은 자신의 발화 인식, 제한된 문맥 창, 겹친 오디오 처리에 어려움이 있습니다. 2025년에 크게 개선될 것으로 예상합니다.
2. 더 복잡한 다단계 작업을 맡고 산업 전반의 업무에 깊이 들어갈 음성 에이전트
2024년은 예측 가능한 순서의 기본 선별과 초과 수요 처리를 주로 맡은 초기 테스트 단계였습니다. 블라인드 A/B 테스트에서 통화 시간, 해결률, 매출 회수율, 고객 만족도 CSAT 같은 지표가 좋아지면서 기업은 AI 음성 상호작용을 신뢰하게 되었습니다. 식당 예약, 진료 예약, 청구서 납부, DMV 업무까지 음성 AI는 소비자가 기업과 일상적으로 소통하는 주요 인터페이스가 될 준비를 하고 있습니다.
예를 들어 항공편을 변경하려고 전화하면 AI 에이전트가 RAG로 승객 기록, 좌석 현황, 항공사 정책에 즉시 접근해 처음부터 끝까지 처리하는 모습을 생각해 보세요. 기다리거나 부서를 옮길 필요 없이 예약 확인, 대안 검색, 정책 적용, 변경 처리를 자연스러운 대화와 동시에 할 수 있습니다. 기업은 지식 베이스로 LLM을 파인튜닝하듯 전사와 TTS 모델도 분야별 사전과 회사 스타일에 맞춰 조정해 신뢰를 높이고 싶을 수 있습니다. 복잡한 일을 끝까지 해결하는 AI에 대한 신뢰는 통화 길이 대신 성공적인 작업 해결률에 연동한 성과 기반 가격 모델에도 나타납니다.
3. 어디서든 대화할 수 있게 하는 소형 온디바이스 모델
소형 온디바이스 AI는 인터넷 없이 실행되고, 로컬 처리로 지연 시간을 줄이며, 데이터를 기기에 두어 개인정보를 지키는 세 가지 문제를 해결합니다. 외딴곳의 차량이나 통신이 닿지 않는 현장 작업자처럼 이런 조건이 필수인 곳에서 음성 AI를 사용할 수 있습니다.
새 아키텍처, 양자화와 증류 기법이 성숙하고 전용 엣지 AI 칩이 널리 보급되면서 2025년은 온디바이스 음성 AI가 본격 성장하는 해가 될 것으로 예상합니다. 로컬 처리가 프로덕션 규모에서도 실용화될 것입니다. TensorFlow Lite와 PyTorch Edge 같은 프레임워크는 배포와 최적화를 쉽게 하며 이미 이 변화를 가속하고 있습니다.
4. 음성의 모든 측면을 세밀하게 제어하기
2024년에는 감정적 어조, 속도, 정확한 발음처럼 합성 음성의 세부 제어가 발전했습니다. 이런 기능은 음성을 넘어 다른 AI 모달리티와의 조율로 확장되고 있습니다. 예를 들어 현재 멈춤이나 철자를 지정하는 Speech Synthesis Markup Language, SSML을 통해 음성의 감정 신호가 디지털 아바타의 몸짓과 표정으로 이어질 수 있습니다. 크리에이터는 기존 오디오에 AI가 생성한 단어나 장면을 삽입하고 주변의 스타일과 타이밍을 자동으로 따르게 할 수 있을 것입니다.
앞으로
초기 실험에서 프로덕션용 시스템으로 성숙하면서 2025년의 음성 AI는 산업 전반에서 더 뛰어난 기능, 맞춤화, 접근성을 제공할 것입니다.