
Este año en Cartesia hemos tenido la suerte de trabajar con cientos de fundadores, responsables de producto e ingenieros que están definiendo el futuro de las aplicaciones de voz. En nuestro primer informe sobre el estado de la voz en 2024 repasamos los principales avances de infraestructura y los nuevos casos de uso que impulsan el sector, y anticipamos lo que llegará en 2025.
Principales tendencias de 2024
1. Surgieron nuevas arquitecturas para las interacciones por voz
En 2024, la IA conversacional de voz avanzó con los sistemas orquestados que combinan modelos STT → LLM → TTS para escuchar, razonar y responder.
La tecnología de voz a voz se hizo realidad con el modo de voz de ChatGPT de OpenAI. Introdujo modelos preentrenados de extremo a extremo con audio y texto, capaces de comprender y generar audio de forma nativa, además de tokens de texto. Aunque la implementación mediante Realtime API quizá aún no sea completamente de extremo a extremo, como sugieren sus problemas al gestionar interrupciones en la demostración, supone un paso hacia modelos únicos para las interacciones de voz.
Los sistemas de voz a voz completamente dúplex aparecieron como resultados de investigación con lanzamientos como Moshi de Kyutai. Están siempre activos: a diferencia del sistema de OpenAI, pueden escuchar mientras hablan. Anticipan un futuro de voz multimodal en el que los modelos reciben audio del usuario de forma continua.
También se hicieron viables nuevas arquitecturas de habla. Cartesia lanzó Sonic TTS, basado en una arquitectura de modelos de espacio de estados, o SSM, entrenada de forma autorregresiva. Estas arquitecturas se apartan de los Transformers basados en atención que se han popularizado en los últimos años y ofrecen más flexibilidad de despliegue. Ahora permiten ejecutarse en el dispositivo con un uso eficiente de memoria y mejoras de calidad y latencia.
2. Las API de voz con IA avanzaron para permitir conversaciones naturales a escala empresarial
En 2024, las mejoras en tres componentes básicos permitieron sustituir menús rígidos de “pulse 1 para inglés” por conversaciones naturales.
- Voz a texto, STT: la transcripción ya es suficientemente buena para ser una herramienta habitual al diseñar aplicaciones nativas de audio. Aun así, la terminología especializada y el habla captada a distancia siguen planteando dificultades. En 2022, Whisper de OpenAI sentó las bases con un modelo abierto entrenado con 680.000 horas de audio multilingüe. Después, Nova-2 de Deepgram elevó el nivel con una reducción del 30 % en la tasa de error de palabras, WER, y nuevos resultados de referencia para aplicaciones comerciales en 2024.
- Modelos de lenguaje grandes, LLM: GPT-4o, Llama 3.2, Claude 3.5 Sonnet y Gemini 2.0 mejoraron el razonamiento y la eficiencia en 2024. Los costes bajaron de 45 dólares por millón de tokens con GPT-4 a 2,75 dólares con Llama 3.1 70B en Together AI. Los modelos de habla ya admiten entradas en streaming y generan audio mientras reciben texto de un LLM, manteniendo una prosodia coherente entre segmentos.
- Texto a voz, TTS: los modelos han alcanzado madurez para producción, con menor latencia, más naturalidad y mayor exactitud ante acrónimos y expresiones numéricas. Los principales motores han pasado de voces robóticas a habla similar a la humana. Este avance procede de nuevas arquitecturas de redes neuronales, como SSM, Transformers y modelos de difusión, de datos de entrenamiento mejores y más diversos, y de códecs de audio optimizados para codificar y decodificar audio digital con eficiencia.
Los proveedores también ampliaron su enfoque inicial en usuarios profesionales individuales y startups de voz para atender a empresas. Hubo que rediseñar los sistemas para cumplir requisitos de interacción en tiempo real más exigentes que los de las aplicaciones asíncronas. Las conversaciones en directo no se pueden editar ni regenerar; la infraestructura necesita disponibilidad garantizada, gestión impecable de llamadas simultáneas y fiabilidad. Los proveedores añadieron SLA personalizables, escalado dinámico para picos de volumen, certificaciones de seguridad y opciones de alojamiento propio para sectores regulados. Estas funciones, raras al principio, se han vuelto habituales.
3. Nuevas plataformas facilitaron crear, probar y desplegar agentes personalizados en producción
La mayoría de los agentes actuales utilizan un proceso de voz a texto, razonamiento con LLM y texto a voz.
Aunque permite conversaciones naturales, construirlo internamente exige gestionar flujos de audio en tiempo real, latencias de modelos, turnos y transiciones. Lo que suele llevar entre 6 y 12 meses a un equipo puede implementarse en semanas con plataformas de orquestación de voz. Estas ocultan parte de la complejidad y permiten centrarse en la experiencia, combinando los componentes más adecuados.
LiveKit y Daily desarrollaron componentes abiertos de orquestación optimizada para latencia entre modelos de IA en tiempo real mediante WebRTC. Su infraestructura ofrece rendimiento fiable a escala mundial y permite personalizar toda la aplicación.
Surgieron plataformas como Vapi, Retell, Bland y Thoughtly para desplegar agentes personalizados rápidamente, con bases de conocimiento mediante RAG y llamadas a herramientas. También ofrecen detección de actividad vocal, VAD, para controlar cambios de hablante, reconocimiento de emociones, gestión de interrupciones y filtrado de ruido.
Nuevas plataformas de observabilidad, como Hamming, Coval, Vocera y Canonical, crearon conjuntos de evaluación para simular y medir la calidad de los agentes a escala.
4. Aparecieron agentes de voz en todos los sectores
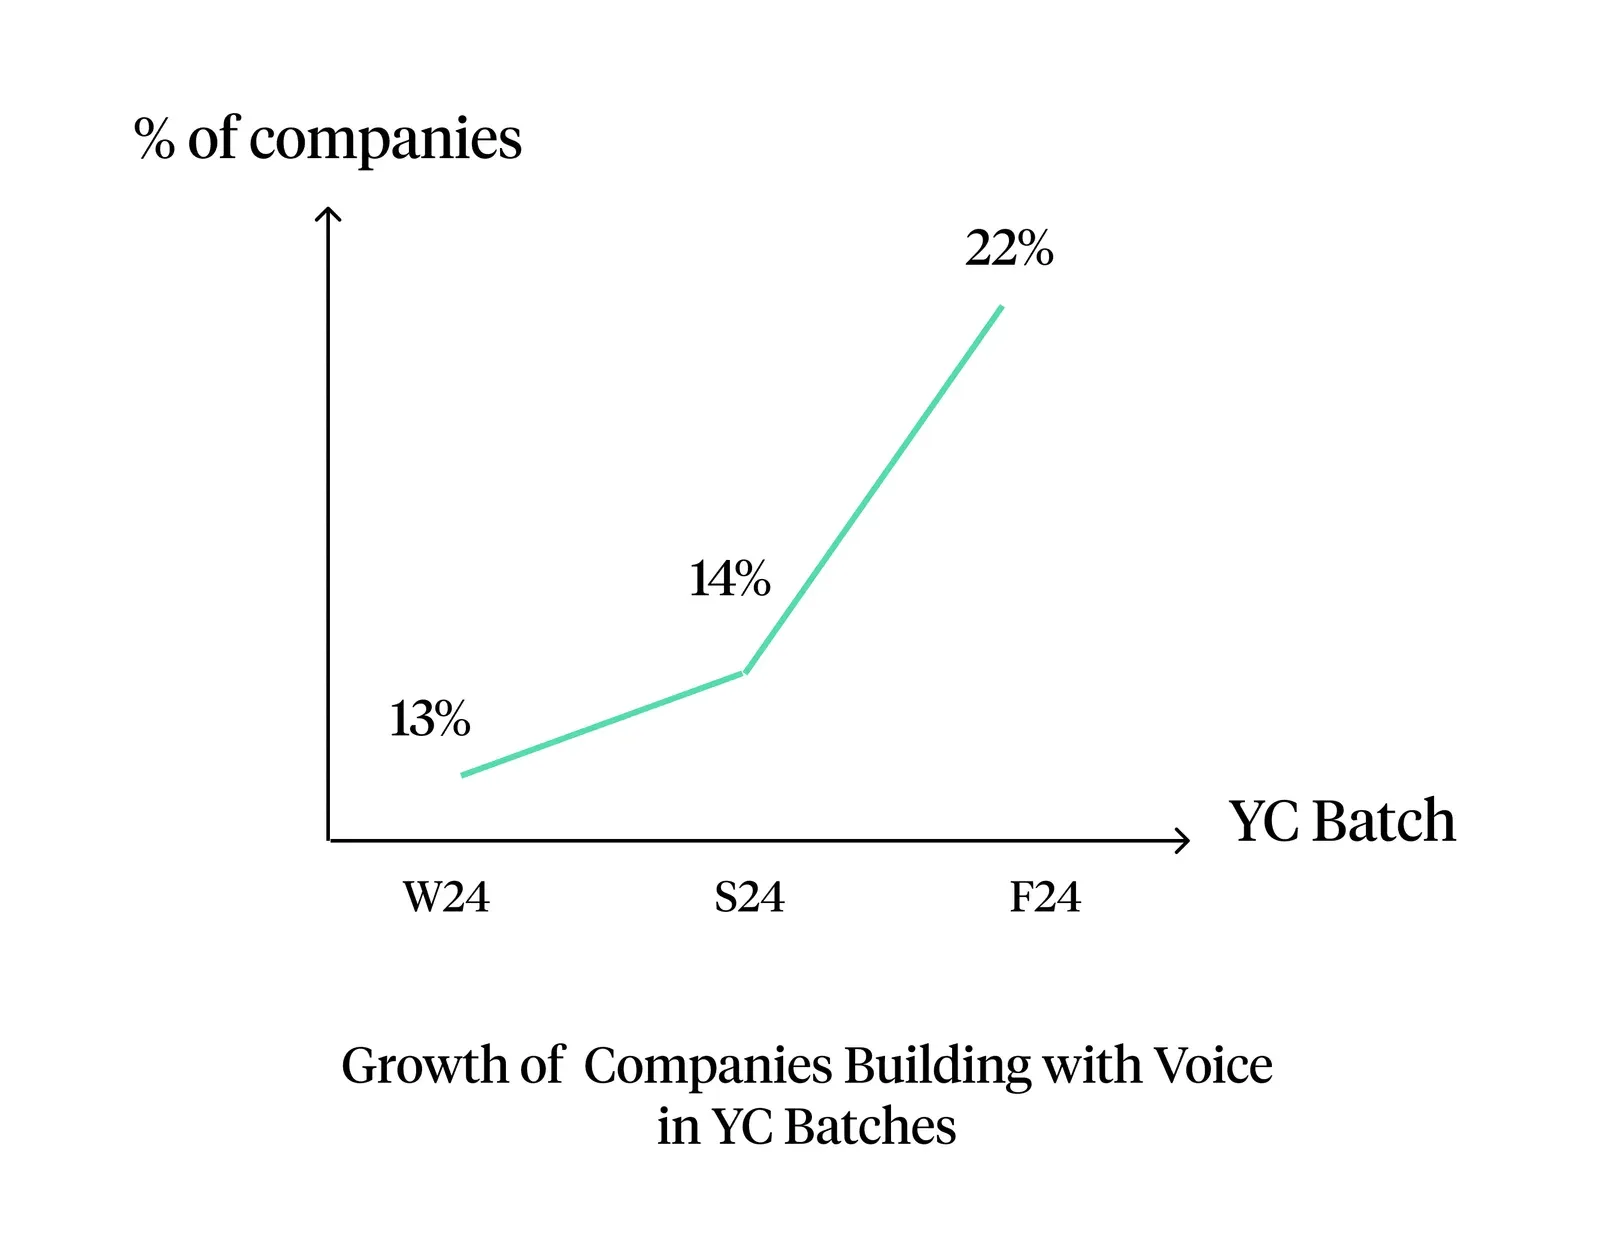
Las startups de agentes especializados crecieron rápidamente. En Y Combinator, el número de empresas nativas de voz aumentó un 70 % entre las promociones de invierno y otoño. La adopción inicial amplió la capacidad de servicios con poco personal, como atención al cliente 24/7 y picos estacionales.
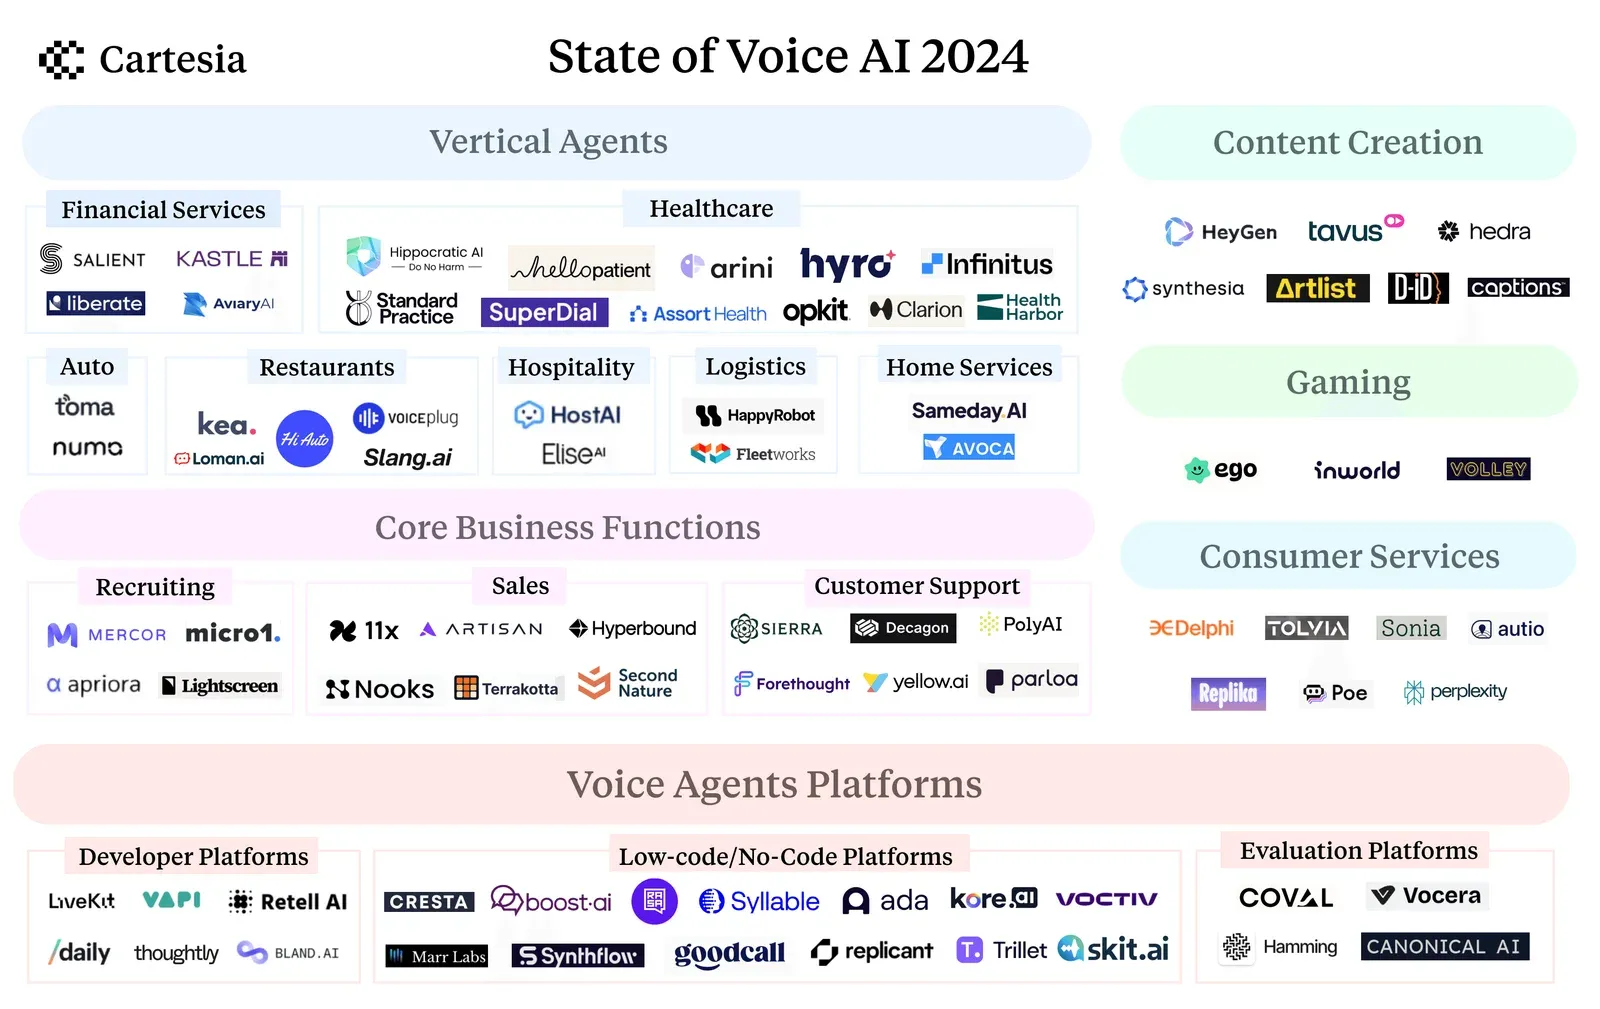
- Gestión de préstamos: los agentes de Salient y Kastle ayudan a administrar préstamos, gestionar pagos y contactar para reactivar cuentas inactivas o vender otros productos financieros, manteniendo altos estándares para datos sensibles como la información personal identificable.
- Seguros: los agentes de Liberate y Skit tramitan siniestros 24/7, renuevan pólizas y explican las coberturas.
- Sanidad: Abridge introdujo la transcripción sanitaria en 2019 ante la demanda de escribas médicos. Ahora, gracias a Hello Patient, Hippocratic, Assort Health y Superdial, clínicas de todo el mundo usan asistentes para citas, recordatorios de medicación y consultas de facturación, protegiendo la información del paciente.
- Logística: intermediarios de transporte, operadores logísticos 3PL y transportistas utilizan Happy Robot y Fleetworks para llamadas de seguimiento, actualizaciones de carga, estado de pagos y programación de citas.
- Hostelería e inmuebles: los casos abarcan el asistente omnicanal para hoteles de Host AI y el planificador de eventos de Nowadays. El asistente y CRM de Elise AI trabajan juntos en consultas de alquiler, mantenimiento y renovaciones.
- Pymes: Goodcall permite a pequeñas franquicias configurar agentes para atender llamadas entrantes, dado que sus propietarios pierden el 60 % por falta de capacidad. Slang ofrece soluciones para restaurantes y Numa se integra con CRM de concesionarios para usar interacciones previas en la retención de clientes. Avoca ofrece centros de llamadas con IA 24/7 para climatización, fontanería y otros servicios a domicilio.
5. Los agentes de voz agilizaron funciones empresariales básicas
También se adoptaron en procesos estandarizados, especialmente en tres áreas:
- Selección de personal: entrevistadores con IA como Mercor y Micro1 realizan entrevistas telefónicas y por vídeo. Usan la trayectoria de cada candidato para formular preguntas relevantes y aportar más información que el filtrado tradicional de solicitudes.
- Ventas: ante la menor eficacia del correo electrónico, 11x, Artisan y Nooks recuperan la venta telefónica mediante agentes SDR de IA para prospección y cualificación. Hyperbound simula situaciones comerciales para entrenar a los vendedores mediante juegos de rol con IA.
- Atención al cliente: plataformas como Sierra, Decagon, Forethought, Parloa y Poly incorporan voz para atender el gran volumen de interacciones que siguen ocurriendo por teléfono.
6. La voz con IA mejoró el entretenimiento y los medios mediante personajes interactivos
- Creación de contenidos: plataformas de avatares como Heygen, Tavus, D-ID, Synthesia y Hedra permiten generar vídeos narrados ilimitados a partir de un clon digital para marketing, formación y educación. Capcut, Canva, Adobe y Captions integran voces de IA, mientras Time y The New York Times adoptan narración de artículos. Esto amplía el acceso a la producción de calidad profesional.
- Videojuegos: los estudios crean personajes no jugables dinámicos que se adaptan en tiempo real. Ego e Inworld permiten crear mundos 3D en los que personajes de IA conversan naturalmente con jugadores. Los cambiadores de voz en tiempo real permiten adaptar la voz del jugador a su personaje.
- Servicios al consumidor: los creadores y proveedores pueden ampliar su alcance. Con Delphi, influencers y famosos interactúan con miles de seguidores simultáneamente. Plataformas como Sonia ofrecen orientación personalizada 24/7 de entrenadores y terapeutas. Duolingo y Khan Academy amplían su alcance con tutores de voz de IA, y NotebookLM de Google genera resúmenes de audio de artículos y libros. Replika y Character AI ofrecen compañeros siempre disponibles; Tolvia se centra en personas mayores. Poe de Quora y la función de voz a voz de Perplexity permiten acceder al contenido de los LLM mediante voz.
Qué esperamos de 2025
1. Los modelos de voz a voz se generalizarán
Los modelos de voz a voz, S2S, convierten directamente habla de entrada en habla de salida, sin pasar por una representación textual. Aunque aparecieron varios en 2024, esperamos que despeguen en 2025 al demostrar sus capacidades en tres aspectos que dificultan los sistemas STT→LLM→TTS:
- Latencia: los mejores agentes actuales alcanzan unos 510 ms, con 100 ms de Deepgram STT, 320 ms de GPT-4 y 90 ms de Cartesia TTS. Siguen lejos de los aproximadamente 230 ms de una conversación humana. Modelos S2S tempranos como Moshi, publicado este año, muestran potencial para 160 ms gracias al procesamiento en un paso, aunque necesitan evitar responder antes de que el usuario termine.
- Comprensión del contexto: un mismo modelo procesa, comprende y genera habla directamente. Así conserva emoción, tono y prosodia, que suelen perderse al convertir a texto. Los sistemas actuales intentan transmitir esa información como metadatos; el procesamiento S2S unificado captará mejor los matices. El principal obstáculo sigue siendo el coste de cómputo. Al resolverlo mejorarán el rendimiento y la eficiencia.
- Gestión de interrupciones: en vez de imponer turnos estrictos, los modelos S2S pueden procesar habla superpuesta en paralelo. Los sistemas actuales aún tienen problemas para reconocer su propia voz, manejar contextos limitados y procesar audio solapado. Esperamos mejoras importantes en 2025.
2. Los agentes asumirán tareas más complejas y de varios pasos, y se integrarán más en los procesos de todos los sectores
En 2024 comenzó una fase de pruebas, con agentes dedicados principalmente a llamadas excedentes y filtrados básicos de turnos previsibles. Las pruebas A/B ciegas mostraron mejores métricas de duración, resolución, recuperación de ingresos y satisfacción del cliente. Las empresas ganaron confianza. La voz con IA está preparada para convertirse en la interfaz principal de muchas relaciones cotidianas entre consumidores y empresas, desde reservar restaurantes y citas médicas hasta pagar facturas o realizar trámites de vehículos.
Imagina llamar a una aerolínea para cambiar una reserva y que un agente resuelva todo mediante generación aumentada por recuperación, RAG, accediendo al instante a registros de pasajeros, disponibilidad y políticas. Evitaría esperas y transferencias entre departamentos. La IA podría comprobar reservas, buscar alternativas, aplicar políticas y procesar cambios mientras mantiene una conversación natural. Igual que se ajusta un LLM con una base de conocimiento, las empresas pueden querer ajustar modelos de transcripción y TTS a su vocabulario y estilo. La creciente confianza en resolver tareas completas ya se refleja en precios basados en resultados satisfactorios en lugar de duración de llamada.
3. Los modelos compactos en el dispositivo permitirán conversaciones locales en cualquier lugar
Estos modelos ganan terreno al resolver tres problemas: funcionan sin internet, reducen la latencia mediante procesamiento local y mantienen los datos en el dispositivo. Permiten usar voz con IA donde esas condiciones son imprescindibles, desde vehículos en zonas remotas hasta trabajadores en lugares sin señal.
Esperamos que 2025 sea el año de despegue de la voz con IA en el dispositivo. Madurarán las nuevas arquitecturas, la cuantización y la destilación, y se generalizarán chips especializados para IA local. Esto hará práctico el procesamiento local a escala de producción. TensorFlow Lite y PyTorch Edge ya aceleran el cambio al facilitar despliegue y optimización.
4. Avanzará el control preciso de todos los aspectos de la voz
En 2024 mejoró el control de matices como emoción, ritmo y pronunciación. Estas capacidades se extienden a otras modalidades. Por ejemplo, las señales emocionales de la voz pueden generar expresiones corporales correspondientes en avatares mediante Speech Synthesis Markup Language, SSML, que actualmente controla pausas o deletreo. Los creadores podrán insertar palabras o escenas generadas por IA en audio existente, adoptando automáticamente el estilo y el ritmo del material circundante.
Mirando al futuro
En 2025, la voz con IA será más capaz, personalizable y accesible en distintos sectores, a medida que pase de experimentos iniciales a sistemas preparados para producción.