
Cette année chez Cartesia, nous avons eu la chance de travailler avec des centaines de fondateurs, de responsables produit et d’ingénieurs qui construisent l’avenir des applications vocales. Notre premier rapport sur l’état de l’IA vocale en 2024 présente les avancées majeures de l’infrastructure et les nouveaux usages qui font progresser le secteur, puis examine les perspectives pour 2025.
Les grandes tendances de 2024
1. De nouvelles architectures d’interaction vocale sont apparues
L’année 2024 a marqué une avancée dans l’IA vocale conversationnelle avec l’apparition de systèmes orchestrés qui combinent des modèles STT → LLM → TTS pour écouter, raisonner et répondre au cours d’une conversation.
La technologie de parole à parole est devenue réalité avec le mode vocal de ChatGPT d’OpenAI. Celui-ci a introduit des modèles préentraînés de bout en bout sur des données audio et textuelles, capables de comprendre et de générer nativement de l’audio en plus des tokens de texte. L’implémentation d’OpenAI via son API Realtime n’est peut-être pas encore entièrement de bout en bout, comme le suggèrent les difficultés de gestion des interruptions dans sa démonstration. Elle représente néanmoins une étape vers des modèles unifiés pour les interactions vocales.
Des systèmes de parole à parole en duplex intégral sont apparus dans la recherche, notamment avec le modèle Moshi de Kyutai. Ces modèles restent « toujours à l’écoute » car, contrairement au système d’OpenAI, ils peuvent écouter l’utilisateur pendant qu’ils parlent. Ils donnent un aperçu de l’avenir de la voix multimodale, où les modèles reçoivent en permanence le flux audio de l’utilisateur.
De nouvelles architectures de modèles vocaux sont devenues viables. Cartesia a lancé Sonic TTS, fondé sur une nouvelle architecture de modèle à espace d’état (SSM) entraînée de manière autorégressive. Ces architectures s’écartent nettement des Transformers classiques fondés sur l’attention, devenus populaires ces dernières années, car elles offrent davantage de souplesse dans les environnements de déploiement. Des déploiements sur appareil économes en mémoire sont désormais possibles, avec une meilleure qualité et une latence réduite.
2. Les API d’IA vocale ont progressé pour permettre des conversations naturelles à l’échelle des entreprises
En 2024, les progrès des trois principaux composants de l’architecture moderne d’un agent vocal ont permis de remplacer les menus rigides « Appuyez sur 1 pour l’anglais » par des conversations naturelles.
- Transcription audio (STT) : sa qualité est devenue suffisante pour en faire un outil courant dans la conception d’applications centrées sur l’audio. Les termes spécialisés et la transcription de voix éloignées du microphone restent toutefois difficiles. En 2022, Whisper d’OpenAI avait posé les bases avec son modèle open source entraîné sur 680 000 heures d’audio multilingue. Depuis, Nova-2 de Deepgram a relevé le niveau en réduisant le taux d’erreur sur les mots (WER) de 30 % et en établissant de nouvelles références pour les applications commerciales en 2024.
- Grand modèle de langage (LLM) : les sorties de GPT-4o, Llama 3.2, Claude 3.5 Sonnet et Gemini 2.0 en 2024 ont apporté de nets progrès en raisonnement et en efficacité. Les coûts des LLM ont chuté, de 45 $ par million de tokens pour GPT-4 à 2,75 $ pour Llama 3.1 70B exécuté sur Together AI. Les modèles vocaux acceptent désormais des entrées en continu. Ils peuvent générer de l’audio en temps réel à mesure qu’un LLM fournit du texte, tout en conservant une prosodie cohérente entre les segments.
- Synthèse vocale (TTS) : les modèles ont atteint une maturité adaptée à la production, avec moins de latence, des voix plus naturelles et une meilleure précision sur les contenus complexes comme les acronymes et les expressions numériques. Les principaux moteurs TTS sont passés de voix robotiques à une parole proche de celle d’un humain. Ces progrès reposent sur de nouvelles architectures de réseaux neuronaux, dont les SSM, les Transformers et les modèles de diffusion, sur la qualité et la diversité des données d’entraînement, et sur l’optimisation des codecs audio, essentiels pour encoder et décoder efficacement l’audio numérique destiné à la diffusion ou au stockage.
Les fournisseurs d’IA vocale ont aussi dépassé leur public initial de créateurs avancés et de startups centrées sur la voix pour répondre aux exigences des entreprises. Les systèmes ont dû être repensés pour respecter des normes d’interaction en temps réel plus strictes que celles des applications asynchrones classiques. Une conversation en direct ne pouvant être ni corrigée ni régénérée, l’infrastructure doit garantir la disponibilité, gérer sans faille les appels simultanés et rester fiable. Pour servir les entreprises traditionnelles, les fournisseurs ont ajouté des SLA personnalisables, une capacité qui s’adapte aux pics de volume, des certifications de sécurité et des options d’auto-hébergement pour les secteurs très réglementés. Rares dans les premières offres d’IA vocale, ces fonctions sont devenues courantes avec la maturité de la technologie.
3. De nouvelles plateformes ont simplifié la création, le test et le déploiement d’agents vocaux personnalisés en production
La plupart des agents vocaux actuels reposent sur une chaîne conversationnelle composée de transcription audio (STT), de raisonnement par grand modèle de langage (LLM) et de synthèse vocale (TTS).
Cette chaîne permet des conversations naturelles, mais sa construction en interne est difficile. Il faut gérer les flux audio en temps réel et la latence des modèles, coordonner les tours de parole et assurer des transitions fluides. Ce qui demande généralement 6 à 12 mois à une équipe d’ingénierie peut être mis en œuvre en quelques semaines avec une plateforme d’orchestration vocale. Ces plateformes masquent cette complexité et permettent aux développeurs de se concentrer sur l’expérience tout en combinant les meilleurs composants.
Des entreprises comme LiveKit et Daily ont développé des composants open source pour orchestrer les modèles IA en temps réel avec une latence optimisée sur une pile WebRTC. Leur infrastructure assure des performances fiables dans le monde entier, tout en laissant les développeurs personnaliser l’ensemble de leur pile.
Des plateformes d’orchestration d’agents vocaux comme Vapi, Retell, Bland et Thoughtly sont apparues pour déployer rapidement des agents personnalisés. Elles proposent notamment des bases de connaissances fondées sur la génération augmentée par récupération (RAG) et des appels d’outils. Elles ajoutent aussi la détection d’activité vocale (VAD) pour gérer les changements de locuteur, la reconnaissance des émotions, la gestion des interruptions et des modèles de filtrage du bruit pour faciliter une conversation naturelle.
De nouvelles plateformes d’observabilité comme Hamming, Coval, Vocera et Canonical ont construit des suites complètes d’évaluation pour simuler et mesurer la qualité des agents vocaux à grande échelle.
4. Les agents vocaux se sont développés dans tous les secteurs
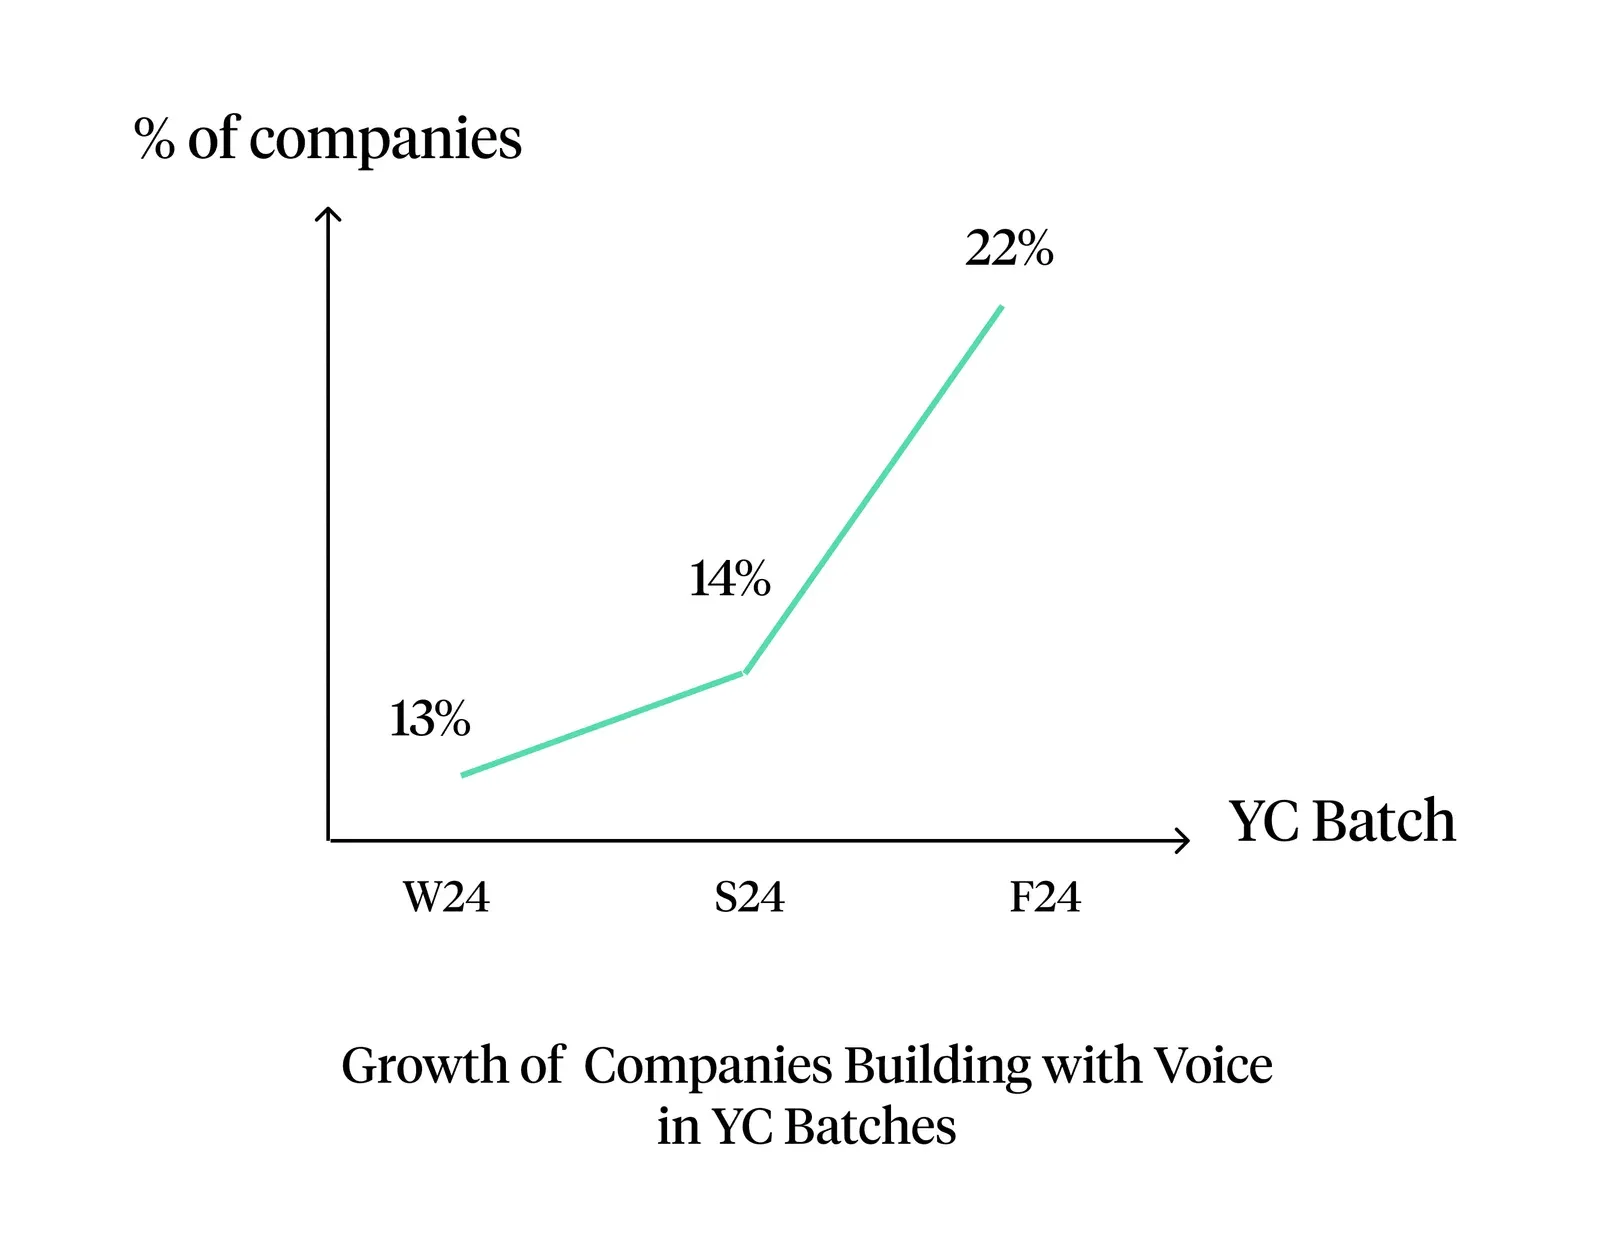
Les startups spécialisées dans les agents vocaux sectoriels ont connu une forte croissance. Chez Y Combinator, le nombre d’entreprises centrées sur la voix a augmenté de 70 % entre les promotions d’hiver et d’automne. Les premiers déploiements visaient à renforcer des services jusque-là en sous-effectif, comme les opérations clients disponibles 24 h/24 et 7 j/7 ou la gestion des pics saisonniers.
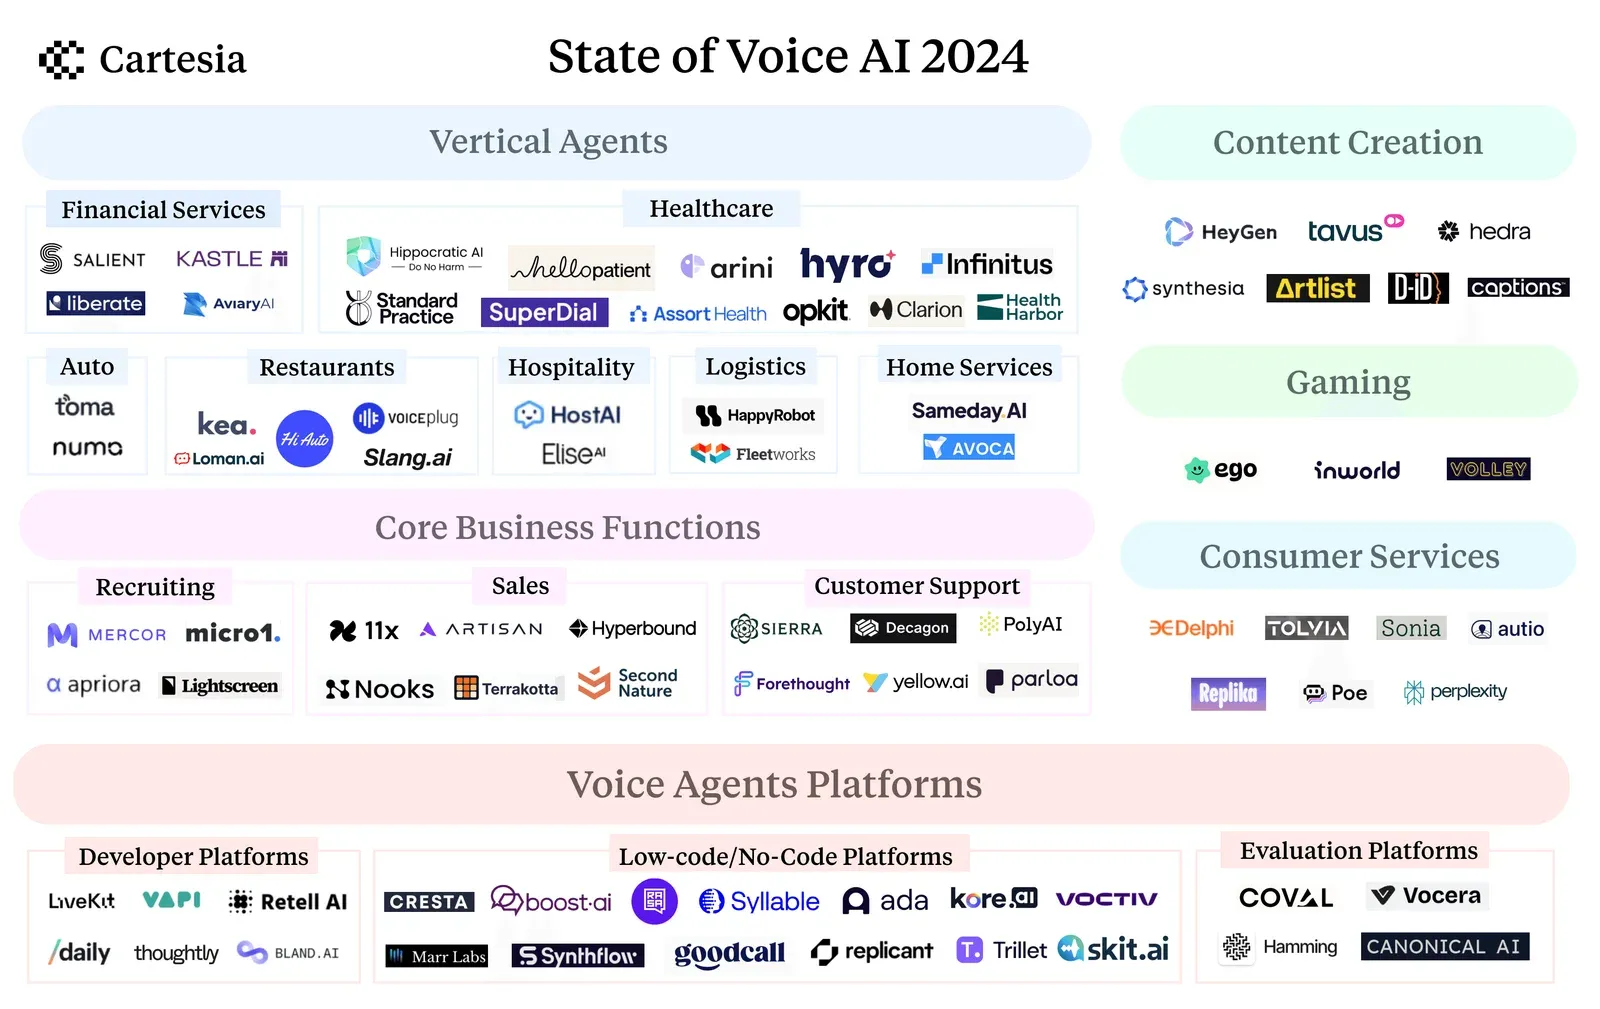
- Gestion des prêts : les agents de Salient et Kastle aident à gérer les prêts et leurs remboursements, à réactiver les comptes inactifs et à proposer d’autres produits financiers, tout en respectant des normes strictes pour les données sensibles comme les informations personnelles.
- Assurance : les agents de Liberate et Skit traitent les déclarations de sinistre 24 h/24 et 7 j/7, renouvellent les contrats et expliquent clairement les garanties.
- Santé : Abridge a introduit la transcription dans la santé en 2019 pour répondre à la forte demande de scribes médicaux. Aujourd’hui, des cliniques du monde entier adoptent des assistants IA pour prendre des rendez-vous, rappeler la prise de médicaments et répondre aux questions de facturation grâce à Hello Patient, Hippocratic, Assort Health et Superdial, tout en protégeant les informations des patients.
- Logistique : les courtiers en transport, prestataires logistiques tiers (3PL) et transporteurs utilisent Happy Robot et Fleetworks pour les appels de suivi, les mises à jour des chargements, le suivi des paiements et la prise de rendez-vous.
- Hôtellerie et immobilier : les usages vont de l’assistant IA omnicanal pour hôtels de Host AI au planificateur d’événements IA de Nowadays. L’assistant et le CRM d’Elise AI travaillent ensemble pour gérer les demandes de location, la maintenance et les renouvellements.
- Petites et moyennes entreprises : Goodcall permet aux petites franchises de configurer facilement des agents IA pour prendre tous leurs appels entrants. Faute de capacité, leurs propriétaires manquent actuellement 60 % des appels. Slang propose des solutions conçues pour les restaurants. Numa s’intègre aux CRM des concessionnaires automobiles afin d’utiliser l’historique des échanges clients pour favoriser la fidélisation. Avoca alimente des centres d’appels IA disponibles 24 h/24 et 7 j/7 pour le chauffage, la ventilation, la climatisation, la plomberie et d’autres services sur le terrain.
5. Les agents vocaux ont simplifié les fonctions centrales des entreprises
Les agents vocaux se sont aussi développés pour les processus d’entreprise standardisés, avec une forte adoption dans trois domaines :
- Recrutement : les recruteurs IA de Mercor et Micro1 réalisent des entretiens téléphoniques et vidéo. Ils s’appuient sur le parcours des candidats pour poser des questions pertinentes et fournir une analyse plus approfondie qu’un simple tri des candidatures.
- Vente : face à la baisse d’efficacité des e-mails, 11x, Artisan et Nooks relancent la prospection téléphonique avec des SDR IA chargés de prospecter et de qualifier les contacts. Des plateformes comme Hyperbound simulent des situations de vente pour améliorer les performances des commerciaux grâce à des jeux de rôle animés par l’IA.
- Support client : les plateformes d’expérience client fondées sur l’IA comme Sierra, Decagon, Forethought, Parloa et Poly ajoutent la voix pour prendre en charge le grand volume d’échanges d’assistance qui ont encore lieu par téléphone.
6. L’IA vocale a enrichi les médias et le divertissement avec des personnages interactifs
- Création de contenu : les plateformes d’avatars IA comme Heygen, Tavus, D-ID, Synthesia et Hedra permettent de générer un nombre illimité de vidéos commentées à partir d’un seul clone numérique. Elles changent la production de contenus marketing, de formation et pédagogiques. Capcut, Canva, Adobe et Captions intègrent désormais directement des voix IA, tandis que de grands médias comme Time et The New York Times adoptent la narration IA pour leurs articles, rendant la création de contenus de qualité professionnelle plus accessible.
- Jeux vidéo : les studios utilisent l’IA vocale pour créer des personnages non joueurs dynamiques qui réagissent aux interactions en temps réel. Ego et Inworld permettent de construire des mondes 3D riches où les personnages IA échangent naturellement avec les joueurs. Les modificateurs de voix en temps réel permettent aussi aux joueurs d’adapter leur voix à leur personnage et de renforcer l’immersion.
- Services aux particuliers : l’IA vocale permet aux créateurs et aux prestataires de toucher beaucoup plus de personnes. Avec Delphi, des influenceurs et des célébrités peuvent échanger simultanément avec des milliers de fans. Avec Sonia, des coachs et des thérapeutes peuvent proposer un accompagnement personnalisé permanent. Duolingo et Khan Academy étendent leur portée avec des tuteurs dotés de voix IA, tandis que NotebookLM de Google permet de créer des résumés audio d’articles et de livres. Replika et Character AI proposent des compagnons toujours disponibles pour différents publics, et Tolvia s’adresse aux personnes âgées. Enfin, Poe de Quora et la fonction de parole à parole de Perplexity facilitent l’accès vocal aux contenus des LLM.
Les perspectives pour 2025
1. Les modèles de parole à parole se généralisent
Les modèles de parole à parole (S2S) convertissent directement une entrée vocale en sortie vocale, sans passer par une représentation textuelle. Plusieurs modèles sont apparus en 2024, mais nous pensons que 2025 sera leur année de percée. Ils devraient démontrer leurs capacités sur trois points qui posent traditionnellement problème aux chaînes STT→LLM→TTS :
- Latence : les meilleurs agents vocaux actuels atteignent environ 510 ms de latence, soit 100 ms pour le STT de Deepgram, 320 ms pour GPT-4 et 90 ms pour le TTS de Cartesia. Cela reste loin des quelque 230 ms d’une conversation humaine. Les premiers modèles S2S comme Moshi, sorti cette année, montrent qu’un traitement en une seule étape pourrait atteindre 160 ms. Ils ont cependant besoin de meilleurs mécanismes pour ne pas répondre avant que l’utilisateur ait fini de parler.
- Compréhension du contexte : les systèmes S2S permettent à un même modèle de traiter, comprendre et générer directement la parole. Ils conservent ainsi les éléments non linguistiques, comme l’émotion, le ton et la prosodie, généralement perdus lors de la conversion en texte. Les systèmes actuels tentent de transmettre ces informations sous forme de métadonnées entre les composants. Un traitement S2S unifié devrait mieux saisir les nuances de la conversation. Le coût de calcul reste le principal obstacle. Une fois résolu, les performances et l’efficacité devraient progresser.
- Gestion des interruptions : au lieu d’imposer une alternance stricte, les modèles S2S peuvent traiter en parallèle des flux de parole qui se chevauchent. Les systèmes actuels ont toutefois du mal à reconnaître leur propre voix, à gérer des fenêtres de contexte limitées et à traiter l’audio superposé. Nous attendons des progrès importants sur ces points en 2025.
2. Les agents vocaux prendront en charge des tâches plus complexes en plusieurs étapes et s’intégreront davantage aux processus de tous les secteurs
L’année 2024 a été une première phase de test pour les agents vocaux. Ils géraient surtout le débordement d’appels et des tâches simples de qualification, avec des échanges prévisibles. Les tests A/B à l’aveugle ont montré de meilleurs résultats sur la durée des appels, le taux de résolution, les revenus récupérés et les scores de satisfaction client (CSAT). Les entreprises ont ainsi gagné confiance dans les interactions vocales fondées sur l’IA. Celle-ci pourrait devenir l’interface principale des échanges quotidiens entre consommateurs et entreprises, de la réservation d’un restaurant ou d’un rendez-vous médical au paiement de factures et aux démarches auprès des services d’immatriculation.
Imaginez appeler une compagnie aérienne pour modifier une réservation. Un agent IA pourrait tout gérer grâce au RAG, qui lui donnerait un accès immédiat au dossier passager, aux vols disponibles et aux règles de la compagnie. Il n’y aurait plus d’attente ni de transfert entre services. L’IA pourrait vérifier la réservation, chercher d’autres vols, appliquer les règles pertinentes et effectuer les changements tout en maintenant une conversation naturelle. Comme elles peuvent affiner un LLM sur leur base de connaissances, les entreprises pourraient vouloir affiner les modèles de transcription et de synthèse vocale sur le vocabulaire et le style propres à leur secteur ou à leur organisation. Cette confiance croissante dans la capacité de l’IA à résoudre des tâches complexes de bout en bout se reflète dans la tarification des agents. Certains fournisseurs facturent désormais les résultats, selon les tâches résolues, plutôt que la durée des appels.
3. Des modèles compacts sur appareil permettront des conversations locales partout
Les modèles IA compacts exécutés sur appareil gagnent du terrain car ils répondent à trois difficultés. Ils fonctionnent sans Internet, réduisent la latence en traitant les données localement et protègent la confidentialité en les conservant sur l’appareil. Cela rend l’IA vocale possible là où ces exigences sont impératives, des véhicules dans des zones isolées aux équipes de terrain sans couverture réseau.
Nous pensons que 2025 sera l’année du décollage de l’IA vocale sur appareil. Les nouvelles architectures, la quantification et la distillation des modèles arrivent à maturité, et les puces spécialisées d’IA en périphérie deviennent plus accessibles. Le traitement local devient ainsi réalisable à l’échelle de la production. Les progrès de TensorFlow Lite et de PyTorch Edge accélèrent déjà cette transition en simplifiant le déploiement et l’optimisation.
4. Le contrôle précis progresse sur tous les aspects de la voix
En 2024, le contrôle des nuances de la parole synthétique a beaucoup progressé, du ton émotionnel et du rythme à la prononciation précise. Ces possibilités s’étendent au-delà de la voix et permettent de coordonner ses caractéristiques avec d’autres modalités IA. Les indices émotionnels vocaux peuvent par exemple piloter des expressions corporelles correspondantes chez les avatars numériques grâce au Speech Synthesis Markup Language (SSML), actuellement utilisé pour définir les pauses ou l’épellation. Les créateurs pourront insérer des mots ou des scènes générés par l’IA dans un audio existant. Le nouveau contenu adoptera automatiquement le style et le rythme du contenu qui l’entoure.
La suite
En 2025, l’IA vocale deviendra plus puissante, plus personnalisable et plus accessible dans tous les secteurs, à mesure qu’elle passera des premières expériences aux systèmes prêts pour la production.