
Neste ano, na Cartesia, tivemos a oportunidade de trabalhar com centenas de fundadores, líderes de produto e engenheiros que estão construindo o futuro das aplicações de voz. Em nosso primeiro relatório sobre o estado da IA de voz em 2024, destacamos os principais avanços de infraestrutura e os novos casos de uso que impulsionam o setor, além das perspectivas para 2025.
As maiores tendências de 2024
1. Surgiram novas arquiteturas para interações por voz
Em 2024, a IA de voz conversacional avançou com sistemas de fala orquestrados que combinam modelos STT → LLM → TTS para ouvir, raciocinar e responder em uma conversa.
A tecnologia de fala para fala se tornou realidade com o modo de voz da OpenAI no ChatGPT. Ele apresentou modelos pré-treinados de ponta a ponta com áudio e texto, capazes de compreender e gerar áudio nativamente, além de tokens de texto. A implementação da API Realtime da OpenAI talvez ainda não seja totalmente de ponta a ponta, como indicam os desafios com interrupções na demonstração. Mesmo assim, representa um passo importante para usar modelos unificados nas interações por voz.
Sistemas de fala para fala totalmente bidirecionais surgiram na pesquisa com lançamentos como o modelo Moshi da Kyutai. Esses modelos estão “sempre ativos”. Ao contrário do sistema da OpenAI, conseguem ouvir o usuário enquanto falam. Isso oferece uma visão do futuro da voz multimodal, em que os modelos recebem áudio do usuário continuamente.
Novas arquiteturas de fala se tornaram viáveis. A Cartesia lançou o Sonic TTS, baseado em uma nova arquitetura de modelos de espaço de estados, ou SSMs, treinada de forma autorregressiva. Essas arquiteturas se afastam dos modelos Transformer tradicionais baseados em atenção que ganharam popularidade nos últimos anos, pois oferecem maior flexibilidade de implantação. Agora é possível executar modelos no dispositivo com uso eficiente de memória, além de melhorar qualidade e latência.
2. As APIs de IA de voz avançaram para permitir conversas naturais em escala empresarial
Em 2024, melhorias em três componentes centrais da arquitetura moderna de agentes permitiram substituir menus rígidos de “Pressione 1 para inglês” por conversas naturais.
- Fala para texto, ou STT: a qualidade da transcrição se tornou boa o suficiente para ser uma ferramenta padrão em aplicações concebidas para áudio. Porém, termos específicos de domínio e transcrição de fala distante do microfone continuam difíceis. Em 2022, o Whisper da OpenAI estabeleceu uma base com seu modelo de código aberto, treinado com 680,000 horas de áudio multilíngue. Desde então, o Nova-2 da Deepgram elevou o padrão, reduzindo a taxa de erro de palavras, ou WER, em 30% e estabelecendo novas referências para aplicações comerciais em 2024.
- Modelos de linguagem grandes, ou LLMs: GPT-4o, Llama 3.2, Claude 3.5 Sonnet e Gemini 2.0, lançados em 2024, trouxeram avanços expressivos em raciocínio e eficiência. Os custos caíram de $45 por milhão de tokens no GPT-4 para $2.75 por milhão no Llama 3.1 70B executado na Together AI. Os modelos de fala agora aceitam entradas em streaming, permitindo gerar áudio em tempo real conforme recebem texto do LLM, com prosódia consistente entre os segmentos.
- Texto para fala, ou TTS: os modelos alcançaram maturidade para produção, com menor latência, mais naturalidade e maior exatidão ao lidar com conteúdo complexo, como siglas e expressões numéricas. Os principais mecanismos TTS transformaram vozes sintéticas de origem robótica em fala semelhante à humana. Esse avanço vem de inovações em arquiteturas de redes neurais, como SSMs, Transformers e modelos de difusão, de dados de treinamento melhores e mais diversos e da otimização de codecs de áudio, essenciais para codificar e decodificar áudio digital para transmissão ou armazenamento.
Os fornecedores também passaram a atender às demandas empresariais, indo além do foco inicial em usuários profissionais e startups nativas de voz. Os sistemas precisaram ser reprojetados para atender a padrões rigorosos de interação em tempo real, superiores aos de aplicações assíncronas tradicionais. Como conversas ao vivo não podem ser editadas nem geradas novamente, a infraestrutura precisa garantir disponibilidade, chamadas simultâneas sem falhas e confiabilidade. Para atender a empresas tradicionais, os fornecedores passaram a oferecer SLAs personalizáveis, dimensionamento dinâmico nos picos, certificações de segurança e opções de hospedagem própria para setores muito regulados. Esses recursos eram raros nas primeiras ofertas, mas se tornaram padrão com o amadurecimento da tecnologia.
3. Novas plataformas facilitaram criar, testar e implantar agentes personalizados em produção
A maioria dos agentes atuais usa um pipeline conversacional central com fala para texto, raciocínio de um LLM e texto para fala.
Embora esse pipeline crie conversas naturais, construí-lo internamente traz desafios, como gerenciar fluxos de áudio em tempo real, lidar com a latência dos modelos, coordenar turnos e garantir transições fluidas. O que costuma exigir de 6 a 12 meses de uma equipe de engenharia pode ser implementado em semanas com plataformas de orquestração de fala. Elas ocultam essa complexidade e permitem que desenvolvedores se concentrem na experiência, combinando os melhores componentes para cada etapa.
Empresas como LiveKit e Daily desenvolveram componentes de código aberto para orquestrar modelos de IA em tempo real com baixa latência usando uma stack WebRTC. Sua infraestrutura garante desempenho confiável globalmente e permite personalizar toda a stack.
Plataformas como Vapi, Retell, Bland e Thoughtly surgiram para implantar agentes personalizados rapidamente, com recursos como bases de conhecimento com RAG e chamadas de ferramentas. Também oferecem detecção de atividade de voz, ou VAD, para controlar a alternância de locutores, além de reconhecimento de emoção, tratamento de interrupções e filtragem de ruído para facilitar conversas naturais.
Novas plataformas de observabilidade, como Hamming, Coval, Vocera e Canonical, criaram conjuntos completos de avaliação para simular e medir a qualidade de agentes em escala.
4. Agentes de voz surgiram em todos os setores
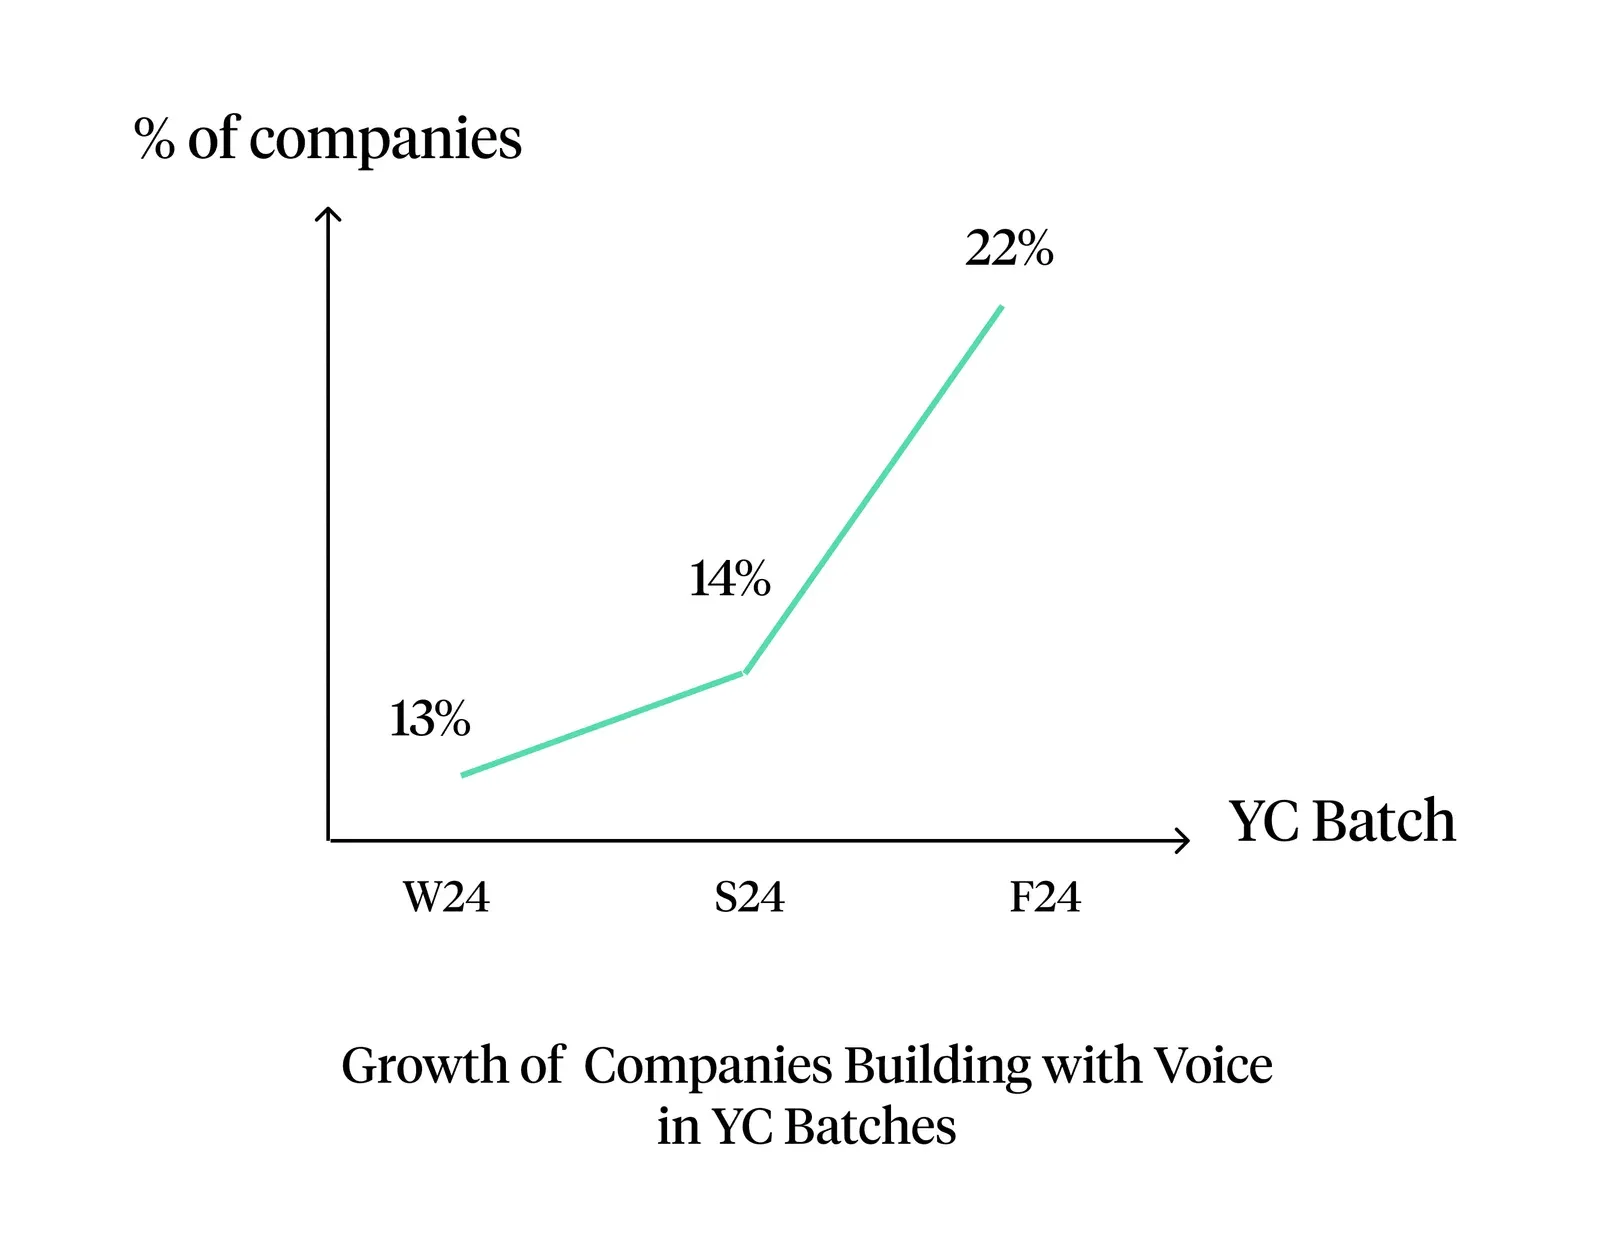
Startups de agentes especializados tiveram crescimento explosivo. Na Y Combinator, o número de empresas nativas de voz cresceu 70% entre as turmas de inverno e outono. A adoção inicial se concentrou em ampliar a capacidade de serviços antes carentes de pessoal, como atendimento 24 horas e picos sazonais.
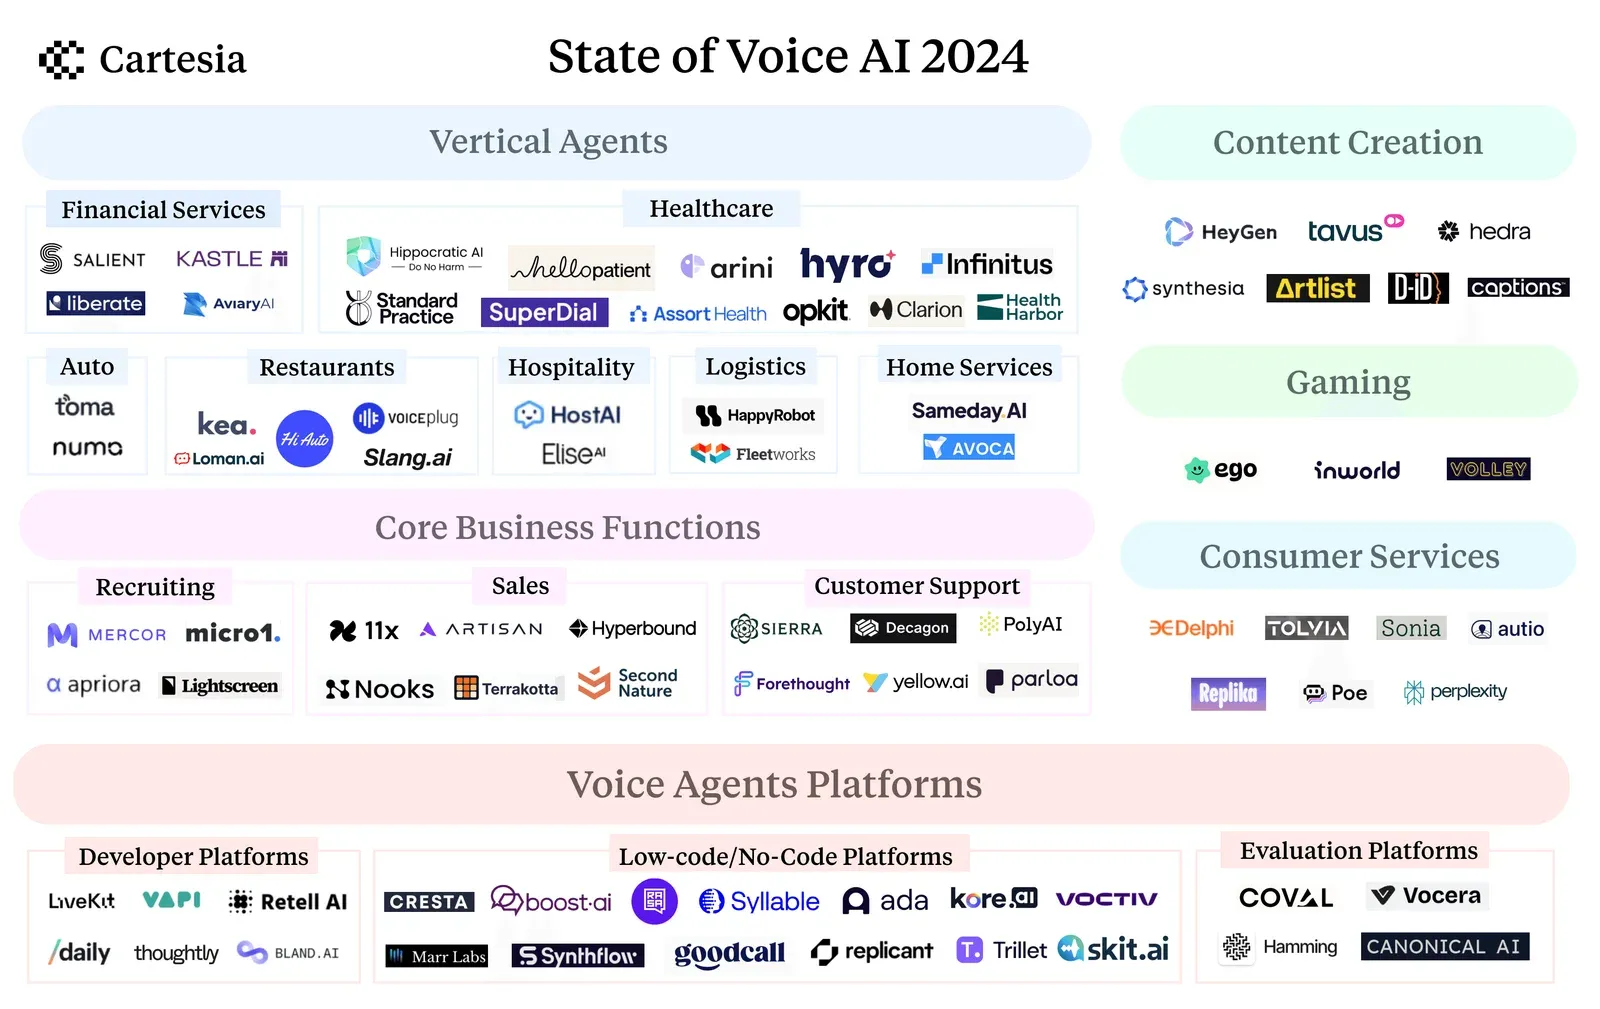
- Administração de empréstimos: os agentes da Salient e da Kastle ajudam a administrar empréstimos, gerenciar quitações e contatar clientes para reativar contas inativas ou oferecer outros produtos financeiros, mantendo padrões elevados de conformidade para dados sensíveis, como informações de identificação pessoal.
- Seguros: agentes da Liberate e da Skit processam sinistros 24 horas por dia, renovam apólices e explicam as opções de cobertura.
- Saúde: a Abridge levou transcrição à saúde em 2019, atendendo à demanda por documentação médica. Agora, clínicas no mundo todo adotam assistentes para agendar consultas, lembrar medicamentos e responder a dúvidas de cobrança, com empresas como Hello Patient, Hippocratic, Assort Health e Superdial, preservando as informações dos pacientes.
- Logística: intermediários de frete, operadores logísticos terceirizados e transportadoras usam Happy Robot e Fleetworks para chamadas de acompanhamento, atualizações de carga, status de pagamentos e agendamento.
- Hotelaria e imóveis: os casos vão do assistente omnicanal da Host AI para hotéis ao planejador de eventos da Nowadays. O assistente e o CRM da Elise AI trabalham juntos em consultas de locação, manutenção e renovações.
- Pequenas e médias empresas: a Goodcall permite que franquias menores configurem agentes para atender todas as chamadas recebidas. Hoje, esses proprietários perdem 60% das ligações por falta de capacidade. A Slang oferece soluções específicas para restaurantes. A Numa se integra a CRMs de concessionárias para usar o histórico de interações na retenção de clientes. A Avoca alimenta centrais de atendimento com IA 24 horas por dia para climatização, encanamento e outros serviços em campo.
5. Agentes simplificaram funções centrais das empresas
Os agentes também avançaram em processos padronizados, com adoção relevante em três áreas:
- Recrutamento: entrevistadores como Mercor e Micro1 fazem entrevistas por telefone e vídeo, usando o histórico dos candidatos para formular perguntas relevantes e oferecer análises mais profundas que a triagem tradicional de inscrições.
- Vendas: com a queda da eficácia do e-mail, empresas como 11x, Artisan e Nooks renovam as vendas por telefone com SDRs de IA para prospecção e qualificação. Plataformas como Hyperbound simulam cenários de venda para treinar representantes com encenações apoiadas por IA.
- Atendimento ao cliente: plataformas de experiência do cliente como Sierra, Decagon, Forethought, Parloa e Poly incorporam voz para atender ao grande volume de interações que ainda acontece por telefone.
6. A IA de voz tornou entretenimento e mídia mais envolventes com personagens interativos
- Criação de conteúdo: plataformas de avatares como Heygen, Tavus, D-ID, Synthesia e Hedra permitem criar vídeos narrados ilimitados a partir de um clone digital, transformando a produção de marketing, treinamento e educação. Capcut, Canva, Adobe e Captions já integram vozes de IA diretamente. Veículos como Time e The New York Times adotam narração de artigos, ampliando o acesso à criação de conteúdo com qualidade profissional.
- Jogos: estúdios usam IA de voz para criar NPCs dinâmicos e responsivos, que se adaptam às interações em tempo real. Ego e Inworld permitem criar mundos 3D em que personagens conversam naturalmente com jogadores. Alteradores de voz em tempo real permitem que a voz do jogador combine com a do personagem, aumentando a imersão.
- Serviços ao consumidor: a IA de voz permite que criadores e prestadores de serviços ampliem seu alcance pessoal. Influenciadores e celebridades podem conversar com milhares de fãs simultaneamente pela Delphi. Coaches e terapeutas podem oferecer orientação personalizada 24 horas por dia por plataformas como Sonia. Duolingo e Khan Academy ampliam o alcance com tutores de voz de IA. O NotebookLM do Google permite criar resumos em áudio de artigos e livros. Replika e Character AI oferecem companheiros sempre disponíveis para diferentes públicos, enquanto Tolvia atende especificamente a idosos. Por fim, o Poe da Quora e o recurso de voz para voz da Perplexity ampliam o acesso por voz ao conteúdo dos LLMs.
O que esperar em 2025
1. Modelos de fala para fala se tornam comuns
Modelos de fala para fala, ou S2S, convertem fala diretamente em fala, sem exigir uma representação em texto. Vários surgiram em 2024, mas esperamos que 2025 seja o ano de sua expansão, com capacidades convincentes em três dimensões que tradicionalmente desafiam pipelines STT→LLM→TTS:
- Latência: os melhores agentes atuais alcançam cerca de 510ms, com 100ms de STT Deepgram, 320ms de GPT-4 e 90ms de TTS Cartesia. Ainda estão longe dos cerca de 230ms da conversa humana. Modelos S2S iniciais, como Moshi, lançado neste ano, mostram potencial para 160ms com processamento em uma etapa, mas precisam melhorar os mecanismos que evitam responder antes que o usuário termine.
- Compreensão do contexto: o mesmo modelo S2S processa, compreende e gera fala diretamente. Isso preserva elementos não linguísticos, como emoção, tom e prosódia, normalmente perdidos na conversão em texto. Sistemas atuais tentam passar essas informações como metadados entre componentes, mas o processamento unificado deve captar melhor as nuances. O principal obstáculo continua sendo o custo computacional. Quando ele for resolvido, desempenho e eficiência melhorarão.
- Tratamento de interrupções: em vez de impor turnos rígidos, modelos S2S podem processar fluxos de fala sobrepostos em paralelo. Porém, os sistemas atuais têm dificuldades para reconhecer a própria fala, lidar com janelas de contexto limitadas e processar áudio sobreposto. Esperamos avanços importantes nessas áreas em 2025.
2. Agentes receberão tarefas mais complexas, com várias etapas, e se integrarão mais profundamente aos fluxos de todos os setores
Em 2024, os agentes passaram por uma fase inicial de testes, principalmente absorvendo excesso de chamadas e realizando triagens básicas com turnos previsíveis. Testes A/B cegos mostraram métricas superiores em duração de chamadas, resolução, recuperação de receita e satisfação do cliente, ou CSAT. Isso aumentou a confiança das empresas nas interações com IA. A voz está pronta para se tornar a interface principal da relação diária entre consumidores e empresas, de reservas em restaurantes e consultas médicas a pagamentos e serviços de órgãos de trânsito.
Imagine ligar para uma companhia aérea para remarcar um voo e um agente resolver tudo de ponta a ponta, usando geração aumentada por recuperação, ou RAG, para acessar imediatamente registros do passageiro, disponibilidade e políticas. Isso elimina esperas e transferências. A IA verifica reservas, identifica alternativas, aplica políticas e processa mudanças simultaneamente, mantendo uma conversa natural. Assim como fazem ajuste fino de um LLM com a base de conhecimento, empresas podem querer adaptar modelos de transcrição e TTS ao vocabulário e ao estilo de seu setor ou organização para reforçar a confiança. Essa confiança crescente na resolução completa de tarefas já aparece nos preços. Fornecedores começam a cobrar por resultados, vinculados à resolução bem-sucedida, em vez da duração da chamada.
3. Modelos compactos no dispositivo permitirão conversas locais em qualquer lugar
Modelos compactos no dispositivo ganham espaço por resolver três desafios. Funcionam sem internet, reduzem a latência com processamento local e mantêm a privacidade ao deixar os dados no dispositivo. Isso viabiliza IA de voz onde esses requisitos são indispensáveis, de veículos em áreas remotas a profissionais em campo sem sinal.
Esperamos que 2025 seja o ano de expansão da IA de voz no dispositivo. Novas arquiteturas, técnicas de quantização e destilação amadurecem, e chips especializados para IA na borda se tornam comuns, viabilizando o processamento local em escala de produção. Frameworks como TensorFlow Lite e PyTorch Edge já aceleram essa mudança ao facilitar implantação e otimização.
4. O controle preciso avança em todos os aspectos da voz
Em 2024, houve avanços no controle de nuances da fala sintética, do tom emocional e do ritmo à pronúncia precisa. Essas capacidades vão além da voz e permitem coordenar suas características com outras modalidades de IA. Por exemplo, sinais emocionais da voz já podem orientar expressões correspondentes na linguagem corporal de avatares por meio da Speech Synthesis Markup Language, ou SSML, atualmente usada para definir pausas ou soletração. Criadores poderão inserir palavras ou cenas geradas por IA em áudios existentes, com o novo conteúdo adotando automaticamente o estilo e o ritmo do material ao redor.
Olhando para o futuro
Em 2025, a IA de voz ficará mais poderosa, personalizável e acessível em vários setores, à medida que a tecnologia passar dos primeiros experimentos a sistemas prontos para produção.