
Quest’anno in Cartesia abbiamo lavorato con centinaia di fondatori, responsabili di prodotto e ingegneri che stanno costruendo il futuro delle applicazioni vocali. Nel nostro primo rapporto sullo stato dell’IA vocale nel 2024 esaminiamo i principali progressi dell’infrastruttura e i nuovi casi d’uso che fanno avanzare il settore, guardando a ciò che arriverà nel 2025.
Le principali tendenze del 2024
1. Sono emerse nuove architetture per le interazioni vocali
Il 2024 ha segnato un progresso nell’IA vocale conversazionale con sistemi orchestrati che combinano modelli STT → LLM → TTS per ascoltare, ragionare e rispondere durante una conversazione.
La tecnologia speech-to-speech è diventata concreta con la modalità vocale di ChatGPT di OpenAI: modelli preaddestrati end-to-end su informazioni audio e testuali che comprendono e generano nativamente audio oltre ai token testuali. L’implementazione tramite Realtime API potrebbe non essere ancora interamente end-to-end, come suggeriscono le difficoltà nel gestire le interruzioni nella dimostrazione, ma rappresenta un passo verso modelli unificati per le interazioni vocali.
Sistemi speech-to-speech full-duplex sono emersi nella ricerca con pubblicazioni come Moshi di Kyutai. Questi modelli sono sempre attivi perché, a differenza del sistema OpenAI, possono ascoltare l’utente mentre parlano. Mostrano un possibile futuro multimodale in cui i modelli ricevono continuamente l’audio dell’utente.
Nuove architetture vocali sono diventate praticabili: Cartesia ha pubblicato Sonic TTS su una nuova architettura di modelli a spazio di stato, SSM, addestrata in modo autoregressivo. È un cambiamento rispetto ai Transformer basati sull’attenzione diventati diffusi negli ultimi anni, perché offre più flessibilità negli ambienti di distribuzione. Ora sono possibili implementazioni sui dispositivi efficienti in memoria, insieme a qualità e latenza migliori.
2. Le API di IA vocale hanno reso possibili conversazioni naturali su scala aziendale
Nel 2024, i miglioramenti nei tre componenti principali degli agenti vocali hanno permesso di sostituire i rigidi menu “premi 1 per l’inglese” con conversazioni naturali.
- Trascrizione vocale, STT. La qualità della trascrizione è diventata sufficiente a renderla uno strumento standard nelle applicazioni nate per l’audio. Termini di settore e trascrizione a distanza restano difficili. Nel 2022 Whisper di OpenAI ha posto le basi con un modello open source addestrato su 680,000 ore di audio multilingue. Nova-2 di Deepgram ha poi ridotto del 30% il tasso di errore sulle parole, WER, stabilendo nuovi riferimenti per le applicazioni commerciali nel 2024.
- Grandi modelli linguistici, LLM. GPT-4o, Llama 3.2, Claude 3.5 Sonnet e Gemini 2.0, pubblicati nel 2024, hanno migliorato ragionamento ed efficienza. I costi sono scesi da $45 per milione per GPT-4 a $2.75 per milione di token per Llama 3.1 70B su Together AI. I modelli vocali supportano ora input in streaming, generando audio mentre ricevono testo dall’LLM e mantenendo la prosodia tra i segmenti.
- Sintesi vocale, TTS. I modelli hanno raggiunto una maturità adatta alla produzione, con meno latenza, maggiore naturalezza e migliore gestione di contenuti complessi come acronimi ed espressioni numeriche. I motori principali hanno trasformato le voci sintetiche da robotiche a simili a quelle umane. I progressi derivano da nuove architetture neurali, SSM, Transformer e modelli di diffusione, da dati di addestramento migliori e più vari e dall’ottimizzazione dei codec audio, essenziali per codificare e decodificare audio digitale per streaming o archiviazione.
I fornitori sono passati anche dal focus iniziale su utenti avanzati e startup vocali alle esigenze delle grandi imprese. I sistemi hanno richiesto una riprogettazione per rispettare standard di interazione in tempo reale più severi di quelli delle applicazioni asincrone. Le conversazioni dal vivo non si possono modificare o rigenerare: l’infrastruttura deve garantire disponibilità, gestione corretta delle chiamate simultanee e affidabilità. Per servire le imprese tradizionali, i fornitori hanno aggiunto SLA personalizzabili, crescita dinamica nei picchi di volume, certificazioni di sicurezza e opzioni autogestite per settori regolamentati. Funzioni rare nelle prime offerte sono diventate standard con la maturazione della tecnologia.
3. Nuove piattaforme hanno semplificato costruzione, test e distribuzione di agenti personalizzati
La maggior parte degli agenti attuali si basa su una pipeline conversazionale con trascrizione STT, ragionamento LLM e sintesi TTS.
Questa pipeline permette conversazioni naturali, ma costruirla internamente comporta difficoltà: gestire flussi audio in tempo reale, latenze dei modelli, alternanza dei turni e transizioni fluide. Ciò che richiede normalmente da 6 a 12 mesi a un team di ingegneria può essere implementato in settimane con piattaforme di orchestrazione vocale. Queste nascondono la complessità e permettono agli sviluppatori di concentrarsi sulle esperienze, combinando i migliori componenti.
LiveKit e Daily hanno sviluppato componenti open source per orchestrare modelli IA in tempo reale con bassa latenza tramite uno stack WebRTC. L’infrastruttura offre prestazioni affidabili nel mondo lasciando agli sviluppatori la personalizzazione dell’intero stack.
Piattaforme come Vapi, Retell, Bland e Thoughtly permettono di distribuire rapidamente agenti personalizzati con basi di conoscenza RAG e chiamate a strumenti. Offrono anche rilevamento dell’attività vocale, VAD, per controllare il cambio di parlante, riconoscimento delle emozioni, gestione delle interruzioni e filtraggio del rumore, per conversazioni naturali.
Piattaforme di osservabilità come Hamming, Coval, Vocera e Canonical hanno costruito suite per simulare e misurare la qualità degli agenti su larga scala.
4. Gli agenti vocali sono arrivati in ogni settore
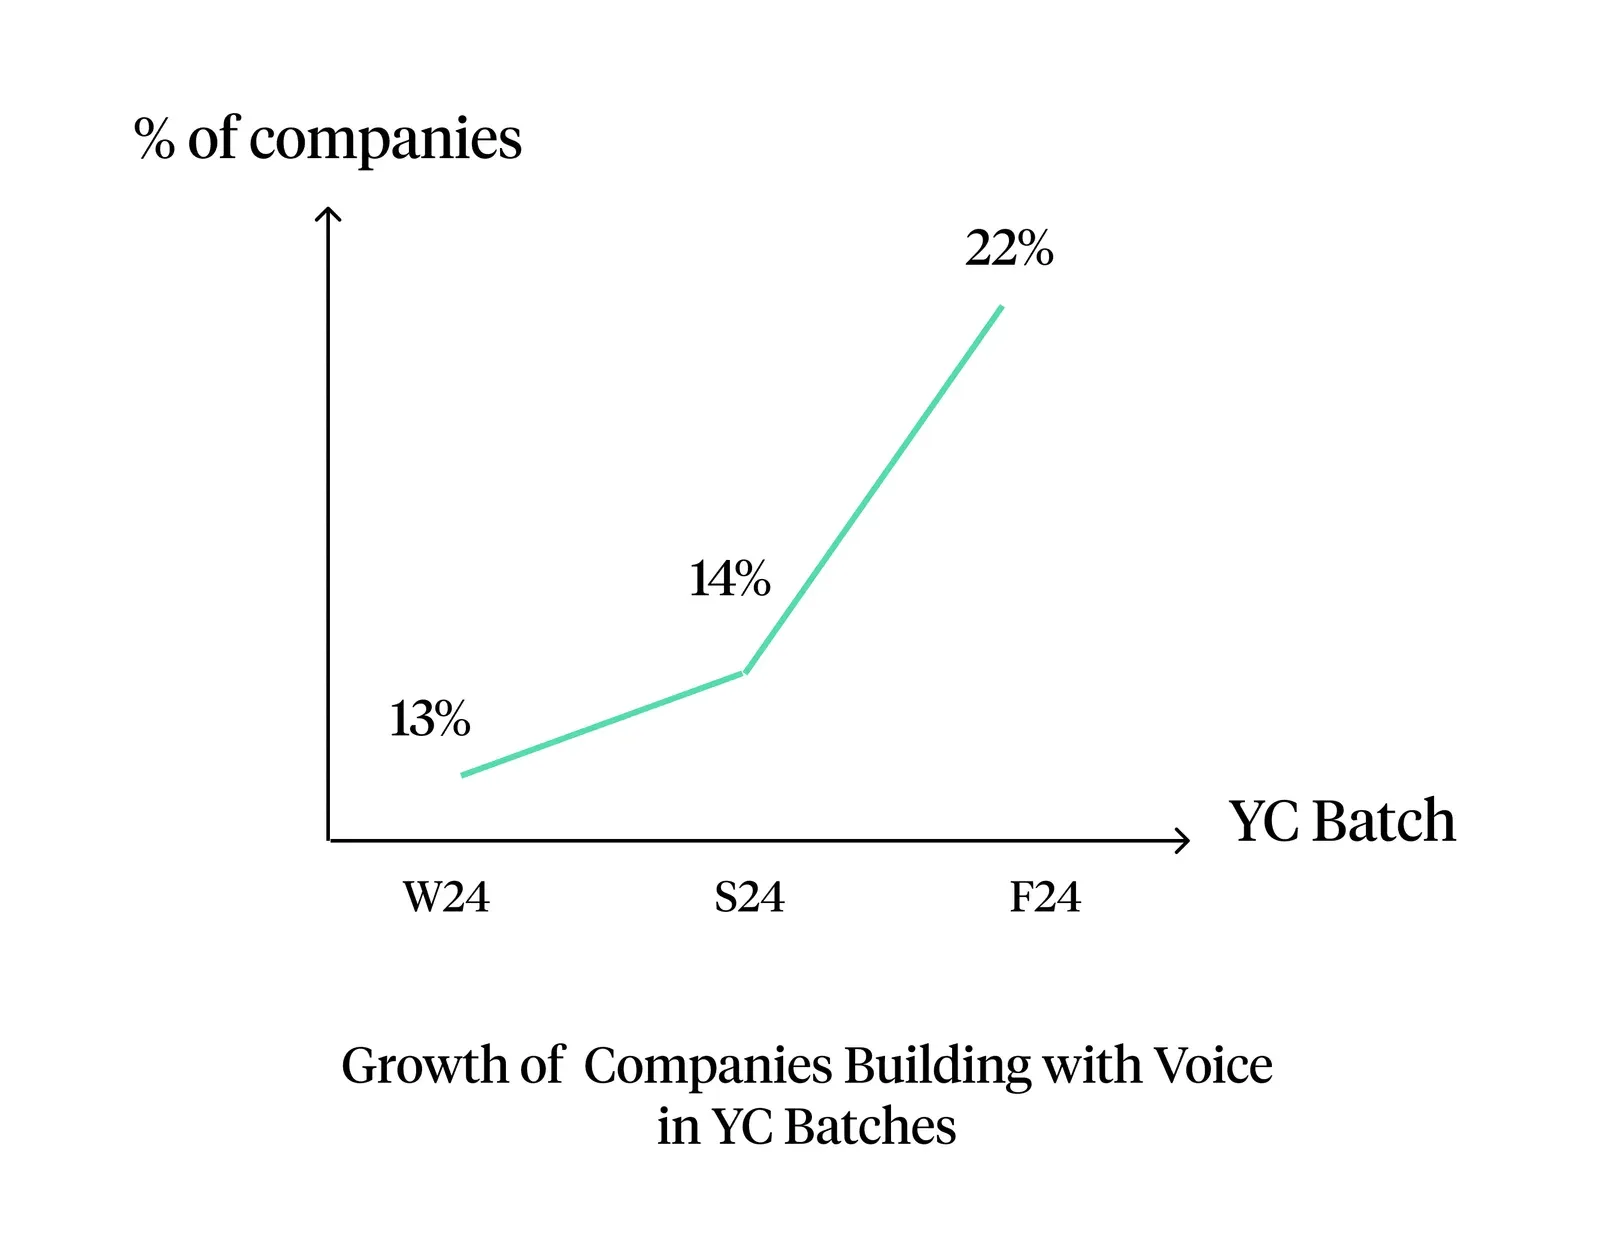
Le startup di agenti vocali verticali sono cresciute rapidamente. Y Combinator riflette la tendenza: il numero di aziende nate intorno alla voce è aumentato del 70% tra i gruppi invernale e autunnale. L’adozione iniziale ha ampliato servizi prima sotto organico, come assistenza 24 ore su 24 e gestione dei picchi stagionali.
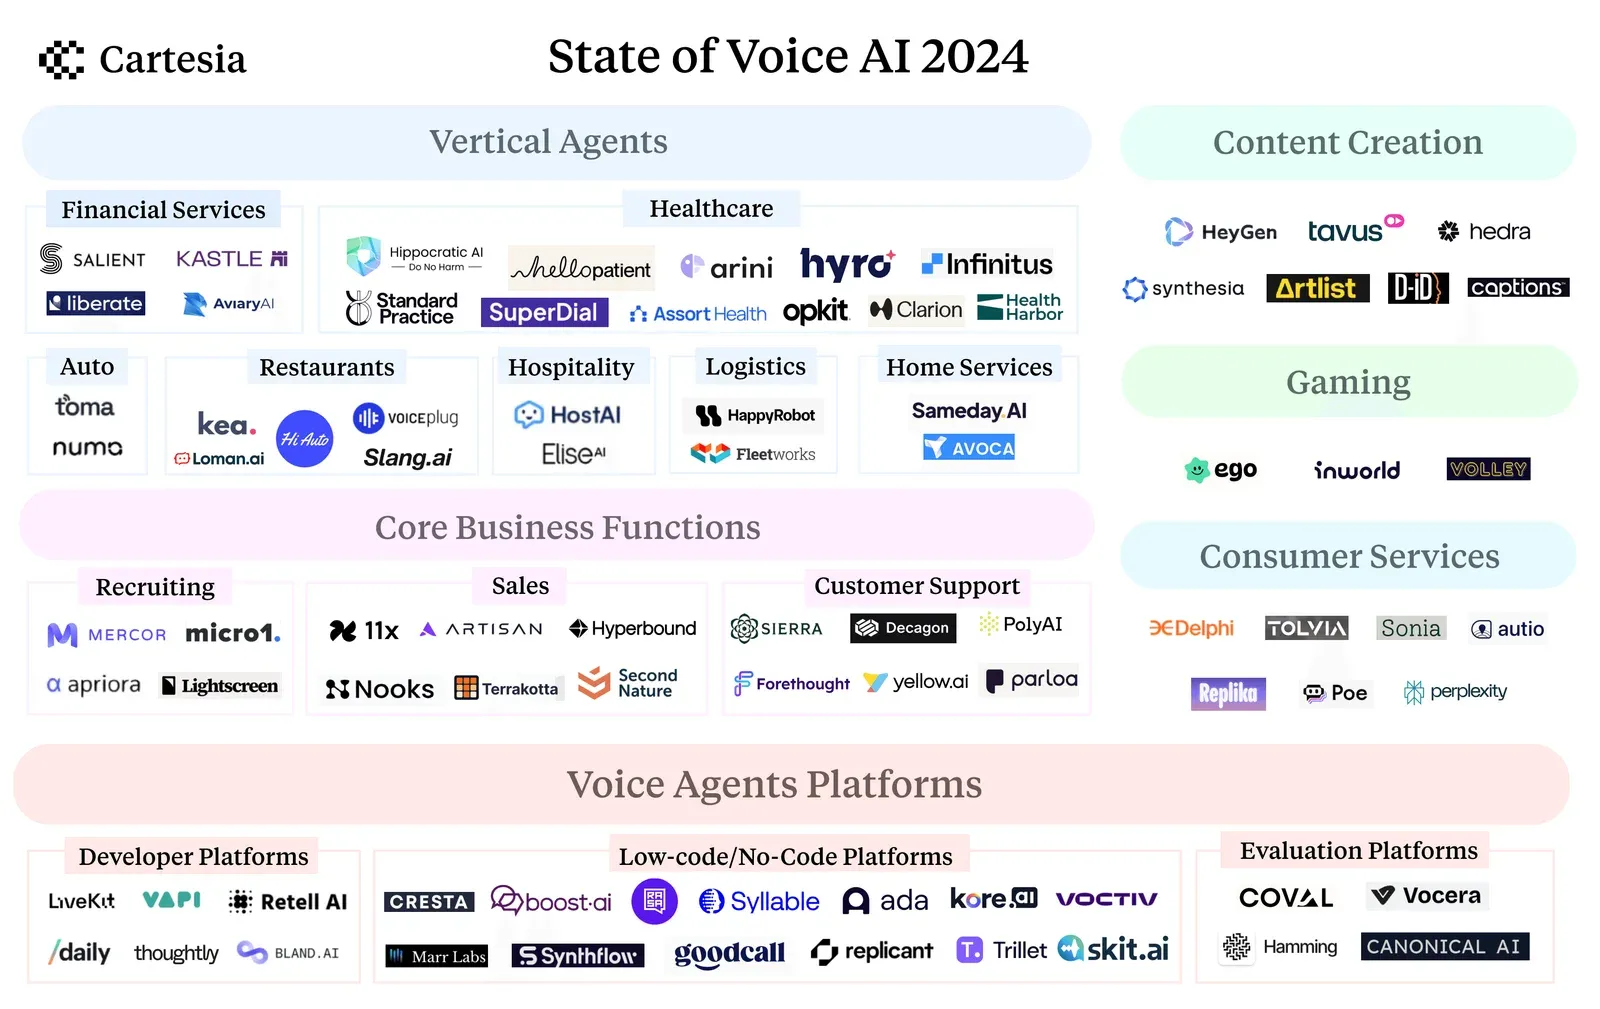
- Gestione dei prestiti. Gli agenti di Salient e Kastle aiutano a gestire prestiti e saldi, riattivare conti inattivi e proporre altri prodotti finanziari, mantenendo elevati standard di conformità per dati sensibili come le informazioni personali identificabili.
- Assicurazioni. Gli agenti di Liberate e Skit gestiscono sinistri 24 ore su 24, rinnovi di polizze e spiegazioni delle coperture.
- Sanità. Abridge ha introdotto la trascrizione sanitaria nel 2019 per rispondere alla domanda di assistenti alla documentazione clinica. Ora le cliniche adottano assistenti IA per appuntamenti, promemoria dei farmaci e domande sulla fatturazione grazie a Hello Patient, Hippocratic, Assort Health e Superdial, proteggendo i dati dei pazienti.
- Logistica. Intermediari del trasporto, operatori logistici terzi e vettori usano Happy Robot e Fleetworks per chiamate di verifica, aggiornamenti sui carichi, stato dei pagamenti e appuntamenti.
- Ospitalità. I casi vanno dall’assistente omnicanale di Host AI per gli hotel al pianificatore di eventi di Nowadays. L’assistente e il CRM di Elise AI lavorano insieme su richieste di locazione, manutenzione e rinnovi.
- Piccole e medie imprese. Goodcall permette ai piccoli franchising di configurare agenti per tutte le chiamate in ingresso; oggi i titolari ne perdono il 60% per mancanza di capacità. Slang ha soluzioni specifiche per ristoranti e Numa si integra con i CRM delle concessionarie per usare le interazioni passate e migliorare la fidelizzazione. Avoca supporta call center IA 24 ore su 24 per climatizzazione, idraulica e altri servizi sul campo.
5. Gli agenti vocali hanno semplificato funzioni aziendali centrali
Sono emersi anche per processi aziendali standardizzati, con forte adozione in tre aree:
- Selezione del personale. Intervistatori IA come Mercor e Micro1 conducono colloqui telefonici e video, usando il percorso dei candidati per formulare domande pertinenti e offrire informazioni più approfondite rispetto allo screening tradizionale.
- Vendite. Mentre l’efficacia delle email cala, 11x, Artisan e Nooks rinnovano le vendite telefoniche con SDR IA per ricerca e qualificazione di potenziali clienti. Hyperbound e altre piattaforme simulano scenari di vendita per allenare gli addetti tramite giochi di ruolo IA.
- Assistenza clienti. Piattaforme di esperienza cliente come Sierra, Decagon, Forethought, Parloa e Poly aggiungono capacità vocali per gestire il grande volume di interazioni che avviene ancora al telefono.
6. L’IA vocale ha reso più coinvolgenti intrattenimento e media con personaggi interattivi
- Creazione di contenuti. Piattaforme di avatar come Heygen, Tavus, D-ID, Synthesia e Hedra permettono di generare video narrati illimitati da un solo clone digitale, trasformando contenuti di marketing, formazione e istruzione. Capcut, Canva, Adobe e Captions integrano ora direttamente voci IA, mentre Time e The New York Times adottano narrazioni IA per gli articoli, rendendo accessibile la produzione di qualità professionale.
- Giochi. Gli studi usano IA vocale per personaggi non giocanti dinamici che reagiscono alle interazioni in tempo reale. Ego e Inworld permettono mondi 3D in cui i personaggi IA conversano naturalmente, mentre i cambiavoce in tempo reale adattano la voce del giocatore al personaggio e aumentano il coinvolgimento.
- Servizi ai consumatori. L’IA vocale amplia la portata di creatori e fornitori. Influencer e celebrità possono parlare con migliaia di fan contemporaneamente tramite Delphi; coach e terapeuti possono offrire guida personalizzata 24 ore su 24 su piattaforme come Sonia. Duolingo e Khan Academy estendono il servizio con tutor vocali IA, mentre NotebookLM di Google permette di creare riepiloghi audio di articoli e libri. Replika e Character AI offrono compagni sempre disponibili per ogni pubblico, e piattaforme specializzate come Tolvia si rivolgono agli anziani. Poe di Quora e la funzione voice-to-voice di Perplexity rendono i contenuti LLM accessibili tramite voce.
Cosa aspettarsi nel 2025
1. I modelli speech-to-speech diventano diffusi
I modelli speech-to-speech, S2S, convertono direttamente parlato in ingresso in parlato in uscita, senza passare da una rappresentazione testuale. Diversi modelli sono emersi nel 2024; prevediamo che il 2025 sarà l’anno della loro affermazione grazie a capacità in tre dimensioni difficili per le pipeline STT→LLM→TTS:
- Latenza. Gli agenti attuali migliori arrivano a circa 510 ms, con 100ms per Deepgram STT, 320ms per GPT-4 e 90ms per Cartesia TTS, ancora lontani dai circa 230ms della conversazione umana. Primi modelli S2S come Moshi, pubblicato quest’anno, mostrano il potenziale per 160ms con elaborazione in un solo passaggio, ma devono evitare meglio di rispondere prima che l’utente finisca.
- Comprensione del contesto. Un sistema S2S permette allo stesso modello di elaborare, comprendere e generare direttamente parlato. Conserva così emozione, tono e prosodia, che spesso si perdono nella conversione in testo. I sistemi attuali provano a passare queste informazioni come metadati tra componenti, ma l’elaborazione unificata catturerà meglio le sfumature. Il principale ostacolo resta il costo computazionale; risolto quello, miglioreranno prestazioni ed efficienza.
- Interruzioni. Invece di imporre turni rigidi, i modelli S2S possono elaborare in parallelo flussi di parlato sovrapposti. I sistemi attuali faticano però a riconoscere la propria voce, hanno finestre di contesto limitate e difficoltà con audio sovrapposto. Prevediamo progressi importanti nel 2025.
2. Agli agenti saranno affidati compiti complessi in più passaggi, più integrati nei flussi di ogni settore
Il 2024 è stato una prima fase di prova, soprattutto per chiamate in eccesso e screening di base con turni prevedibili. I test A/B alla cieca hanno mostrato risultati migliori per durata delle chiamate, risoluzione, recupero dei ricavi e soddisfazione dei clienti, CSAT, aumentando la fiducia delle aziende. L’IA vocale può diventare l’interfaccia principale per le interazioni quotidiane con le imprese: prenotare ristoranti e visite mediche, pagare bollette e gestire pratiche della motorizzazione.
Immagina di chiamare una compagnia aerea per cambiare prenotazione e trovare un agente IA che gestisce tutto usando RAG per accedere subito a dati del passeggero, disponibilità dei voli e regole della compagnia. Senza attese o trasferimenti di reparto, verifica la prenotazione, identifica alternative, applica le regole e processa le modifiche mantenendo una conversazione naturale. Come si adatta un LLM alla propria base di conoscenza, le imprese potrebbero voler adattare modelli di trascrizione e TTS al dizionario e allo stile del settore o dell’azienda, rafforzando la fiducia negli agenti. Questa fiducia crescente si riflette nei nuovi prezzi basati sul risultato: i fornitori legano il costo alla risoluzione dei compiti anziché alla durata delle chiamate.
3. Modelli compatti sui dispositivi permetteranno conversazioni locali ovunque
I modelli IA compatti sui dispositivi risolvono tre problemi: funzionano senza internet, riducono la latenza elaborando localmente e proteggono la privacy mantenendo i dati sul dispositivo. Rendono possibile l’IA vocale quando questi requisiti non sono negoziabili, dai veicoli in aree remote ai lavoratori in zone senza segnale.
Prevediamo che il 2025 sarà l’anno dell’affermazione dell’IA vocale sui dispositivi, grazie alla maturazione di nuove architetture, quantizzazione e distillazione e alla diffusione di chip edge IA specializzati. L’elaborazione locale diventerà praticabile su scala produttiva. Framework come TensorFlow Lite e PyTorch Edge stanno già accelerando il cambiamento rendendo più accessibili distribuzione e ottimizzazione.
4. Il controllo preciso avanza in ogni aspetto della voce
Nel 2024 sono migliorati il controllo del tono emotivo, del ritmo e della pronuncia. Queste capacità vanno oltre la voce e coordinano le caratteristiche del parlato con altre modalità IA: per esempio, segnali emotivi nella voce possono guidare espressioni corrispondenti nel linguaggio corporeo degli avatar tramite Speech Synthesis Markup Language, SSML, oggi usato per indicare pause o spelling. I creatori potranno inserire parole o scene generate dall’IA in audio esistente, con nuovi contenuti che adottano automaticamente stile e tempi del materiale circostante.
Guardando avanti
Nel 2025 l’IA vocale diventerà più potente, personalizzabile e accessibile in tutti i settori, passando dai primi esperimenti a sistemi pronti per la produzione.