
今年Cartesiaは、音声アプリケーションの未来をつくる数百人の創業者、プロダクト責任者、エンジニアと仕事をする機会に恵まれました。初のState of Voiceレポートでは、2024年の業界を動かしたインフラの進歩と新たな用途を振り返り、2025年を展望します。
2024年の大きな動向
1. 音声対話をつくる新しいアーキテクチャの登場
2024年は会話型音声AIが大きく進歩した年でした。STT → LLM → TTSのモデルを組み合わせて、会話を聴き、考え、応答する音声システムが登場しました。
OpenAIのChatGPTのVoice modeによって、音声から音声への技術が現実になりました。音声とテキストの情報でエンドツーエンドに事前学習され、テキストのトークンに加えて音声も直接理解し、生成するモデルです。デモで割り込みへの対応に課題が見られたことから、Realtime APIによるOpenAIの実装はまだ完全なエンドツーエンドではないかもしれません。それでも、音声対話を単一の統合モデルで扱うための大きな一歩です。
KyutaiのMoshiなどの公開によって、全二重の音声対音声システムも研究成果として登場しました。これらは、OpenAIのシステムと違って自分が話している間もユーザーの声を聴けるため、「常時オン」のモデルです。常にユーザーの音声が流れ込む、マルチモーダル音声の未来をうかがわせます。
音声向けの新しいモデルアーキテクチャも実用的になりました。Cartesiaは、自己回帰的に学習する新しい状態空間モデル、SSMに基づくSonic TTSを公開しました。この構成は、過去数年に広まった注意機構ベースのTransformerとは大きく異なり、導入環境の柔軟性を高めます。品質とレイテンシを改善しながら、メモリ効率のよいオンデバイス導入が可能になりました。
2. 企業規模で自然な会話を実現する音声AI APIの進歩
2024年には、現代の音声エージェントを支える三つの主要な構成要素が改善し、「英語は1を押してください」という固定的な電話メニューを、自然な会話に置き換えられるようになりました。
- 音声認識(STT)。文字起こしの品質は、音声中心のアプリケーションを設計する標準的な道具になる水準に達しました。ただし、専門用語や遠くからの音声の認識には課題が残ります。2022年、OpenAIのWhisperは68万時間の多言語音声で学習したオープンソースモデルで基礎を築きました。その後DeepgramのNova-2は単語誤り率、WERを30%削減し、2024年の商用アプリケーションの新たな基準をつくりました。
- 大規模言語モデル(LLM)。2024年のGPT-4o、Llama 3.2、Claude 3.5 Sonnet、Gemini 2.0の公開で、推論能力と効率が大きく改善しました。LLMの費用はGPT-4の100万トークンあたり45ドルから、Together AIで動くLlama 3.1 70Bの2.75ドルへと大幅に低下しました。音声モデルも入力のストリーミングに対応し、LLMから入力を受け取ると同時に音声を生成しながら、区間をまたいで一貫した韻律を保てるようになりました。
- 音声合成(TTS)。TTSモデルは本番運用に使える水準に成熟し、レイテンシの低下、自然さの向上、略語や数値表現など複雑な内容の正確さを実現しました。有力なTTSエンジンによって、合成音声は機械的な声から人間らしい声へと変わっています。SSM、Transformer、拡散モデルといったニューラルネットワークの進歩、学習データの品質と多様性の向上、音声コーデックの最適化が、この変化を支えています。コーデックは、配信や保存のためにデジタル音声を効率よく符号化、復号するために欠かせません。
音声AIの提供企業も、当初の高度な個人利用者や音声中心のスタートアップ向けから、企業の需要に応えるよう変化しました。リアルタイムの対話には、従来の非同期アプリケーションを超える厳しい基準があり、システムの根本的な再設計が必要でした。生の会話は編集も再生成もできないため、稼働時間の保証、同時通話の確実な処理、高い信頼性が求められます。従来型の企業にも対応するため、各社は調整可能なSLA、ピーク時の動的な拡張、セキュリティ認証、厳しい規制のある業界向けの自己ホストの選択肢を提供するようになりました。初期には珍しかったこれらの機能は、技術の成熟とともに標準になっています。
3. 独自の音声エージェントを開発、テスト、本番導入しやすくするプラットフォーム
現在の音声エージェントの多くは、音声認識、LLMによる推論、音声合成という会話のパイプラインを基盤にしています。
この構成は自然な会話を生みますが、社内でつくるには大きな課題があります。リアルタイム音声ストリーム、モデルのレイテンシ、話す順番の調整、滑らかな切り替えを管理しなければなりません。エンジニアリングチームが通常6〜12か月かける開発を、音声のオーケストレーション基盤なら数週間で実装できます。複雑さを隠し、優れた構成要素を組み合わせながら、開発者が体験づくりに集中できるようにします。
LiveKitやDailyは、WebRTCを使って複数のリアルタイムAIモデルを低レイテンシで連携させるオープンソースの構成要素を開発しました。世界中で信頼できる動作を実現しながら、開発者はスタック全体を自由に調整できます。
Vapi、Retell、Bland、Thoughtlyなどの音声エージェント基盤も登場し、RAGを使う知識ベースやツール呼び出しなどを備えた独自エージェントを短期間で導入できるようになりました。話者の切り替えを制御する音声区間検出、感情認識、割り込み対応、雑音を除くモデルなど、自然な会話を支える機能も提供します。
Hamming、Coval、Vocera、Canonicalなどの新しい可観測性基盤は、音声エージェントの品質を大規模にシミュレーションし、測定するための評価一式を開発しました。
4. あらゆる業界への音声エージェントの広がり
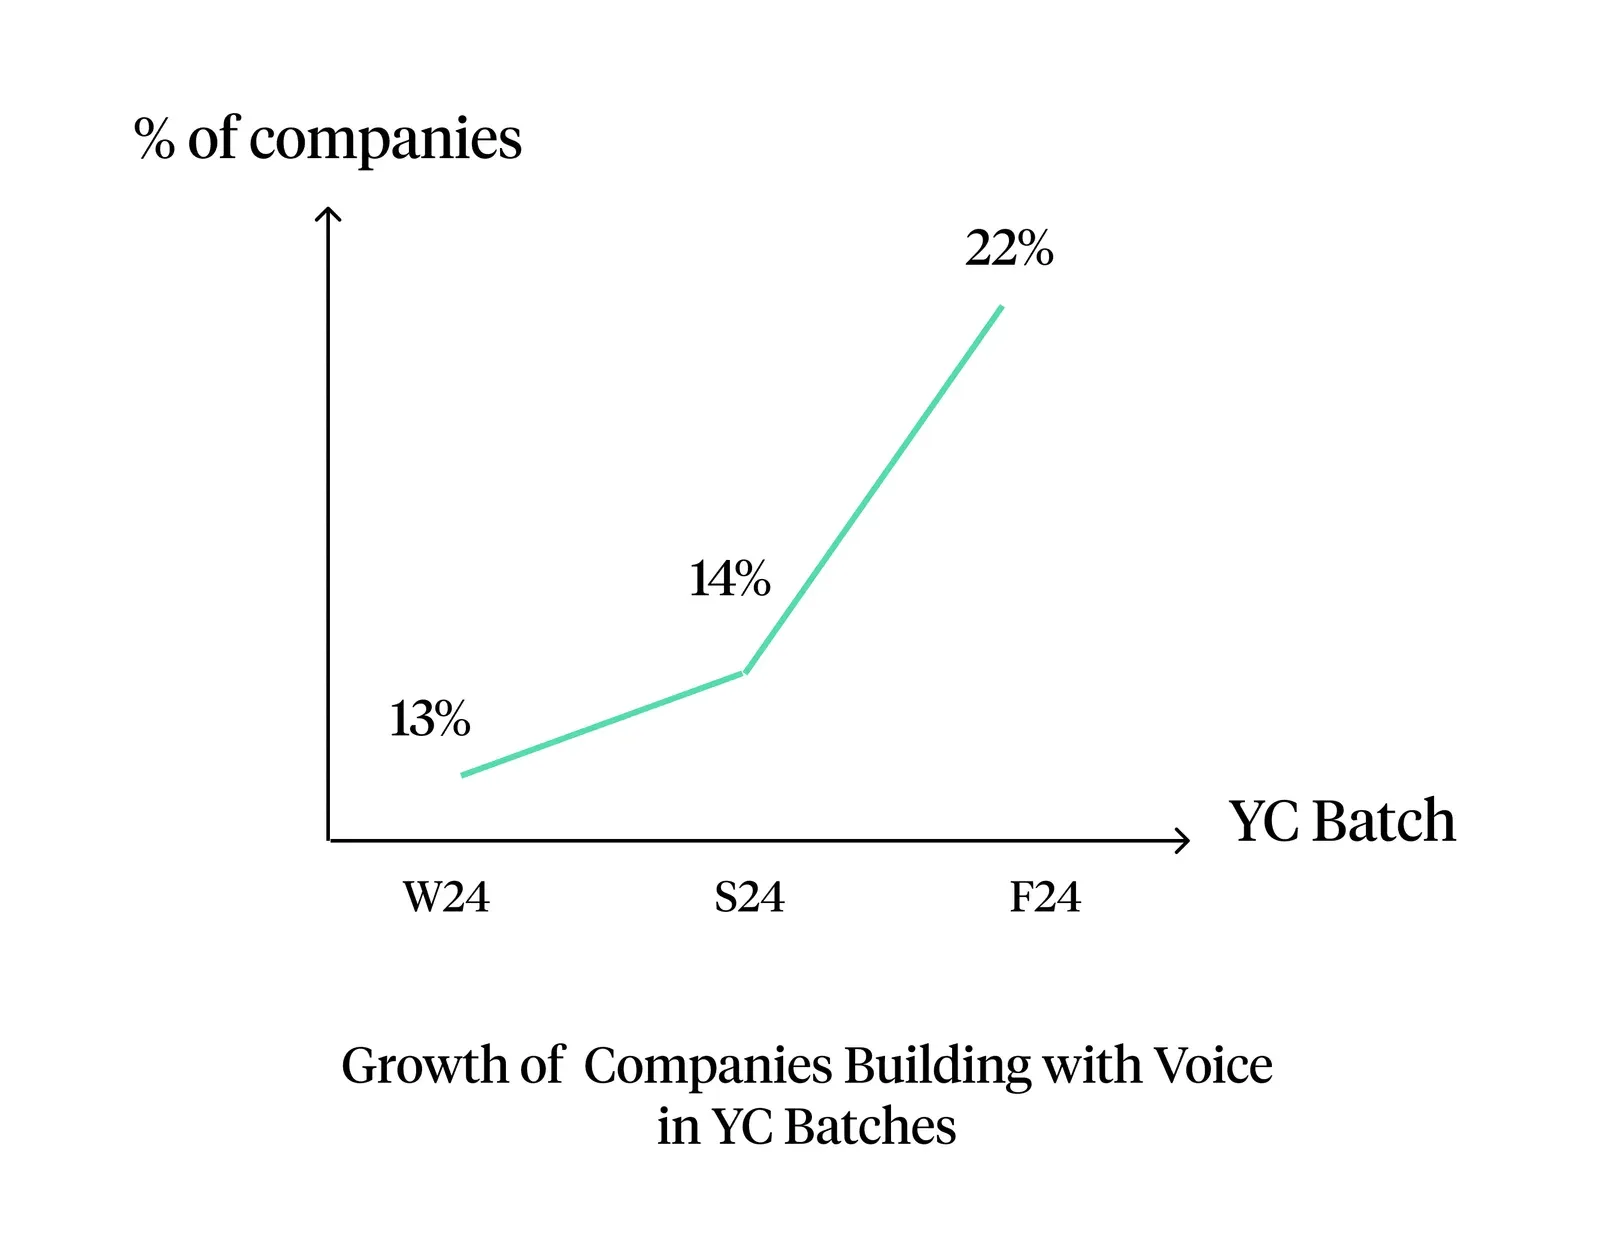
業界特化型の音声エージェント企業は急成長しました。Y Combinatorでも冬と秋の採択グループを比べると、音声中心の企業数が70%増えています。初期の導入は、24時間の顧客対応や季節的な需要増加など、人手不足だったサービスの対応能力を広げることに集中していました。
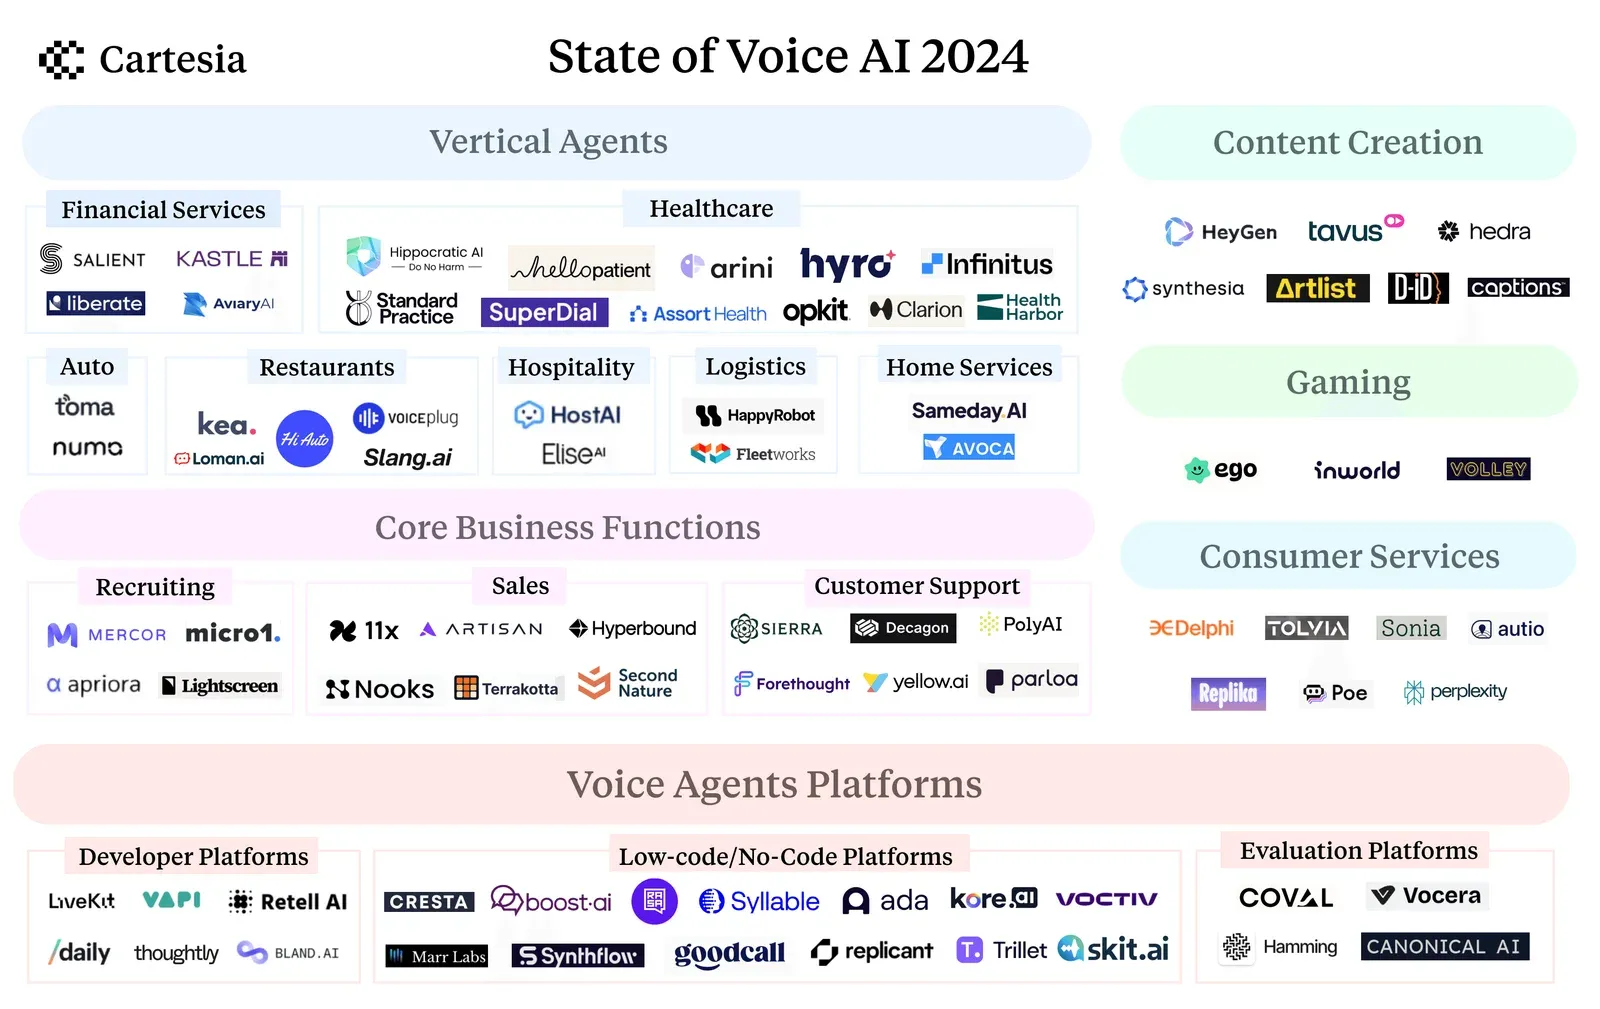
- ローン管理。SalientとKastleのエージェントは、個人を特定できる情報などの機密データについて高いコンプライアンス基準を保ちながら、ローンの管理、完済手続き、休眠口座の再利用や他の金融商品の提案のための連絡を支援します。
- 保険。LiberateとSkitは、保険金請求、契約更新、補償内容のわかりやすい説明に24時間対応します。
- 医療。Abridgeは2019年、医療記録の代行への高い需要に応えて、文字起こしを医療に導入しました。現在はHello Patient、Hippocratic、Assort Health、Superdialなどによって、世界の診療所が患者情報を守りながら、予約、服薬の通知、請求への問い合わせにAIアシスタントを使っています。
- 物流。貨物仲介業者、第三者物流企業、運送会社は、Happy RobotとFleetworksで状況確認の電話、積荷の更新、支払状況、予約を管理しています。
- ホスピタリティ。ホテル向けのHost AIの複数チャネル対応アシスタントから、NowadaysのAIイベントプランナーまで用途が広がっています。Elise AIはAIアシスタントとCRMを連携させ、賃貸の問い合わせから保守、更新まで扱います。
- 中小企業。対応能力の制約で電話の60%を取り逃している小規模フランチャイズの経営者に向け、Goodcallはすべての着信に対応するAIエージェントを簡単に設定できるようにします。Slangは飲食店専用の製品を提供し、Numaは自動車販売店のCRMと連携して過去の顧客対応データから継続利用を促します。Avocaは空調、配管などの現場サービスに24時間のAIコールセンターを提供します。
5. 基幹業務を効率化する音声エージェント
標準化された業務プロセスにも音声エージェントが登場し、主に次の三つの領域で導入が進みました。
- 採用。MercorやMicro1のAI面接官は、応募者の経歴に合わせた質問で電話やビデオの面接を行い、従来の書類選考より深い情報を得て採用を支援します。
- 営業。メールの効果が落ちる中、11x、Artisan、Nooksは、見込み客の開拓や見極めを行うAI SDRで電話営業を活性化しています。一方、HyperboundなどはAIのロールプレイで営業場面を再現し、担当者の能力を高めています。
- カスタマーサポート。Sierra、Decagon、Forethought、Parloa、PolyなどのAI顧客体験基盤は、今も大量に電話で行われる顧客対応のため、音声機能を取り入れています。
6. 対話するキャラクターが娯楽やメディアを豊かに
- コンテンツ制作。Heygen、Tavus、D-ID、Synthesia、HedraなどのAIアバター基盤では、一つのデジタルクローンからナレーション付き動画を多数生成でき、マーケティング、研修、教育の制作が変わっています。Capcut、Canva、Adobe、CaptionsはAI音声を直接組み込み、TimeやThe New York Timesなどの大手メディアも記事のAIナレーションを採用しています。専門家水準のコンテンツを、より多くの人がつくれるようになりました。
- ゲーム。ゲームスタジオは音声AIを使い、プレイヤーにリアルタイムで反応するNPCによって没入感を高めています。EgoやInworldは、AIキャラクターが自然に対話する豊かな3D世界の制作を支援します。リアルタイムのボイスチェンジャーは、プレイヤーの声をゲーム内のキャラクターに合わせ、体験への没入を深めます。
- 消費者向けサービス。音声AIは、クリエイターやサービス提供者が個人で届けられる価値を大きく広げます。Delphiではインフルエンサーや著名人が数千人のファンと同時に対話でき、Soniaのような基盤ではコーチやセラピストが24時間の個別の支援を提供できます。DuolingoとKhan AcademyはAI音声の教師で利用範囲を広げ、GoogleのNotebookLMなら誰でも記事や本の音声要約をつくれます。ReplikaとCharacter AIはさまざまな層に常時利用できる話し相手を提供し、Tolviaのような専門サービスは高齢者を支援します。QuoraのPoeやPerplexityの音声対音声機能も、音声でLLMの内容にアクセスできる人を増やしています。
2025年の展望
1. 音声対音声モデルが主流へ
音声対音声、S2Sモデルは、テキスト表現を介さず、音声入力を直接音声出力に変換します。2024年には複数のモデルが登場しました。従来のSTT → LLM → TTSの構成が苦手とする三つの領域で能力を示し、2025年は飛躍の年になると予想します。
- レイテンシ。現在の音声エージェントの最高水準は約510ミリ秒です。Deepgram STTが100ミリ秒、GPT-4が320ミリ秒、Cartesia TTSが90ミリ秒で、人間の会話の約230ミリ秒にはまだ届きません。今年公開されたMoshiなどの初期S2Sモデルは、一段階の処理で160ミリ秒を実現する可能性を示しています。ただし、ユーザーが話し終える前に応答しないための仕組みを改善する必要があります。
- 文脈の理解。S2Sでは、一つのモデルが音声を直接処理、理解、生成します。テキストへの変換で失われがちな感情、声の調子、韻律といった非言語的な要素を保てます。現在のシステムはこれらをメタデータとして構成要素間で渡そうとしていますが、統合されたS2Sの処理なら、会話の細かな意味をよりよく捉えられます。主な障害は計算費用であり、解決すれば性能と効率の両方が向上します。
- 割り込み対応。S2Sモデルは厳格に交代で話す仕組みを強制せず、重なった音声ストリームを並列に処理できます。ただし現在は、自分の発話の認識、限られたコンテキストウィンドウ、重なった音声の処理に課題があります。2025年を通じた大きな改善を期待しています。
2. 複雑な複数段階の仕事を任され、各業界の業務に深く入る音声エージェント
2024年は、会話の順番を予測しやすい、対応しきれない電話の引き受けや基本的な選別を中心とした初期の検証段階でした。ブラインドA/Bテストで、通話時間、解決率、収益回収率、顧客満足度のCSATなどの優れた結果が示され、企業はAIによる音声対話に自信を持ち始めました。飲食店の予約や診療の予約から、請求の支払い、自動車管理局の手続きまで、消費者と企業の日々の接点として、音声AIが主要な窓口になる準備が整いつつあります。
たとえば航空会社に予約変更の電話をすると、AIエージェントがRAGで旅客記録、空席、規定を即座に取得し、最初から最後まで対応する場面を考えてください。保留や別部署への転送は不要です。自然に会話しながら、現在の予約の確認、代替案の検索、規定の適用、変更の処理を同時に進められます。LLMを自社の知識でファインチューニングするように、企業は文字起こしやTTSモデルも、業界や自社固有の辞書、話し方に合わせて調整し、AIエージェントへの信頼を高めたくなるでしょう。複雑なタスクを一貫して解決できるという自信は料金体系にも表れ、通話時間ではなく、タスクの解決成功率に結びついた成果ベースの料金が登場しています。
3. 小型のオンデバイスモデルが、どこでもローカルな会話を実現
小型のオンデバイスAIモデルは、三つの重要な課題を解決するため注目されています。インターネットなしで動き、ローカル処理でレイテンシを下げ、データを端末内に保ってプライバシーを守ります。遠隔地を走る車や電波の届かない場所で働く人など、これらが欠かせない場面でも音声AIを使えます。
新しいアーキテクチャ、モデルの量子化や蒸留が成熟し、専用のエッジAIチップが広く使えるようになることで、2025年はオンデバイス音声AIが飛躍する年になると予想します。ローカル処理が本番規模でも実用的になります。TensorFlow LiteやPyTorch Edgeの進歩も、導入と最適化をしやすくし、すでにこの変化を加速しています。
4. 声のあらゆる要素を細かく制御
2024年は、感情の調子、話す速さ、正確な発音など、合成音声の細部を制御する技術が大きく進みました。この能力は声だけにとどまらず、音声の特徴と他のAIの表現手段を連携させる方向に広がっています。たとえば、現在は間や綴りの読み方を指定する音声合成マークアップ言語SSMLを通じ、声の感情の手掛かりでデジタルアバターの表情や身ぶりを合わせられます。クリエイターは、AIで生成した言葉や場面を既存の音声に挿入でき、新しい部分は周囲の素材のスタイルとタイミングに自動的に合うようになるでしょう。
今後に向けて
2025年、音声AIは初期の実験から本番対応のシステムへと成熟し、業界を問わず、さらに高機能で調整しやすく、利用しやすいものになるでしょう。