ポケットに
通訳を
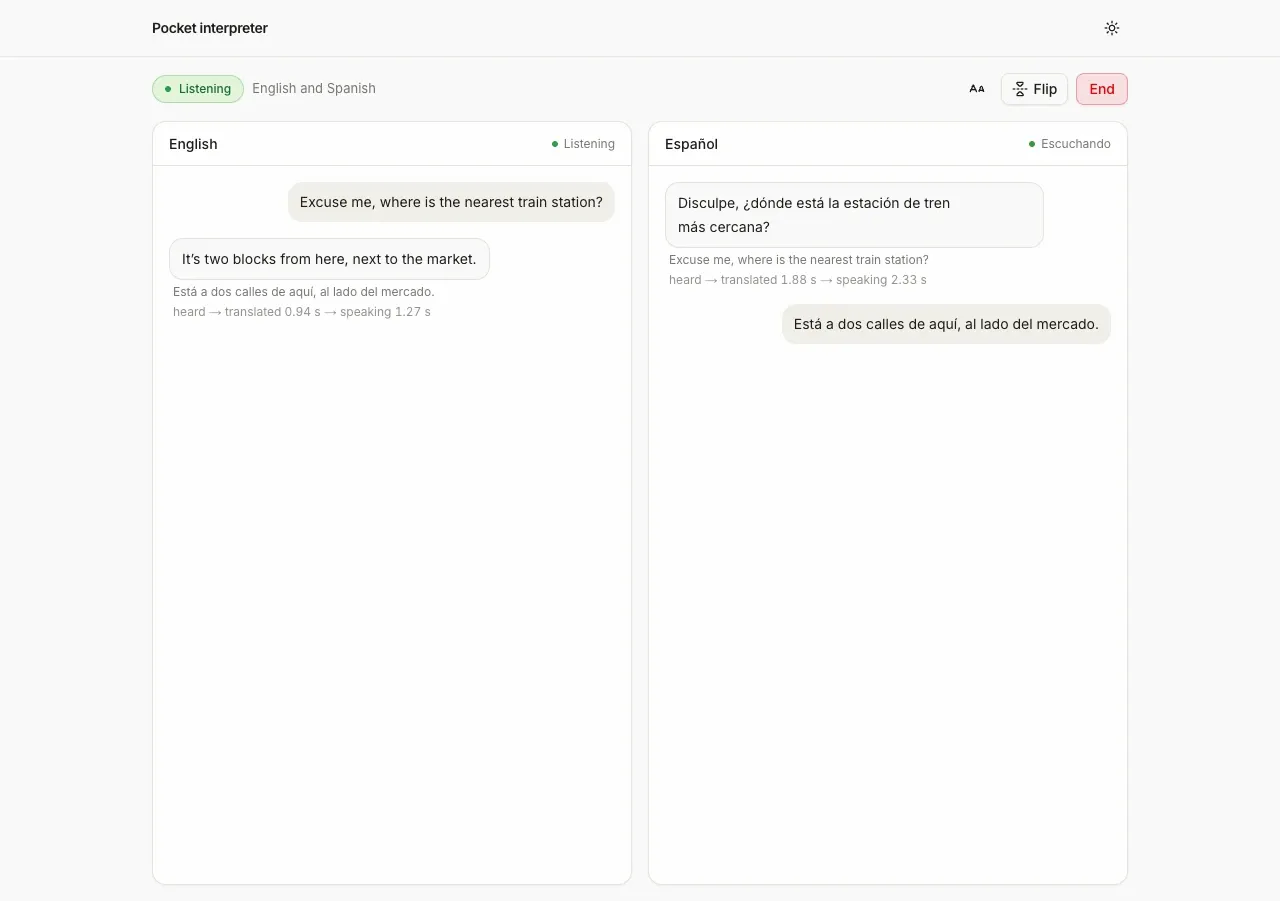
スクリーンショット. ローカルで動かしたテンプレート。
- モデル
- ink-2, sonic-3.6
- 言語
- 英語、スペイン語、フランス語、ヒンディー語、日本語から任意の2つ
- ライセンス
- Apache-2.0
- 技術スタック
- Next.js 16React 19AI SDKWeb Audioshadcn/ui
- Cartesia の製品
- Ink 2Sonic 3.6
できること
画面は2つに分かれ、それぞれが自分の言語で会話を読めます。2人の間にスマートフォンを平らに置けるよう、片方の半分は上下を逆にできます。翻訳された各ターンの下には、翻訳の最初の単語と最初の音声までの時間が小さく表示されます。
自分で動かす
インストールする
Node 22.22以降で下のコマンドを実行します。pnpmでも動きます。下の表を見て
.env.localを埋めます。足りないキーがあれば、ページがどれかを表示します。環境変数 - CARTESIA_API_KEY
play.cartesia.ai/keys- LLM_MODEL
provider/model。例:openai/gpt-5.4-mini- OPENAI_API_KEY
LLM_MODELがopenai/で始まる場合- ANTHROPIC_API_KEY
LLM_MODELがanthropic/で始まる場合- AI_GATEWAY_API_KEY
- それ以外のプロバイダーの場合
- APP_PASSWORD
- ローカルでは任意。Vercelでは必須。公開するならnoneを設定
- TRUST_PROXY
- 任意。自前のリバースプロキシの背後に置く場合は1
話し始める
npm run devが表示するURLを開きます。2つの言語を選んでStart talkingを押します。あとは交互に話すだけで、ターンの合間に押すものはありません。スマートフォンではマイクにHTTPSが必要なので、デプロイするか、cloudflaredなどのトンネルを使って試してください。
コーディングエージェントで作る
どこから始めて、最初に何を読むべきかをコーディングエージェントに伝えるプロンプトです。
Build a two-person voice translation app with Cartesia. Start from https:/ and follow its AGENTS.md for the commands, files and rules. The server mints a 60 second access token with only the stt and tts grants. The browser streams the microphone to ink-2 on /stt/turns/websocket with @cartesia/cartesia-js, sends each turn to an AI SDK route that replies with the language code and the translation, and speaks it with sonic-3.6 over the TTS WebSocket. Keep the mute gate that sends silence to Ink 2 while Sonic plays. If I don't have a Cartesia API key yet, follow https:/ to get one.
仕組み
この設計にした理由
ターンが終わる前に翻訳を始める
間を置くと、Ink 2は話し終えたかもしれないという早めの推測を送り、ページはすぐに翻訳を始めます。本当に話し終えていたら、その翻訳を使います。話し続けた場合は取り消して、文全体を待ちます。
誰が話したかはLLMが伝える
Ink 2は、どの言語を聞き取ったかを知らせません。そこで翻訳の返答は、1行目に言語コードだけを置いて始まります。ページはそのコードで、声と画面のどちら側に表示するかを決めます。
話している間は自分でミュートする
翻訳を再生している間、マイクはInk 2に無音を送ります。そうしないと、アプリは自分の声を聞いてそれを翻訳し返し、それが際限なく続きます。
カスタマイズする
別の音声を使う
言語ごとの声はlib/languages.tsで設定しています。Cartesiaの音声ライブラリから別の声を選ぶか、本人の許可を得て作ったクローンを使ってください。
翻訳の仕方を変える
lib/prompt.tsを編集すると、翻訳を丁寧にもくだけた調子にもできます。返答の1行目にある言語コードは残してください。アプリはそれを読んで声を選んでいます。
ターン検出を調整する
ターンの終わりはInk 2が判断します。待つ時間を長くしたり短くしたりするには、アプリが音声の接続を開くときにturn_end_timeout_msを設定します。その呼び出しはlib/audio/listener.tsにあります。
よくある質問
CartesiaのAPIキーは安全ですか?
安全です。キーはサーバーに置いたままです。ブラウザが受け取るのは60秒だけ有効なトークンで、音声認識と音声合成にしか使えません。
会話はどこに送られますか?
2人の話し声はCartesiaに、各ターンのテキストは翻訳のためにLLMプロバイダーに送られます。始める前に相手にそのことを伝えてください。
2人が同時に話せますか?
話せません。マイクは1つで、ターンも1つずつなので、翻訳の再生が終わるのを待ってください。Ink 2が間と文の終わりを区別するので、ターンの合間に何かを押す必要はありません。
どの言語に対応していますか?
英語、スペイン語、フランス語、ヒンディー語、日本語から2つを選べます。これらはInk 2が聞き取れる言語です。ほかの言語を加えるには、別の音声認識モデルが必要です。
スマートフォンで使えますか?
レイアウトはスマートフォンを前提に作っています。テストはデスクトップのChromeで録音した声をマイク代わりにして行い、実機では試していません。
ヘッドホンは必要ですか?
必要ありません。アプリは自分が話している間と、その後の0.35秒はマイクをミュートします。騒がしい場所では、周りの声で意図しないターンが始まることがあります。
このテンプレートの詳しい手順ガイドはありますか?
はい。レシピでコードを順に解説し、READMEでセットアップ、環境変数、デプロイを説明しています。Cartesia側の仕組みはInk 2のターンイベントのドキュメントにあります。
クックブックのほかの例
今すぐ始める
専門家に相談する。
音声体験の開発にCartesiaをどう活用できるか、私たちのチームにご相談ください。
開発を始める。
APIでモデルにアクセスし、数分で音声エージェントを本番環境に導入できます。