登場人物ごとに声が付く
対話型ストーリー
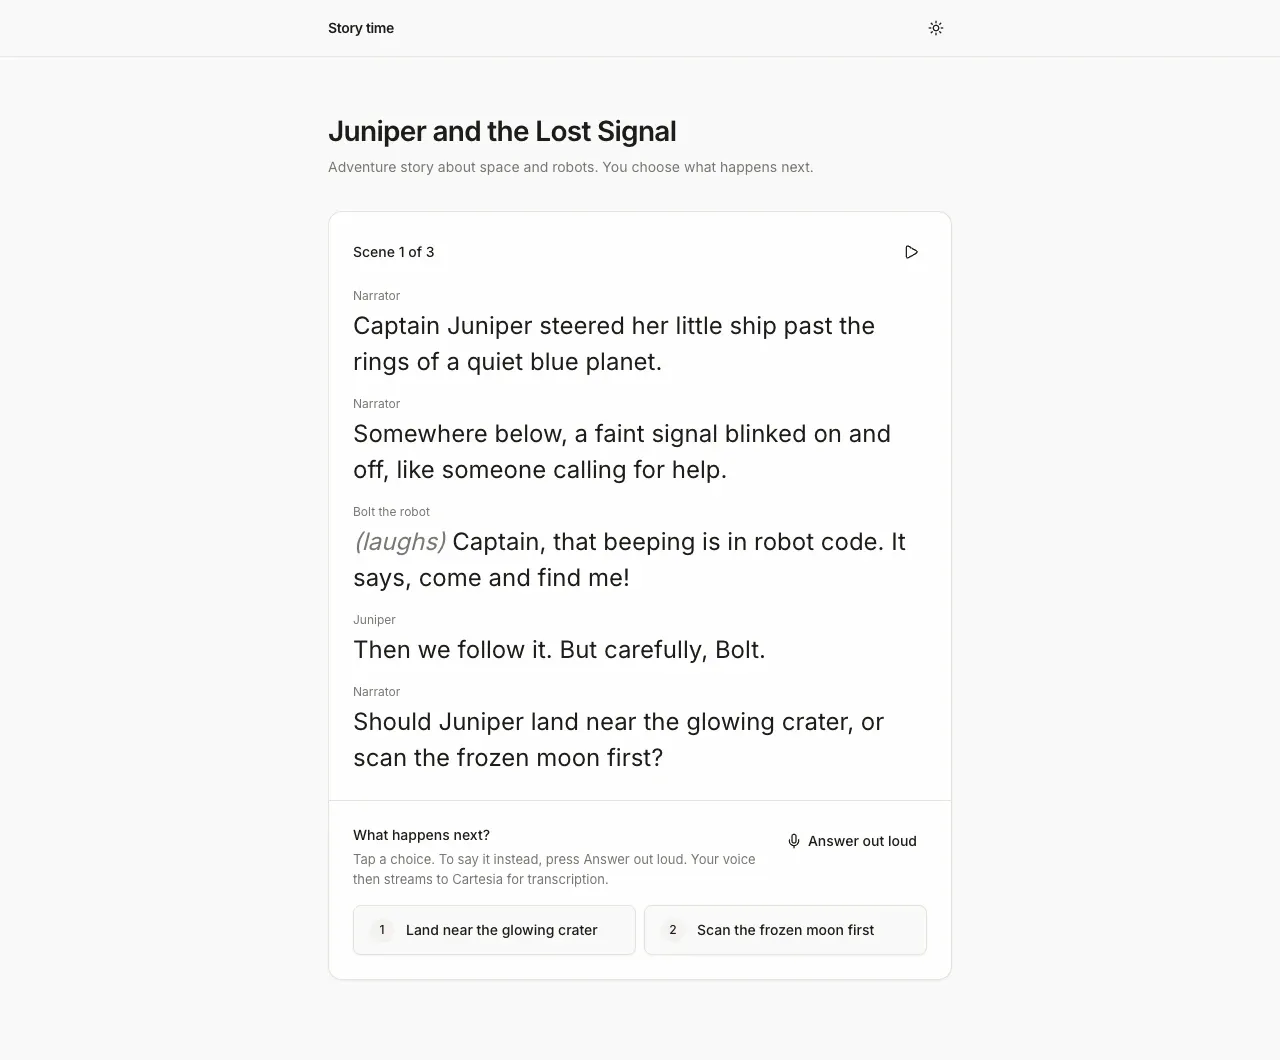
スクリーンショット. ローカルで動かしたテンプレート。
- モデル
- sonic-3.6, ink-2
- 言語
- 英語
- ライセンス
- Apache-2.0
- 技術スタック
- Next.js 16React 19AI SDKIndexedDBshadcn/ui
- Cartesia の製品
- Sonic 3.6Ink 2
できること
物語は短い3つの場面でできています。選んだテーマとトーンをもとにLLMが場面を書き、Sonic 3.6が読み上げます。語り手と登場人物はそれぞれ自分の声で話し、読まれている単語が光ります。
場面の終わりに、次にどうなるかを2つの選択肢から選びます。タップするか、声に出して言ってください。コンテンツの安全対策は最初からオンで、どの場面も再生前に確認されます。
自分で動かす
インストールする
Node 22.22以降で下のコマンドを実行します。pnpmでも動きます。下の表を見て
.env.localを埋めます。足りないキーがあれば、ページがどれかを表示します。環境変数 - CARTESIA_API_KEY
play.cartesia.ai/keys- LLM_MODEL
provider/model。例:openai/gpt-5.4-mini- OPENAI_API_KEY
LLM_MODELがopenai/で始まる場合。場面のモデレーションが有効になるので、どのモデルでも設定を推奨- ANTHROPIC_API_KEY
LLM_MODELがanthropic/で始まる場合- AI_GATEWAY_API_KEY
- それ以外のプロバイダーの場合
- APP_PASSWORD
- ローカルでは任意。Vercelでは必須。公開するならnoneを設定
- TRUST_PROXY
- 任意。自前のリバースプロキシの背後に置く場合は1
物語を始める
npm run devが表示するURLを開きます。テーマとトーンを選び、好みで主人公に名前を付けてStart the storyを押します。場面が終わったら2つの選択肢のどちらかをタップするか、Answer out loudを押して声で言います。
コーディングエージェントで作る
どこから始めて、最初に何を読むべきかをコーディングエージェントに伝えるプロンプトです。
Build an interactive story app with Cartesia. Start from https:/ and follow its AGENTS.md for the commands, files and rules. The AI SDK writes each scene. The browser gets a 60 second access token with the tts and stt grants, reads the scene with sonic-3.6 over the TTS WebSocket using one context per line (each with its own voice, emotion and add_timestamps), and hears the listener's choice with ink-2 on /stt/turns/websocket, opening the mic only when they press Answer out loud. Keep the content-safety rules in AGENTS.md. If I don't have a Cartesia API key yet, follow https:/ to get one.
仕組み
この設計にした理由
話し手ごとに新しい声
Sonicは1つの接続で複数のストリームを動かせ、それぞれに声と感情を設定できます。そのため、ナレーター、主人公、しゃべるドラゴンが再接続なしで交互に話せます。新しい登場人物には、一覧から次の声が割り当てられます。
あなたの言葉はブラウザーから出ない
Ink 2が答えを文字にし、ページはブラウザの中でそれを選択肢と照らし合わせます。LLMに戻るのは選ばれた選択肢だけで、あなたが話した内容は送りません。マイクが開くのはAnswer out loudを押したときだけです。
再生し直してもAPIを呼ばない
各場面は、音声と単語のタイミングと一緒にブラウザのIndexedDBに保存されます。ライブラリから物語を再生すると、ハイライト付きで再生され、何も呼び出しません。
カスタマイズする
別の音声を使う
声のidはlib/story.tsにあります。play.cartesia.ai/voicesの声に差し替えてください。
物語を長くする
lib/story.tsのTOTAL_SCENESを、初期値の3から増やします。場面が1つ増えるごとに、LLMの呼び出しとその読み上げが1回分増えます。
別の言語で物語を語る
Ink 2もSonicも、スペイン語、フランス語、ヒンディー語、日本語に対応しています。lib/narrate.tsで読み上げの言語を設定し、物語のプロンプトにもその言語を加えます。声の選択の照合と安全チェックに使う単語リストを翻訳します。感情の設定は英語でしか効かないので、オフにします。
よくある質問
物語の安全はどう守られていますか?
テーマとトーンは決まった選択肢で、プロンプトは生々しい暴力、性的な内容、差別的な表現を禁じています。どの場面も単語リストで確認され、OpenAIのキーを追加すればOpenAIのモデレーションでも確認されます。完璧なフィルターはないので、共有する前にいくつか物語を読んでみてください。
選んだ内容や声はどこに送られますか?
物語の設定、主人公の名前、あなたの選択は、指定したLLMプロバイダーに送られます。OpenAIのキーを追加すると、設定と各場面もモデレーションのためにOpenAIへ送られます。声での答えはCartesiaへストリーミングされ、アプリのサーバーは音声も物語も保存しません。
CartesiaのAPIキーはブラウザに漏れませんか?
漏れません。キーはサーバーに置いたままです。ブラウザが受け取るのは、60秒だけ有効で音声にしか使えないトークンです。
単語のハイライトはどう動いていますか?
Sonicは音声と一緒に、各単語の開始時刻を送ります。ページは毎フレーム再生時刻を確認し、いま読まれている単語を光らせます。
最初の場面に数秒かかるのはなぜですか?
読み上げが始まる前に、LLMが場面全体を書くからです。小さいモデルを使うと待ち時間が短くなります。その後のセリフは、前のセリフを再生している間に作られます。
このテンプレートの詳しい手順ガイドはありますか?
はい。レシピでコードを順に解説し、READMEでセットアップ、環境変数、デプロイを説明しています。Cartesia側の仕組みはTTS WebSocketのコンテキストのドキュメントにあります。
クックブックのほかの例
今すぐ始める
専門家に相談する。
音声体験の開発にCartesiaをどう活用できるか、私たちのチームにご相談ください。
開発を始める。
APIでモデルにアクセスし、数分で音声エージェントを本番環境に導入できます。