
Come costruire un agente vocale IA con Cartesia
Stanco di conversazioni robotiche con Siri e Alexa che finiscono con “Mi dispiace, non capisco”? I nuovi agenti IA possono conversare in modo naturale, comprendere il contesto e rispondere con un’intelligenza simile a quella umana.
Rispetto agli assistenti tradizionali che eseguono comandi di base, questi agenti cambiano l’esperienza dei clienti. Invece di navigare tra menu telefonici come “Premi 1 per l’inglese”, puoi dire all’IA cosa ti serve, come parleresti a una persona.
Vediamo come costruire questi agenti con l’API Cartesia.
Che cosa sono gli agenti vocali IA?
Gli agenti vocali IA sono sistemi intelligenti che conversano naturalmente con le persone. Comprendono il linguaggio parlato e rispondono, dalle domande semplici ai compiti complessi. Combinano riconoscimento vocale, elaborazione del linguaggio naturale e sintesi vocale per creare interazioni fluide.
Possono gestire molte attività di routine:
- Rispondere alle domande frequenti.
- Fissare appuntamenti.
- Controllare lo stato di un ordine.
- Instradare le chiamate al reparto corretto.
- Offrire supporto di base per risolvere problemi.
Delegando queste interazioni all’IA, i team possono concentrarsi su lavoro più complesso e significativo, usando meglio tempo e risorse.
Come funzionano gli agenti vocali IA?
Gli agenti usano l’IA per elaborare il parlato, interpretarne l’intento, recuperare informazioni dalle basi di conoscenza aziendali, formulare risposte testuali appropriate e pronunciarle con una voce naturale e conversazionale.
Il flusso è questo:
- Trascrizione vocale, ASR: l’utente parla e il sistema converte la voce in testo tramite riconoscimento vocale.
- Elaborazione del linguaggio naturale: il sistema analizza il testo per comprenderne significato, intento, contesto e sfumature.
- Recupero delle informazioni: in base all’intento, l’agente recupera dati pertinenti dalla base di conoscenza per formulare la risposta.
- Generazione della risposta: l’IA genera una risposta appropriata al contesto e alle informazioni recuperate.
- Sintesi vocale: l’agente converte il testo in parlato naturale per l’utente, creando un’esperienza conversazionale.
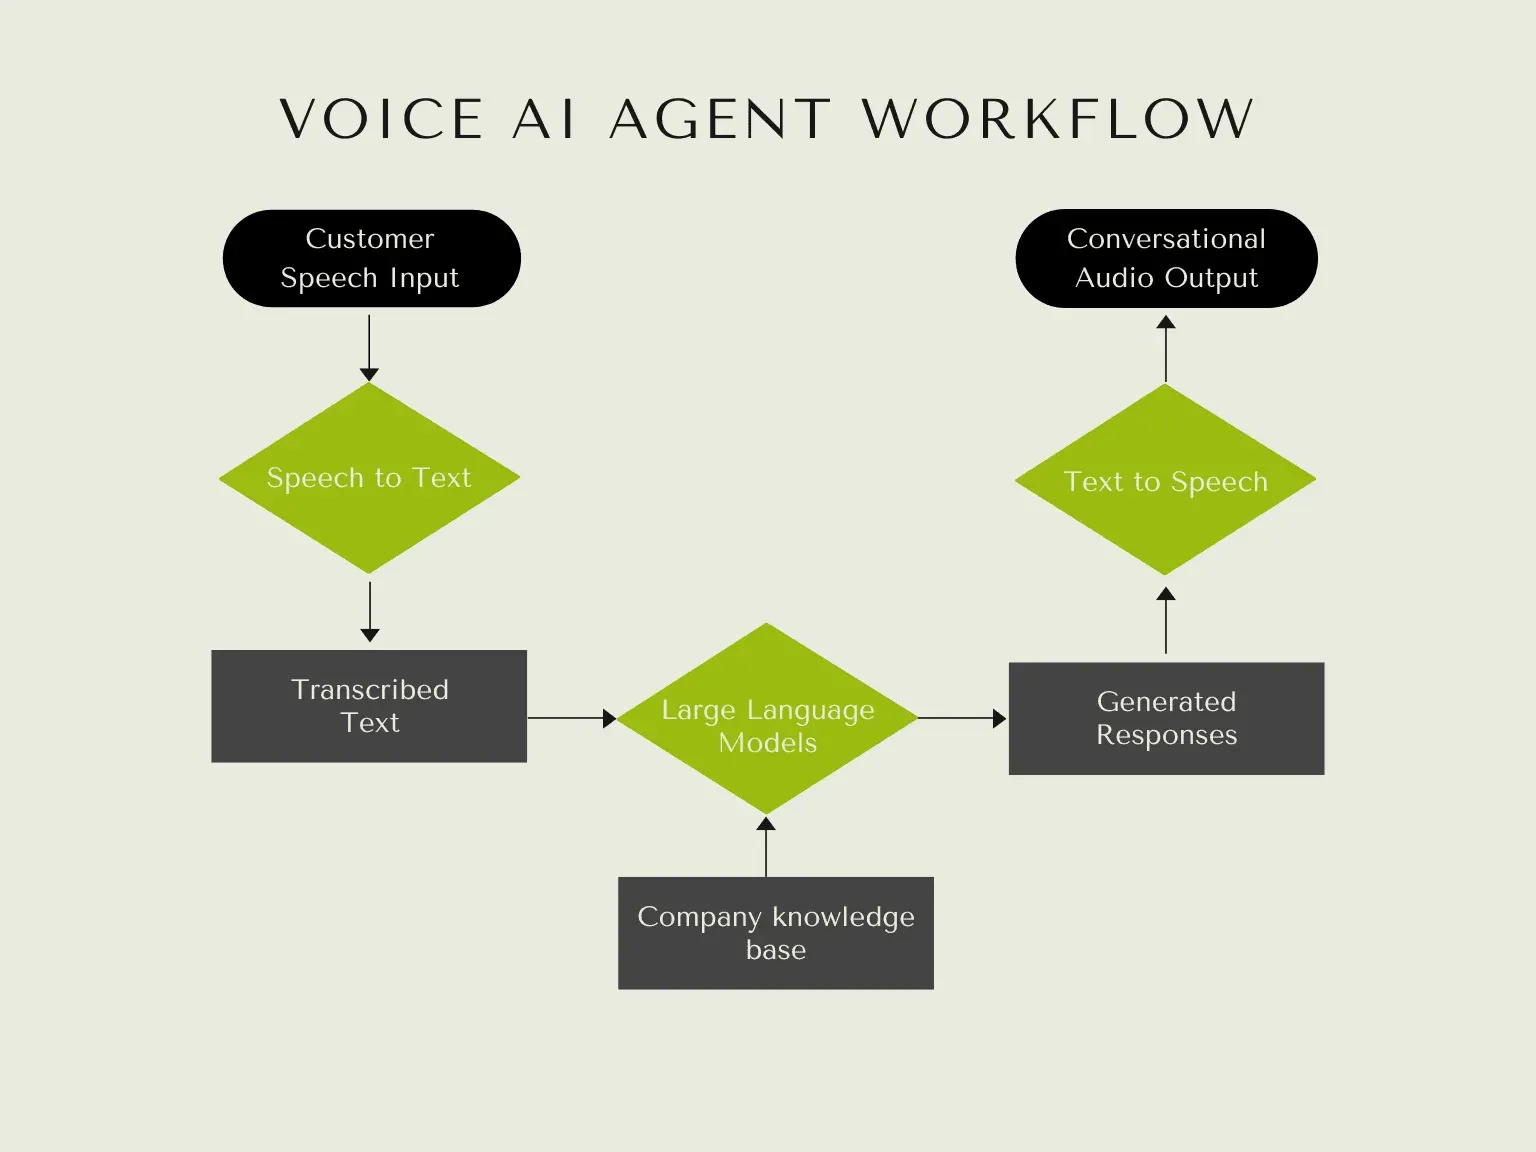
Flusso di lavoro di un agente vocale IA.
L’agente può iniziare la conversazione seguendo un testo preregistrato. Per esempio: “Mi chiamo _____. Come posso aiutarti oggi?”
Il sistema può registrare le risposte dell’utente, convertirle in testo e passare il testo all’LLM o al sistema IA interno in tempo reale. L’LLM genera una risposta adatta, che torna all’agente vocale per essere pronunciata. La conversazione può proseguire finché il sistema raggiunge l’obiettivo, per esempio confermare un appuntamento o risolvere un problema comune.
Costruire un agente vocale IA con l’API Cartesia in Python
Questo tutorial mostra come configurare un agente usando l’API Cartesia e il modello Sonic.
Configura l’ambiente
Per usare l’API Cartesia servono un account, una chiave API e FFmpeg installato. Segui questi passaggi:
- Crea un account su Cartesia Play.
- Ottieni la chiave da Cartesia API Keys.
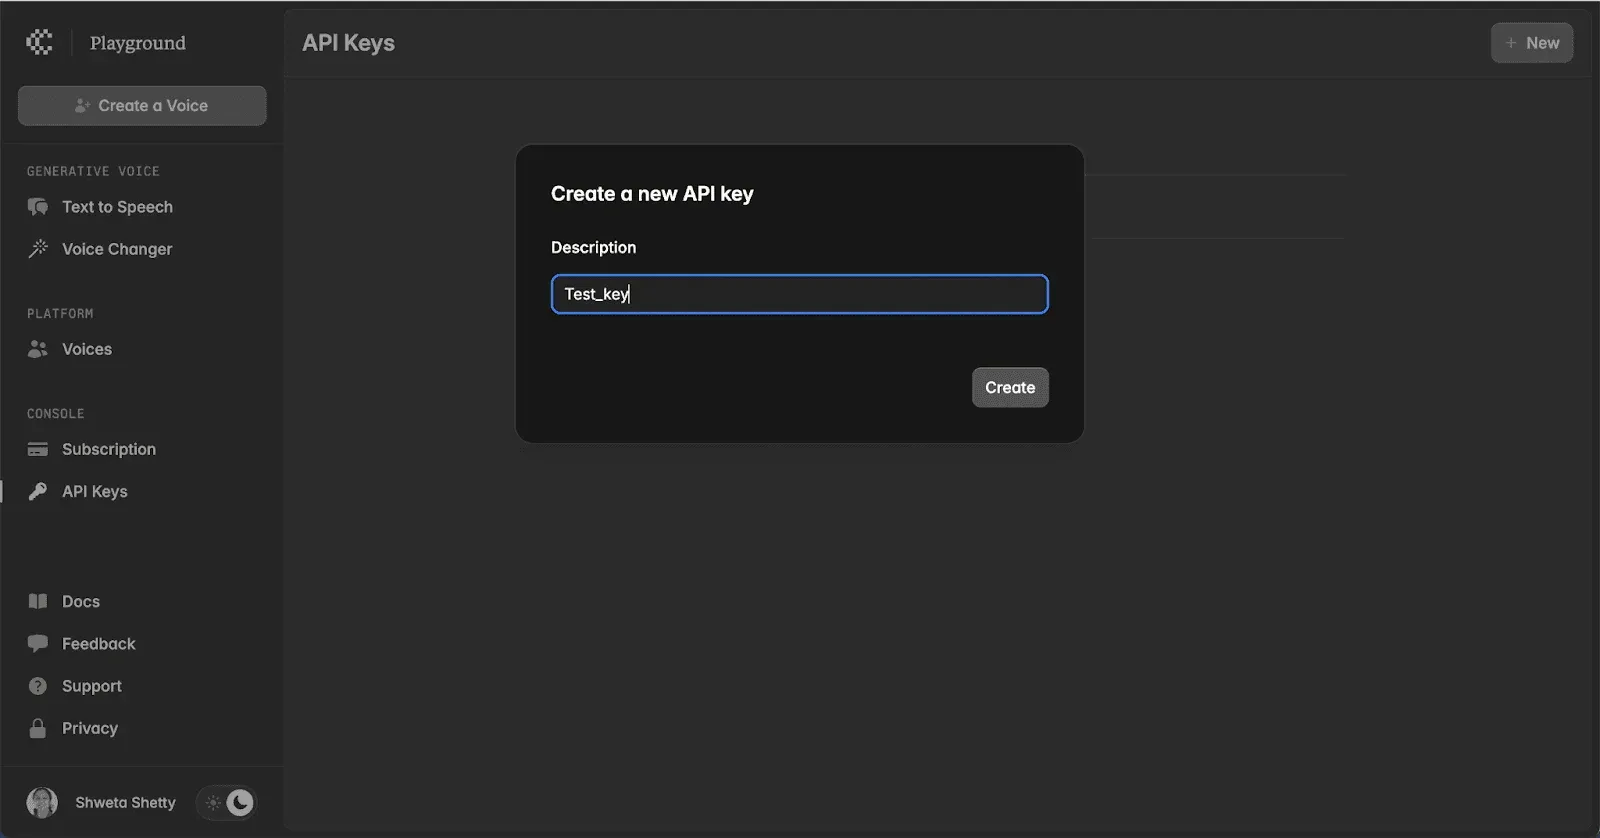
- Installa FFmpeg per l’elaborazione audio come mostrato:
# On Ubuntu/Debian
  sudo apt update && sudo apt install ffmpeg

# On macOS (using Homebrew)
  brew install ffmpeg

# On Windows (using Chocolatey)
  choco install ffmpeg
FFmpeg non è necessario per usare l’API Cartesia, ma aiuta a convertire, salvare e riprodurre file audio.
Scegli l’endpoint di trascrizione vocale
Per prima cosa devi registrare l’input del cliente e convertirlo in testo. Ci sono diverse opzioni. Per esempio, l’API Whisper di OpenAI supporta vari formati audio e trascrive più lingue. Può anche tradurre parlato non inglese in inglese. In alternativa puoi usare Google Speech to Text, Amazon Transcribe, Azure AI Speech, Assembly, Deepgram o Speechmatics.
Genera una risposta dal testo trascritto
La generazione dipende dalla funzione principale della tua applicazione IA. Se l’agente lavora in ambito sanitario, deve comunicare con le applicazioni IA mediche e i database sanitari esistenti. Per fissare appuntamenti, deve consultare le applicazioni calendario. In genere questa funzionalità usa un altro modello IA con maggiori capacità di ragionamento, come Anthropic Claude Sonnet o OpenAI O1 o 4O.
Usa invece una piattaforma per agenti vocali
Se la configurazione sembra troppo complessa, puoi provare piattaforme come LiveKit, VAPI o RASA per iniziare.
La più semplice prova di concetto richiede solo cinquanta righe di codice, senza contare spazi o commenti:
load_dotenv(dotenv_path=".env.local")
logger = logging.getLogger("voice-agent")

def prewarm(proc: JobProcess):
  proc.userdata["vad"] = silero.VAD.load()
async def entrypoint(ctx: JobContext):
  initial_chat_context = llm.ChatContext().append(
      role="system",
      text=(
        "You are a voice assistant created by LiveKit. Your interface with users will be voice. "
        "You should use short and concise responses, and avoid usage of unpronounceable punctuation. "
      ),
  )
  logger.info(f"connecting to room {ctx.room.name}")
  await ctx.connect(auto_subscribe=AutoSubscribe.AUDIO_ONLY)
  # Wait for the first participant to connect
  participant = await ctx.wait_for_participant()
  logger.info(f"starting voice assistant for participant {participant.identity}")

  # Set up the Agent
    agent = VoicePipelineAgent(
      vad=ctx.proc.userdata["vad"],
      stt=deepgram.STT(),
      llm=openai.LLM(model="gpt-4o-mini"),
      tts=cartesia.TTS(
        model="sonic-3.5",
        voice="a0e99841-438c-4a64-b679-ae501e7d6091",
      ),
      chat_ctx=initial_chat_context,
    )
     agent.start(ctx.room, participant)

  # Once connected, we start by hardcoding a greeting
    await agent.say(f"Hey {participant.identity}! How can I help you today?", allow_interruptions=True)

  if __name__ == "__main__":
    cli.run_app(
      WorkerOptions(
        entrypoint_fnc=entrypoint,
        prewarm_fnc=prewarm,
      ),
    )
Formatta il testo in ingresso
Un testo ben formattato è essenziale per ottenere parlato naturale. Alcune buone pratiche:
- Usa la punteggiatura per indicare domande ed enfasi.
- Espandi le abbreviazioni per evitare pronunce errate, per esempio “Doctor” invece di “Dr.”.
- Struttura il testo secondo la cadenza naturale del parlato.
Puoi usare anche tag
Esempio di testo
Ciao! Grazie per aver chiamato il nostro servizio clienti.
<break time="1s" />
  I’m Anna, how can I help you today?
<break time="1s" />
  Could you please provide your order number so we can get started? We’ll resolve this as quickly as possible and keep you updated.
<break time="1s" />
Scegli l’endpoint di sintesi vocale
Cartesia offre più endpoint TTS. Gli endpoint WebSocket e streaming sono adatti agli agenti interattivi per questi motivi:
- Latenza: puoi aprire una connessione WebSocket in anticipo, evitando il ritardo di connessione quando inizi a generare. In genere risparmi circa 200ms.
- Input in streaming: puoi inviare input progressivamente mantenendo la prosodia del parlato generato, utile quando il testo arriva in tempo reale da un LLM.
- Timestamp: puoi ottenere trascrizioni con riferimenti temporali per sottotitoli o trascrizioni dal vivo. Si applicano limiti di modello e lingua; consulta Confronto degli endpoint TTS.
- Multiplexing: puoi gestire più conversazioni sulla stessa connessione.
L’endpoint TTS bytes, POST, è ideale per generare in anticipo un file audio. Puoi creare output in formati come WAV e MP3.
Prima di scegliere, consulta la documentazione degli endpoint TTS Cartesia per individuare quello più adatto.
Chiama l’API
Dopo aver formattato il testo, invialo all’endpoint scelto. L’API richiede un payload JSON con il testo e parametri di configurazione facoltativi. Ecco come configurarlo con l’SDK Python Cartesia.
pip install cartesia

# Or using uv
uv add cartesia

# Make the API call
import os
import subprocess
from cartesia import Cartesia
if os.environ.get("CARTESIA_API_KEY") is None:
  raise ValueError("CARTESIA_API_KEY is not set")

client = Cartesia(api_key=os.environ.get("CARTESIA_API_KEY"))

response = client.tts.generate(
  model_id="sonic-3.5",
  transcript="Hello, world! I'm generating audio on Cartesia.",
  voice={"mode": "id", "id": "a0e99841-438c-4a64-b679-ae501e7d6091"},  # Greg - Supporter
  language="en",

  # You can find the supported output_format at https://docs.cartesia.ai/api-reference/tts/bytes
  output_format={
    "container": "wav",
    "encoding": "pcm_f32le",
    "sample_rate": 44100,
  },
)
with open("sonic.wav", "wb") as f:
  f.write(response.read())
# Play the file
subprocess.run(["ffplay", "-autoexit", "-nodisp", "sonic.wav"])
Esegui lo script così:
env CARTESIA_API_KEY=YOUR_API_KEY python cartesia.py

# On uv
env CARTESIA_API_KEY=YOUR_API_KEY uv run cartesia.py
Lo script invia il testo a Sonic, recupera l’audio e lo salva come file .wav.
Configura il tuo agente vocale
L’API Cartesia permette di personalizzare ulteriormente la voce, regolando velocità, emozione e localizzazione.
Velocità
Per personalizzare la velocità, aggiungi il parametro speed nel dizionario __experimental_controls dell’oggetto voice nella richiesta API.
Le opzioni sono:
- “slowest”: parlato molto lento.
- “slow”: parlato più lento del normale.
- “normal”: velocità predefinita.
- “fast”: parlato più veloce del normale.
- “fastest”: parlato molto veloce.
Puoi anche definire la velocità come numero nell’intervallo [−1.0,1.0] per un controllo più preciso. Il valore 0 indica la velocità predefinita, i valori negativi rallentano e quelli positivi accelerano.
"voice": {
  "mode": "id",
  "id": "VOICE_ID",
  "__experimental_controls": {
    "speed": "fast,
  }
}
Emozione
Per personalizzare l’emozione, aggiungi il parametro emotion nel dizionario __experimental_controls dell’oggetto voice nella richiesta API. È un array di tag nel formato emotion_name: level.
I nomi delle emozioni possono essere anger, positivity, surprise, sadness e curiosity.
I livelli sono lowest, low, high e highest. Sono puramente additivi: “surprise: low” aggiunge una piccola quantità di sorpresa, non rende la voce meno sorpresa. Ometti il livello per un’aggiunta moderata.
"voice": {
  "mode": "id",
  "id": "VOICE_ID",
  "__experimental_controls": {
    "emotion": [
    "positivity:high",
    ]
  }
}
Input in streaming
Per applicazioni interattive puoi generare parlato dinamicamente da un modello IA, come un LLM. L’API Cartesia supporta la generazione in tempo reale tramite le continuazioni. Riprendono da dove la generazione precedente si è fermata, mantenendone andamento sonoro e contesto.
La continuazione si configura con context_id nell’input testuale. Tutte le parole e frasi di un enunciato continuo devono avere lo stesso context_id.
{"transcript":
   "Hello, Sonic!",
   "continue": true,
   "context_id": "stream1"
}
{"transcript":
   " I'm streaming ",
   "continue": true,
   "context_id": "stream1"
}
{"transcript":
   "inputs.",
   "continue": false,
   "context_id": "stream1"
}
Puoi inviare la richiesta con context_id all’endpoint TTS WebSocket. Gli input successivi con lo stesso context_id continuano la generazione mantenendo la prosodia.
È utile per agenti vocali IA, chatbot ed esperienze interattive.
Domande frequenti sugli agenti vocali IA
La tecnologia di IA vocale è già utilizzabile?
Sì, le aziende stanno adottando soluzioni di IA vocale. Piattaforme come Cartesia offrono generazione di alta qualità, bassa latenza e voci conversazionali realistiche. Gli agenti possono rispondere usando un database informativo e gestire appuntamenti, creazione di record CRM, chiamate in uscita e qualificazione dei potenziali clienti.
Quali aziende possono beneficiare degli agenti vocali IA?
Sanità, call center, giochi e assicurazioni mediche sono alcuni dei settori che li usano già. Qualsiasi azienda con molte chiamate mensili può beneficiarne automatizzando le interazioni con i clienti e migliorando l’efficienza operativa.
Gli agenti vocali IA possono parlare lingue diverse dall’inglese?
Sì, possono supportare più lingue, ma la qualità dipende dal fornitore TTS. Per esempio, Cartesia supporta 15 lingue, tra cui spagnolo, tedesco, francese, italiano e hindi.
Quanto sono personalizzabili?
Gli agenti possono essere adattati alle esigenze specifiche dell’azienda. Possono essere addestrati sui dati aziendali per rispondere correttamente ai clienti, e le voci possono seguire le tue preferenze. Possono inoltre integrarsi con siti web, CRM, calendari e qualsiasi software con endpoint API, inserendosi nei flussi esistenti.
Gli agenti vocali IA suonano ancora robotici?
No, la tecnologia moderna ha ridotto molto il parlato robotico. La generazione gestisce meglio pause naturali, interruzioni e sfumature conversazionali. Distinguere parlato umano e generato diventa sempre più difficile, soprattutto con fornitori TTS di qualità come Cartesia.